@rick — following
Follow buttons here act as you, not as @rick.
@rick follows
| Label | Kind | State | Action |
|---|---|---|---|
| rss.skyfleet.blue | source | — | — |
| rss.skyfleet.blue | source | — | — |
| rss.skyfleet.blue | source | — | — |
| rss.skyfleet.blue | source | — | — |
Timeline
-
Muse Wonder : Meta acte son retour dans la course à l’IA avec des agents capables de travailler seuls
Reply sourceMeta n’a pas l’intention de laisser OpenAI et Anthropic occuper seuls le terrain des agents d’intelligence artificielle. La firme de Mark Zuckerberg a présenté ce 12 octobre Muse Wonder et Muse Wonder Full, deux modèles destinés à exécuter des tâches qui nécessitent davantage que de générer une réponse à une question. Comprendre un contrat de location, traiter un dossier d’assurance, élaborer un programme d’entraînement ou développer une application : Meta veut que ses modèles puissent mener un travail à son terme, y compris lorsqu’il implique plusieurs étapes, des outils externes et des corrections successives.
-
Sciences Po : enseignants et personnels rejoignent la grève et dénoncent la répression des lycéen·nes
Reply source -
Comment le mouvement parti des lycées s'étend aux étudiants et aux enseignants-chercheurs
Reply source
-
Près d'un demi-million de jeunes dans la rue : comment la contestation lycéenne gagne les universités
Reply source -
Près d'un demi-million de jeunes dans la rue : comment la contestation lycéenne gagne les universités
Reply source -
Apple lance de nouveaux Apple TV et HomePod mini : voici les nouveautés
Reply source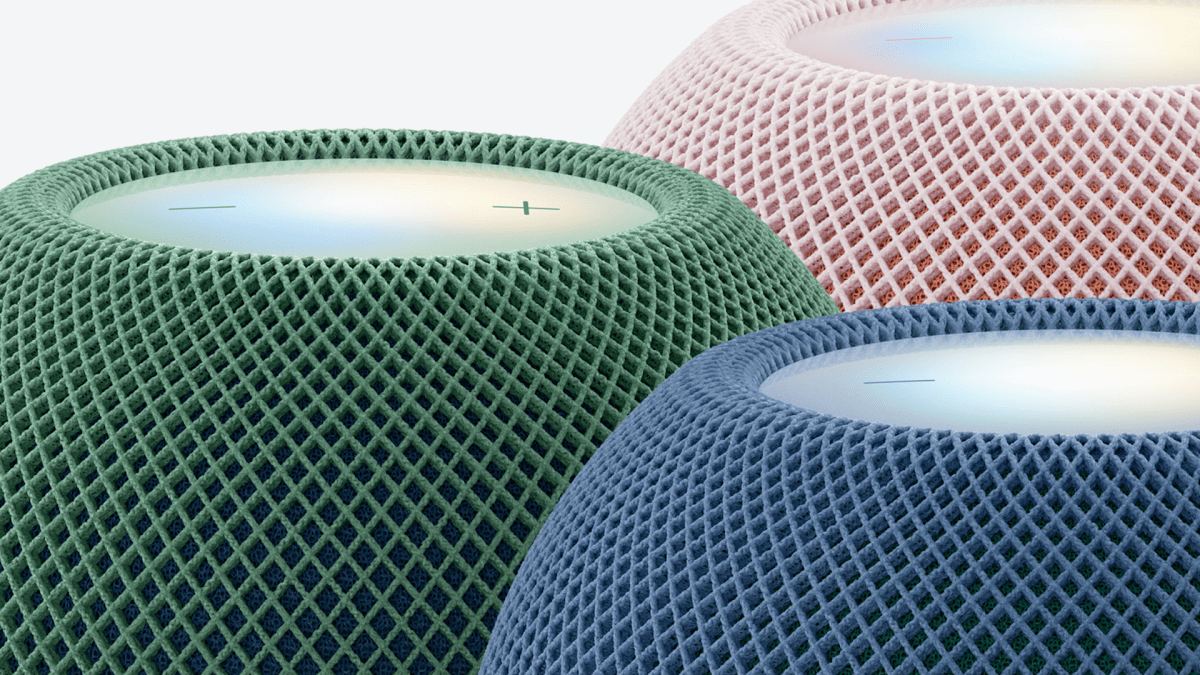
Apple dévoile de nouvelles versions de ses deux produits les plus populaires pour la maison connectée : l'Apple TV et le HomePod mini. Au programme : des puces plus puissantes, mais pas de Siri AI en France.
-
Dans les colonies françaises d’outre-mer : une colère lycéenne oubliée et réprimée
Reply sourceLes médias français basés en métropole n'en parlent pas, mais la jeunesse lutte aussi dans les Antilles et dans l’océan Indien.
L’article Dans les colonies françaises d’outre-mer : une colère lycéenne oubliée et réprimée est apparu en premier sur Contre Attaque.
-
Le nouveau jeu du créateur de Dragon Quest a été conçu avec l’IA en 30 minutes
Reply source
Yuji Horii est l'un des co-créateurs de Dragon Quest, tout de même l'une des sagas de JRPG les plus importantes de l'histoire. Le 11 octobre, il a publié gratuitement un petit jeu d'enquête qu'il dit avoir créé en une trentaine de minutes avec Claude, l'IA générative d'Anthropic.
-
GEO : sur 148 marques, être connu des modèles ne prédit pas la citation, selon Pierre Sauvé
Reply sourceCe qu'il faut retenir :
- Pierre Sauvé distingue la « présence » d'une marque dans les poids d'un modèle, mesurée par log-probabilités sur des modèles ouverts, de sa « citabilité », qui dépend de la recherche web effectuée au moment de répondre.
- Sur son panel, l'accord entre le classement des marques connues des modèles ouverts et celui des marques citées par ChatGPT et Gemini n'est que de 0,1, sur une échelle allant de 0 à 1.
- À notoriété web égale, avoir une page Wikipédia ou une forte présence sur Reddit ne produit pas d'avantage mesurable sur la présence : les paires comparées se répartissent quasiment à parts égales.
- Le consultant recommande des audits GEO avec passages répétés, appels dans l'interface plutôt que par l'API, socle daté et deux indicateurs distincts, présence et citation, plutôt qu'un score unique.
Trois passages dans ChatGPT donnent trois listes de marques différentes
L’étude est née d’une remarque d'un client. Pierre Sauvé raconte avoir travaillé pour une plateforme de sondage dont l’équipe, plutôt rigoureuse, constatait que les taux de visibilité IA variaient d’un outil à l’autre. Il a donc lancé trois fois la même requête dans ChatGPT (« quelle plateforme de sondage propose des quotas et redressement ? »), dans des conditions d’utilisation classiques, le même jour et à quelques heures d’intervalle. Résultat : trois listes différentes. Une seule marque, Symbial, apparaît dans deux réponses, et aucune n’apparaît dans les trois. Le consultant parle de « roulette russe ».
Il a ensuite sollicité Qwairy, outil de suivi de la visibilité dans les LLM, qui lui a fourni gracieusement des données sur un panel plus large. Les marques y sont détectées par leur nom mais aussi par leur domaine. Les résultats confirment l’instabilité :
- Sur ChatGPT : 42 % des marques ne sont vues qu’une seule fois sur trois passages, et seulement 37 % apparaissent aux trois.
- Sur Gemini : 55 % des marques ne sont vues qu’une seule fois sur trois passages.
Pour Pierre Sauvé, un audit GEO fondé sur un passage unique contient donc une part d’aléa importante. Il précise que ces passages ont été réalisés sur une période courte et qu’il prévoit de les renouveler dans un mois ou deux.
Présence et citabilité relèvent de deux couches distinctes
Le consultant distingue deux raisons pour lesquelles un LLM cite une marque :
- La présence : ce que le modèle a en mémoire, ancré dans ses données d’entraînement. Elle est apprise à un instant donné, bouge lentement et se mesure de façon reproductible.
- La citabilité : ce que l’étape de recherche (le live retrieval) place sous les yeux du modèle au moment de répondre. Elle est volatile et actionnable à court terme.
Il illustre la différence par deux cas extrêmes. Pour savoir qui présidait la France en 2003, ChatGPT n’a pas besoin de chercher sur le web : l’information est solidement ancrée dans ses données d’entraînement. Pour connaître le résultat du dernier match de l’OM, il doit effectuer une recherche. La plupart des prompts, notamment en e-commerce, se situent entre les deux : le moteur puise une partie de l’information dans sa mémoire, puis la recherche la complète, la valide ou parfois la contredit.
Ces deux axes forment une matrice à quatre cases : présente et citée (position idéale), présente mais jamais citée (problème de récupération), absente mais citée (position portée par la recherche, donc fragile), absente et silencieuse (tout est à faire). Pierre Sauvé présente cette grille comme une proposition de complément méthodologique, et non comme une vérité établie.
 Illustration de la matrice d'analyse - Source : Slides de la conférence de Pierre Sauvé
Le robots.txt recoupe en partie cette distinction. Chez OpenAI, GPTBot collecte pour l’entraînement (la présence), tandis qu’OAI-SearchBot alimente l’index de recherche (la citabilité). Le consultant cite plusieurs cas observés en septembre 2026, avec des taux de citation calculés sur le jeu de prompts de chaque secteur :
- Moosend : GPTBot et ChatGPT-User bloqués, OAI-SearchBot autorisé. Marque citée par ChatGPT dans moins de 3 % des réponses.
- Dealabs : tous les robots bloqués par défaut, sauf sur le répertoire des codes promos. Marque citée par ChatGPT dans 36 % des réponses.
- Ouest-France : stratégie sélective selon les rubriques.
Pour Pierre, bloquer GPTBot n’empêche pas une marque d’apparaître dans les données d’entraînement, puisque d’autres sites parlent d’elle. Ce choix revient surtout à laisser à des tiers la manière dont la marque y est décrite, et à dépendre de la recherche pour corriger ou valider ces informations. Dealabs illustre l’inverse : selon lui, son ancrage est si fort que le blocage ne l’empêche pas d’être bien présente et bien citée. De la même façon, les LLM connaissent Ouest-France ou Le Figaro malgré la posture restrictive des médias.
La log-probabilité sert d’instrument pour mesurer la présence
Pierre Sauvé limite volontairement son étude à la présence, qu’il juge la plus mal connue et la moins vérifiée dans les audits. Il laisse la citabilité (balisage, format des réponses, fraîcheur) aux outils SaaS spécialisés, et estime que sa conférence ne couvre qu’environ la moitié du sujet. Il précise aussi qu’il mesure si le modèle connaît une marque, pas ce qu’il en pense, un second volet étant annoncé pour une « V2 ».
Son instrument est la log-probabilité (logprob). Pour rappel, un modèle de langage attribue une probabilité à chaque mot susceptible d’en suivre un autre. Dans la phrase « Paris est la capitale de la… », « France » obtient environ 90 % et « soupe » environ 0,01 %. Le consultant exprime ces valeurs en nats, une unité logarithmique : 0 nat correspond à une probabilité de 100 %, et chaque nat en moins divise la probabilité par 2,7 environ. Une marge de +0,78 nat signifie ainsi que la bonne réponse est 2,2 fois plus probable que la meilleure des mauvaises.
Le protocole repose sur quatre briques :
- Le panel : 148 marques réparties sur 11 secteurs, avec une majorité de marques anglophones, un sous-groupe français et 38 marques inventées servant de témoins. Le consultant dit avoir mélangé des secteurs très présents sur le web (CRM, plugins SEO pour WordPress) et d’autres qui communiquent moins.
- La notoriété : le nombre de mentions par milliard de mots dans cinq corpus ouverts de pré-entraînement (C4, DCLM-baseline, Dolma v1.7, RedPajama et The Pile), compté via l’API infini-gram de l’Allen Institute for AI.
- La présence : dix modèles ouverts issus de trois familles (Qwen, Llama, Gemma), en deux tailles de 1 à 9 milliards de paramètres, complétés par des tests sur des modèles de 70 milliards.
- L’appariement : plutôt que de comparer Nike à un petit fabricant local, le consultant compare des marques de notoriété équivalente.
Les vrais corpus de Qwen, Llama, Gemma et des modèles fermés ne sont pas publiés. Pierre Sauvé s’appuie sur le fait que Common Crawl est au cœur de l’entraînement de tous ces modèles, en rappelant que la seule composition publiée par OpenAI date de GPT-3 (60 % des tokens). Il raisonne aussi par différence entre corpus de composition connue, Dolma contenant Reddit et RedPajama non. Le tout a été réalisé avec des GPU loués, pour un coût global d’environ 50 dollars.
La mesure centrale est la « marge de catégorie ». Le modèle évalue la phrase associant la marque à sa vraie catégorie, puis la compare à quatre fausses catégories (café italien, poisson, village du sud, danse folklorique). La marge est l’écart, en nats, entre la bonne catégorie et la meilleure des fausses. Elle est ensuite comparée à un « plancher » : la marge obtenue par des noms inventés, générés puis vérifiés un par un sur Google pour s’assurer qu’ils n’existaient pas. Selon le consultant, une log-probabilité brute mesure la plausibilité d’une chaîne de caractères, pas la connaissance : en démonstration, la marque inventée « Mailzephor » passait devant une vraie marque avant cette correction.
Le premier enseignement concerne le nom lui-même. Un nom inventé mais « parlant », qui contient par exemple « mail » pour l’emailing, obtient une marge positive sans aucune connaissance derrière. Selon les modèles, ce bonus atteint +0,75 à +1,05 nat sur les petits modèles et +0,99 à +1,23 nat sur ceux de 7 à 9 milliards de paramètres. La part de marques réelles qui dépassent la meilleure marque inventée varie de 30 % (Qwen, petite taille) à 71 % (Gemma, grande taille). Sur les petits modèles, sept marques sur dix ne battent donc pas un nom qui n’existe pas. Les gros modèles connaissent davantage de marques, mais accordent aussi un bonus plus élevé aux noms parlants.
Mentions, Reddit, Wikipédia : trois croyances passées au crible
« Spammons de mentions, tant pis pour les liens »
Pierre Sauvé rappelle d’abord que le balisage HTML est supprimé lors de l’extraction du texte d’entraînement. Dans les corpus, « https:// » apparaît 525,7 fois par million, « href= » 16,6 fois et « rel="nofollow" » 3,7 fois. D’un lien, il ne reste que l’ancre, c’est-à-dire une mention. Le lien garde pourtant un rôle à deux niveaux. En amont, Common Crawl découvre et revisite les pages en suivant les liens, et les filtres qualité favorisent les pages connectées. En aval, ChatGPT et Gemini s’appuient sur des index où le graphe de liens sélectionne les pages proposées au modèle.
Il vise ici les plateformes qui vendent des mentions pour le GEO. Selon lui, aucune n’a démontré d’effet sur les données d’entraînement : elles partent du principe que leurs contenus seront à la fois récupérés par la recherche et intégrés aux corpus.
Ses mesures montrent un rendement décroissant. En classant les 148 marques en quatre groupes de taille égale, la part de marques réellement reconnues passe de 11 % (Botify, Oncrawl, Bricorama…) à 30 % avec six fois plus de mentions, puis à 46 % avec 33 fois plus. Elle redescend à 35 % pour les marques omniprésentes (HubSpot, IKEA, Sephora), avec 110 fois plus de mentions.
Sur Qwen 1,5B, la marge moyenne passe de +0,28 à +0,97 nat entre le premier et le deuxième quartile de mentions, puis ne gagne que +0,24 nat jusqu’au quatrième, malgré dix-neuf fois plus de mentions. Sur Qwen 7B et Llama 8B, le deuxième quartile dépasse même les suivants. Le consultant en conclut que sortir de l’invisibilité vaut l’effort, mais que saturer une marque déjà présente rapporte beaucoup moins. Pour une marque jeune ou très peu présente, il recommande au contraire de « taper un peu fort », puisqu’elle part de zéro.
« La présence Reddit pèse lourd »
Les corpus n’indiquent pas d’où vient une occurrence. Pierre Sauvé compare donc Dolma (avec Reddit) et RedPajama (sans Reddit), construits selon la même méthode. Rank Math y est 9,1 fois plus mentionné dans Dolma, Semrush 4,9 fois, Bioderma 3,3 fois, Oncrawl seulement 1,3 fois. Au-delà d’un rapport de 3,3, il considère qu’une marque doit notablement sa présence à Reddit.
Une lecture naïve semble confirmer la croyance : les 16 marques « Reddit-friendly » affichent une marge médiane de +1,39 nat contre +1,06 pour les 132 autres, avec cinq fois moins de présence web. Mais à notoriété web égale, sur 16 paires, le résultat tombe à 8 contre 8, pour un écart médian de −0,05 nat. Deux exemples l’illustrent :
- AccuRanker contre Sistrix : à notoriété comparable (16 et 18 mentions par milliard), l’outil plus présent sur Reddit l’emporte de 1,67 nat.
- Bioderma contre Fenty Beauty : à 351 et 344 mentions par milliard, c’est la marque peu visible sur Reddit qui l’emporte, avec 1,12 nat d’écart.
Pierre Sauvé en conclut que Reddit signale une présence sans en déterminer la valeur. Il rapporte le cas d’un client accompagné par une agence spécialisée dans Reddit : aucune différence observée, un compte signalé par la plateforme, et des critiques formulées uniquement sur Reddit qui sont ensuite remontées dans les réponses des IA. Il ajoute que les LLM cherchent souvent à présenter les points positifs et négatifs d’une marque. Interrogé sur la rentabilité de Reddit, il répond qu’elle n’est pas supérieure à celle d’un média quelconque, et conseille plutôt de travailler sur des espaces où la marque maîtrise son discours.
« Être sur Wikipédia change tout »
Même démarche pour Wikipédia, dont le statut a été vérifié via l’API de l’encyclopédie. Les 75 marques avec une page devancent les 73 autres de 0,42 nat. Elles sont aussi 11,9 fois plus mentionnées. Pour le consultant, avoir une page Wikipédia est d’abord un symptôme de notoriété.
À notoriété égale, sur 36 paires, 17 vont dans le sens de la croyance et 19 dans le sens inverse, avec un écart médian de −0,29 nat. SendGrid (avec page) devance AWeber (sans page) de 1,79 nat à notoriété quasi identique. À l’inverse, Rank Math (sans page) devance Yoast (avec page) de 1,27 nat. Pierre Sauvé avance deux explications possibles : un nom qui contient « Rank » est plus facilement associé au SEO, et Rank Math, arrivé plus tard, a suscité de nombreux contenus comparatifs.
Il reconnaît à Wikipédia un contexte encyclopédique plus informatif et plus neutre que Reddit, sans y voir pour autant de levier décisif. Il rappelle aussi qu’une page créée par un prestataire rémunéré est souvent signalée par un bandeau ou une mention de contribution rémunérée, ce qui ne sert pas l’image de la marque. Interrogé sur Wikidata, il précise ne pas l’avoir mesuré. Son hypothèse : il s’agit d’une base de données qui fournit des relations entre entités plutôt que du texte d’entraînement.
Être connu du modèle ne prédit pas la citation
Pierre Sauvé a ensuite croisé ses mesures de présence avec les données de citation fournies par Qwairy, relevées dans l’interface et non par l’API. Environ 20 prompts génériques par secteur, en français et sans nom de marque, ont été soumis trois fois à ChatGPT et Gemini, soit 1 100 réponses selon les slides. Une marque est considérée comme « citée » si elle apparaît dans au moins 5 % des réponses de son secteur, et « présente » si sa marge dépasse le plancher des noms inventés.
Les accords entre classements (de 0 pour aucun rapport à 1 pour un ordre identique) sont parlants :
- ChatGPT et Gemini, sur les marques qu’ils citent : 0,89.
- Les modèles ouverts, sur les marques qu’ils connaissent : 0,85.
- Présence et citation entre elles : 0,1.
Chaque couche est cohérente avec elle-même, mais les deux ne se recouvrent pas, sauf pour les marques les mieux placées, comme IKEA ou HubSpot. Trois cas l’illustrent :
- Adobe Marketo : marge de +1,37 nat et 2 131 occurrences par milliard de mots, mais une seule réponse ChatGPT sur 60 dans le secteur de l’emailing. Le consultant rappelle que la marque réalisait 400 millions de dollars de chiffre d’affaires en 2021.
- Brevo : marge de −0,15 nat, inférieure à celle d’une marque inventée, mais citée dans 83 % des réponses ChatGPT du secteur.
- Google Optimize : service arrêté en 2023, marge de +2,1 nat, 0 % de citation, comme Universal Analytics ou Klout. Selon Pierre Sauvé, les mises à jour des données d’entraînement ne font pas baisser ses occurrences, car les modèles continuent d’absorber des articles anciens. Sa formule : « Les données d’entraînement n’oublient pas, mais la recherche, oui. »
Le cas Brevo s’explique par le rebranding de Sendinblue en mai 2023. Sur les trois petits modèles, Sendinblue obtient entre +1,56 et +1,73 nat mais n’est jamais cité, tandis que Brevo oscille entre −0,44 et +1,07 nat. La mémoire retient l’ancien nom, la recherche cite le nouveau. Pour le consultant, c’est la recherche web qui corrige le tir : elle signale au modèle que Sendinblue est devenu Brevo. Il note aussi que le changement n’a pas aidé la marque côté présence, « Send » étant plus proche de l’emailing qu’un nom neutre comme Brevo. Même schéma pour Piwik devenu Matomo, cité dans 65 % des réponses alors que Piwik domine les données d’entraînement.
Sur la matrice finale, Pierre Sauvé classe 61 marques présentes et citées (HubSpot, Ahrefs, Semrush), 65 présentes mais jamais citées (Marketo, Hiscox, FullStory), 13 absentes mais citées (Brevo, MAIF, Weldom) et 17 absentes et silencieuses (Sistrix, Matmut).
Le consultant indique avoir tenté de contredire ce résultat, secteur par secteur, puis sur les articles de type « meilleurs outils de », sans changer la conclusion. Sur Llama 3.1 70B, cinquante fois plus gros, l’accord reste nul. La langue joue en partie : sur des modèles mieux entraînés en français et interrogés en français, l’ordre change. En anglais, tous les modèles placent Home Depot devant Leroy Merlin, alors qu’une sonde française sur un modèle français rétablit l’ordre. Il dit n’avoir trouvé aucun modèle majoritairement entraîné en français : Mistral, qu’il pensait plus francophone, présentait davantage de marqueurs anglais que les modèles américains.
Il insiste enfin sur un point : la présence n’est pas inutile. Elle explique environ 10 % du classement, et les marques les plus citées figurent parmi celles qui se détachent sur la présence. Selon lui, être dans les données d’entraînement permet aussi de rattacher la marque à son contexte : si le modèle ne sait pas que Brevo fait de l’emailing, le lien doit être reconstruit à chaque recherche. Pour une petite marque, il recommande d’acquérir des mentions et de s’insérer dans des comparatifs, même si le gain reste modeste.
Un standard d’audit, un kit et une méthode discutée
Ce que Pierre Sauvé demande à un audit GEO
À sa connaissance, aucun outil commercialisé ne mesure la présence dans les données d’entraînement. Il en fait la première exigence d’un audit, avant de détailler celles qui portent sur la citation :
- Des passages répétés, avec une variance visible. Un passage unique relève du bruit : un client qui teste lui-même ses prompts favoris obtiendra un résultat différent.
- Des appels dans le produit plutôt que par l’API, dont la couche de recherche diffère et dont les réponses sont, selon lui, moins riches.
- Un socle stable (modèle, date, prompts), en ne changeant de modèle que lorsque le modèle par défaut du grand public change.
- Deux indicateurs distincts, présence et citation, parce qu’ils ne bougent pas ensemble.
Il met aussi en garde contre l’usage des log-probabilités exposées par l’API d’OpenAI. On n’y choisit pas la phrase évaluée, il n’y a ni corpus ni appariement, et le modèle comme la recherche évoluent sans cesse. Selon lui, on y mesure une conversation, pas une mémoire.
Ses recommandations suivent la matrice. Pour les marques présentes mais jamais citées : « Arrêtez de payer pour entrer dans les LLM », puisque le blocage se situe dans la récupération. Pour les marques présentes et citées, il conseille d’exiger la variance des prompts et de reprendre la main sur le discours de marque. Pour les marques absentes mais citées, comme Brevo, il recommande de ne rien relâcher et de s’imposer aussi dans les données d’entraînement. Pour les marques absentes et silencieuses, il prévient que le chantier sera long et qu’il faut annoncer délai et budget dès le départ.
Un kit pour tester sa propre marque
Le 2 octobre 2026, Pierre Sauvé a publié sur GitHub un kit sous licence MIT, baptisé brand_probe, qui applique la méthode à une marque à la fois. Il fonctionne en ligne de commande, dans un notebook Colab ou via une petite interface. Le modèle par défaut, Qwen 2.5 1.5B, se télécharge (3 Go) sans compte. Llama et Gemma nécessitent un compte Hugging Face et l’acceptation de leur licence. À l’oral, le consultant a mis en garde contre une possible hausse des coûts de Hugging Face, qu’il présentait comme récemment racheté par NVIDIA.
Le kit fournit :
- La présence dans chaque modèle : marge de catégorie, plancher des noms inventés et verdict (présente si la marge dépasse le plancher de plus de 0,10 nat).
- Le nom parlant : la marge d’un nom inventé qui annonce la catégorie (« Rankzuri » pour le SEO, « Assurvex » pour l’assurance). Sur Qwen 1.5B en français, Assurvex obtient +0,62 nat contre +0,42 pour Groupama.
- Les termes associés : les mots que le modèle rattache à la marque, corrigés de ce qu’il dirait d’un nom inventé.
- La fréquence dans les corpus C4, DCLM et Dolma, et les mots qui accompagnent la marque.
Le README avertit que le kit ne mesure pas la citation. Il résume la position de l’auteur : être dans les poids est une condition d’entrée, pas une cause de citation. Une marque absente des poids n’est jamais citée sans recherche web, mais une marque présente ne l’est pas pour autant. Le document détaille aussi plusieurs pièges :
- Le collage de tokens : infini-gram apparie des séquences de tokens. « Brevo » compte 3 421 occurrences dans C4, dont 98 % correspondent à « Brevoort » (un éditeur de Marvel) ou « Brevoortia » (un poisson). En mot entier, Brevo n’en compte que 53.
- Les homonymes : dans les corpus anglophones, « MAIF » désigne surtout le Maryland Automobile Insurance Fund. Une requête combinée (par exemple « Orange » avec « téléphonie », cité en démonstration) déplace l’équilibre sans tout corriger.
- Les corpus datés : C4 date d’avril 2019, DCLM de 2023 et Dolma de début 2024.
- La taille des modèles : une marque absente à 1,5 milliard de paramètres peut être présente à 9 milliards.
Le script fixe la révision exacte de chaque modèle et refuse la quantification, qui modifierait les log-probabilités. Deux personnes doivent ainsi obtenir la même marge à la décimale près.
Une méthode discutée sur LinkedIn
Notons qu'après la publication de Pierre Sauvé sur LinkedIn, Antony Luvera, CTO chez Maples Labs a contesté le passage entre ce qui est mesuré et ce qui est conclu. Selon lui, comparer des corpus et apparier des volumes de mentions n’isole pas explicitement l’effet de Reddit ou de Wikipédia. Une association marque-catégorie n’explique pas une recommandation. Et une marque connue mais non citée a pu être trouvée, comparée puis écartée, sans qu’il s’agisse d’un problème de récupération. Il estime que la méthode ignore les sources réellement présentes dans la fenêtre de contexte, les informations reprises dans le raisonnement du modèle et les critères de comparaison activés.
Pierre Sauvé reconnaît la justesse du troisième point : sa méthode regroupe les marques « jamais récupérées » et « récupérées puis écartées ». Il précise établir seulement que le blocage ne vient pas de la présence dans les données d’entraînement. Sur Wikipédia et Reddit, il dit conclure à une absence d’effet mesurable à notoriété égale, et non à une absence totale d’effet. Il ajoute qu’observer Reddit dans la fenêtre d’une réponse citant une marque ne prouve pas que Reddit a causé la citation : pour mesurer une contribution, il faudrait retirer la source et rejouer la requête, ce qui est impossible.
Précisons que durant sa présentation au TEKnSEO, Pierre Sauvé avait présenté sa matrice comme une proposition et reconnu à plusieurs reprises les limites de ses mesures statistiques. Antony Luvera soutient par ailleurs que l’analyse fine peut être instrumentée : les modèles exposent le contenu des sources qui entrent dans la fenêtre de contexte, ce qui permet selon lui de relier les données reprises aux choix observés, une fois pondérés par les récurrences entre conversations. Il renvoie vers le livre blanc méthodologique de Maple Labs (maplelabs.fr/technologie). La question de savoir si l’on peut attribuer une citation à une source précise reste donc ouverte entre les deux approches.
L’article "GEO : sur 148 marques, être connu des modèles ne prédit pas la citation, selon Pierre Sauvé" a été publié sur le site Abondance.
-
Apple dévoile le HomeView et nous donne vraiment envie… mais ne le sort pas en France et en Europe
Reply source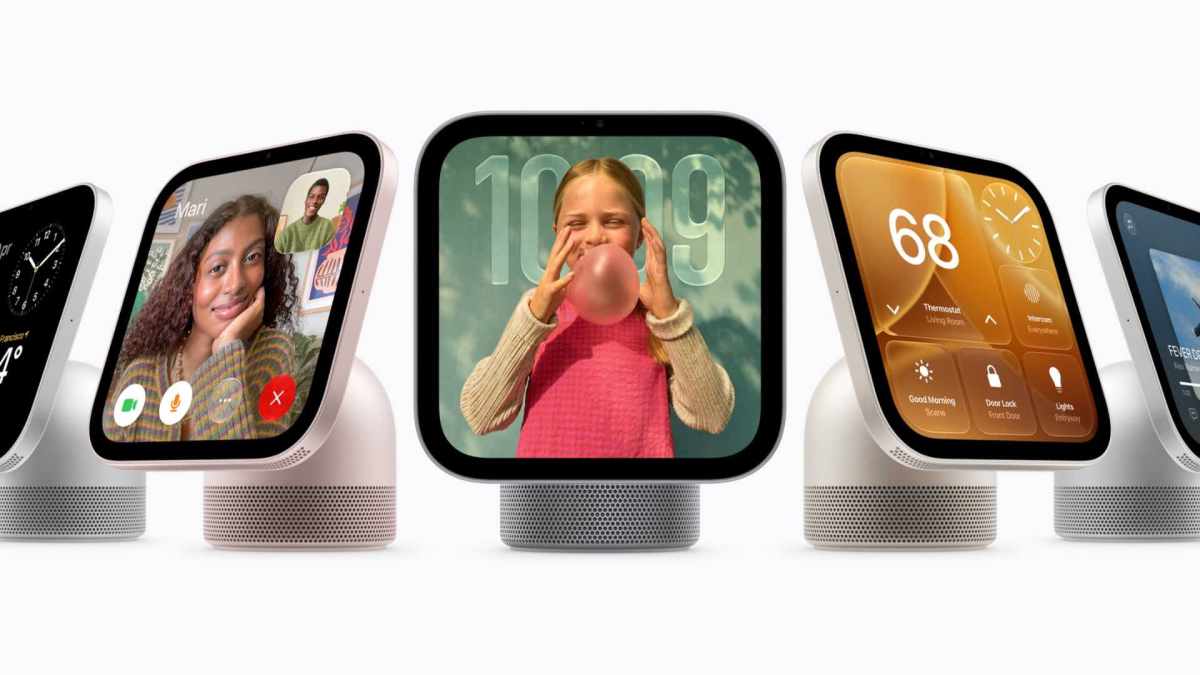
Après des années de rumeurs et de reports, Apple dévoile enfin son premier écran pour la maison : le HomeView. Apple le présente comme le centre de pilotage ultime pour la maison connectée, avec Siri AI aux manettes. Il sortira le 13 novembre aux États-Unis pour 299 dollars… mais pas en Europe, où Apple refuse de le vendre tant que Siri AI y est bloqué.
-
Saint-Denis / Pierrefitte : La parole de nos enfants et élèves compte. Stop aux violences policières !
Le mouvement de contestation de la jeunesse est parti de l'Académie de Créteil et a été très tôt victime de la répression policière. Les organisations locales organisent un rassemblement de soutien au mouvement et…Reply source -
Retrouvez L’Usine Digitale aux Assises de la confiance numérique à Paris le 17 novembre 2026
Reply sourceL’Usine Digitale aura le plaisir de vous retrouver le 17 novembre 2026 au Studio Gabriel, à Paris, à l’occasion des Assises de la confiance numérique. Celles-ci réunissent chaque année les décideurs, experts et praticiens qui font avancer la confiance dans le numérique.
-
Entre incohérences et calculs magiques, le budget du RN réinvente l’austérité et la politique de l’offre
Dans son plan budgétaire pour le prochain quinquennat, Marine Le Pen prévoit des coupes drastiques sur la Sécurité sociale et les services publics. Mais aussi de nouvelles baisses d’impôts pour les entreprises et les plus aisés.Reply source -
Sony lance une PS5 noire deux fois moins chère pour GTA 6 (mais pas en France)
Reply source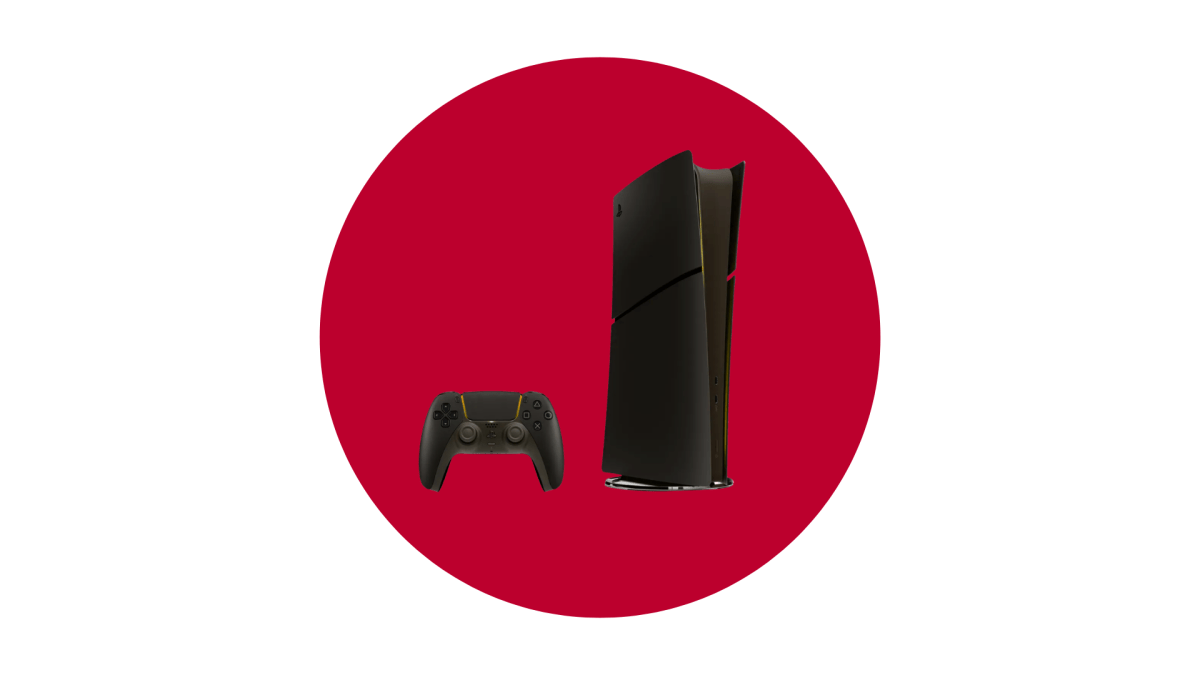
La branche japonaise de PlayStation lance un nouveau modèle de PS5. Pour 55 000 yens, soit environ 310 €, les joueurs japonais pourront s'offrir cette PS5 le 19 novembre, le jour de la sortie de GTA 6.
-
«On vit sous la pression de l’occupant»: aux frontières de la Géorgie, la grande peur de l’impérialisme russe
L’élection d’un fidèle du Kremlin à la présidence de l’Ossétie du Sud, en septembre, est venue confirmer l’annexion «de facto» de cette partie du territoire géorgien par la Russie, occupée depuis 2008. Sur la ligne de démarcation, les plaies sont toujours béantes.Reply source -
Surprise : No Man’s Sky débarque sur iPhone et iPad
Reply source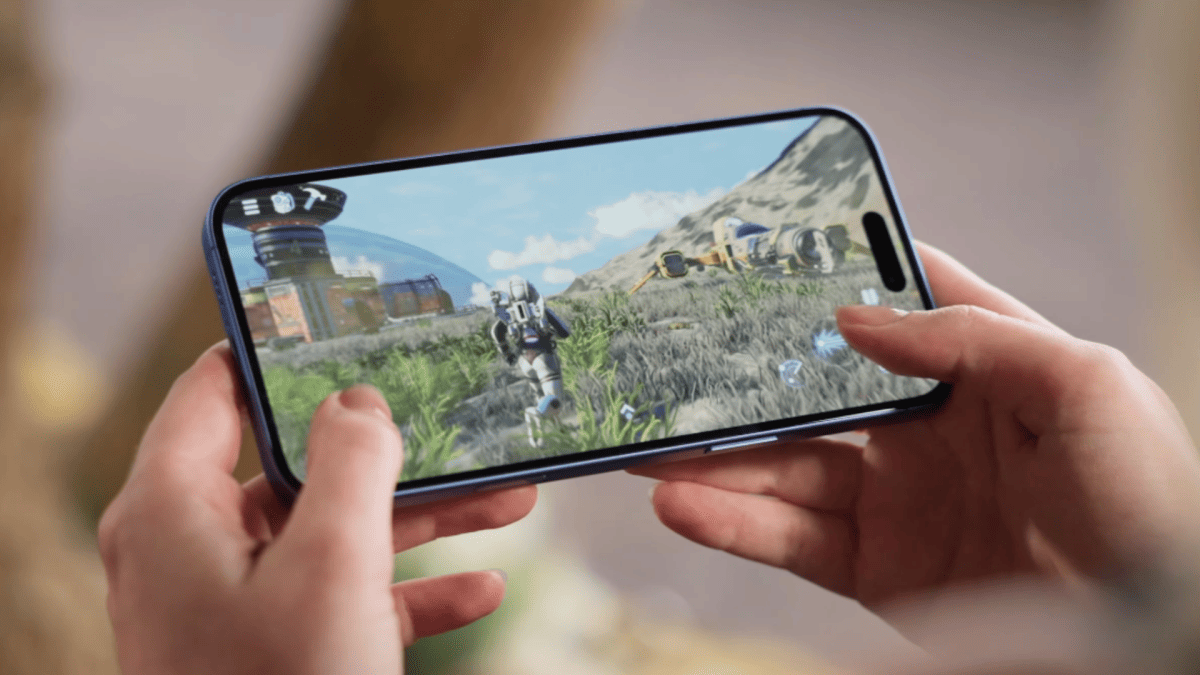
Dix ans après une sortie pour le moins chaotique, No Man’s Sky s’apprête à débarquer sur iPhone et iPad. Un bel arc de rédemption pour un jeu que beaucoup pensaient condamné dès son lancement, avant que Hello Games ne le transforme, mise à jour après mise à jour, en une aventure bien plus ambitieuse.
-
Judge Orders Trump To Stop Airing Taxpayer-Funded Midterm Propaganda Ads (For Now)
Reply sourceLast week, the DNC sued the Trump administration for using $20 million in taxpayer money on strange and ineffective midterm ads. The use of taxpayer money technically violates multiple laws (remember those?), including the Hatch Act and Federal Appropriations Laws restricting taxpayer-funded propaganda.
Trump’s now been ordered to stop airing the ads entirely courtesy of a temporary restraining order issued by U.S. District Judge Jennifer Rochon. The TRO was requested by nonprofit government watchdog group Common Cause which is leading a lawsuit against the propaganda spots.
Advertising data indicates that Trump administration ignored the judge and ran several of the ads on Monday anyway, something the latest filing by Common Cause and allies was quick to point out:
1. On October 12, at 1:31 p.m. Eastern, the Washington Post reported that two ads continued airing after the Court issued the Order and into the early hours of Monday, October 12, on multiple programs, including “60 Minutes,” “ABC World News Tonight,” and “America’s Funniest Home Videos.” Ex. A.
2. According to AdImpact data retrieved at 2:45 p.m. Eastern today, Defendants’ ads ran in nearly 400 spots on programs that began airing at 7 p.m. Eastern last night—that is, after this Court’s order was in effect. Ex. B
The Trump administration says it has already spent $19 of the $20 million allotted for the ads. In an attempt to pretend they weren’t breaking the law, the Trump administration falsely claimed that the propaganda efforts were “public service announcements” from US Customs and Border Protection — despite the fact that no government service or program was being advertised.
On October 5 Trump responded to backlash by insisting he’d stop using taxpayer money for the ads and instead fund them via his SuperPAC. But not only is it not legal for Trump to direct his SuperPAC in such a fashion, he clearly lied and never actually stopped using taxpayer money to fund the ads, which continued to air.
The TRO is scheduled to remain in effect for 14 days, and is “subject to an extension,” Rochon said.
“Taking $20 million from a fund that Congress voted to use on border patrol, then spending it on vanity ads for an unpopular president, breaks the checks and balances set in the Constitution,” Common Cause said in statement. “If the Trump administration wanted to use money on personal promotional ads, they should have asked Congress to pass a bill to do so.”
The grand irony is despite illegally stealing taxpayer money to fund the midterm ads, the ads themselves (several of which are just rehashed version of 2024 ads) are only likely to harm vulnerable Republicans now tethered to a disastrous war and Trump’s sinking health, polling, and political power.
-
Test FR-Alert ce mardi : si votre téléphone a sonné sans crier gare, voilà pourquoi
Reply source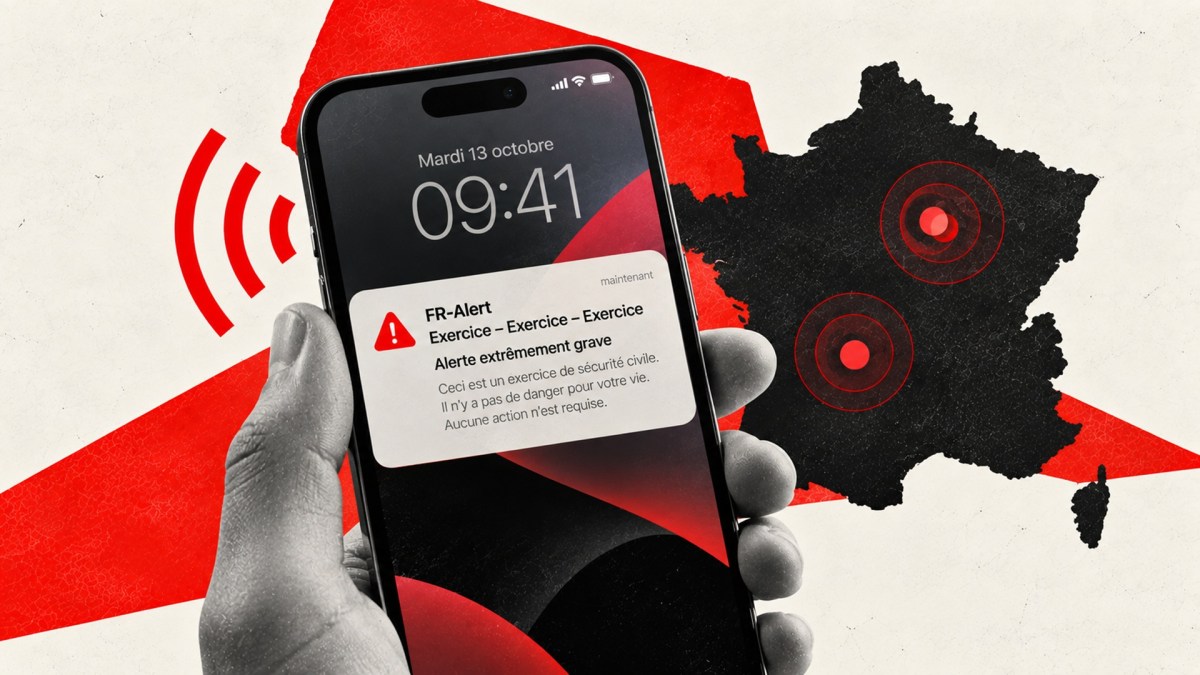
Ce mardi 13 octobre 2026, la préfecture de Seine-et-Marne teste FR-Alert dans 56 communes entre 9 heures et 10 heures. Celle du Lot le fait entre 9 heures et midi, et son message peut aussi arriver sur des téléphones en Corrèze.
-
GitLab - Encore une faille CVSS 10 #FautPatcher
Reply sourceHier, GitLab a publié en urgence les versions 19.4.2, 19.3.5 et 19.2.8 pour corriger une faille un peu chaude avec un score CVSS de 10 sur 10 . Référencée sous le code CVE-2026-97229, elle permet à quelqu'un sans compte user d'exécuter du code sur le serveur en glissant tout simplement une expression régulière piégée dans une configuration CI/CD.
GitLab précise que cela ne peut se faire que "sous certaines conditions" sans préciser lesquelles, et il ne dit pas non plus comment un inconnu pourrait faire lire sa config CI forgée par une instance. Gitlab mentionne une histoire de dépassement d'entier dans le compilateur de regex du CI/CD et d'une validation insuffisante des expressions mais on n'a pas les détails techniques qui sortiront dans environ 90 jours. C'est habituel pour laisser le temps à tout le monde de patcher.
Ces dernières semaines, ça enchaine fort ( un peu comme Citrix ) avec fin septembre, la 19.4.1 qui corrigeait déjà deux autres faille sur le même terrain : CVE-2026-93577, pour un dépassement d'entier dans le compilateur, et CVE-2026-89078, pour un double free dans l'analyseur de regex. Notées 9,9 toutes les deux et signalées par le même chercheur (joaxcar), mais celles-là exigeaient au moins un compte. Et la troisième faille (la CVE-2026-85706) découverte aussi courant septembre, était quand a elle aussi notée 10 sur 10 et permettait de lire les fichiers présents sur le serveur sans avoir de compte.
Alors qui est concerné ?
Hé bien toutes les instances auto-hébergées en 19.2 avant la 19.2.8, en 19.3 avant la 19.3.5 et en 19.4 avant la 19.4.2. Une 19.4.1 installée fin septembre n'est donc pas à l'abri. Le service GitLab.com en lui-même est déjà à jour et les clients serveur dédié n'ont rien à faire. Mais pour les autres, l'alerte de sécurité ne mentionne aucun contournement / fix. Faut juste mettre à jour et basta.
Sur une instance mono-nœud, prévoyez donc une coupure, parce que ce correctif embarque des migrations de base qui exigeront un reboot.
Voilà, maintenant que vous êtes au jus, c'est le moment de patcher !!
Source : BleepingComputer .
-
Un data center équipé par AMD en Finlande, plus de modèles et des services IA ajoutés à son catalogue... Scaleway se rêve en alternative européenne face aux géants américains
Reply sourceScaleway entend profiter de la course à l’intelligence artificielle pour changer de dimension. À l’occasion de sa conférence ai-PULSE, organisée le 13 octobre 2026 à Paris, le fournisseur français de cloud annonce le déploiement en Suède d’un supercalculateur équipé de processeurs graphiques AMD Instinct MI355X. Il revendique « une première européenne », selon les mots de son patron, Damien Lucas, pour un supercalculateur AMD dédié à l’intelligence artificielle et destiné à un usage commercial. Surtout, ce projet constitue le premier déploiement d’un supercalculateur de Scaleway hors de France.
-
Filmer la police, puis flouter les visages avant de publier
Reply sourceEn France, même si ça les défrise, un policier ou un gendarme en service ne peut pas s'opposer à ce qu'on l'enregistre (vidéo, photo et son), tant qu'on n'est pas dans un lieu privé. C'est la Défenseure des droits qui l'a rappelé dans un avis de 2020, en s'appuyant sur une circulaire de 2008 du ministère de l'Intérieur, excluant aussi qu'on vous interpelle ou qu'on vous retire votre matériel pour ça .
J'irais même plus loin en disant que filmer est même un devoir, tant ça peut vite déraper d'un côté comme de l'autre...
Bref, filmer est donc un droit acquis, mais publier l'enregistrement c'est autre chose... Le Conseil constitutionnel ayant censuré en 2021 le délit de provocation à l'identification des policiers prévu par la loi Sécurité globale, parce que le texte était trop imprécis, il ne nous reste que l' article 223-1-1 du Code pénal , qui punit de 3 ans de prison et 45 000 euros d'amende le fait de diffuser des informations permettant d'identifier quelqu'un dans le but de l'exposer à un risque direct d'atteinte. Et ça monte à 5 ans et 75 000 euros si la personne est dépositaire de l'autorité publique.
En langage clair et en théorie, cela veut dire que publier le visage d'un policier ne suffit pas à faire un délit... C'est l'intention d'exposer qui doit être prise en compte, et la LDH le rappelle, il n'y a aucune obligation légale qui impose de flouter les agents.
Reste que flouter est LE choix de la prudence, parce qu'une vidéo est là pour documenter des faits et pas pour afficher des personnes. Et surtout ça vous évite tout procès d'intention. La Défenseure des droits juge d'ailleurs que publier des images d'interventions de police est légitime et nécessaire dans une société démocratique, donc même s'il y floutage de visage, ça ne retire rien au document : les gestes, les mots et le contexte restent à l'image.
Mais attention, le floutage ne vous protège pas non plus de tout puisque si vous n'êtes ni journaliste ni en train de constituer une preuve en justice, diffuser des images de violences peut vous exposer à 5 ans de prison, au titre de l'article 222-33-3, d'après ce qu'explique la LDH.

Après, en ce qui concerne le visage des manifestants, c'est également très bien de les flouter puisque le fichier TAJ des antécédents judiciaires peut être interrogé par reconnaissance faciale, et le Sénat a dénombré 498 871 consultations de ce type en 2021 rien pour la seule police nationale. Donc j'imagine pas en 2026...
Reste le côté "pratique" de la chose, parce que flouter une vidéo à la main, image par image, c'est pas si simple quand on ne maitrise pas les outils de montage vidéo. Mais il y a une application web libre nommée Masque du collectif onestla.tech qui vous permet d'uploader des photos, en lot (avec ZIP à la sortie), ou une vidéo, et celui-ci masquera tous les visages. Tout se passe uniquement dans votre navigateur (rien n'est envoyé sur des serveurs tiers) et une fois chargée l'appli peut même fonctionner offline sur votre téléphone par exemple.
Chaque masque peut ainsi être revu avant l'export, et pour un visage raté, il suffit de glisser le doigt ou la souris dessus pour l'ajouter. Le fichier qui sort ensuite a été totalement nettoyé de ses métadonnées (ni EXIF, ni GPS, ni date de création) et porte un nom aléatoire. Comparé au floutage ou à la mosaïque, notez que le style "Solid" qui met un calque noir ou Emoji sur les visages sont les plus safe pour protéger l'anonymat des personnes.

Après, oui, la détection automatique peut manquer des visages, et les vêtements, les tatouages, les banderoles ou encore les lieux permettent évidemment d'identifier encore des gens donc là faudra se relever un peu plus les manches pour sécuriser à fond la vidéo Et pour le son, si vous en avez besoin, Masque propose une option "Supprimer le son" en précisant que les voix peuvent également permettre d'identifier des personnes, donc pensez-y avant de publier si le son n'a pas d'utilité. Sinon, trouvez un outil pour modifier les voix afin qu'on puisse quand même savoir ce qui est dit mais sans reconnaitre la voix des personnes.
Voilà, ce projet est tout jeune mais je l'ai trouvé bien utile. Et si vous filmez pour documenter, gardez bien évidemment l'original dans un endroit safe que vous maîtrisez, sachant que votre téléphone l'a peut-être déjà envoyé dans un cloud.
Ah et si Masque ne vous convient pas, il y a aussi deface , que j'avais déjà présenté et dont Masque reprend le modèle de détection.
C'est un outil en ligne de commande qui tourne sous Linux, Windows et macOS,
python3 -m pip install defacepuisdeface video.mp4, qui détecte les visages image par image et les floute ou les cache sous des boîtes noires. Pas d'interface graphique prévue cependant et l'audio est viré par défaut.Et pour les photos uniquement, tout le monde l'ignore mais Signal a un outil de floutage dans son éditeur d'images depuis 2020, sur Android et iOS, avec un traitement à 100% local. Sa détection, elle non plus, ne trouve pas tous les visages à coup sûr, d'où le pinceau pour flouter à la main ce qu'elle a raté mais c'est aussi très pratique. Ah et j'avais aussi parlé de cet outil gratuit pour anonymiser les photos de manifs si vous voulez en essayer encore un autre.
Bref, filmez partout et tout le temps mais pensez bien à flouter avant de publier quoi que ce soit et surtout à garder l'original au chaud pour aider les victimes plus tard.
Source : le dépôt de Masque
-
Is punishing the poor Trump’s last hand to play?
Reply sourceThe pre-midterm defenestration of ACA enrollees looks like political madness – but the president appears to believe hitting poor people might work for him
There is a manic quality to Donald Trump’s desperate dash to do something, anything, ahead of November’s midterm elections to convince beleaguered Americans that he can make the pressures his policies have imposed on their livelihoods go away.
The US president offered to lower barriers against beef imports to limit surging meat prices, only to consider backtracking under pressure from the cow lobby. He offered to stop diesel exports, only to find oil companies were not interested. He weakened fuel efficiency standards, claiming this would trim the price of a new car (and forgetting to point out it will also raise spending on gas.) In early October he started mailing $500 checks to nearly a million people touting his healthcare “wins”. Oh, and he promised adult Americans a $5,000 check if Republicans maintain control of Congress. That, too, will go nowhere.
Continue reading... -
« Un milliardaire paye proportionnellement moins d'impôts qu'une infirmière » : Oxfam porte plainte contre l'État pour rupture d'égalité devant l'impôt
Reply source Source : L'Humanité
Payant
-
Israël a démoli la majeure partie des villages du sud du Liban — principalement après le cessez-le-feu (Anglais)
Reply source Source : Common Dreams - États-Unis
Lire la traduction automatique en français
-
Les vélis accélèrent dans la montagne thiernoise
Reply source Source : Tikographie
-
Le Portugal descend dans la rue pour le droit au logement : « Comme en Espagne, tout le monde dans la rue » (Espagnol)
Reply source Source : El Salto - Espagne
Lire la traduction automatique en français
-
Au rythme actuel, la France deviendrait le pays le plus endetté de l'Union au cours des années 2030
Reply source Source : Le Grand Continent
-
Inde : entre choc, colère et répression, pourquoi une révision électorale controversée a suscité l'indignation (Anglais)
Reply source Source : The Guardian - Royaume-Uni
Lire la traduction automatique en français
-
GOP Accepts $296M Bribe to Protect African Immigrant CSAM Purveyor
Reply source
There are several ways to understand the $276M Elon Musk is spending to keep right wingers in power, to say nothing of the election disinformation he is spreading.In an effort to save Republicans’ Senate majority, he gave a total of $158 million this summer to the Senate Leadership Fund, the main super PAC backing the party’s candidates for the chamber, according to his team. In sum, that is one of the largest political donations in American history, and more than the group’s Democratic rival raised from all of its donors that quarter.
Mr. Musk has also built a major Republican turnout operation through a super PAC he founded in 2024, America PAC. He donated over $76 million this summer to the group, which in turn spent that much on building a sprawling canvassing program to try to turn out hard-to-reach Republican voters. The group is active in seven Senate battlegrounds and nearly three dozen House races.
[snip]
Beyond Mr. Musk’s donations to his super PAC and the Senate Leadership Fund, his representatives said that from July through September, he had given smaller but still substantial amounts to other conservative groups:
- $20 million to the Congressional Leadership Fund, the main super PAC for House Republicans
- $10 million to Lone Star Liberty PAC, a group supporting Ken Paxton, the Republican nominee for Senate in Texas
- $10 million to the Republican Governors Association
- $2 million to the Republican Attorneys General Association
On the one hand, it implicates every right winger accepting this money in the AI CSAM Elon Musk’s robot was disseminating earlier this year.
Here’s how three Tennessee teenagers (one has turned 18 since this happened) described having their photos turned into non-consensual CSAM material by Grok in a lawsuit filed in March.
79. Eventually, the anonymous user sent Jane Doe 1 a series of AI-generated images and videos which depicted her as well as other minor females. Jane Doe 1 was immediately disturbed by the sexually explicit content. At least five of these files, one video and four images, depicted her actual face and body in settings with which she was familiar, but morphed into sexually explicit poses. The images showed her entire body, including her genitals, without any clothes. The video depicted her undressing until she was entirely nude.
[snip]
90. On or about February 12, 2026, Jane Doe 2 learned through the ongoing criminal investigation that at least two of her images had also been used by the perpetrator to produce AI-generated CSAM using xAI. Local law enforcement informed Jane Doe 2, a minor, and her mother that these images included one photograph taken of Jane Doe 2 on the beach in a blue bikini which had been morphed to depict her without any clothes. Jane Doe 2 reviewed her Instagram photographs and found a series of images taken on October 12, 2025, depicting her in a blue bikini top in a beach setting.
[snip]
100. Local law enforcement informed Jane Doe 3, a minor, and her mother that the AI-generated images found on the perpetrator’s phone included one image of Jane Doe 3 which had been morphed to depict her fully nude.
Here’s how another victim described how hashed CSAM images of her created decades ago, when she was preschool-aged, got used and disseminated in Grok’s training set.
85. Plaintiff was preschool-aged when she was first repeatedly raped and sexually exploited by an adult male to produce CSAM to meet the demands of pedophiles on the internet. This abuse continued for years. The child sex abuse images and videos depicting her child sexual abuse will forever memorialize Plaintiff being forced to endure horrific crimes as a young child.
86. Plaintiff was repeatedly raped and sexually abused as a minor specifically to produce CSAM to share on the internet, which continues to circulate online to the present day. CSAM depicting Plaintiff has been previously hashed and included in the NCMEC Child Sexual Abuse Material Hash List and Plaintiff was identified by NCMEC in this material.
87. CSAM depicting Plaintiff has been found on xAI as part of investigative reporting, takedown request efforts, and criminal investigations, arrests, and convictions for violations of state and federal laws. Indeed, online forums of offenders include messages between offenders chatting about creating AI generated CSAM of Plaintiff and other similarly situated known, legacy, victims of CSAM.
88. CSAM depicting Plaintiff with its longstanding well-known hash values has been used as a part of the dataset used by xAI.
Another complaint (these will likely all be joined) describes how a photographer who did school photos in Arkansas used some of those photos to develop CSAM, including both girls and boys, using Elon’s robot.
107. On June 8, 2026, the Bentonville Police Department received a CyberTip from NCMEC reporting that X.AI LLC had flagged content associated with an account linked to Bloodworth.
108. On June 10, 2026, Bentonville police executed a search warrant at Bloodworth’s residence seeking, among other things, devices capable of accessing Grok. Upon accessing Bloodworth’s phone, officers discovered a hidden photo folder containing approximately 1,700 images and videos of prepubescent and pubescent children in various states of undress and in sexually explicit poses. Some of these images and videos were, on information and belief, produced using Grok, and others appeared to be genuine photographs.
112. During the relevant period, Jane Doe I was a young child enrolled at a school in Arkansas that had retained Bloodworth to provide school photograph services, including formal portraits and candid classroom photography.
113. Bloodworth photographed Jane Doe I on at least one occasion using a professional camera during a formal school photography session.
114. Law enforcement identified Jane Doe I among the images recovered from Bloodworth’s device and, in early July 2026, notified Jane Doe I’s guardians that images of Jane Doe I had been identified among the material recovered from Bloodworth’s phone.
A report in June described how Grok has increasingly relied on porn traffic to keep up with competitors.
- The report claims xAI is actively doubling down on its explicit video and image-generation tools and that adult-content dominance extends into Grok’s coding model, which The Information reports frequently receives requests for pornographic material.
- Well over half of Grok’s overall traffic is driven by pornographic images and videos, adult role-play chats or other such activity, according to the report, which Vital Knowledge analyst Adam Crisafulli called “a desperate attempt for relevancy.”
- The move comes as xAI has “fallen further behind” competitor chatbots from Anthropic, OpenAI, Google and Meta, per Crisafulli, and Grok recorded the largest drop in web traffic of any single AI model this year, Similarweb data shows.
Elon Musk is using nonconsensual porn to compete. And children are being abused in the process.
And the entire Republican Party is accepting his filthy money.
But that’s not all. Elon Musk committed visa fraud when he first started working in the US — the kind of alleged visa fraud Trump is using to target Ilhan Omar (with the critical difference that Omar was a child when she came to the US).
South African-born Elon Musk worked illegally in the United States as he launched his entrepreneurial career after ditching a graduate studies program in California, according to former business associates, court records and company documents obtained by The Washington Post.
[snip]
What Musk has not publicly disclosed is that he did not have the legal right to work while building the company that became Zip2, which sold for about $300 million in 1999. It was Musk’s steppingstone to Tesla and the other ventures that have made him the world’s wealthiest person — and arguably America’s most successful immigrant.
This is the kind of violation that Stephen Miller is using to deport other African immigrants, even while Stephen’s spouse remains one of Elon’s loudest propagandists.
Worse still for the right wing’s favorite African immigrant, DOJ has started filing denaturalization cases against immigrants. While most target people — like Ghislaine Maxwell, though she has not been targeted — who hid their crimes when they naturalized, the effort also focuses on people engaged in CSAM dissemination.
Elon Musk is at least accused of doing everything the far right claims to hate: An allegedly illegal African immigrant who came to the US and started preying on children.
Yet they are taking every cent he pays them in hopes to cling to power.
Elon Musk clings to AI porn to remain competitive, and self-imagined immigration hard-liners cling to him.
Dockets
As noted above, these cases are in the process of being consolidated. So far, these dockets are included in the motion to consolidate, with a request to certify a class.
Doe 1 v. X.AI Corp. (5:26-cv-02246): A man in Tennessee groomed three teenagers and used their photos, including a Homecoming photo and a yearbook photo, to generate CSAM (they are teenagers, though one has turned 18) on Grok; he then disseminated the images on Discord.
Doe I v. X.AI Corp. (3:26-cv-08567): A school photographer in Bentonville, Arkansas, Russell Bloodworth, used pictures he took at schools, of both girls and boys, to generate CSAM using Grok; xAI referred the photos to NCMEC.
DOE v. X.AI Corp. (5:26-cv-00772): The photo an adult woman in Denmark, South Carolina posted on January 2 was turned into nonconsensual porn on January 3; it took three days to get Xitter to take down the nonconsensual porn. Grok agreed that the photo was “shitty” and “invasive.”
Doe 1 v. X.AI Corp. (5:26-cv-09016): CSAM, including rape, created when a woman was preschool-aged, has been used to create new CSAM using Grok, with criminals discussing doing so in CSAM fora.
Jane Doe 1 v. X.AI Corp. (5:26-cv-09617): A Pennsylvania man accessed photos of three women from when they were teenagers from a victim’s Apple iCloud account and used Grok to make them into CSAM. [Content warning: Four particularly explicit descriptions of CSAM.] When arrested he said, “he was just using a computer program.”
The post GOP Accepts $296M Bribe to Protect African Immigrant CSAM Purveyor appeared first on emptywheel.
-
Kimberly Guilfoyle denies allegations of misconduct as she resigns as US ambassador to Greece – live
Reply sourceGuilfoyle has been under immense scrutiny after the Wall Street Journal reported on a series of questionable acts prior to securing her role in Athens
Ahead of her White House podium debut, Katie Zacharia reportedly monitored Donald Trump’s public schedule every day, and monitored his Truth Social, and made sure she was on-air when she assumed he might be watching, according to Politico, citing a person familiar with the matter.
That source noted that and a number of high-profile conservative anchors – including from Fox News, Newsmax and OANN – also backed Zacharia for press secretary. She is now set to the sixth person to hold the role throughout both of Trump’s terms in office.
Continue reading... -
Trump's worse-than-useless Russian diesel deal
Rising gas and diesel prices are a major reason Republicans risk losing the House and possibly the Senate in November, but President Donald Trump's energy deal with Russia will not fix that. It is too tiny and comes too late to change anyone's mind about the economy. Worse, it provides much-needed economic relief to a Russian war machine that continues its unrelenting attacks on Ukraine.Reply source -
« Le monde entier regarde ce que vous faites » : Greta Thunberg rejoint les lycéens de Seine-Saint-Denis
Reply source
Greta Thunberg est venue soutenir le mouvement des lycéens dans un lycée de Seine-Saint-Denis, le 13 octobre. « On est derrière vous », a affirmé la militante pour la justice climatique.
Lire la suite - En bref / Luttes
Elle est venue soutenir les lycéens en colère. Greta Thunberg était présente devant le lycée Paul-Éluard à Saint-Denis, en Seine-Saint-Denis, mardi 13 octobre au matin. La militante pour la justice climatique de 23 ans a choisi de se rendre dans l'un des épicentres du mouvement, un lycée bloqué depuis (…) -
« On est derrière vous » : Greta Thunberg rejoint les lycéens de Seine-Saint-Denis
Reply source
Greta Thunberg est venue soutenir le mouvement des lycéens dans un lycée de Seine-Saint-Denis, le 13 octobre. « Le monde entier regarde ce que vous faites », a déclaré la militante pour la justice climatique.
Lire la suite - En bref / Luttes
Elle est venue soutenir les lycéens en colère. Greta Thunberg était présente devant le lycée Paul-Éluard à Saint-Denis, en Seine-Saint-Denis, mardi 13 octobre au matin. La militante pour la justice climatique de 23 ans a choisi de se rendre dans l'un des épicentres du mouvement, un (…) -
Judge blasts Trump's DOJ over 'inexcusable' tree removal at DC golf course
A US judge said on Monday that she was "furious" with Justice Department lawyers for their conduct in a lawsuit seeking to halt the Trump administration's takeover of a historic golf course in Washington, saying it was "inexcusable" that hundreds of trees were removed from the course over the weekend. "More than being upset and furious right now, I am just deeply disappointed in the government," US District Judge Ana Reyes in Washington told government lawyers during a court hearing. "On what universe did anyone in your office think this was acceptable?"Reply source -
‘No one’s here, no one knows’: north-east Ohio is ground zero for ICE flights
Reply sourceAway from the public eye, deportation planes at Youngstown-Warren and Akron-Canton airports carry hundreds of immigrants daily amid Trump’s ICE crackdown
Just after 10.30am on a recent weekday morning, a Bombardier CRJ200 Air Wisconsin aircraft landed at Youngstown-Warren regional airport.
Having made the 75-minute flight from Milwaukee, the 50-seater came to a halt and its twin engines fired down next to another Air Wisconsin plane and a larger Eastern Air Express Boeing 737, planes that flew in the evening before from Alexandria, Louisiana.
Continue reading... -
Millions of Medicaid recipients to face draconian requirements as of 1 January
Reply sourceTrump’s reform law that seeks to make coverage harder to get, and to keep, includes working 80 hours a month
It is a date keeping US healthcare providers up at night: 1 January 2027.
As the midterm elections loom, everyone from hospital leaders and to patient advocates are focused on the New Year, when Republicans scheduled the most controversial elements of their healthcare reform law to go into effect.
Continue reading... -
Attention à cette fausse vidéo qui affirme que 140 millions de dollars destinés à Volodymyr Zelensky ont été saisis en Ukraine
Reply source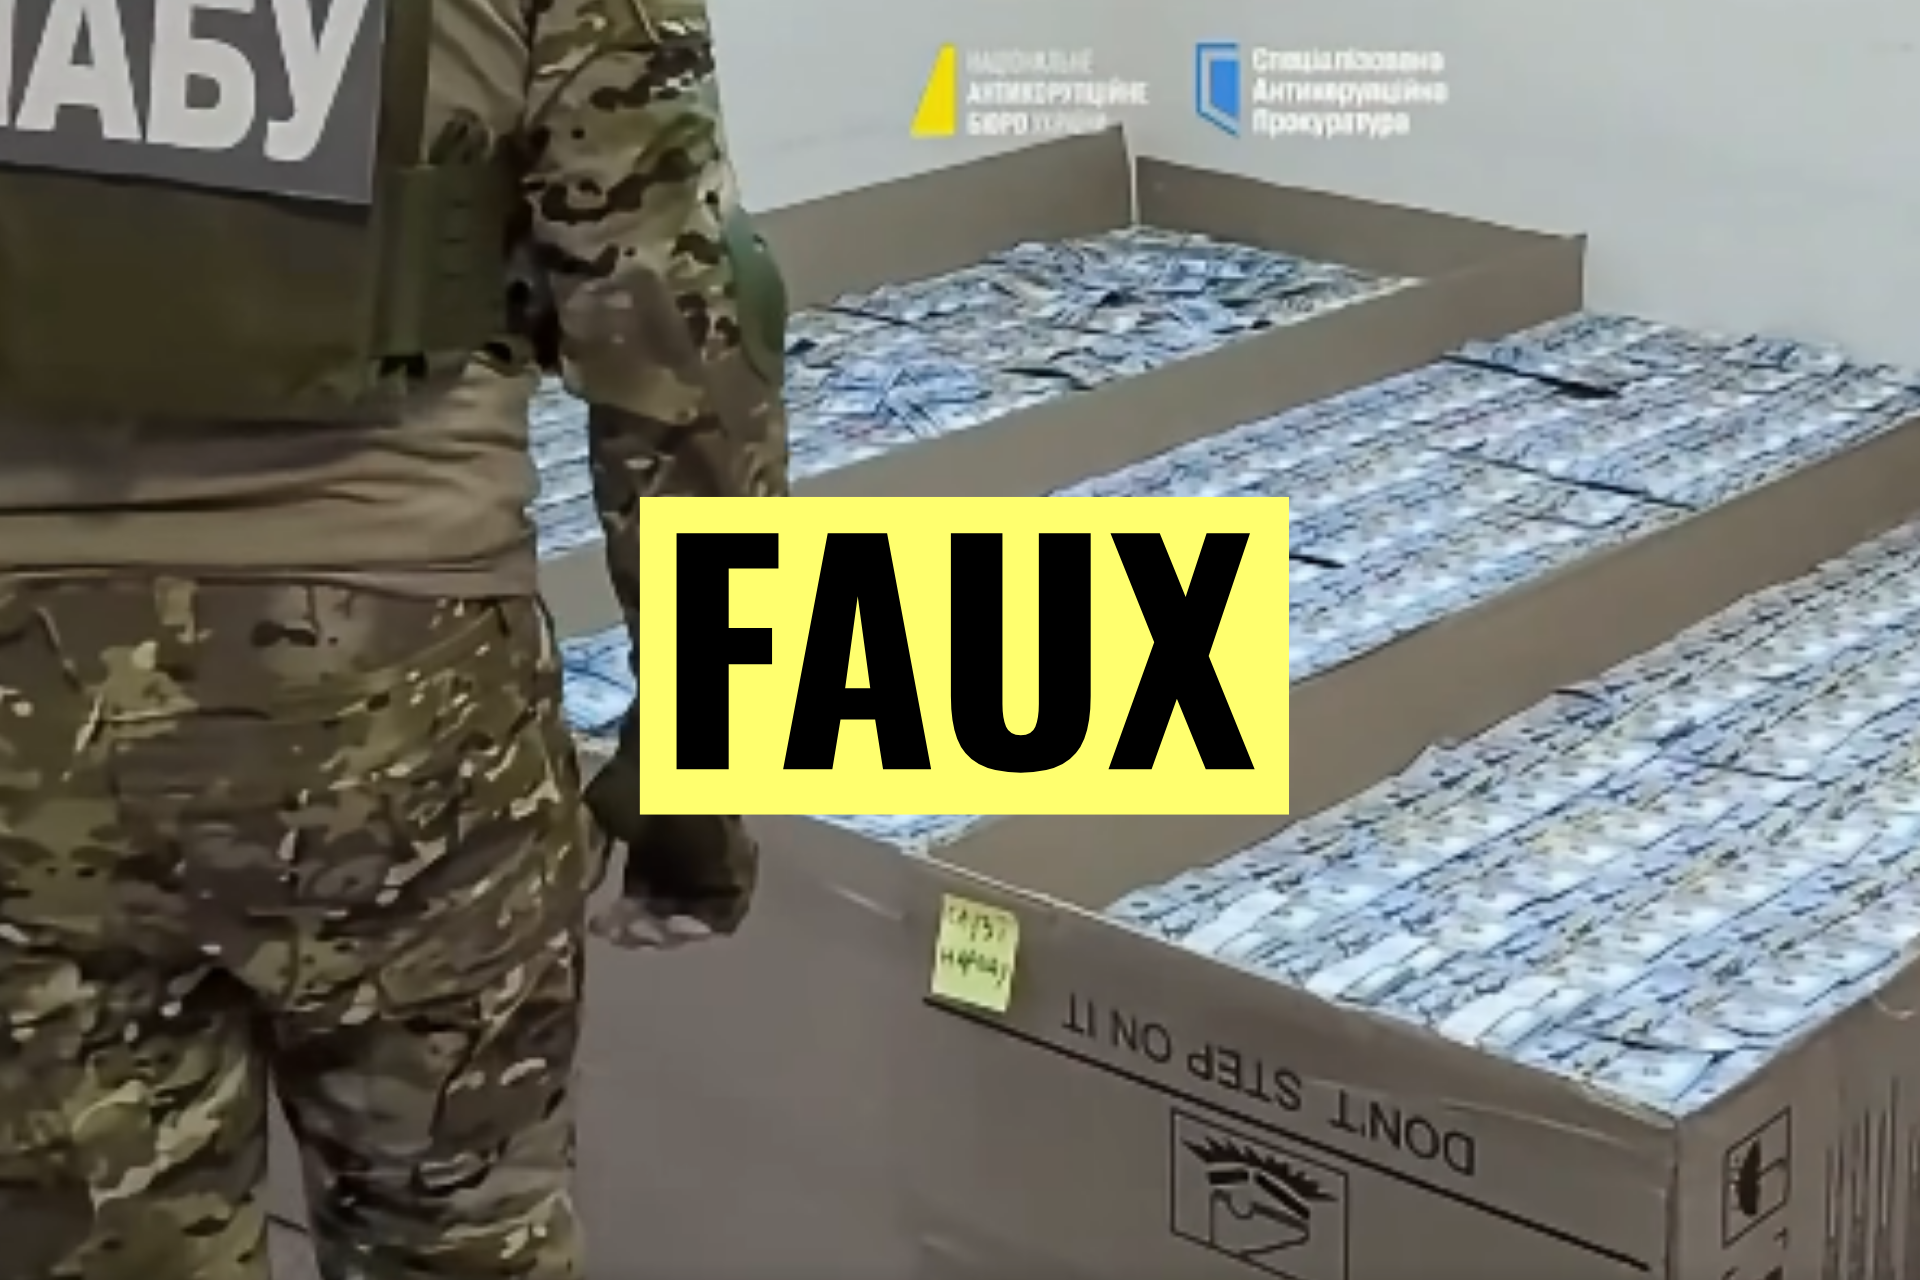
Source :Compte Facebook, le 24 septembre 2026
Etiqe :Faux
Contenu :
Le bureau anticorruption ukrainien aurait fait une trouvaille de taille : « 140 millions de dollars » saisis « lors d’une perquisition au domicile de l’ancien directeur des achats de défense de l’Ukraine », Arsen Zhumadilov, « le 23 septembre [2026] ». Ces fonds auraient été destinés à Volodymyr Zelensky, le président ukrainien, à en croire les allégations qui circulent sur Facebook (ici) et Instagram (ici, ici et ici).
Ces propos accompagnent une vidéo censée attester de la découverte. On peut y voir des liasses de billets de 100 dollars, entassées dans trois grands cartons de réfrigérateurs, et deux agents du NABU (НАБУ), le Bureau national anticorruption d’Ukraine. Sur les cartons, un papier collé adresse les colis au « Serviteur du peuple », autrement dit Volodymyr Zelensky, en référence à son rôle dans une série télévisée éponyme, diffusée avant qu’il ne se lance en politique au sein d’un parti portant également ce nom.
Mais loin de fournir une preuve de la corruption du chef d’État, ces images seraient générées par intelligence artificielle, indique le NABU. Plusieurs médias de différents pays sont parvenus à la même conclusion, comme nos confrères de Lead Stories (international), dpa (Allemagne), Myth Detector (Estonie et Allemagne), Factcheck.bg (Bulgarie), VRT NWS (Belgique), Open (Italie), FakeNews.pl (Pologne) ou encore Detector Media (Ukraine).
Une vidéo générée par IA d’après le bureau anticorruption
« Il s’agit d’une vidéo truquée, générée par intelligence artificielle, a démenti le NABU dans un communiqué, le 25 septembre 2026. Ce type de contenu illustre clairement comment l’ennemi [la Russie, en guerre ouverte contre l’Ukraine depuis l’invasion à grande échelle du pays le 24 février 2022, ndlr] a de plus en plus recours à des outils d’IA de pointe pour mener une guerre de l’information. » Cette vidéo aurait été conçue pour « discréditer les organismes indépendants de lutte contre la corruption, d’éroder la confiance envers les institutions de l’État et de nuire à la réputation de l’Ukraine ».
Le bureau anticorruption ukrainien rappelle également que les seules sources fiables le concernant sont ses canaux officiels. Sur son site internet, l’organisme ne mentionne aucune perquisition chez Arsen Zhumadilov ni une quelconque saisie de 140 millions de dollars.
Le site d’un média copié pour diffuser la vidéo
L’itinéraire de la vidéo laisse penser à une opération de manipulation typique des désinformations russes. Le clip a été publié sur un site répliquant celui du média The New Voice of Ukraine, lequel a dénoncé une falsification de son identité graphique. Dans ce faux article, publié le 23 septembre 2026, apparaissent la vidéo et le descriptif de la prétendue perquisition – qui aurait eu lieu à la même date.
« The New Voice rejette catégoriquement les allégations contenues dans cet article et n’a participé ni à sa création ni à sa publication », a déclaré le média, le 25 septembre. « Après avoir été informée de l’existence de ce site web, notre rédaction a immédiatement contacté toutes les autorités compétentes et a ouvert une enquête interne sur cette affaire [et depuis publié un article de fact-checking sur la vidéo, ndlr]. Nous avons déjà découvert que cette histoire avait été diffusée par des organes de désinformation russes connus avant même le lancement de ce faux site web », a déclaré le chef d’édition du média, Romeo Kokriatski.
Le nom de domaine du faux site web (nvukraine.com) a été enregistré deux jours avant la publication du faux article, le 21 septembre. Celui du média The New Voice of Ukraine étant english.nv.ua, pour la version anglophone, ou nv.ua, en ukrainien.
Une énième campagne de désinformation russe
Le Centre de communications stratégiques et de sécurité de l’information de l’Ukraine (SPRAVDI) a retracé les étapes de ce qu’il présente comme une campagne de désinformation, sur X et Telegram. La création du faux article aurait servi à « rendre crédible » la fausse vidéo, après son apparition en ligne (ici ou ici, par exemple). « En conséquence, cette histoire inventée concernant les “140 millions de dollars” a pris l’apparence d’une information qui aurait soi-disant trouvé son origine dans l’espace médiatique ukrainien », en conclut le SPRAVDI.
La rumeur aurait ensuite été « amplifiée » via des canaux russes, puis « légitimée » par un partage de la vidéo sur X de Kirill Dmitriev, messager de Vladimir Poutine aux États-Unis et grand financier russe. Dans son post, ce dernier déclare : « Encore 140 millions de dollars volés aux contribuables occidentaux par les responsables ukrainiens des achats de matériel de défense. Pas étonnant qu’ils veuillent poursuivre la guerre tout en prétendant vouloir la paix. » Les médias russes s’en sont aussitôt fait l’écho (ici, ici, ici ou ici).
Ce n’est pas la première fois que de fausses informations sont propagées à propos de découvertes compromettantes faites par le bureau anticorruption ukrainien. Les Surligneurs s’étaient par exemple intéressés, en 2025, à une fausse vidéo prétendant montrer quatre passeports différents appartenant à Volodymyr Zelensky, prétendument saisis lors d’une perquisition. Il n’en était rien.
Auteurs :
Autrice : Mathilde Lafargue, journaliste
Relecteur : Nicolas Turcev, journaliste
Liens d’intérêts ou fonctions politiques déclarés des intervenants à l’article : aucun
Secrétariat de rédaction : Maylis Ygrand, journaliste
L’article Attention à cette fausse vidéo qui affirme que 140 millions de dollars destinés à Volodymyr Zelensky ont été saisis en Ukraine est apparu en premier sur Les Surligneurs.
-
Tal Madesta : « Il y a une queerness fondamentale dans les judéités »
Reply sourcePourquoi ce choix d’analyser l’entremêlement des expériences juives, décoloniales et queers ?
TAL MADESTA J’ai plongé dans ma judéité au moment où j’ai commencé ma transition de genre : ma judéité et ma transidentité ont été des lieux jumeaux d’insoumission. J’ai également été marqué par le fait que, parmi les Juif·ves les plus engagé·es pour la libération de la Palestine, beaucoup sont queers. J’ai donc voulu explorer les liens entre queerness, judéités et lutte contre les nationalismes coloniaux. C’est un sujet crucial dans le contexte du génocide à Gaza – et de la montée en force des fascismes partout dans le monde.
Qu’avez-vous découvert en écrivant cet ouvrage ?
TAL MADESTA Il y a une queerness fondamentale dans les judéités, une déviance ancienne aux normes de genre blanches. J’ai découvert plein de manières dont les communautés juives ont, au fil de leur histoire, accueilli les personnes trans. Ainsi, en 1896, à Izmir, dans l’actuelle Turquie, un rabbin ottoman a établi ce qu’il faut faire en cas de divorce entre un homme cis et un homme trans qui aurait transitionné après le mariage !
L’État d’Israël, par la colonisation, le génocide et l’apartheid au nom des Juif·ves, a créé un rapport militarisé au genre, où queerphobie et colonialisme se répondent. Cette double police – des corps et des frontières – est un fait historique ancien. Dans Mauvaises Graines, je raconte l’histoire de Jacob Israël de Haan, poète et journaliste gay néerlandais installé en Palestine mandataire en 1919, qui documente le racisme anti-Arabes des premiers sionistes, et finit assassiné en 1924 par l’ancêtre de l’armée israélienne.
« Je suis né juif et j’ai grandi trans »
Tal Madesta
Pourquoi le titre Mauvaises Graines ?
TAL MADESTA Il renvoie à l’histoire des Juif·ves, souvent envisagé·es comme des herbes indésirables par les États dans lesquels elles et ils vivent. De la même manière, les queers sont des mauvaises graines qui troublent l’ordre sexuel et familial. Enfin, les mouvements décoloniaux sont fortement criminalisés parce qu’ils perturbent le pouvoir politique. Mais ces mauvaises graines résistent et portent en elles une puissance de transformation immense.
Quel est le message principal porté par cet essai ?
TAL MADESTA Je suis désespéré par l’instrumentalisation de l’antisémitisme et la manière dont elle impacte les personnes juives françaises. Ce matraquage constant,
tout comme le soutien croissant de la diaspora à l’État israélien, nous isole et nous fait peu à peu oublier notre histoire. Par ce livre, j’aimerais montrer qu’une autre voie est possible, qui ne passerait pas par le nationalisme meurtrier, mais par la reconnexion à notre queerness juive qui n’a que faire des frontières et de l’assimilation à la blanchité.
-
Timothy Snyder says Trump is weak. Can Democrats take advantage? – Stateside with Kai and Carter
Reply sourceAs the midterms approach, Donald Trump is continuing to make strongman moves: banning reporters from the White House; trying to remake Washington DC’s architecture in his name; putting "Dear leader"-style videos on television. But historian Timothy Snyder tells Kai Wright that what this really is, is a sign of weakness. And even as the Democrats seemed poised to win the midterms, Snyder argues that the Democrats need to take bold, decisive action if they do win. They have to investigate cases of obvious personal corruption among the people surrounding Trump and try everything they can to get money out of politics. Snyder is the author of On Tyranny and one of the first scholars to warn that the Trump movement presented a threat that looked like fascism.
Continue reading... -
Deezer prépare un bouton pour faire disparaître la musique générée par IA de vos recherches
Reply source
Deezer ajoutera d'ici la fin de l'année 2026 un bouton pour faire disparaître de la recherche les morceaux entièrement générés par IA. La plateforme dit recevoir près de 90 000 titres de ce type chaque jour.
-
Le drone de combat d’Airbus a volé en Europe, mais son « cerveau » souverain manquait à l’appel
Reply source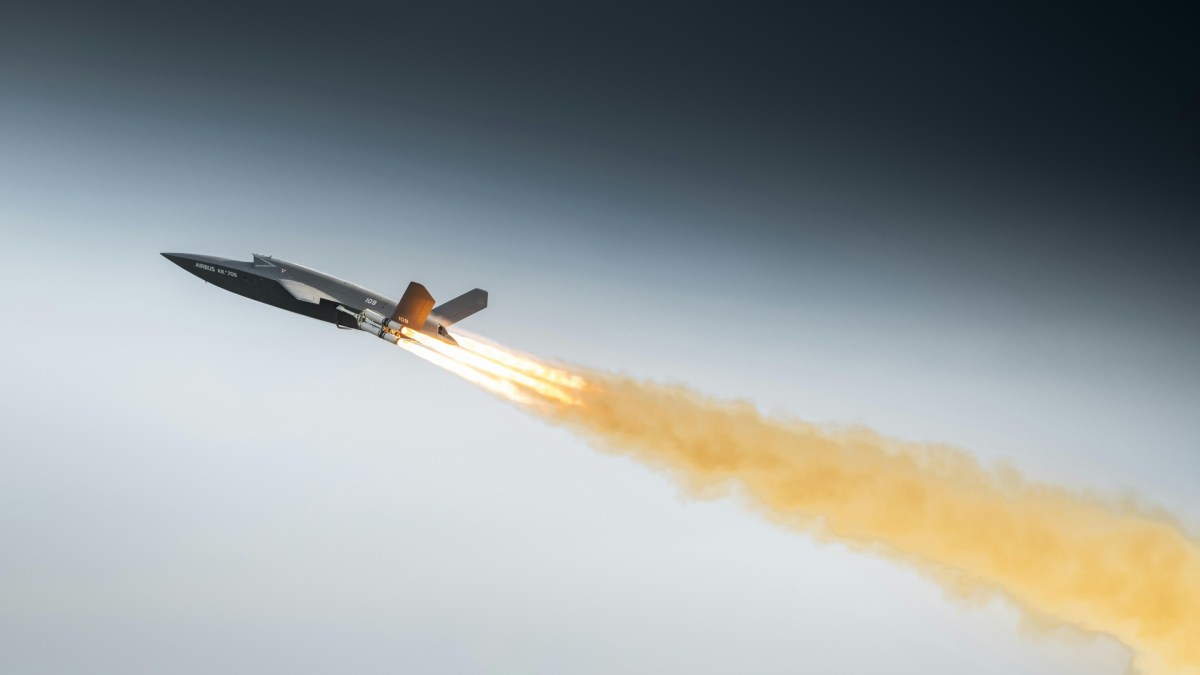
Airbus et l'Américain Kratos ont fait voler pour la première fois en Europe le U740 Valkyrie, un drone de combat que l'Allemagne pourrait utiliser dès 2029. Le système de mission européen censé le piloter n'était pas encore à bord.
-
Chauffage, transport : la baisse des émissions se poursuit, mais pas assez vite
Reply source
Les émissions de gaz à effet de serre devraient reculer de 2,8 % en France en 2026. Ce ralentissement est dû à l'effet dissuasif du prix élevé du gazole, a estimé le 13 octobre le Centre interprofessionnel technique d'études de la pollution atmosphérique (Citepa). Cette réduction reste malgré tout insuffisante pour que la France tienne ses objectifs.
Lire la suite - En bref / Climat , Pollutions
La ministre de la Transition écologique, Monique Barbut, a salué une baisse « encourageante », tout en reconnaissant qu'elle « ne suffit pas (…) -
Mobilisation lycéenne : une plainte pour agression sexuelle contre un policier
Reply sourceAlors que la mobilisation lycéenne se poursuit dans plusieurs villes, les interventions policières sont de plus en plus contestées. Une plainte pour agression sexuelle visant un policier vient d’être déposée, et l’IGPN a ouvert une enquête.
L’article Mobilisation lycéenne : une plainte pour agression sexuelle contre un policier est apparu en premier sur Les Nouvelles News.
-
AI godfather Geoffrey Hinton: ‘We’re creating alien beings. I’m willing to be selfish and choose humans’
Reply sourceThe pioneering computer scientist on why Trump is using ‘superintelligence’ wrong, whether AI could wipe out humanity – and how our biggest challenge will be accepting we’re not the only intelligent beings
Donald Trump is a “corrupt, senile felon” whose fixation on the term superintelligence proves he knows nothing about AI, said Geoffrey Hinton, “godfather” of the technology, in a wide-ranging interview where he doubled down on recent warnings that AI models pose an existential threat to humanity and scoffed at claims the industry could regulate itself.
The pioneering computer scientist, whose work helped lay the foundations of modern AI, has since become one of the technology’s most vocal critics. His latest remarks come after a tumultuous month during which a growing list of senior AI scientists and researchers have joined Hinton in ringing the alarm about how the technology he helped create could ultimately escape human control, sparking an industry crisis, the hasty assembly of congressional meetings and a rare global consensus that something must be done.
Continue reading... -
[St Nazaire] Rassemblement en soutien aux familles expulsées de logements et sans hébergement d’urgence
Reply sourceMERCREDI 14 OCTOBRE 17H – MAIRIE DE SAINT-NAZAIRE – RASSEMBLEMENT EN SOUTIEN AUX FAMILLES EXPULSÉES DE LOGEMENTS ET SANS HÉBERGEMENT D’URGENCE
Nous appelons toutes les personnes soutenant les familles laissées sans hébergement d’urgence à nous rejoindre devant la mairie de Saint-Nazaire ce mercredi à 17h.
Les vacances scolaires commencent à la fin de la semaine et nous savons qu’il s’agit d’une période critique.
Les solutions d’hébergement trouvées par les familles arrivent à épuisement et nous craignons que plusieurs d’entre elles se retrouvent à la rue au milieu des vacances.
Nous nous rassemblons donc pour réaliser une photo sur les marches de la mairie sous le fronton où est marqué Liberté égalité fraternité.
Nous souhaitons que vous soyez nombreux pour montrer qu’il y a du monde à Saint-Nazaire de solidaire et concerné par le sort de ces famillesIl s’agit de 17 familles auxquelles le 115 ne propose pas de mise à l’abri.
Sur Saint-Nazaire, ce sont 25 adultes dont 2 femmes enceintes et 38 enfants dont 3 bébés de 9, 12 et 16 mois.
Ce sont les élèves de 17 établissements scolaires sur Saint-Nazaire.
Montrons qu’à Saint-Nazaire, la solidarité a encore un sens et demandons l’accès à l’hébergement d’urgence de ces familles.Un toit c’est un droit! Un toit c’est la loi !

-
Implants espions dans des Ledger : les détenteurs de cryptomonnaies doutent désormais de toute la chaîne de distribution
Reply source
Après la découverte d’implants espions dans des portefeuilles Ledger vendus par le revendeur CryptoBilis, les rumeurs se multiplient sur les réseaux sociaux. Ledger appelle à la prudence, mais peine à rassurer des clients qui démontent désormais leurs appareils.
-
«Il a plu de grosses paillettes, une pluie noire» : à Dunkerque, ces habitants s’inquiètent des rejets suspects de l’usine ArcelorMittal
Reply source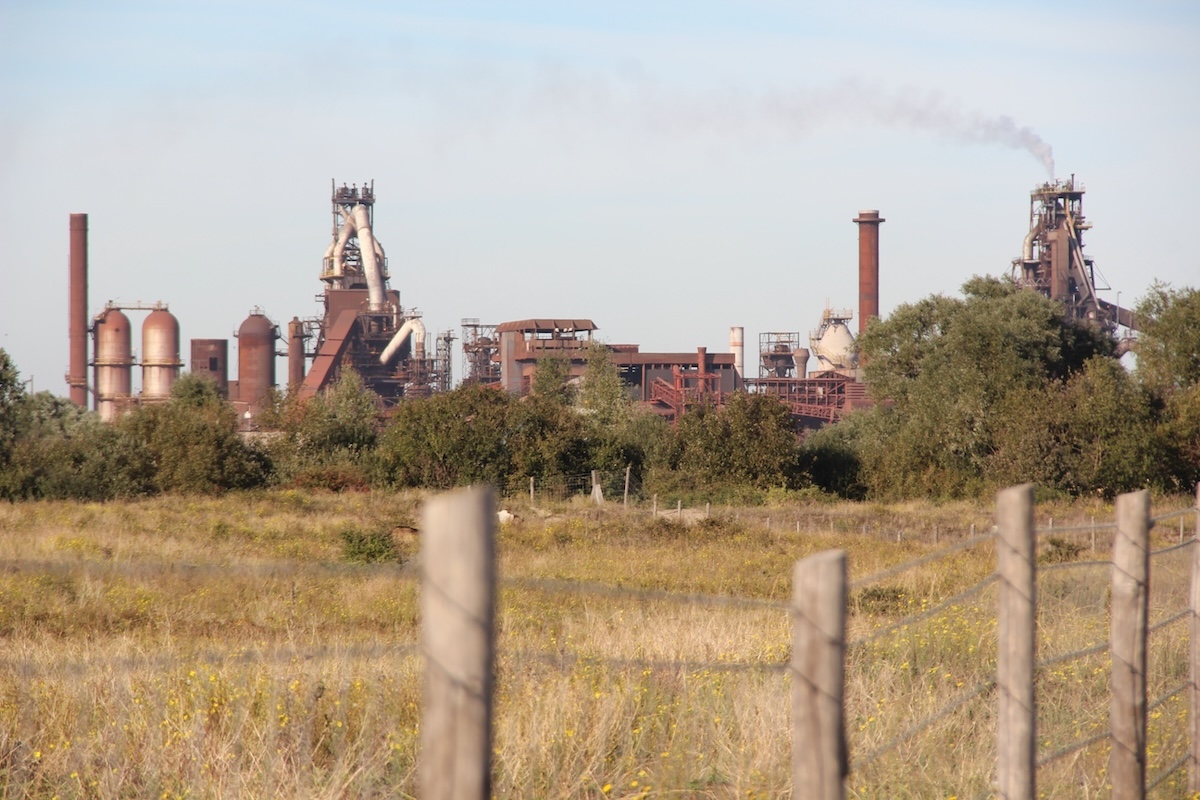 Cet été, plusieurs dysfonctionnements sur le site sidérurgique d’ArcelorMittal, à Dunkerque, ont causé des fumées noires et des panaches de poussière, dont les riverain·es de l’usine ont été victimes. © Arnaud Stoerkler/Vert
«C’est une usine polluante qui intoxique la population. L’industriel affirme qu’il met des filtres, mais c’est faux. Et tout le monde ferme les yeux, parce que c’est de l’emploi.» Voilà le pitch des Enfants de plomb, une mini-série qui cartonne sur Netflix. L’histoire vraie d’une pédiatre qui a révélé, en Pologne, les effets délétères d’une fonderie sur la santé de ses riverain·es.
Daniel*, un habitant de Grande-Synthe (Nord), y a reconnu son quotidien. À deux kilomètres de ses fenêtres s’étirent les cheminées d’ArcelorMittal Dunkerque, l’une des usines les plus polluantes de France, qui brûle du charbon pour produire de l’acier. Il observe les panaches de fumée, la survenue de cancers dans son entourage, et pense qu’un lien existe entre les deux. «Personne n’en parle, les élus sont silencieux», enrage-t-il. Et cet été, il a «failli déménager».
Nuages de poussière oranges, fumées noires, confettis de carbone dans l’air… Des retombées «épouvantables» ont touché les résident·es proches du site sidérurgique et d’autres usines, entre avril et septembre. L’industriel a reconnu des «aléas techniques», promis une «meilleure communication» à l’avenir et «engagé des actions» pour améliorer son fonctionnement.
Mais l’inquiétude a conduit à un événement rare dans le Dunkerquois : une critique de la pollution industrielle locale par un élu. «J’ai l’impression que nous sommes revenus trente ans en arrière», a fustigé Grégory Bartholoméus, maire socialiste de Fort-Mardyck, lors d’une réunion publique organisée le 16 septembre dans sa commune – la plus exposée.
Trottoirs scintillants
Déjà en 2018, la Voix du Nord se faisait l’écho de panaches anormaux durant l’été. En dehors de ces épisodes exacerbés, les rejets industriels restent un impensé sur le territoire. La communauté urbaine de Dunkerque (Cud) – qui n’a pas souhaité répondre à nos sollicitations – tente d’attirer de nouvelles usines et incite sa population à embrasser les métiers du secteur, avec son plan «20 000 emplois».
Les voix qui s’élèvent contre ces nuisances, dans la rue et sur les réseaux sociaux, sont souvent moquées par les défenseur·ses d’un poids lourd économique drainant 20 400 emplois en 2023, entre le port et une quinzaine de sites classés Seveso – afin de prévenir les accidents liés aux substances dangereuses.
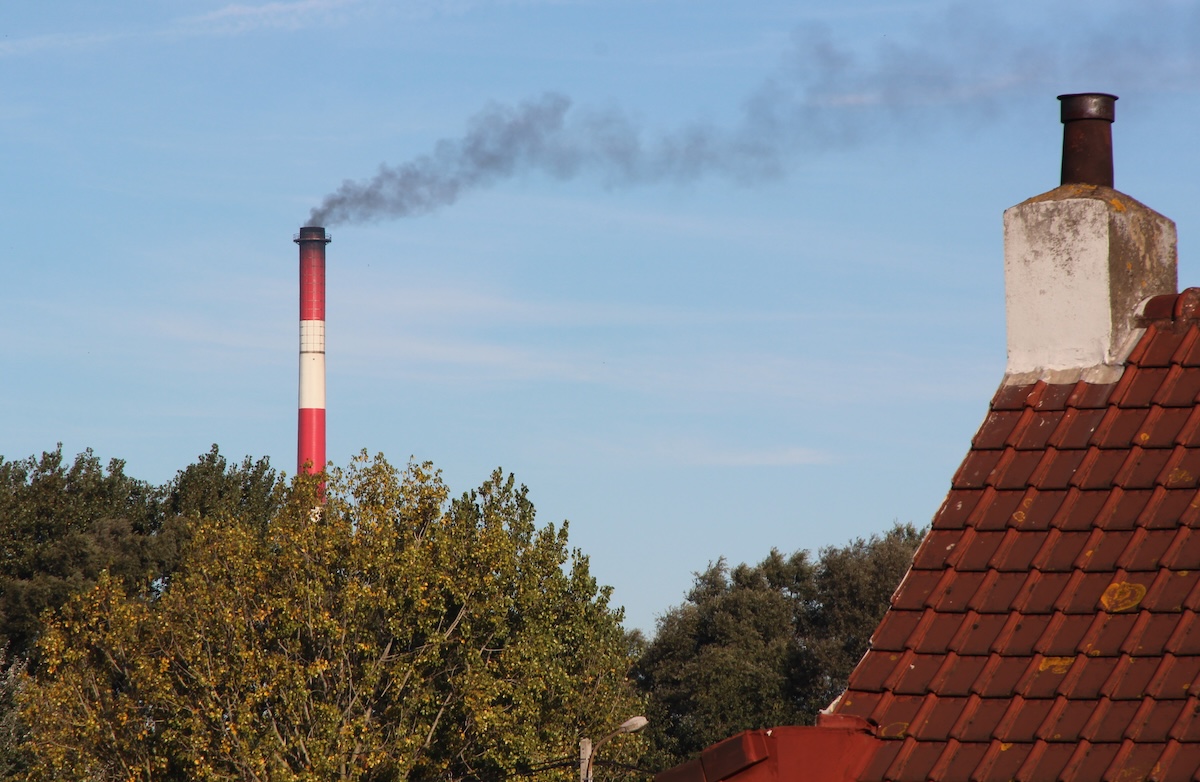 Les premières habitations de Fort-Mardyck, une commune associée de Dunkerque, se trouvent à moins de 200 mètres du site d’ArcelorMittal. © Arnaud Stoerkler/Vert
«Il suffit d’ouvrir les yeux pour voir la pollution», soutient pourtant Nicole Bertrand, 74 ans. Elle habite au pied des cheminées et a connu le secteur avant l’arrivée, en 1962, de l’usine sidérurgique. Chaque jour de l’année, les pelouses, voitures et façades des habitations de Fort-Mardyck, de Grande-Synthe ou de Saint-Pol-sur-Mer sont recouvertes d’une fine couche de poussière noire venue d’ArcelorMittal. Et les trottoirs scintillent parfois de paillettes, échappées des 12 millions de tonnes de matières traitées chaque année sur le site.
«Lors d’une braderie au printemps, il a plu de grosses paillettes, une pluie noire», rit jaune une trentenaire de Fort-Mardyck, qui n’a pas voulu être citée. C’était le 2 mai dernier, et l’industriel ne connaît toujours pas l’origine exacte de ce «carbone pur [tombé] sous forme de graphite», confesse à Vert un porte-parole.
«Personne ne fait ça»
Arrivée de Calais il y a neuf ans, Élise (elle n’a pas donné son nom) a pris conscience du problème à force de «nettoyer la poussière noire» sur les jouets de ses filles, dans le jardin. Comme bien d’autres habitant·es, elle évoque «une voiture à laver tous les deux jours», «des appuis de fenêtre souillés» et l’impossibilité d’aérer sa maison sans voir «la poussière atterrir à l’intérieur».
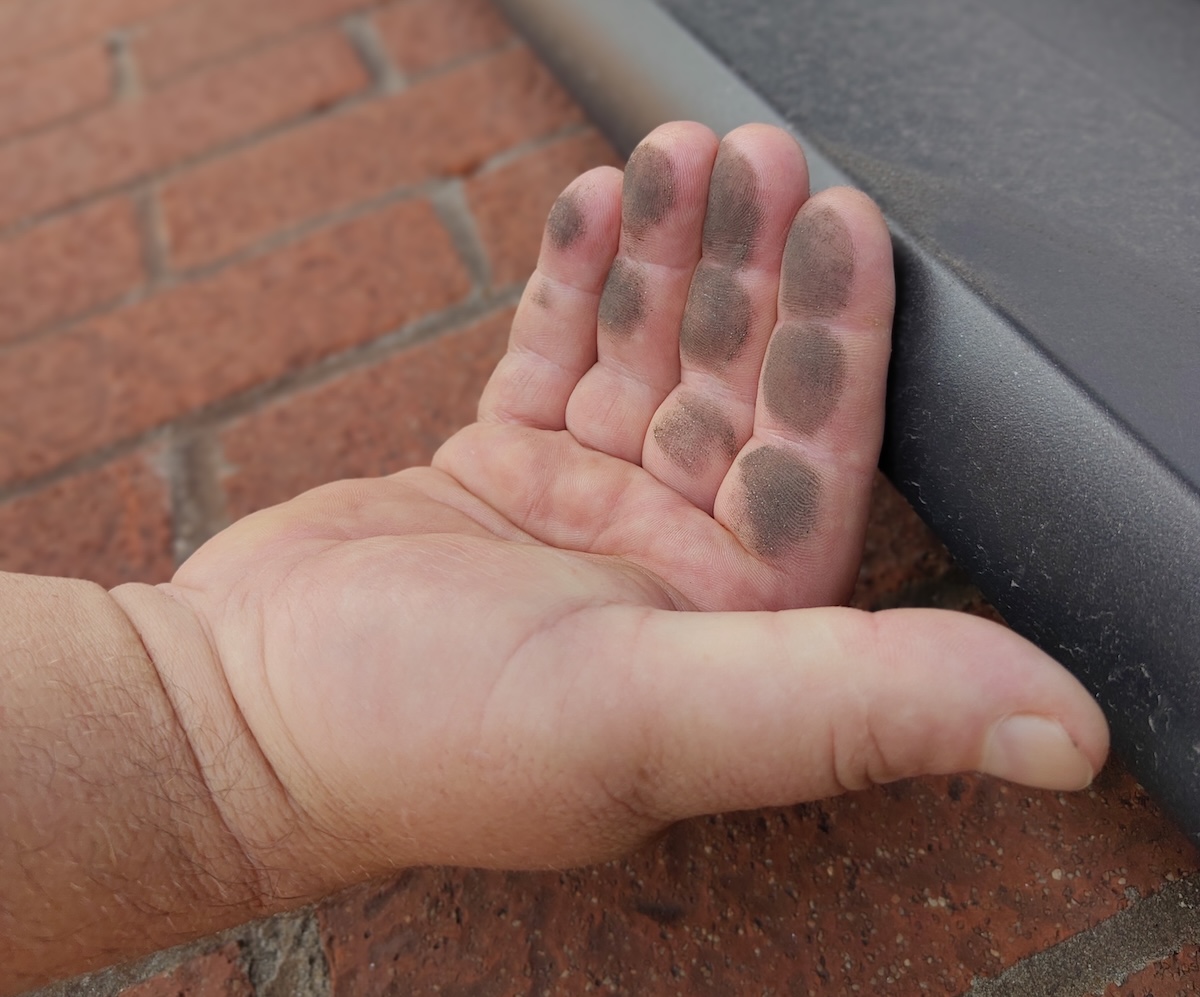 «La poussière, c’est tous les jours, partout. Il suffit de passer la main sur un rebord de fenêtre pour le vérifier», constate Jean, qui habite au pied des cheminées. © Arnaud Stoerkler/Vert
Certain·es riverain·es ont retiré leur trampoline après avoir vu les chaussettes blanches de leurs enfants «devenir noires en quelques minutes». Celles et ceux qui ont conservé un salon de jardin retournent consciencieusement «les verres et les assiettes jusqu’au moment de servir», relate Jean*, installé à Fort-Mardyck depuis «cinq générations».
«On a grandi comme ça, s’attriste Daniel, l’habitant de Grande-Synthe. Dans ma jeunesse, on mettait toujours un coup de wassingue [chiffon, en patois, NDLR] sur la table et le fil à linge, pour ne pas avoir un trait noir sur son t-shirt. Je me suis rendu compte plus tard qu’ailleurs, personne ne fait ça.»
Forcément, le carnaval de Dunkerque illustre régulièrement avec panache cette existence noircie. Dominique Mouftier, un artiste de 65 ans né à deux pas d’ArcelorMittal, pousse la chansonnette : «La fumée de nos usines nous rend tous tuberculeux, on s’en fout on a bonne mine, on est des carnavaleux !»
Dépassements de seuils
Blague à part, Dominique Mouftier se dit entouré de «proches atteints par des cancers». Et Élise est «sous traitement pour des sinusites chroniques» depuis son arrivée dans le Dunkerquois. «Je m’inquiète pour mes filles. On manque d’informations sur cette pollution», regrette-t-elle.
«Les particules visibles ne sont pas forcément les plus dangereuses, mais elles en charrient des plus petites qui ne sont pas toutes contrôlées», note Constance Valade, de l’association Respire. Une étude de Santé publique France parue en 2025 suggère un sur-risque d’asthme, de prématurité et de maladies respiratoires pour celles et ceux qui habitent à quatre kilomètres ou moins d’un site industriel. Le diagnostic territorial de santé de la communauté urbaine de Dunkerque, publié en 2023, montre aussi une surmortalité de 20 à 30% et une prévalence des cancers parmi ses habitant·es par rapport au niveau national. Sans pour autant les lier au risque industriel.
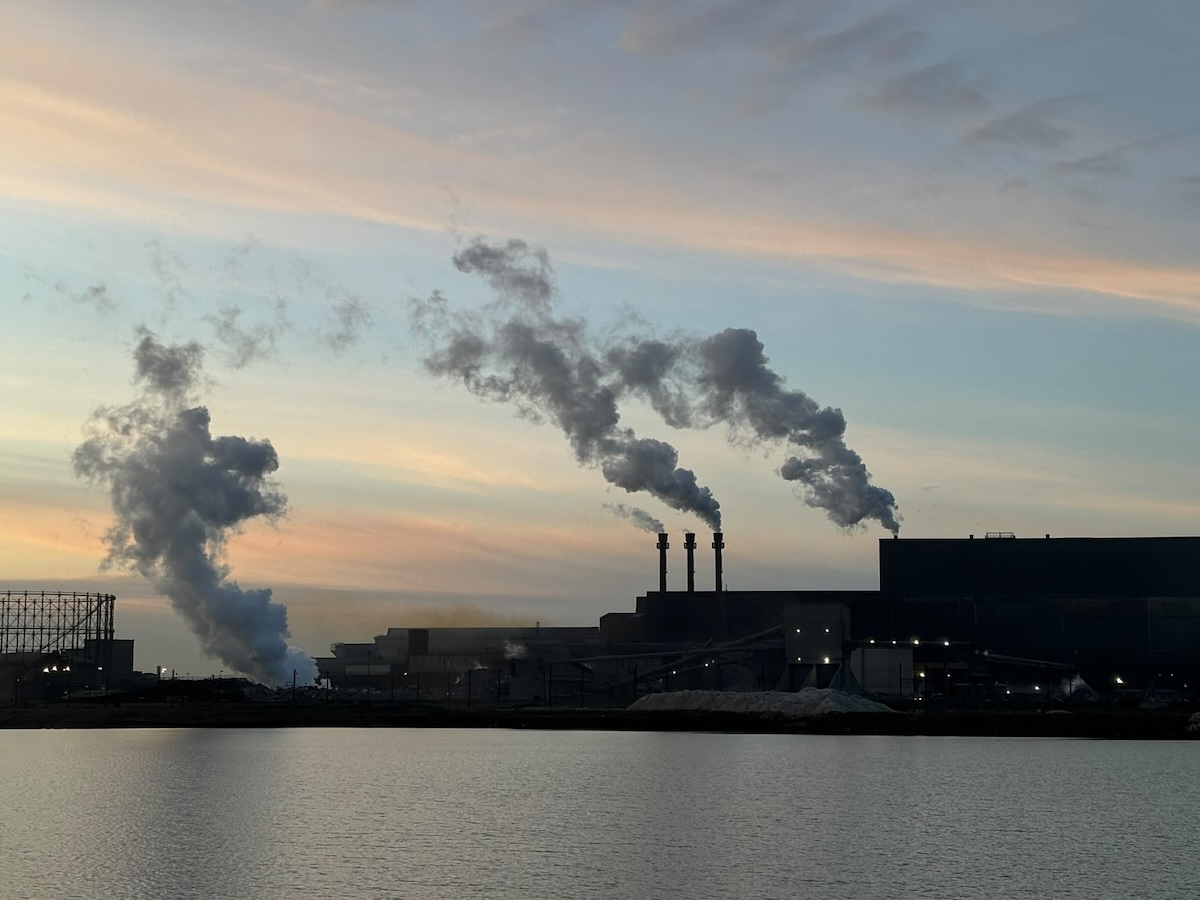 Lors d’une campagne de contrôle réalisée au printemps 2025, l’association Respire a relevé des seuils de pollution situés au-dessus des limites de l’OMS dans les fumées d’ArcelorMittal Dunkerque. © Association Respire
Plusieurs enquêtes (Disclose, association Respire, France nature environnement) ont démontré que le site sidérurgique dunkerquois avait dépassé certains seuils réglementaires d’émissions polluantes, lui valant des amendes et un contrôle renforcé par la préfecture. Malgré ces alertes, l’actuel premier adjoint au maire de Dunkerque, le chercheur en toxicologie Yann Landkocz, jugeait en 2023 dans Libération que l’air de Dunkerque «n’est pas plus pollué qu’ailleurs».
Reprendre la main
«Il y a une omerta, un conflit d’intérêts entre le développement économique du territoire et la pollution de l’air», estiment Éric Lefebvre et Jean-Michel Vermeersch, membres de Santé Transparence. Cette association de quarante riverain·es souhaite créer un institut écocitoyen pour reprendre la main sur une réalité sanitaire qui leur échappe. Comme à Fos-sur-Mer, où se trouve aussi le géant de l’acier. Elle organise des réunions publiques depuis un an et vient de candidater à des projets d’études scientifiques pour s’entourer de chercheur·ses.
 Jean-Michel Vermeersch, membre de l’association Santé Transparence. © Arnaud Stoerkler/Vert
Une manière de ne pas attendre la décarbonation du site sidérurgique, revue à la baisse mais toujours d’actualité, qui vise à réduire l’utilisation du charbon en 2030. Gaëtan Lecocq, responsable CGT dans l’usine, reste sceptique : «Le manque criant d’investissement explique en partie les panaches de cet été et interroge l’avenir», s’alarme-t-il. L’entreprise, elle, rappelle à Vert l’injection de «dizaines de millions d’euros chaque année dans ses installations».
 Gaëtan Lecocq, responsable de la CGT à ArcelorMittalDunkerque. © Arnaud Stoerkler/Vert
Coincés entre grondements nocturnes, odeurs âcres et fumées chamarrées, deux habitant·es de Fort-Mardyck, récemment arrivé·es, ont peur de ce qu’elle et il «respirent» mais veulent croire à la décarbonation. Souhaitant rester anonyme, un ancien maire de la ville, croisé sous son porche noirci et «incité à se calmer» à une époque où il s’était ému de la pollution, se dit «résigné». Il a accueilli ses deux petites-filles cet été, dont les pieds ont viré au noir dans sa pelouse, «comme si elles avaient marché dans du charbon».
*Leurs prénoms ont été modifiés pour préserver leur anonymat.
-
L’Atari 800XL de 1983 revient en précommande avec un vrai clavier mécanique et 25 jeux
Reply source
[Précommande] Annoncé le 8 octobre par Atari et Retro Games Ltd, THE 800XL, une recréation grandeur nature de l'ordinateur 8 bits de 1983, est déjà en précommande sur Amazon à 219,99 €, pour une sortie le 23 avril 2027.
-
Tradwifes : les influenceuses se rebellent timidement
Reply sourceDécouvrant, à leurs dépens, les risques du modèle conservateur de « femme traditionnelle », certaines influenceuses prennent leurs distances. Mais la tendance n’a pas dit son dernier mot, question de modèle économique...
L’article Tradwifes : les influenceuses se rebellent timidement est apparu en premier sur Les Nouvelles News.
-
Des IA capables de se multiplier toutes seules sur des boîtiers TV ? Anthropic alerte sur ce risque
Reply source
Faire tourner une IA sur quinze boîtiers Android TV : c’est l’expérience menée par Anthropic, qui étudie comment des modèles pourraient se multiplier sur des objets connectés, sans data center. Un scénario dont plusieurs étapes restent à démontrer.
