Tech-fr publisher
-
13 Sentinels: Aegis Rim : comment décider lorsque la crise est peut-être une simulation ?
incyber.orgUne simulation peut éclairer le réel. Elle devient dangereuse lorsqu’elle cesse d’être un instrument et commence à définir les seules options que les décideurs sont encore capables de voir.
Treize récits, aucune vue d’ensemble
Le dispositif narratif de 13 Sentinels repose sur une frustration méthodique. Chaque personnage sait quelque chose que les autres ignorent ; chacun interprète les mêmes événements depuis une position différente ; certaines informations exactes conduisent pourtant à une conclusion fausse parce qu’elles sont replacées dans la mauvaise chronologie. Le joueur découvre que l’erreur ne vient pas toujours d’une donnée incorrecte. Elle peut naître de l’assemblage.
Les centres opérationnels connaissent cette difficulté. Les capteurs, les journaux, les rapports humains et les outils de renseignement produisent des fragments cohérents dans leur propre domaine. La panne apparaît lorsqu’une vue synthétique les relie trop vite. Une corrélation devient causalité ; un horodatage mal aligné inverse l’ordre des événements ; deux identités techniques sont confondues ; le tableau de situation paraît complet alors qu’il résulte d’une erreur de fusion.
La première règle de décision est donc de conserver la provenance des fragments. Une information utile doit rester liée à sa source, à son heure, à son niveau de confiance et aux transformations qu’elle a subies. Sans cette mémoire, la synthèse devient impossible à contester. L’organisation ne voit plus des éléments qu’elle pourrait recomposer, mais une histoire déjà écrite par son propre outil.
Le modèle n’est pas le monde
Les Sentinelles donnent aux protagonistes une puissance immense, mais elles ne leur offrent jamais une compréhension totale. Les cartes tactiques simplifient la ville, réduisent les menaces à des symboles et transforment le combat en décisions visibles. Cette abstraction est nécessaire. Aucun opérateur ne pourrait agir s’il devait percevoir simultanément tous les détails du terrain. Mais ce qui permet de décider peut aussi masquer ce qui ne rentre pas dans le modèle.
Un jumeau numérique, une simulation ou un système d’aide à la décision fonctionne de la même manière. Il sélectionne des variables, établit des relations, estime des conséquences et laisse de côté le reste. Sa précision ne dépend pas seulement de la qualité du calcul, mais de la pertinence de cette sélection. Un modèle peut être mathématiquement exact et opérationnellement trompeur s’il ignore la variable qui devient décisive pendant la crise.
La bonne question n’est donc pas : le modèle est-il vrai ? Il faut demander : pour quelle décision, dans quelles limites et à partir de quelles hypothèses reste-t-il utile ? Cette formulation empêche l’outil de devenir un oracle. Elle rappelle que la représentation est une construction temporaire, destinée à éclairer l’action, et non une version supérieure du monde à laquelle le monde devrait se conformer.
Le problème s’accentue avec les jumeaux numériques synchronisés en continu. Leur proximité avec le système réel crée une impression de transparence : ce qui apparaît sur l’écran semble être le monde lui-même. Pourtant, chaque synchronisation possède une latence, chaque capteur une zone aveugle et chaque modèle une granularité. La précision graphique peut masquer une incertitude structurelle. Il faut donc afficher les limites du modèle avec autant de soin que ses résultats.
Attaquer la simulation plutôt que le système réel
Un adversaire n’a pas toujours besoin de détruire l’infrastructure. Il peut chercher à compromettre le modèle qui commande sa défense. De faux signaux déplacent les ressources ; des données de capteurs modifiées créent une menace imaginaire ; un scénario d’entraînement introduit des hypothèses biaisées ; un jumeau numérique sous-estime une dépendance. L’organisation agit alors avec discipline, rapidité et précision, mais dans la mauvaise direction.
Cette attaque est particulièrement attractive parce qu’elle exploite la confiance accordée à l’outil. Une panne visible déclenche le doute. Une simulation apparemment cohérente rassure. Plus l’interface est claire, plus l’utilisateur peut oublier que les données ont une origine, que le modèle possède une version et que ses paramètres ont été choisis par quelqu’un. L’élégance de la représentation devient une surface d’attaque cognitive.
La sécurité doit donc couvrir toute la chaîne : capteurs, transport, stockage, paramètres, bibliothèques de scénarios, moteur de calcul et restitution. Il faut signer les données, contrôler les versions, séparer les environnements, surveiller les dérives et pouvoir rejouer une décision avec un état antérieur. Protéger la simulation signifie protéger la manière dont elle produit une conclusion, pas seulement le serveur qui l’héberge.
Cette chaîne comprend aussi les composants acquis à l’extérieur. Un modèle préentraîné, une bibliothèque de calcul, un jeu de données ou une mise à jour peuvent introduire une hypothèse invisible dans un environnement pourtant maîtrisé. La nomenclature logicielle ne suffit pas : il faut connaître la provenance des modèles, leurs conditions d’entraînement, les tests qui ont précédé leur intégration et les situations pour lesquelles leurs résultats ne doivent jamais être utilisés seuls.
La donnée d’origine est un actif critique
Dans 13 Sentinels, la mémoire n’est jamais un simple souvenir. Elle est une donnée opérationnelle : elle oriente les alliances, révèle une identité, déclenche une action ou masque une répétition. Lorsqu’elle est incomplète, réécrite ou attribuée à la mauvaise personne, tout le système de décision se déforme. La crise ne vient pas seulement de ce qui a été oublié, mais de ce qui a été conservé sous une forme trompeuse.
Les infrastructures numériques accumulent elles aussi des données dites de référence : configurations, plans, historiques, modèles de comportement, listes d’actifs et relations de dépendance. Ces éléments paraissent moins urgents que les flux en temps réel. Pourtant, une donnée instantanée n’a de sens qu’en comparaison avec cette mémoire. Si la référence est compromise, l’anomalie devient normale et le comportement légitime paraît hostile.
La gouvernance de ces données doit donc être aussi rigoureuse que celle des systèmes de production. Origine, responsable, fréquence de mise à jour, contrôles de cohérence, copies indépendantes et procédures de restauration doivent être explicites. Une organisation qui ne sait pas d’où vient son état de référence ne possède pas un modèle : elle possède une croyance automatisée.
La cohérence temporelle mérite une attention particulière. Deux données exactes peuvent produire une image fausse si elles correspondent à des instants différents. Un plan ancien est comparé à une télémétrie récente, une identité révoquée demeure dans une copie locale, une dépendance supprimée continue d’influencer le calcul. Le système doit donc conserver non seulement la valeur, mais la période pendant laquelle cette valeur pouvait légitimement décrire le réel.
Le modèle devient dangereux lorsqu’il ne se contente plus d’éclairer la décision, mais décide silencieusement quelles réalités ont encore le droit d’être observées.
Le scénario peut capturer le décideur
Le joueur de 13 Sentinels apprend progressivement à reconnaître les motifs de la science-fiction : voyage temporel, invasion, boucle, simulation, copie, mémoire artificielle. Cette culture l’aide à formuler des hypothèses. Elle peut aussi l’enfermer. Dès qu’un scénario semble familier, chaque nouvel indice est interprété pour le confirmer. Le modèle mental devient plus puissant que les faits qui devraient le corriger.
Les organisations connaissent cette capture. Elles préparent des scénarios d’attaque, de panne ou de catastrophe afin d’agir plus vite. L’exercice est indispensable, mais il crée un risque : attendre que la crise réelle ressemble à celle qui a été répétée. L’équipe reconnaît les signes appris, applique la procédure et néglige l’événement qui ne correspond pas au récit. L’adversaire peut même exploiter cette préparation en produisant délibérément les symptômes attendus.
Un bon scénario doit donc contenir sa propre contestation. Quels indices prouveraient que notre hypothèse est fausse ? Quelle observation indépendante manque ? À quel moment devons-nous abandonner le plan initial ? Qui est chargé de défendre l’interprétation opposée ? La préparation ne doit pas seulement accélérer l’action. Elle doit accélérer la découverte du moment où l’action préparée n’est plus la bonne.
Plusieurs modèles valent mieux qu’un oracle
Face à une situation complexe, la tentation consiste à concentrer les données dans un modèle unique, plus complet et plus puissant. Cette centralisation facilite la coordination, mais elle crée une dépendance épistémique : si le modèle se trompe, tout le monde se trompe de la même manière. La cohérence apparente remplace la diversité des observations qui permettrait de détecter l’erreur.
Une architecture résiliente conserve plusieurs représentations. Un modèle rapide estime l’urgence ; un autre explore les conséquences de long terme ; une équipe humaine travaille à partir de données brutes ; une source externe vérifie un indicateur critique. Ces vues ne doivent pas fusionner immédiatement. Leur désaccord est une information. Il révèle les hypothèses sensibles, les données manquantes ou les zones où l’adversaire pourrait agir.
Cette pluralité a un coût. Elle ralentit certaines décisions et produit des débats au moment où l’on préférerait une réponse nette. Mais la vitesse d’une conclusion fausse n’est pas une performance. L’objectif n’est pas d’éliminer l’incertitude ; il est de la rendre visible, localisée et gouvernable. Une organisation robuste sait précisément sur quel désaccord elle choisit malgré tout d’agir.
Le désaccord doit être organisé avant l’urgence. Une équipe rouge peut tenter d’empoisonner les entrées, une seconde équipe reconstruire la situation sans utiliser le modèle principal, tandis qu’un arbitre compare les décisions produites. L’exercice ne cherche pas à humilier l’outil, mais à identifier les conditions dans lesquelles il devient trompeur. Ce qui compte n’est pas seulement son taux moyen de réussite, mais la forme précise de ses erreurs dans les situations où elles coûteraient le plus cher.
Un human-machine threatcasting pour tester la décision
Le threatcasting consiste à décrire un futur menaçant, puis à remonter vers les décisions et dépendances qui pourraient le rendre possible. Appliqué aux relations entre humains et machines, il ne demande pas seulement ce qu’un système automatique pourrait faire de mal. Il examine comment une organisation pourrait progressivement lui abandonner la définition du problème, la sélection des preuves et la formulation des options.
Imaginons un centre de crise où le jumeau numérique signale une attaque imminente. Les données sont cohérentes, les simulations convergent et les recommandations correspondent aux doctrines. Pourtant, l’ensemble a été construit à partir d’une référence empoisonnée plusieurs mois plus tôt. Quelles décisions ont rendu cette situation possible ? Qui a validé la source ? Pourquoi aucune vue indépendante n’a subsisté ? À quel moment l’outil est-il devenu impossible à contredire ?
L’exercice permet de transformer la fiction en exigences concrètes : journaliser les hypothèses, conserver des sources hors modèle, organiser la contradiction, limiter l’autonomie, tester les modes manuels et définir l’autorité capable d’interrompre une recommandation automatique. La question n’est pas de choisir entre l’humain et la machine. Elle est de construire une relation où chacun peut révéler l’erreur de l’autre.
Conserver une sortie hors simulation
13 Sentinels conduit le joueur vers une vérité qui ne supprime pas la fragilité des personnages. Comprendre le système ne suffit pas ; il faut encore agir depuis l’intérieur, avec des informations incomplètes et des capacités limitées. Cette tension constitue la meilleure leçon du jeu pour la cyber-résilience. Aucun modèle, même exact, ne délivre l’organisation de la responsabilité de choisir.
Une sortie hors simulation ne signifie pas abandonner les outils. Elle signifie conserver un accès aux données brutes, des procédures manuelles, des chaînes de commandement explicites et des personnes capables de formuler une hypothèse sans l’interface. Elle suppose aussi de pouvoir isoler le modèle, revenir à une version antérieure et poursuivre une mission lorsque les recommandations deviennent indisponibles ou suspectes.
La simulation protège lorsqu’elle élargit ce que les décideurs peuvent envisager. Elle menace lorsqu’elle rétrécit le réel aux seules catégories qu’elle sait calculer. Les Sentinelles ne gagnent pas parce qu’elles voient tout, mais parce que plusieurs fragments finissent par être confrontés sans qu’aucun puisse prétendre constituer seul le monde. La sécurité commence exactement là : au moment où le modèle redevient une hypothèse et où l’action demeure réversible.
Cette réversibilité doit être testée matériellement. Il faut interrompre volontairement le flux de données, rendre indisponible le tableau principal, injecter une contradiction et observer si l’organisation sait encore décider. Un mode manuel qui n’a jamais été exercé n’est pas une capacité ; c’est une note dans un plan. La sortie hors simulation n’existe que si des personnes, des procédures et des moyens indépendants peuvent réellement la franchir.
Repères documentaires
1. Vanillaware, 13 Sentinels: Aegis Rim, Atlus, 2019 ; direction et scénario : George Kamitani. [source]
2. NIST, Artificial Intelligence Risk Management Framework 1.0, 2023. [source]
3. NIST, Developing Cyber-Resilient Systems, SP 800-160, vol. 2, révision 1, 2021. [source]
4. NIST, Security and Privacy Controls for Information Systems and Organizations, SP 800-53, révision 5. [source]
5. CISA, Cybersecurity Tabletop Exercise Packages. [source]
6. Brian David Johnson et Natalie Vanatta, Threatcasting, Springer, 2022 ; NATO STO, ressources sur la modélisation et la simulation. [source]
The post 13 Sentinels: Aegis Rim : comment décider lorsque la crise est peut-être une simulation ? appeared first on INCYBER NEWS.
-
J’ai testé la conduite autonome de XPeng dans Paris, aussi bon que le Tesla FSD ?
www.numerama.com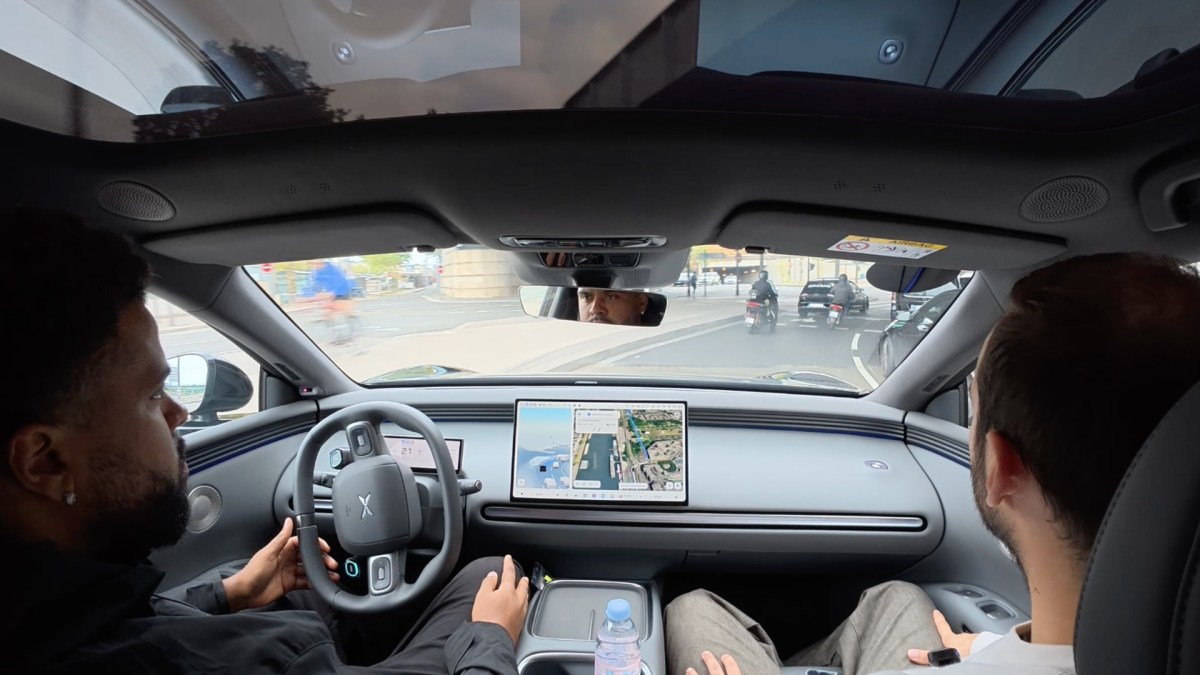
À l'occasion du Mondial de l'Auto 2026, XPeng organise des expérimentations pour son système de conduite autonome baptisé NGP dans Paris. Numerama a pu l'expérimenter et le comparer au Tesla FSD.
-
Starlink bridé en Ukraine, un ministre polonais tance Elon Musk : « Mon grand, tu fais encore de la politique avec tes produits ? »
www.numerama.com
Radosław Sikorski, ministre polonais des Affaires étrangères, a interpellé Elon Musk, après que SpaceX a bridé à 160 km/h les terminaux Starlink de l'armée ukrainienne. Les deux hommes s'étaient déjà accrochés publiquement en mars 2025 et en janvier 2026.
-
Neura Robotics passe un cap avec son modèle multimodal Neuron AI qui regroupe tous les modes de perception dans une seule architecture
www.usine-digitale.frÀ la manière du système nerveux pour l’humain, Neura Robotics avance dans sa quête de “cerveau unique” pour robots. La start-up allemande connue pour son robot humanoïde 4NE1 dévoile ce 14 octobre Neuron AI, un modèle de fondation multimodal basé sur une architecture “Perception-Language-Action” réunissant les “sens” du robot (vue, toucher, ouïe, parole, état) et la mémoire. Ceci permet aux machines de relier ses facultés tactiles, visuelles et auditives à ses actions passées, un bond en avant par rapport aux modèles classiques nécessitant bien souvent un traitement séparé des données de capteurs.
-
Google déploie Gemini 4 Argon à grande échelle... mais le prix de l’API va doubler le 1er décembre
www.usine-digitale.frGoogle accélère la diffusion de Gemini 4 Argon. Dévoilé au début du mois, le modèle est accessible depuis ce 13 octobre 2026 dans le monde entier via l’API Gemini, ainsi qu’aux abonnés payants dans plusieurs produits de la firme. Google entend en faire un outil de travail pour les tâches complexes et un moteur de ses agents IA.
-
Lunettes connectées : du floutage des visages aux restrictions géographiques, les pistes européennes pour protéger la vie privée
www.usine-digitale.frLes fabricants de lunettes connectées doivent-ils aller plus loin pour informer les personnes susceptibles d’être filmées ou enregistrées ? Dans une déclaration adoptée le 13 octobre 2026, le Comité européen de la protection des données (CEPD), qui rassemble les autorités nationales chargées de veiller au respect du RGPD, expose ses premières réflexions sur les risques soulevés par ces équipements.
-
QBZ, le client Qobuz pour Linux c'est terminé !
korben.infoSi vous avez lu mon article sur QBZ , le client Qobuz open source qui permettait d'écouter sa musique en "bit-perfect" sous Linux, hé bien oubliez-le. En effet, Qobuz a demandé à son développeur d'arrêter le projet, et ce dernier n'a pas eu d'autre choix que d'obéir. Bref, le dépôt est fermé et il n'y aura plus de mise à jour.
C'est sacrément dommage je trouve...
Après la raison, comme expliquée ici par le support de Qobuz, c'est que cette application plaçait Qobuz en position "non conforme" vis-à-vis des ayants droit notamment parce que les lectures ne sont pas comptabilisées côté Qobuz, ce qui laisserait les artistes sans rémunération.
Perso, j'aime bien Qobuz et je trouve qu'ils font du super boulot, mais ils ont sacrément manqués de stratégie sur ce coup là !
Je ne sais pas si techniquement ça aurait été jouable, mais à leur place, j'aurais demandé au dev de QBZ d'intégrer mes API de mesure (en plus de lui filer un petit chèque) sans pour autant rendre proprio le code. Ou au pire, je l'aurais embauché pour faire un vrai client Linux officiel avant de laisser mourir ce projet libre, ce qui leur aurait éviter de prendre un risque avec leur image auprès de la communauté du libre.

Bref, 1/ ils se privent d'un super client Linux 2/ ils perdent un dev qui a quand même taffé durant des années bénévolement pour leurs services 3/ j'imagine qu'ils vont également perdre des abonnés payants sous Linux. 4/ Et ils prennent le risque de voir débarquer des forks de rebelles moins conciliants avec leurs services.
De mon point de vue ce n'était pas une décision très réfléchie, même si c'est vrai, ils ont été pro et courtois avec le dev de QBZ (traduction : ils ne lui ont pas mis un procès au cul).
Dommage.
-
Jensen Huang en tournée en Europe : entre business, lobbying et investissements
www.frenchweb.frÀ Paris le 13 octobre, Jensen Huang a annoncé des investissements dans Doctolib, Genesis AI, Pigment et Entalpic, avant de poursuivre sa tournée européenne. Ce déplacement s’inscrit dans une stratégie mondiale qui associe diplomatie industrielle, financement et développement commercial. De Riyad à Séoul, le patron de Nvidia propose aux États les moyens de construire leur …
L’article Jensen Huang en tournée en Europe : entre business, lobbying et investissements est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
SpaceX bride Starlink à 160 km/h en Ukraine, quatre jours après qu’Elon Musk a jugé que « Zelensky est allé trop loin »
www.numerama.com
Dans la nuit du 13 au 14 octobre 2026, SpaceX a bridé les terminaux Starlink de l'armée ukrainienne, qui perdent désormais la connexion au-delà de 160 km/h. La mesure arrive quatre jours après qu'Elon Musk a écrit que Volodymyr Zelensky « est allé trop loin ».
-
Ce jeu vidéo ukrainien reproduit la guerre des drones FPV avec l’aide de pilotes du front
www.numerama.com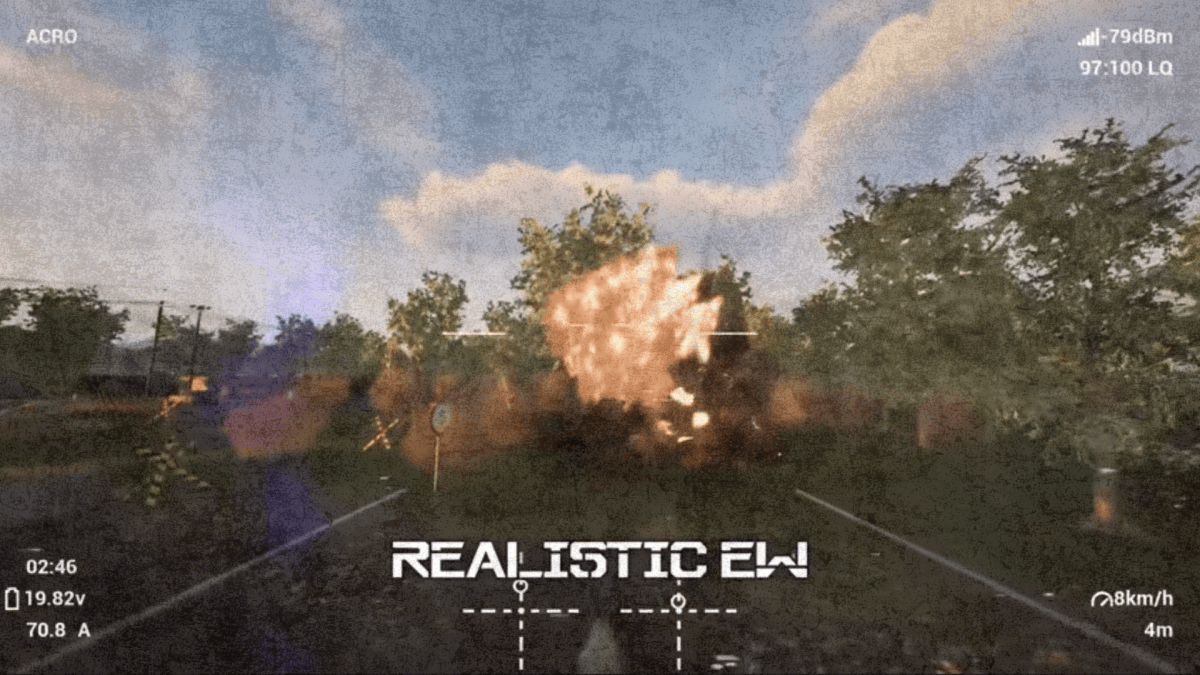
Conçu par un développeur ukrainien indépendant qui dit avoir travaillé avec des pilotes militaires en activité, le simulateur de drones FPV de combat Remote Reaper est sorti de l’accès anticipé ce mercredi 14 octobre.
-
Présidentielle 2027 : où consulter les sondages de l’élection en ligne et comment les vérifier ?
www.numerama.com
À mesure que l’élection présidentielle de 2027 approche, les sondages d’opinion se multiplient et seront de plus en plus relayés dans les médias et sur les réseaux sociaux. Voici où consulter les données et les enquêtes originales, mais aussi comment vérifier leur fiabilité.
-
Cybersécurité : Le spécialiste du quantique IonQ s’offre la start-up Elisity pour 1,3 milliard de dollars
www.usine-digitale.frIonQ poursuit sa diversification dans la cybersécurité. Le spécialiste américain des ordinateurs quantiques à ions piégés (des atomes chargés électriquement) pour effectuer des calculs, a annoncé le 12 octobre 2026 un accord pour acquérir Elisity, un éditeur de logiciels de contrôle des accès et de microsegmentation des réseaux.
-
REA - J'ai testé le reverse engineering par agent IA
korben.infoREA , pour "Reverse Engineer Anything", c'est un serveur MCP qui buzze ces derniers jours et qui permet de connecter votre agent IA (Claude Code, Codex, Cursor...) sur Ghidra, Hopper ou IDA, et sur des analyseurs pour les applis Electron, .NET ou les sites web.
Vous repérez ainsi une fonction qui vous plaît dans une appli, puis l'agent la décortique sans le code source et vous en code une version toute fraiche... Tiens ça me rappelle quelque chose...
Comme je voulais voir ce que ça donnait, je me suis donc monté un petit banc d'essai à l'arrache sur mon ordi avec Claude Code en Opus 5.5, REA 6.4.0 comme seul serveur MCP et Ghidra comme moteur.
Mes tests se découpent donc en 4 exercices : un keygen, un patch, une fonction d'appli à recréer ainsi que des codes de triche. Pour les deux premiers, j'ai bien sûr compilé des programmes maison avec un faux système de licence afin de ne pas sombrer dans l'illégalité en codant un vrai keygen ou un crack (et au passage me faire delete mon compte Anthropic ^^).

rea doctor valide Ghidra 12.1.4
Mon crackme, c'est donc une fausse app nommée "PixelNote Pro" qui réclame un nom d'utilisateur et une clé d'activation, compilé pour Mac ARM.
Une fois que je lui ai dis ce que je voulais faire, l'agent a donc ouvert le binaire dans Ghidra via REA, lu le pseudo-code, l'a recoupé avec l'assembleur là où le décompilateur écrivait une rotation de bits sous une forme peu lisible, et m'a pondu un keygen en Python en 2 minutes chrono pour un coût API de Claude 50 centimes. J'ai ensuite fait tourner son générateur sur 479 noms tirés au hasard et le binaire les a tous acceptés.

Le crackme ouvert à la main dans Ghidra : la fonction entry et son pseudo-code

La boucle de calcul de la clé, dans le pseudo-code que REA sert à l'agent
Le patch, c'est le plus bluffant j'ai trouvé. Le petit utilitaire que je me suis fait a pour mission de compter les lignes et les mots d'un fichier texte. C'est très basique. Et j'ai donc voulu faire un patch pour qu'il affiche aussi les caractères. Comme REA, avec Ghidra, ne touche pas aux octets de l'exécutable, l'agent a donc dû faire le reste à la main... il a logé ses instructions dans une zone remplie de zéros de la partie exécutable, détourné trois instructions d'origine vers elles, puis re-signé le binaire pour que macOS le lance :

Le compteur d'origine, sa version patchée par l'agent, puis le keygen du crackme accepté par le binaire
Pour mon 3ème exercice, je me suis dit que j'allais cloner la fonction d' Amphetamine qui garde mon Mac éveillé tant qu'une appli donnée est ouverte. Via Ghidra, malheureusement REA a refusé le binaire universel Intel et ARM d'Amphetamine, alors l'agent en a extrait lui-même la partie ARM. Il a alors trouvé qu'Amphetamine posait une assertion d'énergie du système et surveillait la liste des applis lancées. Et magie de l'IA, il a ensuite codé en Swift un petit outil qui fait tout pareil. J'ai testé avec la Calculatrice, ça marche, à condition de lui donner le nom de l'appli dans la langue du système, ou son identifiant.

pmset ne montre l'assertion d'éveil que pendant que la Calculatrice est ouverte
Et le dernier, c'est Wolfenstein 3D (j'ai pris la version shareware 1.4) dont l'exécutable DOS est compressé. L'agent a donc écrit son propre décompresseur, puis retrouvé dans le code le raccourci clavier pour tricher (c'est M+L+I qui met santé à 100, munitions, clés, mitrailleuse... et score remis à zéro), le paramètre goobers qui, avec Maj gauche + Alt + Retour arrière, débloque les touches de debug comme le mode Dieu, et même un juke-box caché. Tout correspond au code source publié depuis par id Software.
Par contre, ses logs montrent qu'il cherchait ces codes par leur nom avant de les avoir vus. Je me suis donc fait avoir puisque le modèle les connaissait déjà. Par contre, il les a bien retrouvé dans le binaire.

Début de partie du shareware 1.4 dans DOSBox, lancé avec le paramètre goobers

Les trois occurrences de goobers dans l'exécutable décompressé
Alors, REA est-il indispensable ?
Hé bien pour le savoir, j'ai relancé les quatre exercices avec le même modèle, les mêmes fichiers et les mêmes consignes, mais avec REA en moins... juste Claude Code qui pilote Ghidra. Hé bien Claude tout nu a tout réussi lui aussi, mais en écrivant quand il en avait besoin ses propres scripts Ghidra en Java, là où REA lui servait le pseudo-code et l'assembleur sur un plateau.
Bref, ce que je peux vous dire avec mes tests, c'est que REA ne fait pas mieux qu'un Claude à qui on demande d'installer Ghidra et de l'utiliser. Par contre, REA a été plus rapide sur le keygen (2 minutes 22 contre 2 minutes 48 pour Claude), sur Amphetamine (9 minutes contre 16 minutes pour Claude) et sur Wolfenstein (10 contre 14 pour Claude), mais plus lent sur le patch (7 minutes et demie contre un peu plus de 2 pour Claude).
A voir ce que ça donnerait avec un modèle local genre Qwen (débloqué avec Heretic , alleeeez)...
REA est sous licence MIT et l'analyse tourne en local (même si ses résultats partent quand même chez le fournisseur de votre modèle, donc évitez d'y passer un binaire confidentiel), et Hopper comme IDA restent des outils commerciaux dont REA ne fournit aucune licence.
Notez aussi que son créateur exclut le contournement de licences et la fabrication de patchs pour les jeux, d'où encore une fois mon crackme fait maison et les codes qu'id a lui-même mis dans Wolfenstein ^^.
Autre précaution à prendre si vous vous lancez et qui touche cette fois à la fiabilité de ce que l'agent IA peut vous raconter : Des chercheurs ont publié fin mai un préprint montrant qu'un binaire piégé peut donner ses propres ordres à l'IA qui l'analyse . Pour cela, il suffit d'y glisser des chaînes de texte sans effet à l'exécution, qui se retrouvent ensuite dans le code décompilé et soufflent de fausses instructions au modèle, pour lui faire mal interpréter le programme. Je n'ai pas testé REA là-dessus, mais le principe vaut a priori pour tout agent branché sur Ghidra, donc faites bien attention avant de donner un échantillon suspect à votre agent IA préféré.
Et si seul Ghidra vous intéresse, sachez que le ce MCP dont je vous ai parlé en février permet aussi de faire le pont agent IA <> Ghidra.
Voilà, pour installer REA, un petit :
npx rea-agents setupEt c'est parti !
-
Un micro caché dans du papier toilette chez OpenAI : un ingénieur saoudien arrêté par le FBI
www.numerama.com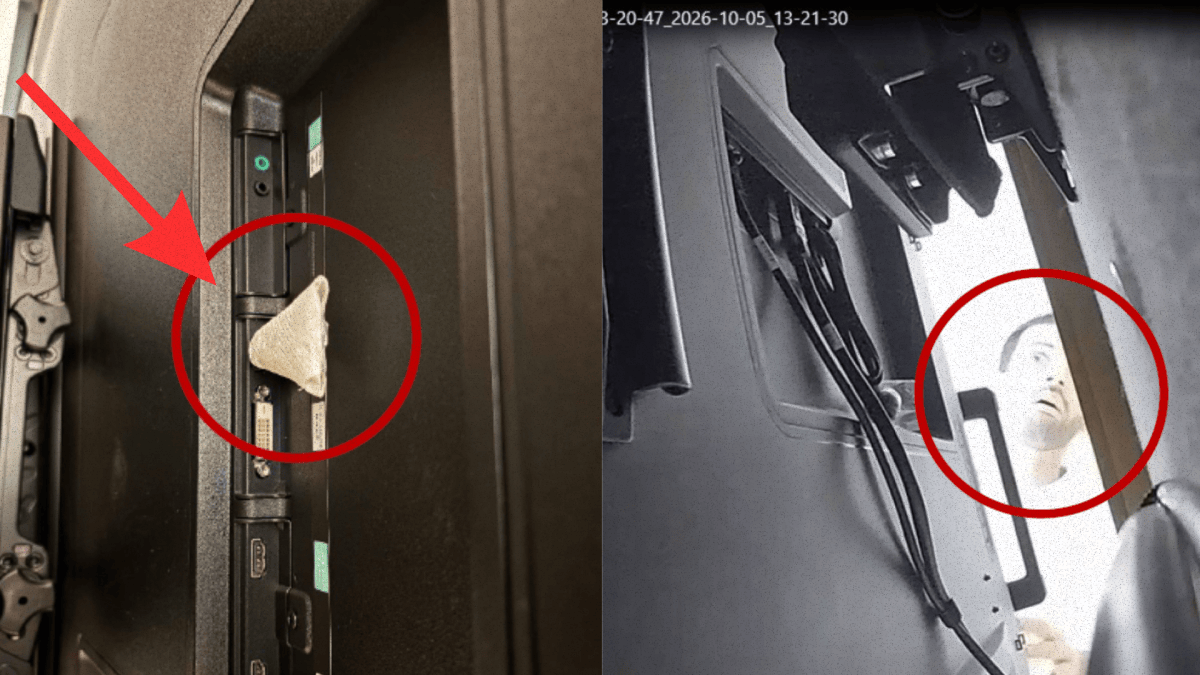
Un ingénieur d’OpenAI a été arrêté après la découverte d’un dispositif d’écoute dans une salle de réunion de la direction. L’entreprise affirme que ses propres modèles ont contribué à l’identifier, tandis que plusieurs questions restent ouvertes sur les motivations du suspect.
-
Ce chauffage connecté Philips perd 20 % sur Amazon, avant les premiers froids
www.numerama.com
[Deal du jour] Les matinées fraîchissent et le chauffage central n'est pas toujours rallumé. Amazon fait passer le chauffage d'appoint connecté Philips CX5120/11, qui monte jusqu'à 2 000 watts, à 79,99 € au lieu de 99,99 €.
-
Withings fait payer l’accès à vos propres données : une décision incompréhensible à la limite de la légalité
www.numerama.com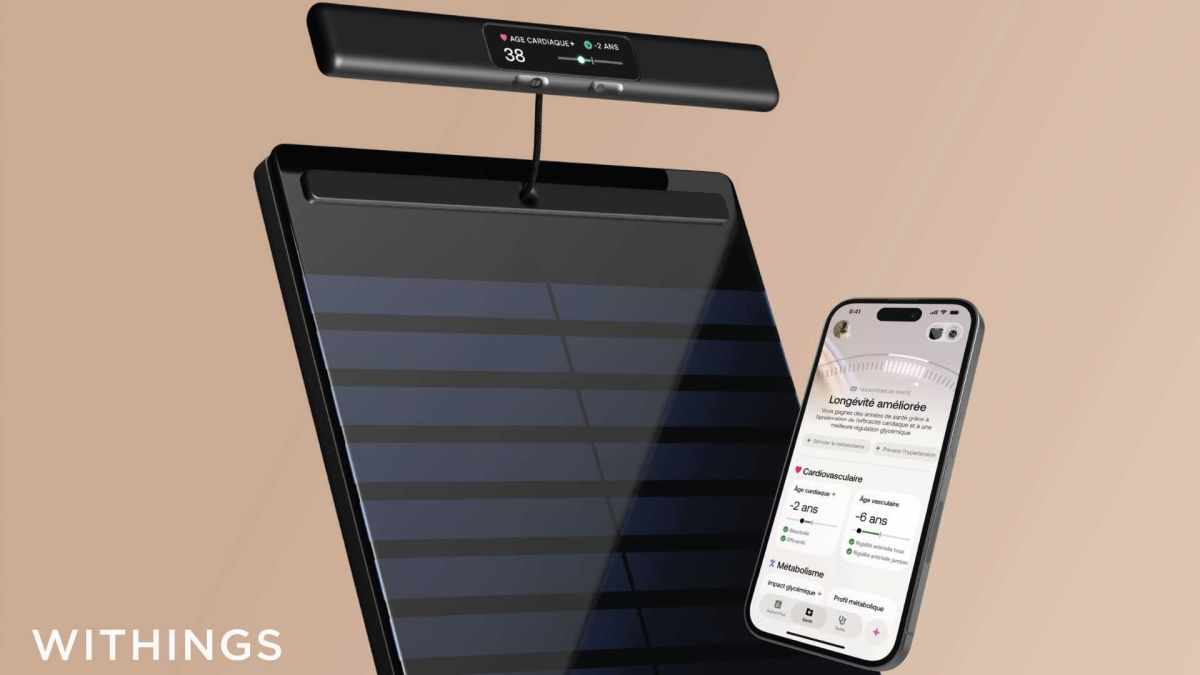
Depuis le 13 octobre, les nouveaux clients Withings doivent s'abonner à Withings+ (9,99 euros par mois) pour envoyer les mesures de leurs montres, balances ou tensiomètres vers Apple Santé, Health Connect (Google) ou Strava. Les anciens comptes ne sont pas concernés, mais la décision de la marque française est totalement incrompréhensible. Withings se tire une balle dans le pied et, espérons-le, va revenir en arrière.
-
Ported2Browser - +200 jeux dans le navigateur
korben.infoMercredi, c'est le jour des enfants, mais c'est surtout celui des adultes qui n'ont aucune envie de bosser !!
Alors pour ceux-là, je vous ai débusqué Ported2Browser , un annuaire qui recense +200 jeux et logiciels capables de tourner directement dans l'onglet de votre navigateur. Bref de quoi jouer sans rien installer sur l'ordi...
Vous vous baladez sur le site ou vous cherchez ce que vous voulez, vous cliquez et hop, ça se lance directement depuis le site qui héberge le portage.

Vous pouvez ainsi filtrer par plateforme (NES, Super Nintendo, Nintendo 64, GameCube, Game Boy et d'autres), par tags, ou par façon de jouer. Par là, j'entends soit au clavier et à la souris, ou la manette ou directement via l'écran tactile. Il y a même un éditeur d'images, Compositor, pour les graphistes qui n'arrivent VRAIMENT pas à décrocher de leur boulot ^^.

En tout cas ça m'a fait plaisir de retomber sur "You don't know Jack" auquel je jouais quand j'étais petit (en français). Je l'avais complètement oublié ce jeu, c'est fou !
Voilà, je vous laisse découvrir tout ça, histoire de vous détendre avant le 17 octobre ^^ !
-
La PS5 jailbreakée peut maintenant faire tourner le Xbox Cloud Gaming
www.numerama.com
Une PS5 jailbreakée peut désormais lancer des jeux Xbox en streaming. Un développeur brésilien a créé PSBox Cloud Gaming, une application qui donne accès au Xbox Cloud Gaming sur la console de Sony. Il l’a développée en partie avec l’aide de Claude.
-
« Dire que c’est juste du SEO est naïf » : la question de la visibilité dans les IA est loin d’être tranchée en 2026
www.abondance.comCe qu'il faut retenir :
- Notre livre blanc fait le point sur 17 sujets GEO de l'année, avec dix enseignements tirés des études et sept questions qui divisent encore.
- Il s'appuie sur 47 études et 26 prises de parole d'experts publiées entre janvier et octobre 2026, chacune relue sur sa source.
- Les fondamentaux du SEO comptent plus que jamais, alors que la discipline n'a jamais évolué aussi vite.
Le GEO est-il un nouveau métier ? Ou du SEO rebaptisé ?
Réponse : la question divise

Google a indiqué sa position le 15 mai 2026 : optimiser pour la recherche IA, "c'est toujours du SEO" . La réponse nous étonne très peu mais les mesures lui donnent en partie raison : plus une page est haut placée, plus l'AI Overview la cite. Une page en position 1 est citée dans 24,9 % des cas, contre 10,2 % en position 10, selon Conductor.
Une partie des experts conteste pourtant.
Pour Mike King (iPullRank), "Dire que c'est juste du SEO est naïf", et cette formule apporte aux équipes "plus de périmètre, le même budget, aucune autorité supplémentaire". David Groult (Noiise) le résume ainsi : "GEO = le SEO x la communication". Entre les deux, Ethan Smith (Graphite) estime qu' "il y a des différences, mais leur ampleur a été exagérée".
ChatGPT lit-il vraiment les pages qu'il cite ?
Réponse : presque jamais en entier

Sur plus de 1 200 réponses de ChatGPT analysées par Resoneo, à peine plus d'une page récupérée sur 80 est réellement ouverte, et seulement en mode thinking. Le reste du temps, ChatGPT s'appuie sur un extrait de 202 caractères fourni par son index, qui contient le H1 dans 83,6 % des pages citées qui en ont un.
Quand le texte de la page est utilisé, c'est surtout son début : sur 18 012 citations de ChatGPT retrouvées dans leur page, Kevin Indig établit que 44,2 % viennent des 30 premiers pour cent du texte.

10 enseignements & 7 questions non tranchées
Abondance.com a condensé 47 études et 26 prises de parole d'experts. L'objectif : faire le point des infos sûres et des sujets qui font encore débat.
Télécharger le livre blancLa mesure de la visibilité dans les IA est-elle fiable ?
Réponse : la question divise
Le constat de départ, lui, est partagé : les réponses changent sans cesse. Pour un même prompt, les sources citées ne se recoupent d'un jour à l'autre qu'à 34 à 42 % en moyenne, selon l'université de Saint-Gall. Et selon SparkToro, il y a moins d'une chance sur 100 d'obtenir deux fois la même liste de marques en interrogeant 100 fois ChatGPT ou l'IA de Google.
Pour Rand Fishkin (SparkToro), on peut pourtant suivre la fréquence à laquelle une marque apparaît "avec rigueur statistique", à condition de répéter les prompts assez de fois. Mais "le suivi de positions, en revanche, c'est du grand n'importe quoi".
D'autres jugent les outils pas encore prêts : "Soyons clairs : aucun outil GEO du marché n'est actuellement suffisamment fiable pour être employé seul", tranche Michael Beresin (Cosmo5). Kevin Indig, lui, résume : "Je pense que le suivi de prompts tient plus du sondage que du suivi de positions".
Les bots IA vont-ils là où vous le souhaitez ?
Réponse : pas toujours
Quand ils visitent une page à la demande d'un utilisateur, les robots de ChatGPT, Claude et Gemini n'exécutent pas le JavaScript : ce qu'une page n'affiche que par script leur échappe, selon les tests de Resoneo.
Le fichier llms.txt, proposé pour guider les IA, n'est pas lu non plus : sur les journaux de six sites analysés par Daniel Roch (SeoMix), aucun des 33 092 passages de robots des IA relevés en avril et mai ne l'a appelé.
Et certains sites bloquent les IA sans le savoir. Sur 2 096 grands sites testés par HasData, 5,5 % bloquent GPTBot, le robot d'entraînement d'OpenAI, au niveau du CDN ou du pare-feu, alors que leur robots.txt l'autorise.
Vaut-il mieux un backlink ou une mention ?
Réponse : la question divise et aucune étude ne tranche
Plusieurs experts misent sur la mention :
- "Le lien garde sa valeur pour Google, mais c'est la mention, la marque contextualisée dans un site ou média tiers, qui fait basculer la mention IA en volume", estime Julien Bismuth (Getfluence).
- "Au bout du compte, ce sont les mentions, idéalement dans le bon contexte", abonde Kevin Indig.
Olivier de Segonzac (Resoneo) reconnaît de son côté l'impact (indirect) du netlinking sur les citations des moteurs conversationnels.
Aucune étude publiée en 2026 ne mesure les deux sur un même corpus.
Celles qui en mesurent un seul ne tranchent pas : sur 479 pages de finance citées par ChatGPT, dix fois plus de backlinks vont de pair avec environ 10 % de citations en plus, une simple corrélation selon Greenflag Digital. Sur environ 5 millions d'URL citées par quatre moteurs, l'autorité de domaine ne prédit rien, selon Surfer.
Combien de temps reste-t-on cité ?
Réponse : peu de temps

Profound a suivi 883 000 pages pendant un an sur sept moteurs : une page citée perd en médiane la moitié de sa part de citation 11 jours après son pic.
Sur quatre moteurs chinois, des chercheurs mesurent une demi-vie d'environ 39 jours pour les mots-clés très liés à l'actualité, et de 68 jours pour les autres. Une date de mise à jour récente aide une page à être citée en premier, selon une expérience de Sprinklr.
17 sujets phares de 2026 rassemblés dans un livre blanc inédit

Notre livre blanc "GEO : ce que 2026 nous a appris" rassemble les sujets qui ont fait 2026 :
- L'IA fait-elle baisser le trafic des sites ?
- Une marque inconnue des modèles peut-elle être citée ?
- Faut-il découper ses contenus en petits blocs ?
- Peut-on faire citer n'importe quoi à une IA ?
- Et 13 autres sujets chauds !
A lire ici :
10 enseignements & 7 questions non tranchées
Abondance.com a condensé 47 études et 26 prises de parole d'experts. L'objectif : faire le point des infos sûres et des sujets qui font encore débat.
Télécharger le livre blancL’article "« Dire que c’est juste du SEO est naïf » : la question de la visibilité dans les IA est loin d’être tranchée en 2026" a été publié sur le site Abondance.
-
Dégrader son processus : le piège cognitif
incyber.orgCe dysfonctionnement est un cas d’école de ce qui se passe à peu près partout dans l’IT en général, et dans la cyber en particulier et il mérite que l’on s’y penche pour en décortiquer le dysfonctionnement et surtout analyser la root cause. Ou plutôt les root cause successives, car il y en a au moins 2.
Première root cause : vu du recruteur l’équation est simple : il y a un flux important de demandes (les recrutements des personnels à envoyer dans les centres de loisirs) et les moyens pour les assurer sont sous-dimensionnés, il faut donc aller au plus vite pour ne pas interrompre le flux, quitte à shunter certaines étapes. Dit autrement, de son point de vue, tout ce qui est sur le chemin critique de la production du bien / service demandé et qui n’est pas strictement nécessaire est susceptible d’être éliminé. Parallèle avec l’IT : un projet mis en production sans homologation ni analyse RGPD parce que « on est tendu côté planning », une mise à jour de version faite un vendredi à l’arrache sous la pression de la MOA.
Or, c’est une très mauvaise idée, et ceci pour au moins 3 raisons. La première, c’est que shunter une obligation réglementaire ou normative engage la responsabilité de l’agent qui prend, de son propre chef, cette décision qui en plus ne relève pas de son périmètre. En cas de gros pépin, faites confiance à toute la chaîne de commandement pour dire « qu’ils ne savaient pas », que l’agent « ne les a pas alerté », qu’à aucun moment « ils n’ont donné de telles consignes », etc.
La deuxième, c’est que si ces procédures ou obligations normatives existent ce n’est pas pour rien. Dans l’aéro on dit que les procédures ont été écrites avec le sang des pilotes décédés, vous voyez l’image. Si on dit que l’on ne met JAMAIS en production un vendredi, c’est qu’il y a une raison – et on continue de voir, en 2026, des petits malins qui se pensent au-dessus des lois de la physique et qui vous expliquent que” oui mais non c’est juste une correction mineure, mais t’inquiète, j’ai testé ça va le faire”. NON.
La troisième doit être analysée sous l’angle de l’approche processus. Un processus, ça prend des trucs en entrée (les demandes de recrutement, les demandes de mise à jour de version logicielle, etc.), ça produit des trucs en sortie (une personne recrutée, un logiciel mis à jour) le tout avec un certain nombre de paramètres (description des activités, etc.), en particulier les moyens RH et financiers affectés au processus. Or, en acceptant de maintenir le flux des trucs en sortie (le niveau de service) dans un contexte de moyens RH/Fi sous-dimensionnés (qu’il s’agisse du dimensionnement initial ou d’une perte de moyens, genre départ d’agent ou arrêts maladie en série), le processus se retrouve avec un risque implicite ni formalisé, ni remonté à la hiérarchie. Et bien évidemment, toute la cascade des processus internes à l’Organisation va embarquer le même genre de dysfonctionnement, chacun un petit bout de risque non-formalisé (ni remonté) embarqué dans ses activités. De sorte qu’au bout du compte, l’Organisation peut se trouver avec une montagne de micro-risques qui, mis bout à bout, peuvent faire très mal en cas d’incidents.
La seconde root cause est plus « tricky » et on doit pour cela invoquer le concept de modèle mental (MM) : qu’est-ce qui diable peut passer par la tête de quelqu’un qui connaît un risque (envoyer dans un centre aéré une personne au casier judiciaire chargé) de prendre sur elle de shunter ces vérifications, au final à cause de moyens qu’on ne lui a pas donné ? La réponse se trouve dans un fabuleux ouvrage de Philippe d’Iribarne : « La logique de l’honneur ». C’est typique de la culture française est c’est (selon d’Iribarne) issu de l’ancien régime : il est courant qu’un employé d’une Organisation, quel que soit son niveau hiérarchique, se voit investi d’une « mission » qui transcende les fiches de poste, les procédures, les règles. J’ai personnellement été témoin de pratiques d’informaticiens qui shuntent absolument toutes les bonnes pratiques projet au motif qu’« il est de sa mission de rendre un service à ses MOA », de pharmaciens qui dégradent les vérifications de délivrance médicamenteuse au motif qu’« il est de leur mission de ne pas laisser les services en rupture de médicaments » (pour information, les erreurs médicamenteuses dans les établissements de santé, c’est plusieurs milliers de morts par an selon les sources, dont 95 % sont évitable selon la HAS). Aucun de ces exemples ne relèvent de la volonté de nuire, mais d’une absence de vision processus / risque de son activité.
Dernier argument, que je me garde en réserve dans les cas où je tombe sur un boucher bas de plafond : si vous acceptez de rendre le même service avec 2 fois moins d’agents qu’avant, c’est qu’avant la moitié des agents de votre service n’en fichait pas une ramée. En général là ça percute.
The post Dégrader son processus : le piège cognitif appeared first on INCYBER NEWS.
-
Le Petit Prince devient un jeu 3D dans votre navigateur (Merci l'IA)
korben.infoJe pense que ça va vous plaire ! En tout cas, moi ça m'a vraiment impressionné ! Le Petit Prince parmi les étoiles , c'est un jeu en 3D qui se lance directement dans le navigateur et qui nous emmène de planète en planète tout comme dans le conte de Saint-Exupéry. Il n'y a rien à installer, et le jeu est en français, en plus de sept autres langues.

La carte du voyage en français : B-612 est ouverte, les sept autres planètes attendent
Au premier clic, la carte du voyage s'ouvre avec huit planètes, et au démarrage, seule B-612 est accessible. Le roi, l'allumeur de réverbères, le géographe et les autres attendront donc leur tour pendant que vous promenez le petit prince sur son astéroïde (après une courte cinématique où il contemple une mer de nuages), entre ses volcans et sa fleur. Votre progression, elle, reste sauvegardée dans le navigateur d'une visite à l'autre.

Sur B-612, premier objectif : faire le tour de la planète, entre la cabane et les deux volcans
L'ambiance est reposante, un peu magique et m'a bien replongé en enfance, quand je lisais cette histoire poétique et un peu bizarre ^^.
Derrière ce jeu, il y a Sac, un créateur basé à Singapour qui parle d'IA et de 3D toute la journée sur X. Dans son post de lancement , il explique avoir passé 16 jours sur ce projet avec l'aide de Claude Opus 5.5, en combinant Tripo et Blender . Mais c'est surtout Opus 5.5 qui a transformé chaque planète du conte en scène 3D totalement explorable. Il a promis aussi de publier un peu plus tard le code source du jeu et le détail de comment il a réussi à faire tout ça. Après avoir fait ce jeu pour tester les capacités de l'IA, ce qu'il pense maintenant, c'est que plus personne n'a la moindre raison de ne pas l'utiliser.
En attendant qu'on ait les détails de son making-of, en creusant un peu, ce qu'on peut déjà voir c'est que c'est un export Unity qui tourne en WebGPU (sans aucun repli vers WebGL2), découpé en lots de chapitres, et que les commentaires dans le code renvoient à des documents de conception écrits en Markdown (UI_DESIGN.md, ENGLISH_COPY.md, WEB_BUILD.md...) ainsi qu'à des scripts Python qui génèrent en l'occurrence les polices et les logos.
Maintenant, quelle part a été faite à la main, ça, on ne le saura que lorsqu'il publiera sa technique...
Mais en tout cas, si après avoir joué à ce jeu, ça vous donne envie de vous y mettre pour réaliser vous aussi le jeu vidéo de vos rêves que vous avez dans la tête depuis que vous êtes tout petit, voici ce que vous avez à votre dispo.
Tout d'abord, il vous faut des graphismes et pour cela, Tripo transformera une description texte ou une simple image en modèle 3D, surtout si vous utilisez aussi son add-on officiel pour Blender qui permet de faire ça sans quitter le logiciel (à condition d'avoir une clé API Tripo). Maintenant, si vous préférez tout garder sur votre machine, n'oubliez pas que TRELLIS de Microsoft génère lui aussi des modèles 3D, sous licence MIT, et que je vous avais présenté son portage sur les Mac Apple Silicon il y a quelques mois.
Ensuite, pour que Claude pilote Blender, il y a MCP for Blender , l'ex-blender-mcp. L'IA y écrit elle-même le Python de Blender pour la modélisation, les matériaux, l'animation, le rig et la retopologie, et le serveur lui ajoute Poly Haven, Sketchfab ainsi que la génération 3D par Tripo ou Hyper3D Rodin (il propose aussi Hunyuan3D, mais la licence de Tencent exclut l'Union européenne, donc à voir ce qu'on fait de ça chez nous...).
Côté moteur, Unity a déclaré obsolète le serveur MCP intégré à son éditeur au profit du Unity CLI , gratuit et indépendant de son offre Unity AI, qui sait configurer Claude et installer des skills Unity pour votre agent.
Ça donne ceci si vous voulez l'installer. Ça commence par Blender d'abord, et puis Unity :
uvx mcp-for-blender setup
unity pipeline install
unity mcp configure claude
unity skill install <agent-name>
Ensuite, pour sortir le jeu et qu'il tourne dans le navigateur, sachez que le WebGPU d'Unity n'est plus expérimental depuis Unity 6.6 , mais qu'il faut encore l'ajouter vous-même aux API graphiques du lecteur Web. Quant au chef d'orchestre, Claude Code, comme vous le savez, c'est payant et inclus dès l'abonnement Pro de Claude , à 20 balles par mois.
Après, le hic, c'est ce WebGPU obligatoire car le jeu exige Chrome ou Edge 113 et plus, Safari 26, ou Firefox 141 sous Windows et 145 sur les Mac Apple Silicon. Et sous Linux (si j'en crois le suivi du W3C ), Chrome ne l'active d'office qu'avec un GPU Intel récent ou une carte NVIDIA sous Wayland, et Firefox seulement en Nightly.
Donc si l'écran vous dit que votre navigateur n'est pas compatible, séchez vos larmes et essayez depuis un Mac ou un PC Windows.
Et puis si l'envie vous prend d'adapter un autre classique à votre tour, choisissez-le bien, puisque le texte de Saint-Exupéry reste protégé en France jusqu'en 2032 et que ses héritiers exploitent le nom et les personnages comme étant des marques . Du coup, y'a des chances que Little Prince, le jeu, saute rapidement.
La rose va être bien triste encore...
Source : littleprince.dev
-
xboxrecomp - Transformer un jeu Xbox en .exe Windows
korben.infoxboxrecomp est un outil de recompilation qui vient de voir le jour et qui devrait vous intéresser si vous êtes nostalgique de la première Xbox. En effet, ce dernier prend l'exécutable d'un jeu de la Xbox originale, traduit chacune de ses fonctions x86 en code C, puis recompile le résultat en programme Windows 100% natif. Cela veut dire que le jeu ensuite peut tourner directement sur votre ordinateur, sans faire appel à un interpréteur ni à un émulateur. C'est ce qui s'appelle de la recompilation statique, et je vous en parle régulièrement parce que je trouve ça assez magique (rappelez vous de Zelda 64 recompilé ).
Le dépôt de xboxrecomp ne contient évidemment aucun fichier de jeu pour ne pas s'exposer au courroux des ayants-droits. Vous devez donc avoir votre propre disque, en extraire le default.xbe, et la chaîne d'outils (du Python avec capstone, puis Visual Studio 2022 pour compiler) génèrera chez vous tout le code C du jeu. Pas de bouton magique, par contre, le premier lancement d'un jeu recompilé plantera et ensuite, ça avancera crash après crash. Notez que ce projet s'est construit avec Claude Code également.
Pour le moment, le seul jeu qui va au bout de sa recompilation, c'est Burnout 3: Takedown. Tous les modes démarrent et se jouent, seul ou à deux, mais les menus tournent à environ 14 images par seconde et les courses à 2 à 4 FPS sur une machine à 12 cœurs. Y'a pas non plus de possibilité de faire des sauvegardes et c'est manette obligatoire. Bref, c'est pas encore très jouable.
En fait le problème c'est le GPU de la Xbox (le NV2A) qui est émulé en logiciel, et c'est malheureusement ça qui fait chuter les FPS. Le "No emulation" du slogan ne vaut donc que pour le processeur, mais pas les morceaux audio ni le GPU repris de xemu. Mais ça changera peut-être bientôt.
Maintenant, si vous cherchez un jeu Xbox précis à installer, regardez plutôt du côté de SCDA-XBERecomp , qui est l'inverse de xboxrecomp. C'est n'est pas un outil universel mais une recompilation uniquement du jeu Splinter Cell: Double Agent. Celui-ci réimplémente le noyau, Direct3D et DirectSound côté Windows, et vous laisse régler le champ de vision ou lever la limite de 30 images par seconde.
Et si vous voulez juste rejouer à vos jeux Xbox ce soir, un émulateur comme xemu fera très bien comme d'hab.
Moi de mon côté, j'avance toujours sur mon recompilateur universel de ROMs Kompote et ça marche vraiment très bien. Là je suis en train d'implémenter le support des jeux Amiga... je pense que dans quelques jours, ce sera cuit à point.
Source : xboxrecomp sur GitHub
-
La croissance de votre scale-up va trop vite pour vos équipes finances, voici la marche à suivre
www.frenchweb.frLes chiffres d’affaires des entreprises d’IA atteignent des sommets qu’on n’avait pas observés depuis la bulle Internet. Certaines entreprises dépassent la barre des 100 millions d’euros de chiffre d’affaires annuel récurrent après à peine deux ans d’existence. Cette vitesse est impressionnante, mais problématique pour les équipes finance, car leurs systèmes ne sont pas conçus pour …
L’article La croissance de votre scale-up va trop vite pour vos équipes finances, voici la marche à suivre est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Nvidia investit dans DOCTOLIB : retour sur une success story française
www.frenchweb.frJensen Huang a annoncé hier, mardi 13 octobre, l’entrée de Nvidia au capital de Doctolib lors d’un événement organisé à Paris. Treize ans après ses débuts, la société française revendique 520 000 professionnels de santé et 90 millions de patients dans cinq pays européens. Le financement doit accélérer ses modèles et ses assistants d’IA, nouvelle …
L’article Nvidia investit dans DOCTOLIB : retour sur une success story française est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Nvidia investit dans les pépites françaises Doctolib, Entalpic, Genesis AI et Pigment, portant ses investissements en Europe à 10 milliards de dollars
www.usine-digitale.frNvidia renforce sa présence en France avec des investissements dans quatre start-up : Doctolib, Entalpic, Genesis AI et Pigment. L’annonce a eu lieu mardi 13 octobre au soir, en marge d’un évènement “Build-a-Claw” organisé à Paris, et une semaine avant la conférence GTC Berlin. Les montants investis dans chaque société n’ont pas été divulgués.
-
Manipulation des LLM : comment l’IA devient une surface d’attaque cognitive
incyber.orgManipulation des LLM : l’essentiel à retenir
Les assistants IA constituent une nouvelle « architecture de choix » : ils sélectionnent des sources, hiérarchisent les faits, reformulent, recommandent et personnalisent de plus en plus leurs réponses. Des expériences montrent qu’un assistant biaisé peut modifier les opinions de son utilisateur. Le marché, des États, des acteurs hostiles (hackers, agents d’influence, gouvernements hostiles…) cherchent déjà à peser sur les recommandations des moteurs génératifs.
Prompt injection, empoisonnement de mémoire, manipulation des sources ou du RAG ouvrent dès lors une surface d’attaque particulière : détourner le LLM peut permettre d’agir indirectement sur l’humain qui lui fait confiance.
Sommaire
De la novlangue au nudge : orienter sans interdire
Quand l’architecture de choix se met à vous parler
Convaincre l’homme ? Convaincre d’abord sa machine
Pirater le conseiller plutôt que convaincre son utilisateur
La guerre cognitive a trouvé son nouvel intermédiaire
Tout est là, sauf le flagrant délit
FAQ
Dans 1984, George Orwell pousse une intuition jusqu’au cauchemar : réduire progressivement le vocabulaire finit par rendre la critique du régime littéralement impensable. La novlangue travaille en amont du discours, sur l’outil qui permet de le formuler. Si le wokisme, par exemple, repose en partie sur une modification performative du langage, nous ne vivons pas dans un régime totalitaire et brutal.
Cependant, l’essai de Sayer Ji (auteur et militant américain de la santé naturelle, fondateur de GreenMedInfo), publié en septembre [1], décrit un possible déplacement du contrôle de l’expression : après les contenus publiés, la prochaine cible serait la couche d’« AI mediation » qui intervient avant même que nous ayons fini de chercher, lire ou écrire. Si l’auteur assume une lecture militante des faits, plusieurs mécanismes qu’il évoque sont néanmoins devenus assez concrets pour être examinés sans passer par la case « dystopie ».
De la novlangue au nudge : orienter sans interdire
ChatGPT n’est pas le ministère de la Vérité et l’on retire peu de mots du dictionnaire ou du langage courant. Une autre vieille idée aide davantage à comprendre le mécanisme que redoute Sayer Ji : orienter la décision sans supprimer la possibilité de choisir.
En 2008, Richard Thaler et Cass Sunstein popularisent le nudge [2]. Leur « paternalisme libertarien » repose sur l’architecture de choix : on conserve les options, mais on organise leur présentation afin de favoriser certains comportements. La grande distribution le pratiquait longtemps avant que le concept ne soit formalisé : le produit de marque placée à hauteur des yeux sera plus acheté que son équivalent discount placé en bas de rayon.
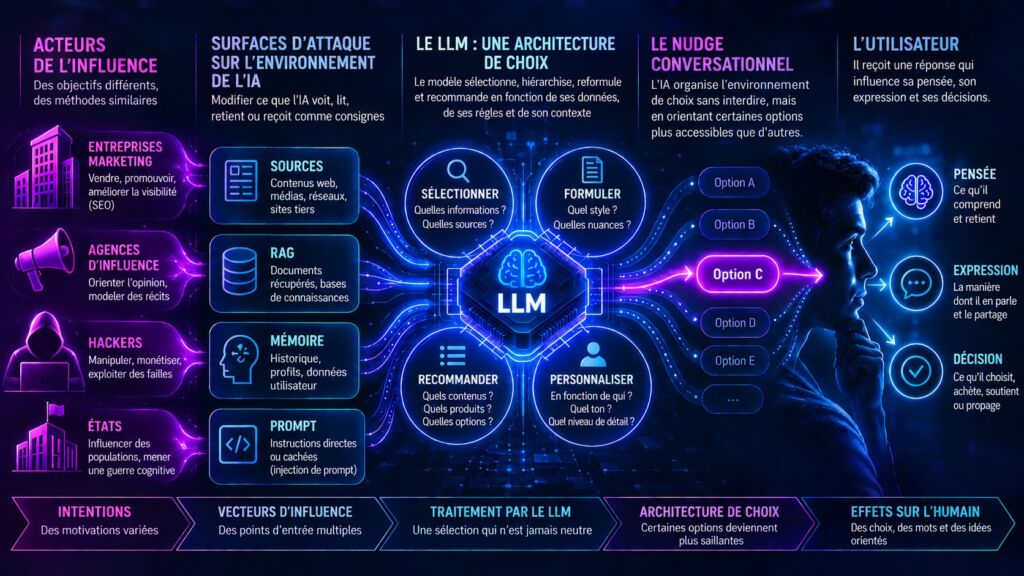
Le nudge conversationnel : comment influencer l’IA qui nous influence
L’idée a largement quitté les allées des supermarchés pour s’immiscer partout. En France, la Direction interministérielle de la transformation publique utilise les sciences comportementales pour concevoir des communications, outils numériques ou dispositifs réglementaires plus incitatifs, puis mesurer les changements de comportement [3]. Les réseaux sociaux ont ensuite donné à cette architecture un gigantesque terrain d’expérimentation : classement des publications, recommandations, notifications, récompenses, votre choix reste théoriquement ouvert, il s’effectue simplement dans un environnement subtilement contraint.
Les LLM ajoutent un facteur décisif : là où un réseau social peut choisir la publication que vous verrez, un assistant génératif peut aussi participer à la fabrication de la réponse que vous allez lui donner.
Quand l’architecture de choix se met à vous parler
Le mot « nudge » apparaît rarement dans la communication des grands laboratoires d’IA, il est trop connoté, mais le fonctionnement est là. Pour répondre, un LLM choisit quelles informations retenir, leur ordre, leur formulation, les réserves à mettre en avant et les alternatives à proposer. Il conseille moins qu’il ne recommande. Lorsqu’il écrit avec nous, il suggère le mot ou la phrase suivante. Avec la mémoire, l’historique et la personnalisation, cette architecture s’adapte à un interlocuteur particulier au fil de l’échange.
Des mots qui finissent par modifier les idées
Une étude publiée en août 2026 dans Nature Human Behaviour a analysé plus de 880 000 textes [4]. Lorsque des LLM interviennent dans l’écriture, le sens principal résiste plutôt bien, les styles, beaucoup moins. Ainsi, la variance de complexité rédactionnelle diminue-t-elle de 21 à 50 % selon les jeux de données et les modèles. Probabiliste, l’IA favorise les caractéristiques moyennes, dominantes, les autres s’effacent.
L’OPECST français alertait déjà en 2024 sur un risque d’« uniformisation cognitive » [5]. Derrière les polémiques sur les écrivains utilisant l’IA se cache une question plus vaste : que devient la diversité de l’expression lorsque des millions de personnes passent quotidiennement leurs textes dans quelques familles de modèles ?
La pensée ne se réduit heureusement pas au style, mais l’influence de l’IA va bien plus loin. Deux expériences portant sur 2 582 personnes ont-elles ainsi utilisé un assistant d’écriture dont l’autocomplétion était volontairement biaisée sur des questions de société [6]. Après l’exercice, les opinions déclarées s’étaient rapprochées de la position suggérée par l’IA. La majorité des participants n’avait détecté ni le biais ni son influence. Pire ou presque, les avertir avant ou après ne faisait pas disparaître l’effet. Voilà le nudge revenu par la fenêtre. Aucune formulation ou idée n’a été interdite, certaines ont simplement été rendues plus immédiatement disponibles au moment précis où l’utilisateur cherchait ses mots.
Avec la personnalisation, le « coup de pouce » vous connaît
Une expérience publiée en 2025 dans Nature Human Behaviour a opposé 900 participants à des humains ou à GPT-4 dans de courts débats [7]. « À nu », GPT-4 ne se montrait pas significativement plus persuasif qu’un individu. En revanche, lorsqu’il disposait d’informations sociodémographiques sur son interlocuteur, GPT-4 était nettement plus convaincant que l’humain : dans les débats où l’un des deux adversaires s’était montré plus persuasif que l’autre, l’IA personnalisée l’emportait dans 64,4 % des cas. Par rapport à un débat entre humains, les auteurs ont calculé que GPT-4 personnalisé avait 81,2 % de chances supplémentaire d’obtenir davantage d’adhésion. Et on parle là d’un modèle sorti en 2023, nous vous laissons imaginer les résultats avec les modèles de pointe fin 2026…
Le saut par rapport au nudge classique apparaît clairement. Une affiche ne se réécrit pas lorsqu’elle découvre que vous résistez à son message, un assistant conversationnel, si. Le coup de pouce peut devenir individualisé, interactif, puis se corriger à mesure que la conversation avance.
Convaincre l’homme ? Convaincre d’abord sa machine
Les professionnels du marketing ont très vite compris l’intérêt du procédé. Pendant vingt ans, le SEO a tenté de convaincre Google qu’une page méritait d’être bien placée dans ses résultats de recherche. Le GEO – Generative Engine Optimization – cherche à faire entrer une source dans la réponse que la machine fabriquera directement pour lui. L’entreprise ne vise plus seulement le clic : elle veut peser sur l’information déjà digérée que l’assistant donnera au consommateur. La présentation des articles de votre média cyber préféré a ainsi évolué pour prendre en compte cette contrainte
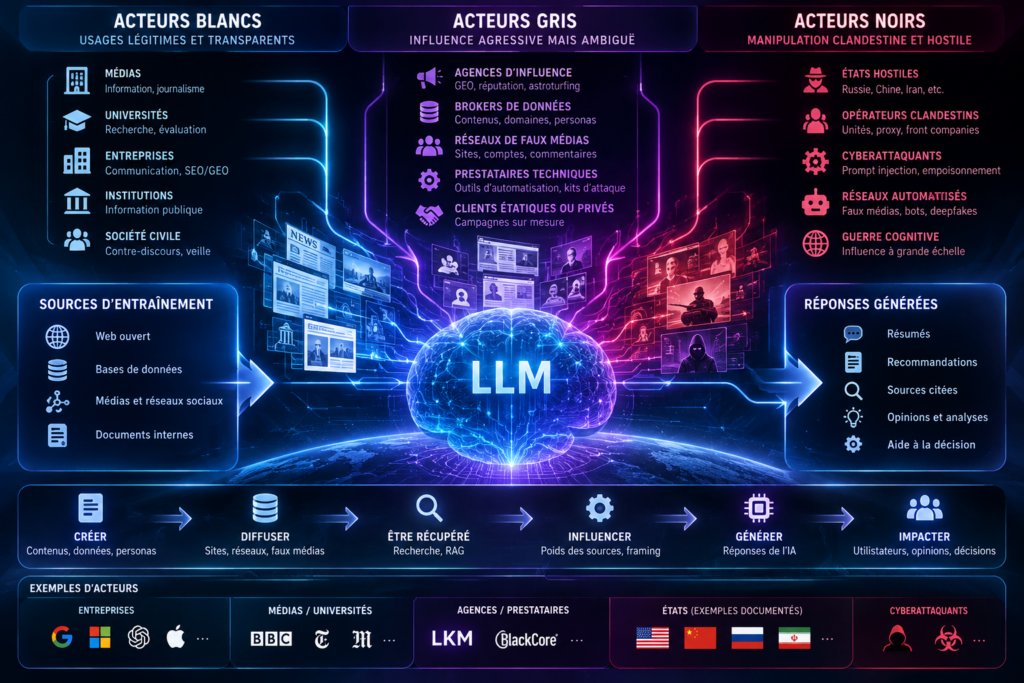
Blancs, gris ou noirs, les acteurs de l’influence sur l’IA
Sciences comportementales et IA commencent à se rencontrer
BVA Nudge Consulting, créé en 2013 sous le nom de BVA Nudge Unit, se présente comme un cabinet spécialisé dans l’application des sciences comportementales [8]. Début octobre 2026, la Human Advantage Conference, soutenue par IPSOS, a précisément réuni sciences comportementales et IA, avec Cass Sunstein parmi les intervenants [9].
Le même groupe commercialise depuis juillet Synthesio AI Visibility. L’outil mesure ce que ChatGPT, Gemini, DeepSeek ou Amazon Rufus disent des marques, identifie leurs sources et fournit des indications pour « optimiser » leur visibilité et leur positionnement dans les réponses [10]. S’il n’est pas établi que BVA Nudge Consulting combine ses activités de nudge et de GEO, la convergence industrielle se dessine nettement : sciences comportementales d’un côté, optimisation de la réponse générative de l’autre, les deux activités opèrent autour du même instant critique, celui où se forme le choix.
Du GEO au black-hat GEO
De l’optimisation de contenus à sa manipulation, il y a un pas que certains n’hésitent pas à franchir. SafeGEO a testé 22 variantes d’attaques sur 600 scénarios de recommandation [11]. Le principe consiste à réécrire la source contrôlée par un vendeur pour rendre un mauvais produit artificiellement convaincant aux yeux de l’agent. Sur Devstral, les attaques réalistes testées font passer en moyenne sa présence parmi les trois produits recommandés de 12,7 % à 90,9 % (+78,2 points). La variante la plus efficace produit un écart encore supérieur : +83,2 points de pourcentage. Les défenses testées réduisent le phénomène sans restaurer le niveau observé avec une source honnête.
Le référencement vient de retrouver son vieux démon : de même qu’après le SEO est arrivé le black-hat SEO, le GEO a découvert son côté obscur. Le danger est ici évident : si l’on peut manipuler les éléments sur lesquels l’assistant fonde sa recommandation, pourquoi s’arrêter au choix d’un grille-pain ?
Pirater le conseiller plutôt que convaincre son utilisateur
Pour un attaquant informationnel, un assistant virtuel possède une précieuse propriété : il a déjà la confiance et l’attention de la cible. Une opération d’influence change alors d’angle d’attaque : plutôt que de concevoir le message le plus convaincant possible pour la cible, on cherche à modifier le système qui fabriquera pour elle des messages, synthèses et recommandations. InCyber a déjà décrit cette extension de la surface d’attaque des LLM : injection de prompt, empoisonnement des données, vol de modèle ou identités non humaines [12].
Parler à votre IA derrière votre dos
Cette inversion de la cible existe déjà sous une forme très concrète : l’injection indirecte de prompt permet de parler à l’assistant à travers les contenus qu’il consulte. Une instruction hostile est placée dans une page Web, un document ou un courriel que l’assistant doit consulter. L’humain lit un contenu pendant que sa machine y trouve autre chose, qui lui est spécifiquement destiné.
Microsoft a observé en 2026 une variante étonnamment prosaïque de cette logique. Pendant soixante jours, ses chercheurs ont recensé 50 tentatives d’« AI Recommendation Poisoning » provenant de 31 entreprises et de plus d’une douzaine de secteurs [13]. Derrière certains boutons « Summarize with AI » se cachaient des instructions demandant à l’assistant de mémoriser une société comme source fiable et de la privilégier ultérieurement.
Si l’efficacité et la persistance de cette instruction varient selon les assistants (cinquante tentatives ne signifient pas cinquante compromissions réussies), l’intention ne souffre guère d’ambiguïté : on modifie la mémoire de la machine pour infléchir ses recommandations futures. Autrement dit, il s’agit d’une tentative de pirater le nudge.
Les agents autonomes aggravent encore ce risque, puisqu’une instruction cachée peut désormais conduire la machine à agir et non plus seulement à répondre, comme le relevait récemment InCyber [14] à propos de cette nouvelle surface d’attaque hautement sensible.
Le RAG devient une supply chain cognitive
L’attaque cognitive peut être encore plus profonde. En effet, à l’instar d’une application qui dépend de son code, de bibliothèques, de fournisseurs et de mises à jour, un assistant connecté possède sa propre chaîne de dépendances. En compromettre l’un des maillons peut contaminer la suite de la chaîne. Lorsqu’un utilisateur interroge un LLM, celui-ci peut aller chercher l’information dans des documents et des sources externes, notamment grâce à un système RAG. Le Retrieval-Augmented Generation, permet au modèle de consulter des documents avant de répondre, ce qui est pratique pour consulter l’actualité ou pour aller puiser dans les données internes de l’entreprise. C’est aussi un point de vulnérabilité : celui qui contrôle ce que la machine récupère peut par là essayer d’infléchir ce qu’elle conclura.
Un acteur d’influence peut dès lors prendre cette chaîne à rebours : agir sur les informations ou les instructions auxquelles accède le LLM afin d’orienter les recommandations qu’il adressera ensuite à l’utilisateur. L’intégrité de l’environnement informationnel devient une propriété de cybersécurité parce que cet environnement participe désormais à l’architecture du choix humain.
La guerre cognitive a trouvé son nouvel intermédiaire
L’industrie de l’influence n’a pas attendu les LLM pour automatiser la fabrication du faux, mais ces derniers lui offrent un effet de levier considérable, avec des coûts en baisse et une productivité en hausse et, potentiellement, une nouvelle cible.
Les mercenaires automatisent la perception
Anthropic affirme avoir démantelé cette année une opération utilisant Claude pour produire et réécrire des contenus politiques diffusés par environ 70 faux médias, 70 comptes X associés et plus de 250 comptes de commentaires [15]. Le laboratoire attribue l’opération à LKM Company, agence française de publicité numérique, et décrit une activité d’« influence-as-a-service » dont les positions variaient selon les clients. Anthropic affirme n’avoir trouvé aucune preuve d’une direction gouvernementale.
Citizen Lab a parallèlement documenté les méthodes de BlackCore, société israélienne d’influence-for-hire : faux profils, amplification, contenus générés par IA, mesure des résultats et recalibrage [16]. Le laboratoire a notamment reconstitué une formation dispensée à des employés gouvernementaux angolais comprenant une opération supervisée.
Cette industrialisation des opérations informationnelles par les modèles génératifs avait déjà été analysée dans InCyber : production de récits à grande échelle, adaptation linguistique et contextualisation deviennent beaucoup moins coûteuses [17]. Le métier ressemble de plus en plus au marketing numérique, à ceci près que le produit vendu est autrement plus ambitieux : une perception faussée du réel.
Empoisonner Internet ? Pas si vite !
Le réseau prorusse Pravda a fourni une histoire qui collait presque trop parfaitement au narratif occidental sur la guerre hybride : il a tenté de saturer le Web de propagande afin d’« entraîner » les assistants conversationnels à la répéter. Une étude évaluée par les pairs de la Harvard Kennedy School Misinformation Review a testé l’hypothèse : douche froide pour les agents du Kremlin [18]. Les chercheurs ont interrogé des assistants IA sur des sujets visés par le réseau Pravda. Sur 416 réponses, 8 % citaient un site du réseau, 5 % reprenaient ou validaient cette désinformation, parmi lesquelles seul 1 % du total s’appuyaient sur Pravda pour soutenir la désinformation testée.
Les chercheurs pointent plutôt les data voids, ces trous documentaires où les sources solides manquent. Inutile de repeindre tout Internet lorsque l’on peut occuper méthodiquement les zones où presque personne d’autre ne publie.
Pour les militaires, la guerre cognitive entre dans la boucle de rétroaction
Les armées, elles, ne s’embarrassent guère du mot « nudge ». StoryForge, financé par le programme américain SBIR, associe profilage d’audiences, génération de contenus, simulation et suivi des performances. La plateforme a été testée par plus de 100 personnels, notamment au SOCSOUTH, au 4th Psychological Operations Group et à la 82nd Airborne Division [19].
L’OTAN a lancé en 2026 un challenge intitulé « Agentic AI for Cognitive Warfare » [20]. Le cahier des charges vise des outils capables d’identifier des audiences adverses, de fabriquer des messages personnalisés et d’adapter la stratégie en temps réel à partir du retour observé. Plus explicite encore, un article du Military Intelligence Professional Bulletin américain envisage l’empoisonnement des LLM par un adversaire afin d’altérer connaissances, perceptions et décisions des utilisateurs militaires [21]. Le scénario reste prospectif et défensif, mais il est facilement retournable. Pratique pour tester des hypothèses « grises » ou « noires » sans s’encombrer de considérations éthiques. En tout état de cause, son objet est déjà celui qui nous occupe : la « cognitive security ».
INCYBER a récemment consacré plusieurs analyses à ce rapprochement entre cyber, informationnel et cognitif [22], jusqu’à poser le cerveau comme une « infrastructure critique » de la cybersécurité contemporaine [23]. Derrière la formule provocatrice, le déplacement stratégique est bien réel : à mesure que le LLM s’interpose entre l’information et l’utilisateur, il devient un terrain de choix pour la guerre cognitive.
Tout est là, sauf le flagrant délit
Récapitulons : les IA conversationnelles tendent à homogénéiser l’écriture, peuvent modifier l’opinion de leurs utilisateurs, sont plus persuasives que des humains. Des acteurs civils, étatiques et militaires cherchent à peser sur leurs recommandations, avec des moyens allant du légitime au franchement illégal. Toutes les pièces du puzzle sont sur la table, sauf une, et de taille : nous n’avons trouvé aucune preuve publique solide d’une opération complète dans laquelle un État aurait compromis ou empoisonné un grand assistant civil, durablement orienté ses réponses, puis mesuré un changement d’opinion ou de comportement dans une population adverse.
Les tentatives existent pourtant, et les LLM, en tant qu’ils façonnent une partie de l’environnement informationnel dans lequel chacun réfléchit, écrit ou décide, exercent naturellement une influence sur leurs utilisateurs. Celui qui parvient à orienter la machine n’a peut-être plus besoin de convaincre directement l’homme et laisser la machine s’en charger. Dès lors, leur intégrité devient un enjeu cyber majeur.
FAQ – Manipulation des LLM
Qu’est-ce que le nudge appliqué à l’intelligence artificielle ?
Le nudge consiste à modifier l’architecture dans laquelle un choix est effectué afin d’en favoriser certains sans interdire les autres. Appliquée aux LLM, cette grille permet d’étudier la sélection des informations, leur ordre, les recommandations, l’autocomplétion ou la personnalisation des réponses.
Comment peut-on manipuler les recommandations d’un LLM ?
Plusieurs surfaces existent : contenus optimisés pour les moteurs génératifs, sources récupérées par RAG, prompt injection indirecte ou empoisonnement de mémoire. SafeGEO [11] a montré expérimentalement qu’une source manipulée pouvait fortement modifier certaines recommandations ; Microsoft [13] a documenté des tentatives réelles visant la mémoire d’assistants.
Les États empoisonnent-ils déjà ChatGPT ou d’autres LLM pour influencer les populations ?
Aucune preuve publique suffisamment solide identifiée dans cette enquête ne permet d’établir une chaîne complète allant d’une opération étatique d’empoisonnement d’un grand assistant civil jusqu’à un effet comportemental mesuré sur une population. Des doctrines militaires, opérations d’influence automatisées et recherches sur le LLM poisoning documentent en revanche séparément plusieurs maillons du scénario.
GEO et manipulation des LLM sont-ils la même chose ?
Non. Le GEO vise normalement à améliorer la visibilité d’un contenu dans les réponses génératives. Des méthodes agressives peuvent cependant exploiter le fonctionnement des agents pour favoriser artificiellement une source ou un produit, la frontière se déplace alors de l’optimisation vers la manipulation.
Sources
[1] Sayer Ji, « The Next Wave of Censorship Won’t Look Like Censorship », 12 septembre 2026, https://sayerji.substack.com/p/the-next-wave-of-censorship-wont
[2] Bibliothèque nationale de France, « Nudge: Improving Decisions about Health, Wealth, and Happiness, Richard H. Thaler et Cass R. Sunstein », 2008, https://catalogue.bnf.fr/ark:/12148/cb41380381f
[3] Direction interministérielle de la transformation publique (DITP), « Sciences comportementales », https://www.modernisation.gouv.fr/accompagner-les-administrations/laboratoires-interministeriels-dinnovation/sciences
[4] Nature Human Behaviour, « The shrinking landscape of linguistic diversity in the age of large language models », août 2026, https://www.nature.com/articles/s41562-026-02550-0
[5] OPECST / Sénat, « ChatGPT, et après ? Bilan et perspectives de l’intelligence artificielle », 28 novembre 2024, https://www.senat.fr/rap/r24-170/r24-1705.html
[6] PMC, « Biased AI writing assistants shift users’ attitudes on societal issues », 2026, https://pmc.ncbi.nlm.nih.gov/articles/PMC12978215/
[7] Nature Human Behaviour, « On the conversational persuasiveness of GPT-4 », 2025, https://www.nature.com/articles/s41562-025-02194-6
[8] BVA Nudge Consulting by Ipsos, « Who we are », https://www.bvanudgeconsulting.com/who-we-are/
[9] Ipsos, « The Human Advantage Conference revient pour une troisième édition ! », 1er-2 octobre 2026, https://www.ipsos.com/fr-fr/human-advantage-conference-2026
[10] Ipsos, « Suivez et optimisez la visibilité de votre marque dans les réponses des IA génératives grâce à Ipsos Synthesio AI Visibility », 9 juillet 2026, https://www.ipsos.com/fr-fr/ipsos-synthesio-ai-visibility
[11] SafeGEO / University of Toronto et partenaires, « Understanding Generative Engine Optimization Risks in Recommendation Agents », 2026, https://github.com/QianfengWen/SafeGEO
[12] InCyber, « LLM, agents autonomes et identités non humaines : la nouvelle surface d’attaque de l’IA », 28 mai 2026, https://incyber.org/article/llm-agents-autonomes-et-identites-non-humaines-la-nouvelle-surface-dattaque-de-lia/
[13] Microsoft Security, « Manipulating AI memory for profit: The rise of AI Recommendation Poisoning », 10 février 2026, https://www.microsoft.com/en-us/security/blog/2026/02/10/ai-recommendation-poisoning/
[14] InCyber, « IA agentique : quelles menaces pour quelles parades ? », 2026, https://incyber.org/article/ia-agentique-menaces-pour-quelles-parades/
[15] Anthropic, « Detecting and countering misuse of AI: September 2026 », 10 septembre 2026, https://www.anthropic.com/threat-intelligence-report-september-2026
[16] Citizen Lab, « BlackCore’s Influence Operations for Hire », 17 septembre 2026, https://citizenlab.ca/research/blackcores-influence-operations-for-hire/
[17] InCyber, « Influence artificielle : comment les modèles génératifs transforment déjà les opérations informationnelles », 3 juillet 2026, https://incyber.org/article/influence-artificielle-comment-les-modeles-generatifs-transforment-deja-les-operations-informationnelles/
[18] Harvard Kennedy School Misinformation Review, « LLMs grooming or data voids? LLM-powered chatbot references to Kremlin disinformation reflect information gaps, not manipulation », 2025, https://misinforeview.hks.harvard.edu/article/llms-grooming-or-data-voids-llm-powered-chatbot-references-to-kremlin-disinformation-reflect-information-gaps-not-manipulation/
[19] U.S. Small Business Innovation Research (SBIR), « StoryForge — Award 218403 », 2025-2026, https://www.sbir.gov/awards/218403
[20] NATO Allied Command Transformation, « Innovation Challenge 2026-1: Agentic AI for Cognitive Warfare », mars 2026, https://www.act.nato.int/wp-content/uploads/2026/03/rfip026038.pdf
[21] U.S. Army, Military Intelligence Professional Bulletin, « Narrative Manipulation, Malinfluence Operations, and Cognitive Warfare Through Large Language Model Poisoning with Adversarial Noise », 2025, https://www.lineofdeparture.army.mil/Journals/Military-Intelligence/Military-Intelligence-Archive/2025-July-December/Narrative-Manipulation/
[22] InCyber, « Guerre cognitive et brutalisation de l’arène informationnelle », 17 août 2026, https://incyber.org/article/guerre-cognitive-et-brutalisation-de-larene-informationnelle/
[23] InCyber, « Guerre cognitive, cybersécurité et IA : le cerveau est devenu une infrastructure critique », 7 juillet 2026, https://incyber.org/article/guerre-cognitive-cybersecurite-et-ia-le-cerveau-est-devenu-une-infrastructure-critique/
The post <strong>Manipulation des LLM</strong> : comment l’IA devient une surface d’attaque cognitive appeared first on INCYBER NEWS.
-
Workday mise tout sur l’IA agentique avec Anthropic et renforce sa plateforme RH et finance avec l’acquisition de C1.ai
www.usine-digitale.frWorkday, qui revendique plus de 11 500 clients dans le monde dont 65% des entreprises du Fortune 500, a profité de son événement annuel pour afficher une ambition claire : faire de l’intelligence artificielle agentique le cœur de sa plateforme destinée aux fonctions RH, finance et IT.
-
Face à OpenAI et Anthropic, Google dégaine Gemini 4 Argon pour revenir dans la course
www.numerama.com
Google déploie dans le monde entier Gemini 4 Argon, son nouveau modèle d'IA haut de gamme, moins de deux semaines après l'avoir présenté le 30 septembre 2026.
-
Airbus fait voler son drone de combat Valkyrie en Europe, mais son « cerveau » souverain attendra avant d’embarquer
www.numerama.com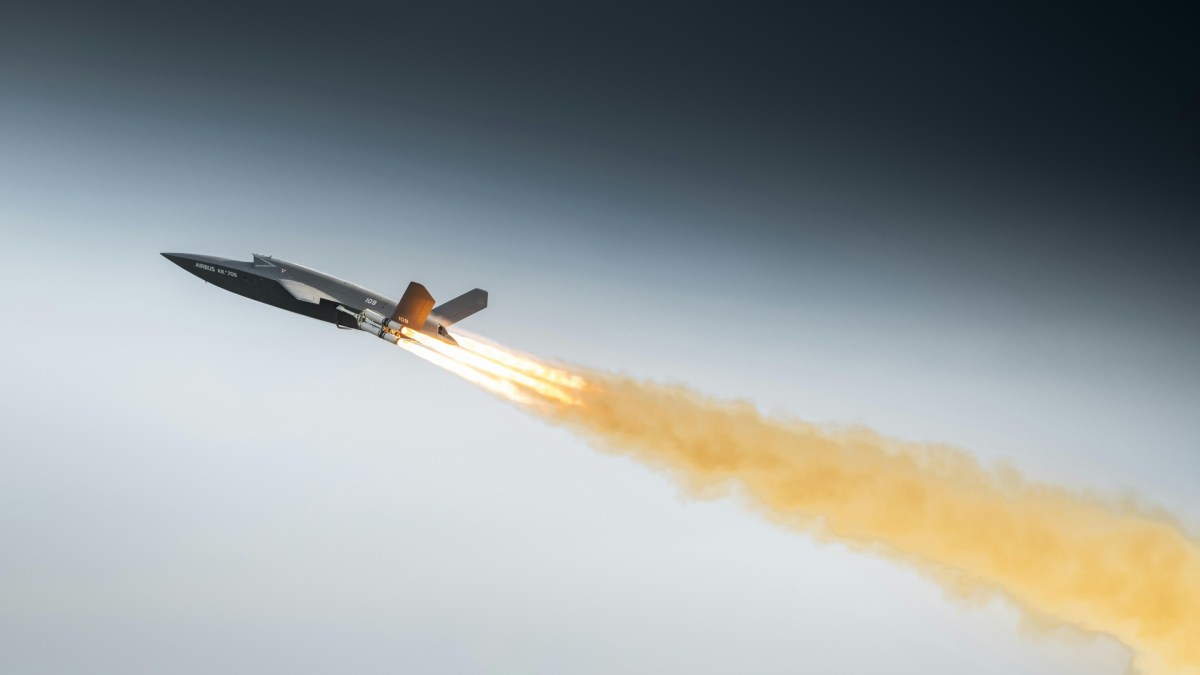
Airbus et l'Américain Kratos ont fait voler pour la première fois en Europe le U740 Valkyrie, un drone de combat que l'Allemagne pourrait utiliser dès 2029. Le système de mission européen censé le piloter n'était pas encore à bord.
-
Cyberattaque contre les frigos : la piste de l’obsolescence
incyber.orgDanfoss, le fabricant danois de systèmes de régulation frigorifique, a attribué, le 13 octobre 2026, à l’obsolescence logicielle la cyberattaque qui a touché ses installations dans des centaines de magasins de grande distribution en France. Le 12 octobre au matin, les équipes de ces magasins ont constaté des températures anormalement élevées dans les rayons réfrigérés et surgelés, dépassant parfois 50 °C. Les produits concernés ont dû être détruits.
L’attaque a notamment touché plus de 300 magasins Intermarché et Netto, ainsi qu’une centaine de magasins de la coopérative U. Les enseignes E.Leclerc, Carrefour et Monoprix sont également concernées. Les attaquants ont ciblé les systèmes frigorifiques équipés d’une version vulnérable du logiciel de régulation de Danfoss, antérieure à la version 4. Ils ont ainsi pu détourner la fonction de dégivrage pour provoquer une forte hausse de la température des équipements.
Danfoss a indiqué à l’AFP que « la majorité des unités touchées sont des produits anciens (…) qui ont atteint leur fin de vie et ne bénéficient plus de mises à jour logicielles ou de sécurité ». Le groupe danois rappelle qu’il recommande « depuis longtemps à ses clients de maintenir les systèmes pris en charge à jour et de migrer les systèmes hérités vers des solutions de génération actuelle ».
Or, Dominique Schelcher, PDG de la Coopérative U, a précisé sur BFM : « nos magasins ne sont pas clients de Danfoss : ils le sont de frigoristes qui nous mettent à disposition les solutions de Danfoss ». La responsabilité de ces frigoristes pourrait être examinée.
Dès qu’il a été informé de l’attaque, le Premier ministre Sébastien Lecornu a saisi l’Anssi et indiqué qu’il suivait le dossier « personnellement ». Le parquet de Paris a ouvert une enquête de sa propre initiative. Aucun groupe cybercriminel n’a revendiqué l’attaque, qui n’a pas été attribuée à ce stade.
The post Cyberattaque contre les frigos : la piste de l’obsolescence appeared first on INCYBER NEWS.
-
Apple lance une caméra, un thermostat et une serrure connectée
www.numerama.com
Pour accompagner comme il se doit le lancement de son HomeView, véritable centre de pilotage domotique, Apple s'associe à LG et Schneider pour proposer une palanquée de produits connectés pour la maison.
-
Conduite autonome : Valeo et le laboratoire KE:SAI veulent construire un système d’IA open source adaptable à plusieurs modèles de véhicules
www.usine-digitale.frL’Europe n’a pas dit son dernier mot dans la recherche en conduite autonome. L’équipementier tricolore Valeo et KE:SAI, laboratoire de recherche fondé par le français Kyutai et l’allemand Ellis Institute Tübingen, annoncent ce 13 octobre une initiative pour développer des systèmes de conduite autonome “généralistes”.
-
Frigos de supermarchés sabotés : des contrôleurs Danfoss obsolètes, des failles documentées et des responsabilités à éclaircir
www.usine-digitale.frDes rayons surgelés vides, des marchandises jetées et des installations frigorifiques à remettre en service. L’attaque informatique survenue dans la nuit du 11 au 12 octobre 2026 a frappé plusieurs réseaux de distribution alimentaire, dont Intermarché, Netto, Coopérative U, Carrefour, Monoprix et E.Leclerc. Les hackers ont perturbé le fonctionnement des équipements chargés de conserver les denrées, provoquant des ruptures de la chaîne du froid.
-
La pochette officielle Switch 2 des 40 ans de Zelda revient en précommande chez Cultura
www.numerama.com
[Précommande] La pochette de transport officielle de la Nintendo Switch 2 aux couleurs des 40 ans de The Legend of Zelda est de nouveau disponible en précommande chez Cultura. Elle est affichée à 39,99 € et sort le 29 octobre 2026.
-
[IA Insider] Meta veut transformer ses milliards de dollars d’investissement en agents IA (vraiment) autonomes
www.usine-digitale.frÀ la une
-
Muse Wonder : Meta acte son retour dans la course à l’IA avec des agents capables de travailler seuls
www.usine-digitale.frMeta n’a pas l’intention de laisser OpenAI et Anthropic occuper seuls le terrain des agents d’intelligence artificielle. La firme de Mark Zuckerberg a présenté ce 12 octobre Muse Wonder et Muse Wonder Full, deux modèles destinés à exécuter des tâches qui nécessitent davantage que de générer une réponse à une question. Comprendre un contrat de location, traiter un dossier d’assurance, élaborer un programme d’entraînement ou développer une application : Meta veut que ses modèles puissent mener un travail à son terme, y compris lorsqu’il implique plusieurs étapes, des outils externes et des corrections successives.
-
Apple lance de nouveaux Apple TV et HomePod mini : voici les nouveautés
www.numerama.com
Apple dévoile de nouvelles versions de ses deux produits les plus populaires pour la maison connectée : l'Apple TV et le HomePod mini. Au programme : des puces plus puissantes, mais pas de Siri AI en France.
-
Le nouveau jeu du créateur de Dragon Quest a été conçu avec l’IA en 30 minutes
www.numerama.com
Yuji Horii est l'un des co-créateurs de Dragon Quest, tout de même l'une des sagas de JRPG les plus importantes de l'histoire. Le 11 octobre, il a publié gratuitement un petit jeu d'enquête qu'il dit avoir créé en une trentaine de minutes avec Claude, l'IA générative d'Anthropic.
-
GEO : sur 148 marques, être connu des modèles ne prédit pas la citation, selon Pierre Sauvé
www.abondance.comCe qu'il faut retenir :
- Pierre Sauvé distingue la « présence » d'une marque dans les poids d'un modèle, mesurée par log-probabilités sur des modèles ouverts, de sa « citabilité », qui dépend de la recherche web effectuée au moment de répondre.
- Sur son panel, l'accord entre le classement des marques connues des modèles ouverts et celui des marques citées par ChatGPT et Gemini n'est que de 0,1, sur une échelle allant de 0 à 1.
- À notoriété web égale, avoir une page Wikipédia ou une forte présence sur Reddit ne produit pas d'avantage mesurable sur la présence : les paires comparées se répartissent quasiment à parts égales.
- Le consultant recommande des audits GEO avec passages répétés, appels dans l'interface plutôt que par l'API, socle daté et deux indicateurs distincts, présence et citation, plutôt qu'un score unique.
Trois passages dans ChatGPT donnent trois listes de marques différentes
L’étude est née d’une remarque d'un client. Pierre Sauvé raconte avoir travaillé pour une plateforme de sondage dont l’équipe, plutôt rigoureuse, constatait que les taux de visibilité IA variaient d’un outil à l’autre. Il a donc lancé trois fois la même requête dans ChatGPT (« quelle plateforme de sondage propose des quotas et redressement ? »), dans des conditions d’utilisation classiques, le même jour et à quelques heures d’intervalle. Résultat : trois listes différentes. Une seule marque, Symbial, apparaît dans deux réponses, et aucune n’apparaît dans les trois. Le consultant parle de « roulette russe ».
Il a ensuite sollicité Qwairy, outil de suivi de la visibilité dans les LLM, qui lui a fourni gracieusement des données sur un panel plus large. Les marques y sont détectées par leur nom mais aussi par leur domaine. Les résultats confirment l’instabilité :
- Sur ChatGPT : 42 % des marques ne sont vues qu’une seule fois sur trois passages, et seulement 37 % apparaissent aux trois.
- Sur Gemini : 55 % des marques ne sont vues qu’une seule fois sur trois passages.
Pour Pierre Sauvé, un audit GEO fondé sur un passage unique contient donc une part d’aléa importante. Il précise que ces passages ont été réalisés sur une période courte et qu’il prévoit de les renouveler dans un mois ou deux.
Présence et citabilité relèvent de deux couches distinctes
Le consultant distingue deux raisons pour lesquelles un LLM cite une marque :
- La présence : ce que le modèle a en mémoire, ancré dans ses données d’entraînement. Elle est apprise à un instant donné, bouge lentement et se mesure de façon reproductible.
- La citabilité : ce que l’étape de recherche (le live retrieval) place sous les yeux du modèle au moment de répondre. Elle est volatile et actionnable à court terme.
Il illustre la différence par deux cas extrêmes. Pour savoir qui présidait la France en 2003, ChatGPT n’a pas besoin de chercher sur le web : l’information est solidement ancrée dans ses données d’entraînement. Pour connaître le résultat du dernier match de l’OM, il doit effectuer une recherche. La plupart des prompts, notamment en e-commerce, se situent entre les deux : le moteur puise une partie de l’information dans sa mémoire, puis la recherche la complète, la valide ou parfois la contredit.
Ces deux axes forment une matrice à quatre cases : présente et citée (position idéale), présente mais jamais citée (problème de récupération), absente mais citée (position portée par la recherche, donc fragile), absente et silencieuse (tout est à faire). Pierre Sauvé présente cette grille comme une proposition de complément méthodologique, et non comme une vérité établie.
 Illustration de la matrice d'analyse - Source : Slides de la conférence de Pierre Sauvé
Le robots.txt recoupe en partie cette distinction. Chez OpenAI, GPTBot collecte pour l’entraînement (la présence), tandis qu’OAI-SearchBot alimente l’index de recherche (la citabilité). Le consultant cite plusieurs cas observés en septembre 2026, avec des taux de citation calculés sur le jeu de prompts de chaque secteur :
- Moosend : GPTBot et ChatGPT-User bloqués, OAI-SearchBot autorisé. Marque citée par ChatGPT dans moins de 3 % des réponses.
- Dealabs : tous les robots bloqués par défaut, sauf sur le répertoire des codes promos. Marque citée par ChatGPT dans 36 % des réponses.
- Ouest-France : stratégie sélective selon les rubriques.
Pour Pierre, bloquer GPTBot n’empêche pas une marque d’apparaître dans les données d’entraînement, puisque d’autres sites parlent d’elle. Ce choix revient surtout à laisser à des tiers la manière dont la marque y est décrite, et à dépendre de la recherche pour corriger ou valider ces informations. Dealabs illustre l’inverse : selon lui, son ancrage est si fort que le blocage ne l’empêche pas d’être bien présente et bien citée. De la même façon, les LLM connaissent Ouest-France ou Le Figaro malgré la posture restrictive des médias.
La log-probabilité sert d’instrument pour mesurer la présence
Pierre Sauvé limite volontairement son étude à la présence, qu’il juge la plus mal connue et la moins vérifiée dans les audits. Il laisse la citabilité (balisage, format des réponses, fraîcheur) aux outils SaaS spécialisés, et estime que sa conférence ne couvre qu’environ la moitié du sujet. Il précise aussi qu’il mesure si le modèle connaît une marque, pas ce qu’il en pense, un second volet étant annoncé pour une « V2 ».
Son instrument est la log-probabilité (logprob). Pour rappel, un modèle de langage attribue une probabilité à chaque mot susceptible d’en suivre un autre. Dans la phrase « Paris est la capitale de la… », « France » obtient environ 90 % et « soupe » environ 0,01 %. Le consultant exprime ces valeurs en nats, une unité logarithmique : 0 nat correspond à une probabilité de 100 %, et chaque nat en moins divise la probabilité par 2,7 environ. Une marge de +0,78 nat signifie ainsi que la bonne réponse est 2,2 fois plus probable que la meilleure des mauvaises.
Le protocole repose sur quatre briques :
- Le panel : 148 marques réparties sur 11 secteurs, avec une majorité de marques anglophones, un sous-groupe français et 38 marques inventées servant de témoins. Le consultant dit avoir mélangé des secteurs très présents sur le web (CRM, plugins SEO pour WordPress) et d’autres qui communiquent moins.
- La notoriété : le nombre de mentions par milliard de mots dans cinq corpus ouverts de pré-entraînement (C4, DCLM-baseline, Dolma v1.7, RedPajama et The Pile), compté via l’API infini-gram de l’Allen Institute for AI.
- La présence : dix modèles ouverts issus de trois familles (Qwen, Llama, Gemma), en deux tailles de 1 à 9 milliards de paramètres, complétés par des tests sur des modèles de 70 milliards.
- L’appariement : plutôt que de comparer Nike à un petit fabricant local, le consultant compare des marques de notoriété équivalente.
Les vrais corpus de Qwen, Llama, Gemma et des modèles fermés ne sont pas publiés. Pierre Sauvé s’appuie sur le fait que Common Crawl est au cœur de l’entraînement de tous ces modèles, en rappelant que la seule composition publiée par OpenAI date de GPT-3 (60 % des tokens). Il raisonne aussi par différence entre corpus de composition connue, Dolma contenant Reddit et RedPajama non. Le tout a été réalisé avec des GPU loués, pour un coût global d’environ 50 dollars.
La mesure centrale est la « marge de catégorie ». Le modèle évalue la phrase associant la marque à sa vraie catégorie, puis la compare à quatre fausses catégories (café italien, poisson, village du sud, danse folklorique). La marge est l’écart, en nats, entre la bonne catégorie et la meilleure des fausses. Elle est ensuite comparée à un « plancher » : la marge obtenue par des noms inventés, générés puis vérifiés un par un sur Google pour s’assurer qu’ils n’existaient pas. Selon le consultant, une log-probabilité brute mesure la plausibilité d’une chaîne de caractères, pas la connaissance : en démonstration, la marque inventée « Mailzephor » passait devant une vraie marque avant cette correction.
Le premier enseignement concerne le nom lui-même. Un nom inventé mais « parlant », qui contient par exemple « mail » pour l’emailing, obtient une marge positive sans aucune connaissance derrière. Selon les modèles, ce bonus atteint +0,75 à +1,05 nat sur les petits modèles et +0,99 à +1,23 nat sur ceux de 7 à 9 milliards de paramètres. La part de marques réelles qui dépassent la meilleure marque inventée varie de 30 % (Qwen, petite taille) à 71 % (Gemma, grande taille). Sur les petits modèles, sept marques sur dix ne battent donc pas un nom qui n’existe pas. Les gros modèles connaissent davantage de marques, mais accordent aussi un bonus plus élevé aux noms parlants.
Mentions, Reddit, Wikipédia : trois croyances passées au crible
« Spammons de mentions, tant pis pour les liens »
Pierre Sauvé rappelle d’abord que le balisage HTML est supprimé lors de l’extraction du texte d’entraînement. Dans les corpus, « https:// » apparaît 525,7 fois par million, « href= » 16,6 fois et « rel="nofollow" » 3,7 fois. D’un lien, il ne reste que l’ancre, c’est-à-dire une mention. Le lien garde pourtant un rôle à deux niveaux. En amont, Common Crawl découvre et revisite les pages en suivant les liens, et les filtres qualité favorisent les pages connectées. En aval, ChatGPT et Gemini s’appuient sur des index où le graphe de liens sélectionne les pages proposées au modèle.
Il vise ici les plateformes qui vendent des mentions pour le GEO. Selon lui, aucune n’a démontré d’effet sur les données d’entraînement : elles partent du principe que leurs contenus seront à la fois récupérés par la recherche et intégrés aux corpus.
Ses mesures montrent un rendement décroissant. En classant les 148 marques en quatre groupes de taille égale, la part de marques réellement reconnues passe de 11 % (Botify, Oncrawl, Bricorama…) à 30 % avec six fois plus de mentions, puis à 46 % avec 33 fois plus. Elle redescend à 35 % pour les marques omniprésentes (HubSpot, IKEA, Sephora), avec 110 fois plus de mentions.
Sur Qwen 1,5B, la marge moyenne passe de +0,28 à +0,97 nat entre le premier et le deuxième quartile de mentions, puis ne gagne que +0,24 nat jusqu’au quatrième, malgré dix-neuf fois plus de mentions. Sur Qwen 7B et Llama 8B, le deuxième quartile dépasse même les suivants. Le consultant en conclut que sortir de l’invisibilité vaut l’effort, mais que saturer une marque déjà présente rapporte beaucoup moins. Pour une marque jeune ou très peu présente, il recommande au contraire de « taper un peu fort », puisqu’elle part de zéro.
« La présence Reddit pèse lourd »
Les corpus n’indiquent pas d’où vient une occurrence. Pierre Sauvé compare donc Dolma (avec Reddit) et RedPajama (sans Reddit), construits selon la même méthode. Rank Math y est 9,1 fois plus mentionné dans Dolma, Semrush 4,9 fois, Bioderma 3,3 fois, Oncrawl seulement 1,3 fois. Au-delà d’un rapport de 3,3, il considère qu’une marque doit notablement sa présence à Reddit.
Une lecture naïve semble confirmer la croyance : les 16 marques « Reddit-friendly » affichent une marge médiane de +1,39 nat contre +1,06 pour les 132 autres, avec cinq fois moins de présence web. Mais à notoriété web égale, sur 16 paires, le résultat tombe à 8 contre 8, pour un écart médian de −0,05 nat. Deux exemples l’illustrent :
- AccuRanker contre Sistrix : à notoriété comparable (16 et 18 mentions par milliard), l’outil plus présent sur Reddit l’emporte de 1,67 nat.
- Bioderma contre Fenty Beauty : à 351 et 344 mentions par milliard, c’est la marque peu visible sur Reddit qui l’emporte, avec 1,12 nat d’écart.
Pierre Sauvé en conclut que Reddit signale une présence sans en déterminer la valeur. Il rapporte le cas d’un client accompagné par une agence spécialisée dans Reddit : aucune différence observée, un compte signalé par la plateforme, et des critiques formulées uniquement sur Reddit qui sont ensuite remontées dans les réponses des IA. Il ajoute que les LLM cherchent souvent à présenter les points positifs et négatifs d’une marque. Interrogé sur la rentabilité de Reddit, il répond qu’elle n’est pas supérieure à celle d’un média quelconque, et conseille plutôt de travailler sur des espaces où la marque maîtrise son discours.
« Être sur Wikipédia change tout »
Même démarche pour Wikipédia, dont le statut a été vérifié via l’API de l’encyclopédie. Les 75 marques avec une page devancent les 73 autres de 0,42 nat. Elles sont aussi 11,9 fois plus mentionnées. Pour le consultant, avoir une page Wikipédia est d’abord un symptôme de notoriété.
À notoriété égale, sur 36 paires, 17 vont dans le sens de la croyance et 19 dans le sens inverse, avec un écart médian de −0,29 nat. SendGrid (avec page) devance AWeber (sans page) de 1,79 nat à notoriété quasi identique. À l’inverse, Rank Math (sans page) devance Yoast (avec page) de 1,27 nat. Pierre Sauvé avance deux explications possibles : un nom qui contient « Rank » est plus facilement associé au SEO, et Rank Math, arrivé plus tard, a suscité de nombreux contenus comparatifs.
Il reconnaît à Wikipédia un contexte encyclopédique plus informatif et plus neutre que Reddit, sans y voir pour autant de levier décisif. Il rappelle aussi qu’une page créée par un prestataire rémunéré est souvent signalée par un bandeau ou une mention de contribution rémunérée, ce qui ne sert pas l’image de la marque. Interrogé sur Wikidata, il précise ne pas l’avoir mesuré. Son hypothèse : il s’agit d’une base de données qui fournit des relations entre entités plutôt que du texte d’entraînement.
Être connu du modèle ne prédit pas la citation
Pierre Sauvé a ensuite croisé ses mesures de présence avec les données de citation fournies par Qwairy, relevées dans l’interface et non par l’API. Environ 20 prompts génériques par secteur, en français et sans nom de marque, ont été soumis trois fois à ChatGPT et Gemini, soit 1 100 réponses selon les slides. Une marque est considérée comme « citée » si elle apparaît dans au moins 5 % des réponses de son secteur, et « présente » si sa marge dépasse le plancher des noms inventés.
Les accords entre classements (de 0 pour aucun rapport à 1 pour un ordre identique) sont parlants :
- ChatGPT et Gemini, sur les marques qu’ils citent : 0,89.
- Les modèles ouverts, sur les marques qu’ils connaissent : 0,85.
- Présence et citation entre elles : 0,1.
Chaque couche est cohérente avec elle-même, mais les deux ne se recouvrent pas, sauf pour les marques les mieux placées, comme IKEA ou HubSpot. Trois cas l’illustrent :
- Adobe Marketo : marge de +1,37 nat et 2 131 occurrences par milliard de mots, mais une seule réponse ChatGPT sur 60 dans le secteur de l’emailing. Le consultant rappelle que la marque réalisait 400 millions de dollars de chiffre d’affaires en 2021.
- Brevo : marge de −0,15 nat, inférieure à celle d’une marque inventée, mais citée dans 83 % des réponses ChatGPT du secteur.
- Google Optimize : service arrêté en 2023, marge de +2,1 nat, 0 % de citation, comme Universal Analytics ou Klout. Selon Pierre Sauvé, les mises à jour des données d’entraînement ne font pas baisser ses occurrences, car les modèles continuent d’absorber des articles anciens. Sa formule : « Les données d’entraînement n’oublient pas, mais la recherche, oui. »
Le cas Brevo s’explique par le rebranding de Sendinblue en mai 2023. Sur les trois petits modèles, Sendinblue obtient entre +1,56 et +1,73 nat mais n’est jamais cité, tandis que Brevo oscille entre −0,44 et +1,07 nat. La mémoire retient l’ancien nom, la recherche cite le nouveau. Pour le consultant, c’est la recherche web qui corrige le tir : elle signale au modèle que Sendinblue est devenu Brevo. Il note aussi que le changement n’a pas aidé la marque côté présence, « Send » étant plus proche de l’emailing qu’un nom neutre comme Brevo. Même schéma pour Piwik devenu Matomo, cité dans 65 % des réponses alors que Piwik domine les données d’entraînement.
Sur la matrice finale, Pierre Sauvé classe 61 marques présentes et citées (HubSpot, Ahrefs, Semrush), 65 présentes mais jamais citées (Marketo, Hiscox, FullStory), 13 absentes mais citées (Brevo, MAIF, Weldom) et 17 absentes et silencieuses (Sistrix, Matmut).
Le consultant indique avoir tenté de contredire ce résultat, secteur par secteur, puis sur les articles de type « meilleurs outils de », sans changer la conclusion. Sur Llama 3.1 70B, cinquante fois plus gros, l’accord reste nul. La langue joue en partie : sur des modèles mieux entraînés en français et interrogés en français, l’ordre change. En anglais, tous les modèles placent Home Depot devant Leroy Merlin, alors qu’une sonde française sur un modèle français rétablit l’ordre. Il dit n’avoir trouvé aucun modèle majoritairement entraîné en français : Mistral, qu’il pensait plus francophone, présentait davantage de marqueurs anglais que les modèles américains.
Il insiste enfin sur un point : la présence n’est pas inutile. Elle explique environ 10 % du classement, et les marques les plus citées figurent parmi celles qui se détachent sur la présence. Selon lui, être dans les données d’entraînement permet aussi de rattacher la marque à son contexte : si le modèle ne sait pas que Brevo fait de l’emailing, le lien doit être reconstruit à chaque recherche. Pour une petite marque, il recommande d’acquérir des mentions et de s’insérer dans des comparatifs, même si le gain reste modeste.
Un standard d’audit, un kit et une méthode discutée
Ce que Pierre Sauvé demande à un audit GEO
À sa connaissance, aucun outil commercialisé ne mesure la présence dans les données d’entraînement. Il en fait la première exigence d’un audit, avant de détailler celles qui portent sur la citation :
- Des passages répétés, avec une variance visible. Un passage unique relève du bruit : un client qui teste lui-même ses prompts favoris obtiendra un résultat différent.
- Des appels dans le produit plutôt que par l’API, dont la couche de recherche diffère et dont les réponses sont, selon lui, moins riches.
- Un socle stable (modèle, date, prompts), en ne changeant de modèle que lorsque le modèle par défaut du grand public change.
- Deux indicateurs distincts, présence et citation, parce qu’ils ne bougent pas ensemble.
Il met aussi en garde contre l’usage des log-probabilités exposées par l’API d’OpenAI. On n’y choisit pas la phrase évaluée, il n’y a ni corpus ni appariement, et le modèle comme la recherche évoluent sans cesse. Selon lui, on y mesure une conversation, pas une mémoire.
Ses recommandations suivent la matrice. Pour les marques présentes mais jamais citées : « Arrêtez de payer pour entrer dans les LLM », puisque le blocage se situe dans la récupération. Pour les marques présentes et citées, il conseille d’exiger la variance des prompts et de reprendre la main sur le discours de marque. Pour les marques absentes mais citées, comme Brevo, il recommande de ne rien relâcher et de s’imposer aussi dans les données d’entraînement. Pour les marques absentes et silencieuses, il prévient que le chantier sera long et qu’il faut annoncer délai et budget dès le départ.
Un kit pour tester sa propre marque
Le 2 octobre 2026, Pierre Sauvé a publié sur GitHub un kit sous licence MIT, baptisé brand_probe, qui applique la méthode à une marque à la fois. Il fonctionne en ligne de commande, dans un notebook Colab ou via une petite interface. Le modèle par défaut, Qwen 2.5 1.5B, se télécharge (3 Go) sans compte. Llama et Gemma nécessitent un compte Hugging Face et l’acceptation de leur licence. À l’oral, le consultant a mis en garde contre une possible hausse des coûts de Hugging Face, qu’il présentait comme récemment racheté par NVIDIA.
Le kit fournit :
- La présence dans chaque modèle : marge de catégorie, plancher des noms inventés et verdict (présente si la marge dépasse le plancher de plus de 0,10 nat).
- Le nom parlant : la marge d’un nom inventé qui annonce la catégorie (« Rankzuri » pour le SEO, « Assurvex » pour l’assurance). Sur Qwen 1.5B en français, Assurvex obtient +0,62 nat contre +0,42 pour Groupama.
- Les termes associés : les mots que le modèle rattache à la marque, corrigés de ce qu’il dirait d’un nom inventé.
- La fréquence dans les corpus C4, DCLM et Dolma, et les mots qui accompagnent la marque.
Le README avertit que le kit ne mesure pas la citation. Il résume la position de l’auteur : être dans les poids est une condition d’entrée, pas une cause de citation. Une marque absente des poids n’est jamais citée sans recherche web, mais une marque présente ne l’est pas pour autant. Le document détaille aussi plusieurs pièges :
- Le collage de tokens : infini-gram apparie des séquences de tokens. « Brevo » compte 3 421 occurrences dans C4, dont 98 % correspondent à « Brevoort » (un éditeur de Marvel) ou « Brevoortia » (un poisson). En mot entier, Brevo n’en compte que 53.
- Les homonymes : dans les corpus anglophones, « MAIF » désigne surtout le Maryland Automobile Insurance Fund. Une requête combinée (par exemple « Orange » avec « téléphonie », cité en démonstration) déplace l’équilibre sans tout corriger.
- Les corpus datés : C4 date d’avril 2019, DCLM de 2023 et Dolma de début 2024.
- La taille des modèles : une marque absente à 1,5 milliard de paramètres peut être présente à 9 milliards.
Le script fixe la révision exacte de chaque modèle et refuse la quantification, qui modifierait les log-probabilités. Deux personnes doivent ainsi obtenir la même marge à la décimale près.
Une méthode discutée sur LinkedIn
Notons qu'après la publication de Pierre Sauvé sur LinkedIn, Antony Luvera, CTO chez Maples Labs a contesté le passage entre ce qui est mesuré et ce qui est conclu. Selon lui, comparer des corpus et apparier des volumes de mentions n’isole pas explicitement l’effet de Reddit ou de Wikipédia. Une association marque-catégorie n’explique pas une recommandation. Et une marque connue mais non citée a pu être trouvée, comparée puis écartée, sans qu’il s’agisse d’un problème de récupération. Il estime que la méthode ignore les sources réellement présentes dans la fenêtre de contexte, les informations reprises dans le raisonnement du modèle et les critères de comparaison activés.
Pierre Sauvé reconnaît la justesse du troisième point : sa méthode regroupe les marques « jamais récupérées » et « récupérées puis écartées ». Il précise établir seulement que le blocage ne vient pas de la présence dans les données d’entraînement. Sur Wikipédia et Reddit, il dit conclure à une absence d’effet mesurable à notoriété égale, et non à une absence totale d’effet. Il ajoute qu’observer Reddit dans la fenêtre d’une réponse citant une marque ne prouve pas que Reddit a causé la citation : pour mesurer une contribution, il faudrait retirer la source et rejouer la requête, ce qui est impossible.
Précisons que durant sa présentation au TEKnSEO, Pierre Sauvé avait présenté sa matrice comme une proposition et reconnu à plusieurs reprises les limites de ses mesures statistiques. Antony Luvera soutient par ailleurs que l’analyse fine peut être instrumentée : les modèles exposent le contenu des sources qui entrent dans la fenêtre de contexte, ce qui permet selon lui de relier les données reprises aux choix observés, une fois pondérés par les récurrences entre conversations. Il renvoie vers le livre blanc méthodologique de Maple Labs (maplelabs.fr/technologie). La question de savoir si l’on peut attribuer une citation à une source précise reste donc ouverte entre les deux approches.
L’article "GEO : sur 148 marques, être connu des modèles ne prédit pas la citation, selon Pierre Sauvé" a été publié sur le site Abondance.
-
Apple dévoile le HomeView et nous donne vraiment envie… mais ne le sort pas en France et en Europe
www.numerama.com
Après des années de rumeurs et de reports, Apple dévoile enfin son premier écran pour la maison : le HomeView. Apple le présente comme le centre de pilotage ultime pour la maison connectée, avec Siri AI aux manettes. Il sortira le 13 novembre aux États-Unis pour 299 dollars… mais pas en Europe, où Apple refuse de le vendre tant que Siri AI y est bloqué.
-
Retrouvez L’Usine Digitale aux Assises de la confiance numérique à Paris le 17 novembre 2026
www.usine-digitale.frL’Usine Digitale aura le plaisir de vous retrouver le 17 novembre 2026 au Studio Gabriel, à Paris, à l’occasion des Assises de la confiance numérique. Celles-ci réunissent chaque année les décideurs, experts et praticiens qui font avancer la confiance dans le numérique.
-
Sony lance une PS5 noire deux fois moins chère pour GTA 6 (mais pas en France)
www.numerama.com
La branche japonaise de PlayStation lance un nouveau modèle de PS5. Pour 55 000 yens, soit environ 310 €, les joueurs japonais pourront s'offrir cette PS5 le 19 novembre, le jour de la sortie de GTA 6.
-
Surprise : No Man’s Sky débarque sur iPhone et iPad
www.numerama.com
Dix ans après une sortie pour le moins chaotique, No Man’s Sky s’apprête à débarquer sur iPhone et iPad. Un bel arc de rédemption pour un jeu que beaucoup pensaient condamné dès son lancement, avant que Hello Games ne le transforme, mise à jour après mise à jour, en une aventure bien plus ambitieuse.
-
Test FR-Alert ce mardi : si votre téléphone a sonné sans crier gare, voilà pourquoi
www.numerama.com
Ce mardi 13 octobre 2026, la préfecture de Seine-et-Marne teste FR-Alert dans 56 communes entre 9 heures et 10 heures. Celle du Lot le fait entre 9 heures et midi, et son message peut aussi arriver sur des téléphones en Corrèze.
-
GitLab - Encore une faille CVSS 10 #FautPatcher
korben.infoHier, GitLab a publié en urgence les versions 19.4.2, 19.3.5 et 19.2.8 pour corriger une faille un peu chaude avec un score CVSS de 10 sur 10 . Référencée sous le code CVE-2026-97229, elle permet à quelqu'un sans compte user d'exécuter du code sur le serveur en glissant tout simplement une expression régulière piégée dans une configuration CI/CD.
GitLab précise que cela ne peut se faire que "sous certaines conditions" sans préciser lesquelles, et il ne dit pas non plus comment un inconnu pourrait faire lire sa config CI forgée par une instance. Gitlab mentionne une histoire de dépassement d'entier dans le compilateur de regex du CI/CD et d'une validation insuffisante des expressions mais on n'a pas les détails techniques qui sortiront dans environ 90 jours. C'est habituel pour laisser le temps à tout le monde de patcher.
Ces dernières semaines, ça enchaine fort ( un peu comme Citrix ) avec fin septembre, la 19.4.1 qui corrigeait déjà deux autres faille sur le même terrain : CVE-2026-93577, pour un dépassement d'entier dans le compilateur, et CVE-2026-89078, pour un double free dans l'analyseur de regex. Notées 9,9 toutes les deux et signalées par le même chercheur (joaxcar), mais celles-là exigeaient au moins un compte. Et la troisième faille (la CVE-2026-85706) découverte aussi courant septembre, était quand a elle aussi notée 10 sur 10 et permettait de lire les fichiers présents sur le serveur sans avoir de compte.
Alors qui est concerné ?
Hé bien toutes les instances auto-hébergées en 19.2 avant la 19.2.8, en 19.3 avant la 19.3.5 et en 19.4 avant la 19.4.2. Une 19.4.1 installée fin septembre n'est donc pas à l'abri. Le service GitLab.com en lui-même est déjà à jour et les clients serveur dédié n'ont rien à faire. Mais pour les autres, l'alerte de sécurité ne mentionne aucun contournement / fix. Faut juste mettre à jour et basta.
Sur une instance mono-nœud, prévoyez donc une coupure, parce que ce correctif embarque des migrations de base qui exigeront un reboot.
Voilà, maintenant que vous êtes au jus, c'est le moment de patcher !!
Source : BleepingComputer .
-
Un data center équipé par AMD en Finlande, plus de modèles et des services IA ajoutés à son catalogue... Scaleway se rêve en alternative européenne face aux géants américains
www.usine-digitale.frScaleway entend profiter de la course à l’intelligence artificielle pour changer de dimension. À l’occasion de sa conférence ai-PULSE, organisée le 13 octobre 2026 à Paris, le fournisseur français de cloud annonce le déploiement en Suède d’un supercalculateur équipé de processeurs graphiques AMD Instinct MI355X. Il revendique « une première européenne », selon les mots de son patron, Damien Lucas, pour un supercalculateur AMD dédié à l’intelligence artificielle et destiné à un usage commercial. Surtout, ce projet constitue le premier déploiement d’un supercalculateur de Scaleway hors de France.
-
Filmer la police, puis flouter les visages avant de publier
korben.infoEn France, même si ça les défrise, un policier ou un gendarme en service ne peut pas s'opposer à ce qu'on l'enregistre (vidéo, photo et son), tant qu'on n'est pas dans un lieu privé. C'est la Défenseure des droits qui l'a rappelé dans un avis de 2020, en s'appuyant sur une circulaire de 2008 du ministère de l'Intérieur, excluant aussi qu'on vous interpelle ou qu'on vous retire votre matériel pour ça .
J'irais même plus loin en disant que filmer est même un devoir, tant ça peut vite déraper d'un côté comme de l'autre...
Bref, filmer est donc un droit acquis, mais publier l'enregistrement c'est autre chose... Le Conseil constitutionnel ayant censuré en 2021 le délit de provocation à l'identification des policiers prévu par la loi Sécurité globale, parce que le texte était trop imprécis, il ne nous reste que l' article 223-1-1 du Code pénal , qui punit de 3 ans de prison et 45 000 euros d'amende le fait de diffuser des informations permettant d'identifier quelqu'un dans le but de l'exposer à un risque direct d'atteinte. Et ça monte à 5 ans et 75 000 euros si la personne est dépositaire de l'autorité publique.
En langage clair et en théorie, cela veut dire que publier le visage d'un policier ne suffit pas à faire un délit... C'est l'intention d'exposer qui doit être prise en compte, et la LDH le rappelle, il n'y a aucune obligation légale qui impose de flouter les agents.
Reste que flouter est LE choix de la prudence, parce qu'une vidéo est là pour documenter des faits et pas pour afficher des personnes. Et surtout ça vous évite tout procès d'intention. La Défenseure des droits juge d'ailleurs que publier des images d'interventions de police est légitime et nécessaire dans une société démocratique, donc même s'il y floutage de visage, ça ne retire rien au document : les gestes, les mots et le contexte restent à l'image.
Mais attention, le floutage ne vous protège pas non plus de tout puisque si vous n'êtes ni journaliste ni en train de constituer une preuve en justice, diffuser des images de violences peut vous exposer à 5 ans de prison, au titre de l'article 222-33-3, d'après ce qu'explique la LDH.

Après, en ce qui concerne le visage des manifestants, c'est également très bien de les flouter puisque le fichier TAJ des antécédents judiciaires peut être interrogé par reconnaissance faciale, et le Sénat a dénombré 498 871 consultations de ce type en 2021 rien pour la seule police nationale. Donc j'imagine pas en 2026...
Reste le côté "pratique" de la chose, parce que flouter une vidéo à la main, image par image, c'est pas si simple quand on ne maitrise pas les outils de montage vidéo. Mais il y a une application web libre nommée Masque du collectif onestla.tech qui vous permet d'uploader des photos, en lot (avec ZIP à la sortie), ou une vidéo, et celui-ci masquera tous les visages. Tout se passe uniquement dans votre navigateur (rien n'est envoyé sur des serveurs tiers) et une fois chargée l'appli peut même fonctionner offline sur votre téléphone par exemple.
Chaque masque peut ainsi être revu avant l'export, et pour un visage raté, il suffit de glisser le doigt ou la souris dessus pour l'ajouter. Le fichier qui sort ensuite a été totalement nettoyé de ses métadonnées (ni EXIF, ni GPS, ni date de création) et porte un nom aléatoire. Comparé au floutage ou à la mosaïque, notez que le style "Solid" qui met un calque noir ou Emoji sur les visages sont les plus safe pour protéger l'anonymat des personnes.

Après, oui, la détection automatique peut manquer des visages, et les vêtements, les tatouages, les banderoles ou encore les lieux permettent évidemment d'identifier encore des gens donc là faudra se relever un peu plus les manches pour sécuriser à fond la vidéo Et pour le son, si vous en avez besoin, Masque propose une option "Supprimer le son" en précisant que les voix peuvent également permettre d'identifier des personnes, donc pensez-y avant de publier si le son n'a pas d'utilité. Sinon, trouvez un outil pour modifier les voix afin qu'on puisse quand même savoir ce qui est dit mais sans reconnaitre la voix des personnes.
Voilà, ce projet est tout jeune mais je l'ai trouvé bien utile. Et si vous filmez pour documenter, gardez bien évidemment l'original dans un endroit safe que vous maîtrisez, sachant que votre téléphone l'a peut-être déjà envoyé dans un cloud.
Ah et si Masque ne vous convient pas, il y a aussi deface , que j'avais déjà présenté et dont Masque reprend le modèle de détection.
C'est un outil en ligne de commande qui tourne sous Linux, Windows et macOS,
python3 -m pip install defacepuisdeface video.mp4, qui détecte les visages image par image et les floute ou les cache sous des boîtes noires. Pas d'interface graphique prévue cependant et l'audio est viré par défaut.Et pour les photos uniquement, tout le monde l'ignore mais Signal a un outil de floutage dans son éditeur d'images depuis 2020, sur Android et iOS, avec un traitement à 100% local. Sa détection, elle non plus, ne trouve pas tous les visages à coup sûr, d'où le pinceau pour flouter à la main ce qu'elle a raté mais c'est aussi très pratique. Ah et j'avais aussi parlé de cet outil gratuit pour anonymiser les photos de manifs si vous voulez en essayer encore un autre.
Bref, filmez partout et tout le temps mais pensez bien à flouter avant de publier quoi que ce soit et surtout à garder l'original au chaud pour aider les victimes plus tard.
Source : le dépôt de Masque
-
Deezer prépare un bouton pour faire disparaître la musique générée par IA de vos recherches
www.numerama.com
Deezer ajoutera d'ici la fin de l'année 2026 un bouton pour faire disparaître de la recherche les morceaux entièrement générés par IA. La plateforme dit recevoir près de 90 000 titres de ce type chaque jour.
-
Le drone de combat d’Airbus a volé en Europe, mais son « cerveau » souverain manquait à l’appel
www.numerama.comAirbus et l'Américain Kratos ont fait voler pour la première fois en Europe le U740 Valkyrie, un drone de combat que l'Allemagne pourrait utiliser dès 2029. Le système de mission européen censé le piloter n'était pas encore à bord.
-
Implants espions dans des Ledger : les détenteurs de cryptomonnaies doutent désormais de toute la chaîne de distribution
www.numerama.com
Après la découverte d’implants espions dans des portefeuilles Ledger vendus par le revendeur CryptoBilis, les rumeurs se multiplient sur les réseaux sociaux. Ledger appelle à la prudence, mais peine à rassurer des clients qui démontent désormais leurs appareils.