Timeline
Every post and feed across this instance
-
Kimberly Guilfoyle ousted as US ambassador to Greece after alleged misconduct
White House told Guilfoyle, who is alleged to have sought a bill payment from a Trump donor, to resign from post
Kimberly Guilfoyle is stepping down as US ambassador to Greece after weeks of reports that she sought payment from a Trump donor in exchange for access to administration officials.
The decision, announced by the White House on Tuesday morning, ends the diplomatic career of one of Donald Trump’s longest-standing political allies. It came after the US president and Marco Rubio, the secretary of state, were reported to have grown furious over the allegations.
Continue reading... -
Le Conseil supérieur de la magistrature rend un avis «défavorable» sur la nomination de Rachida Dati
L’ex-ministre de la justice souhaitait pouvoir reprendre un poste dans la magistrature. Pour l’institution, la procédure pénale qui la vise constitue un obstacle à cette réintégration. -
Fusillade dans un collège: «Si ce jeune avait été détecté par un psychologue, on aurait pu éviter ce drame»
Pour la première fois en France, un collégien a ouvert le feu dans son établissement, à Aubagne, blessant deux membres du personnel. Alors que les parents, les élèves et les enseignants sont encore sidérés, élus et ministres accumulent les raccourcis politiques. Le Parquet national antiterroriste s’est saisi de l’affaire. -
Entre Thonon-les-Bains et Machilly (74): situation à la Chab’ZAD, mi-octobre 2026
– Les keufs dans la ZAD (6 oct. 2026)
Ce lundi 5 octobre, les keufs sont
rentré.es dans la ZAD. Une de nos habitations a été détruite à coups de pelleteuse. Plus d’infos sur chabzad.espivblogs.net et @chab_zadLes keufs ont expulsé une première partie de la ZAD le matin et détruit la maison qui était là.
Le soir iels sont revenu.es à la charge dans l’autre partie de la zone pour venir choper des copaines. Pointant leurs LBD sur des personnes à 7m de hauteur sur une tour, entre autres dingueries.
Iels sont reparti.es à la tombée de la nuit. On se remet de nos émotions de la journée et on pense à nos 2 copaines qui passent la nuit en GAV.
Il y a plein de zadistes encore sur zone
Les keufs ne sont plus dans la zad et plus trop dans le village de ce qu’on sait, donc c’est possible d’entrer.
On a besoin de soutien, de présence humaine, d’eau, d’eau potable.
Les keufs risquent de repasser très bientôt, si ce n’est pas le 6 octobre avec les mouvements lycéens ce sera les jours suivants.
Un jour de plus à la Chab’ZAD
Hésite pas à checker notre site pour les infos importantes : https://chabzad.espivblogs.net/
– Expulsion et destruction d’une partie de la Chab’ZAD (6 oct. 2026)
Hier dès 8h, plusieurs dizaines de keufs ont débarqué à la Chab’Zad pour expulser sans préavis une maison qui était habitée depuis plus d’un mois par les zadistes.
Après plusieurs heures de coups de pression les occupant.es ont réussi à négocier leur sortie sans poursuites. La maison a été démolie tout de suite après par Eiffage et ses sous-traitants. Iels ont aussi coupé tous les arbres sur cette partie de la zone et ont fait des sondages du sol.
Juste avant la tombée de la nuit, les Keufs sont rentré.es sur l’autre partie de la zone pour essayer d’interpeller plusieurs personnes. Au cours de la journée il y aura eu 5 interpellations, dont 2 personnes qui sont encore en GAV à l’heure actuelle.
Sur zone, on est de nouveau aux aguets aujourd’hui. On a besoin d’un max de soutien humain, si tu peux venir ! On a besoin de couettes et duvets, de vêtements, de matos de construction et de boissons sans alcool.
gps : 46.330, 6.4423
– Jusqu’ici tout va bien. This is fine (11 oct. 2026)Ce n’était pas une expulsion mais « juste » de la destruction apparemment.
On est toujours là contre l’A412 et son monde de merde.Viens si tu veux. (Cette vidéo peut contenir un peu d’ironie.)

-
US transport secretary’s war on ‘woke’ could make roads even deadlier, experts warn
Sean Duffy targets bike lanes and immigrant truck drivers while steering funds away from addressing lethal US roads
Barbara McCann may have been the first person to notice that the Federal Highway Administration had removed several safety policies from public view.
McCann worked on road safety policy at the US Department of Transportation (USDOT) for more than a decade across multiple administrations, retiring in January 2025 just before Donald Trump’s second term started. After Sean Duffy, the president’s ally and former Fox news host, took the wheel at USDOT, she became increasingly worried as the secretary appeared unmotivated to address pedestrian safety and regularly bashed bike infrastructure.
Continue reading... -
Il a étouffé un ruisseau, la justice l'a condamné : récit d'un jugement inhabituel

C'est l'histoire d'une parcelle de forêt rasée par un sylviculteur, avec des conséquences en cascade jusqu'à la disparition de la biodiversité d'une rivière. L'exploitant, qui n'avait pas conscience des conséquences de ses actes, a été condamné.
Lire la suite - Info / Forêts , Eau , Justice
C'est un jugement inhabituel, qui vient rappeler qu'on ne fait pas tout à fait ce qu'on veut en forêt. L'histoire avait pourtant commencé de façon banale. Printemps 2022, lieu-dit Petit Tournant, à Saint-Setiers, sur le plateau de Millevaches, en (…) -
Qui est l'artiste derrière l'hymne des blocus lycéens ?

« No Title », composé il y a onze ans pour une star de YouTube, est devenu la bande-son des blocus lycéens. Son auteur, le producteur franco-vietnamien Nodey, soutient de longue date les victimes de l'agent orange.
Lire la suite - Portrait / Culture , Luttes
« C'est la plus belle récompense pour un compositeur. » Depuis le début du mouvement lycéen, le même instrumental revient sous les vidéos de lycées bloqués, de pancartes et de cortèges : No Title. Qui est derrière ce titre, parfois qualifié d'« hymne de la Gen Z » ? Nodey, DJ (…) -
« Créer est un acte politique » : Nodey, un artiste engagé derrière l'hymne des blocus lycéens

« No Title », composé il y a onze ans pour une star de YouTube, est devenu la bande-son des blocus lycéens. Son auteur, le producteur franco-vietnamien Nodey, soutient de longue date les victimes de l'agent orange.
Lire la suite - Portrait / Culture , Luttes
« C'est la plus belle récompense pour un compositeur. » Depuis le début du mouvement lycéen, le même instrumental revient sous les vidéos de lycées bloqués, de pancartes et de cortèges : No Title. Qui est derrière ce titre, parfois qualifié d'« hymne de la Gen Z » ? Nodey, DJ (…) -
Frigos de supermarchés sabotés : des contrôleurs Danfoss obsolètes, des failles documentées et des responsabilités à éclaircir
Des rayons surgelés vides, des marchandises jetées et des installations frigorifiques à remettre en service. L’attaque informatique survenue dans la nuit du 11 au 12 octobre 2026 a frappé plusieurs réseaux de distribution alimentaire, dont Intermarché, Netto, Coopérative U, Carrefour, Monoprix et E.Leclerc. Les hackers ont perturbé le fonctionnement des équipements chargés de conserver les denrées, provoquant des ruptures de la chaîne du froid.
-
La pochette officielle Switch 2 des 40 ans de Zelda revient en précommande chez Cultura
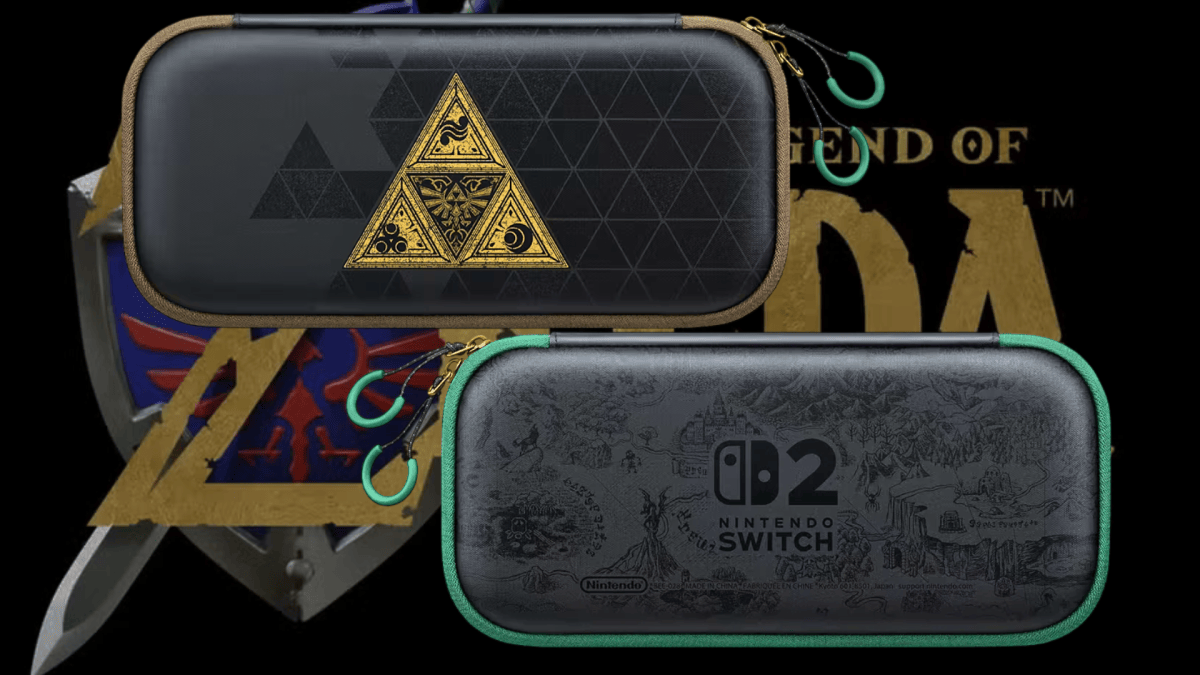
[Précommande] La pochette de transport officielle de la Nintendo Switch 2 aux couleurs des 40 ans de The Legend of Zelda est de nouveau disponible en précommande chez Cultura. Elle est affichée à 39,99 € et sort le 29 octobre 2026.
-
[IA Insider] Meta veut transformer ses milliards de dollars d’investissement en agents IA (vraiment) autonomes
À la une
-
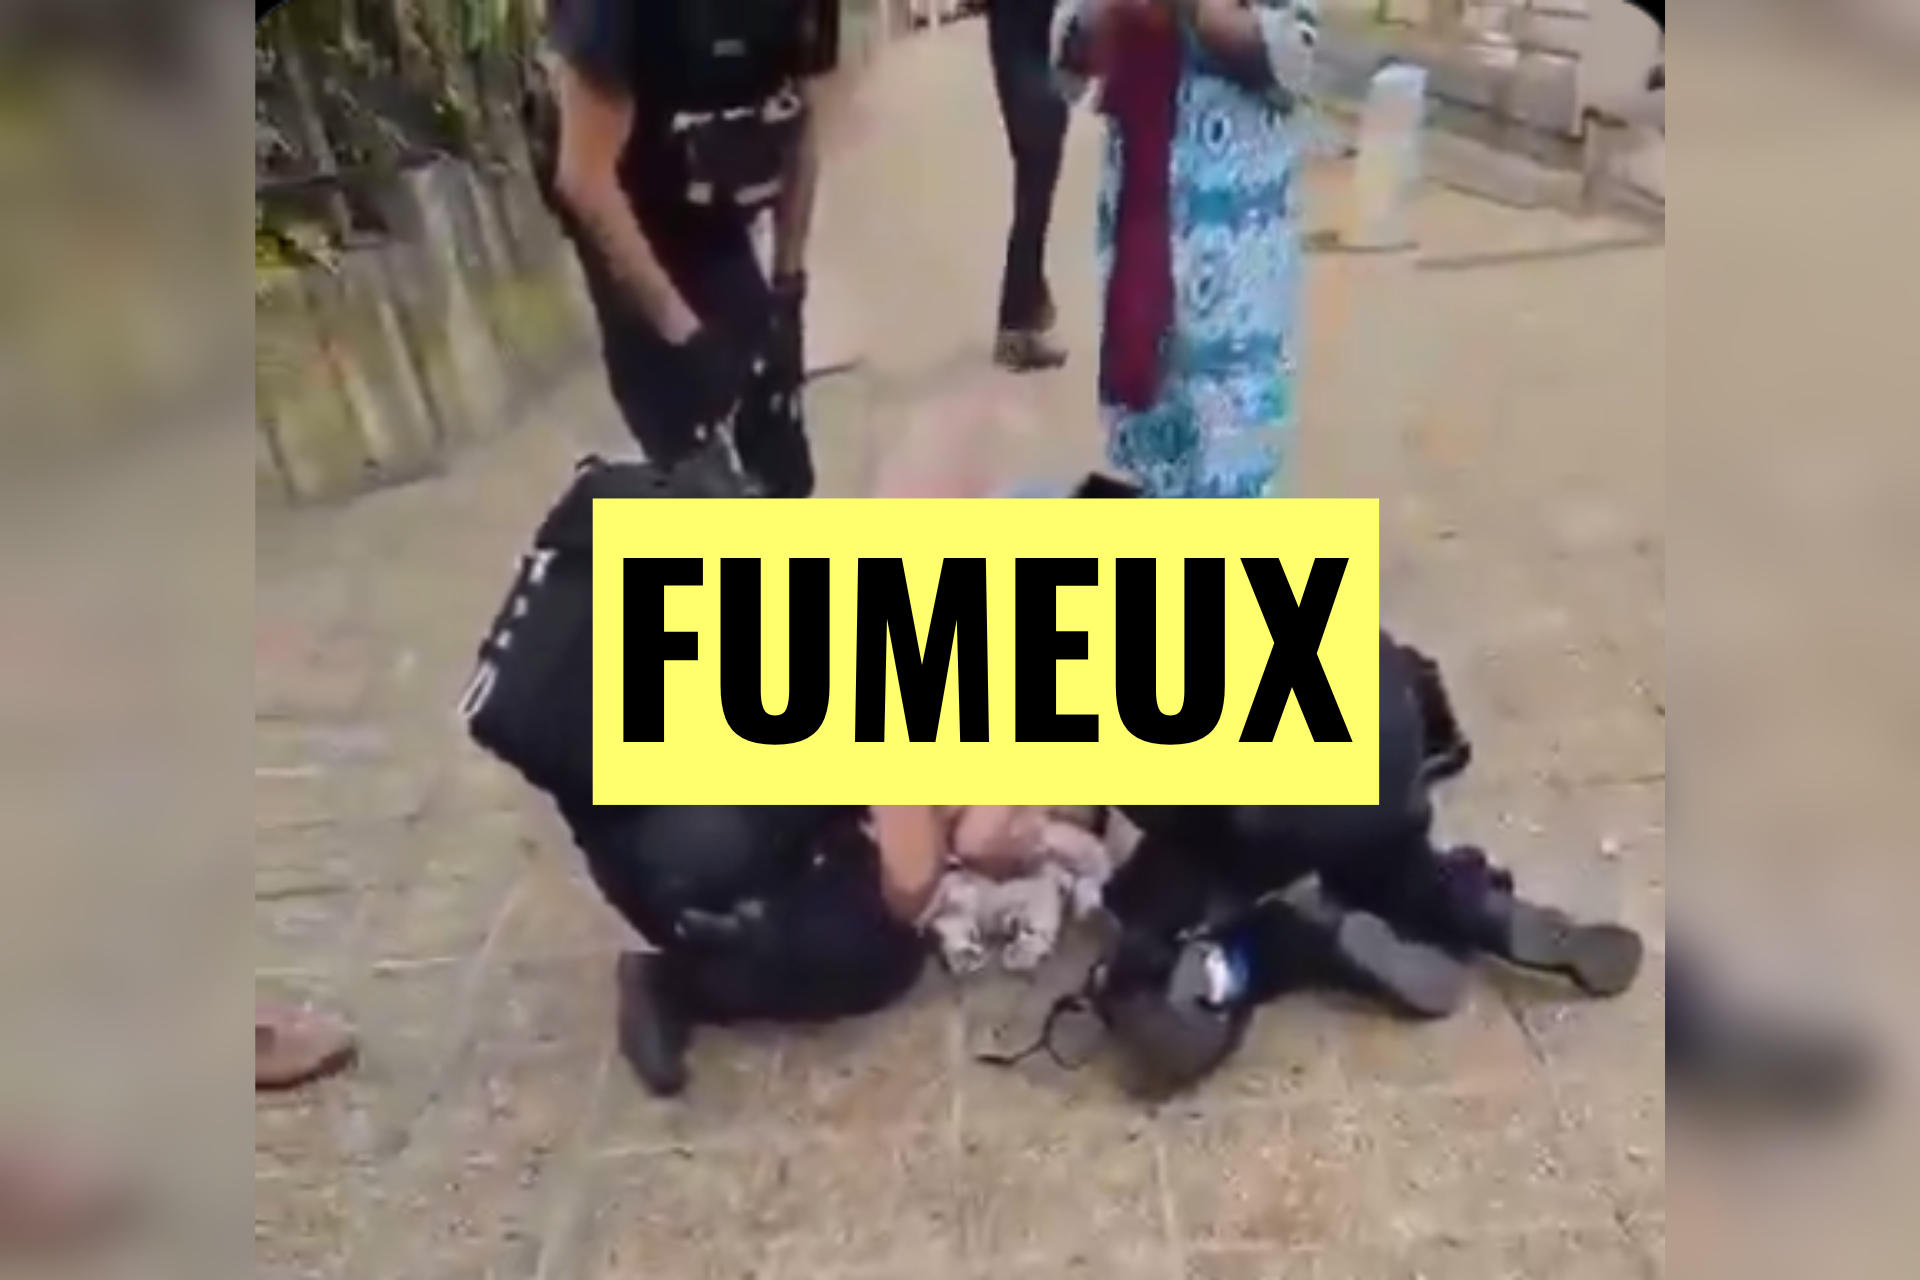
La police niçoise a-t-elle utilisé du gaz lacrymogène sur un nourrisson ?
Source :Compte X, le 1er octobre 2026
Etiqe :fumeux
Contenu :
Gazé avant de savoir marcher ? Le 1er octobre, un utilisateur de la plateforme X publie une vidéo montrant deux agents de police en uniforme, accroupis au-dessus du corps d’un bébé allongé au sol. L’un d’entre eux lui appose la main sur le ventre. « À Nice, la police a gazé un bébé », assure l’internaute. Visionnées plus de 800 000 fois à ce jour, les images sont relayées par différents comptes Facebook (ici, ici ou encore là). Selon eux, le nourrisson aurait été touché par du gaz lacrymogène, utilisé par la police niçoise lors d’une manifestation lycéenne à proximité.
Le contenu de la vidéo ne permet pourtant pas de corroborer ce récit : les policiers n’y font usage ni d’une bombe lacrymogène ni d’un lanceur de grenades, et l’air autour du bébé ne contient aucune volute blanche caractéristique de la présence de ce gaz dans les scènes de maintien de l’ordre.
La préfecture conteste d’ailleurs entièrement la version des faits avancée par les internautes. Les forces de l’ordre seraient au contraire intervenues à la demande de la mère de l’enfant.
Malaise dans un bus
Citant différentes sources officielles, Nice Matin a reconstitué le déroulé des faits. La scène s’est bien déroulée le jeudi 1er octobre, à Nice, en même temps que la mobilisation lycéenne, sans pour autant que les deux événements soient corrélés.
Interrogé par le quotidien, le service départemental d’incendie et de secours (SDIS) local rapporte avoir effectué « une intervention auprès d’un bébé, un garçon, âgé d’un mois, qui a fait un malaise dans un bus ». La police nationale confirme, sur son compte X, que les policiers visibles sur la vidéo ont « prodigué les gestes de premiers secours » à un nourrisson « pris d’un malaise », et dément tout gazage.
Voyant son enfant souffrir d’une apparente insuffisance respiratoire, une passagère d’un bus est descendue du véhicule pour demander l’aide des forces de l’ordre, selon un communiqué de presse de la préfecture des Alpes-Maritimes transmis à Actu Nice.
Les agents de police ont alors entamé les premiers secours en attendant l’arrivée des pompiers, affirme la préfecture. Finalement, « les sapeurs-pompiers sont intervenus rapidement en prenant en charge le nourrisson dont l’état de santé était stable », ajoute le préfet.
Autrement dit, l’intervention de la police auprès du nourrisson n’a rien à voir avec les mobilisations lycéennes.
Auteurs :
Auteur : Jean-Baptiste Breen, journaliste
Relecteur : Nicolas Turcev, journaliste
Liens d’intérêts ou fonctions politiques déclarés des intervenants à l’article : aucun
Secrétariat de rédaction : Nicolas Turcev, journaliste
L’article La police niçoise a-t-elle utilisé du gaz lacrymogène sur un nourrisson ? est apparu en premier sur Les Surligneurs.
-
Trump's Desperate Diesel Deal
Desperation is not a good look for an American president. The price of Diesel #2 — the type of diesel typically used in, among other applications, trucks, buses, tractors, generators, and construction equipment — has soared in the last few months. In early January, it was priced at around $3.50 per gallon. It spiked as soon as the war against Iran began, and apart from one brief pullback, it has kept on up and now costs about $6.20 per gallon. -
Trump's October Surprise
It rained most of Sunday in Washington, as the remnants of Hurricane Isaias washed over the East Coast. Unable to golf, and stuck inside the White House, President Trump spent part of his morning on social media touting the size of his rallies and defending Christopher Columbus. He also declared that Russia and Ukraine had agreed to halt strikes against each other's energy infrastructures. Except that he hadn't first confirmed that with Ukrainian President Volodymyr Zelensky—and Russia spent the hours that followed bombarding Ukraine with missiles and drones, hitting a Kharkiv power plant. -
« Tu nous la met à l’envers, on te mai 68 » : 7000 personnes en soutien à la jeunesse à Montpellier
Lyéen-nes, étudiant-es, travailleurs-euses : environ 7000 personnes ont manifesté à Montpellier ce mardi 13 octobre en soutien à la jeunesse quotidiennement mobilisée depuis le 29 septembreNi les annonces du gouvernement sur une consultation lycéenne censée porter ses fruits fin octobre, ni les 3 000 professeurs-eures affecté-es à des remplacements, ni les 1,2 milliards de rallonge au budget de l’Éducation Nationale ne semblent calmer la colère. Ce mardi 13, une manifestation d’environ 7000 personnes a eu lieu dans les rues de Montpellier. Comme les 6 et 8 octobre, une intersyndicale de l’Éducation Nationale appelait à la grève dans tout le pays en soutien au mouvement lycéen amorcé fin septembre, dénonçant le manque de moyens pour l’éducation et des conditions d’études jugées déplorables.
Dans le cortège parti de la place Albert 1er se mêlaient lycéen-nes, étudiant-es, et travailleurs-euses solidaires. « Tu nous la met à l’envers, on te mai 68 », « Bloquons tout pour débloquer nos rêves », ou encore « Lutte pour ton éducation », pouvait-on lire sur les pancartes.
La manifestation a rejoint Antigone via le boulevard du Jeu de Paume et le boulevard de Strasbourg. En fin de manifestation, une partie de la manifestation est venue se masser contre les cordons de CRS positionnés en haut d’Antigone, côté Polygone.
Plusieurs lycées et campus montpelliérains étaient bloqués ce matin. Parmi eux, Clémenceau, Jules Guesde, Mermoz, Joffre. La fac de sciences reste bloquée et occupée. Les CRS sont intervenus a Paul-Valery après une tentative d’occupation du campus bloqué. La fac d’économie et la fac de droit étaient bloquées à l’aube, mais ont été rapidement débloquées. L’IRTS était aussi mobilisé.
Plus d’infos dans nos reportages a venir dans Le Poing.
L’article « Tu nous la met à l’envers, on te mai 68 » : 7000 personnes en soutien à la jeunesse à Montpellier est apparu en premier sur Le Poing.
-
Muse Wonder : Meta acte son retour dans la course à l’IA avec des agents capables de travailler seuls
Meta n’a pas l’intention de laisser OpenAI et Anthropic occuper seuls le terrain des agents d’intelligence artificielle. La firme de Mark Zuckerberg a présenté ce 12 octobre Muse Wonder et Muse Wonder Full, deux modèles destinés à exécuter des tâches qui nécessitent davantage que de générer une réponse à une question. Comprendre un contrat de location, traiter un dossier d’assurance, élaborer un programme d’entraînement ou développer une application : Meta veut que ses modèles puissent mener un travail à son terme, y compris lorsqu’il implique plusieurs étapes, des outils externes et des corrections successives.
-
Sciences Po : enseignants et personnels rejoignent la grève et dénoncent la répression des lycéen·nes
-
Comment le mouvement parti des lycées s'étend aux étudiants et aux enseignants-chercheurs
-
Près d'un demi-million de jeunes dans la rue : comment la contestation lycéenne gagne les universités
-
Près d'un demi-million de jeunes dans la rue : comment la contestation lycéenne gagne les universités
-
Apple lance de nouveaux Apple TV et HomePod mini : voici les nouveautés
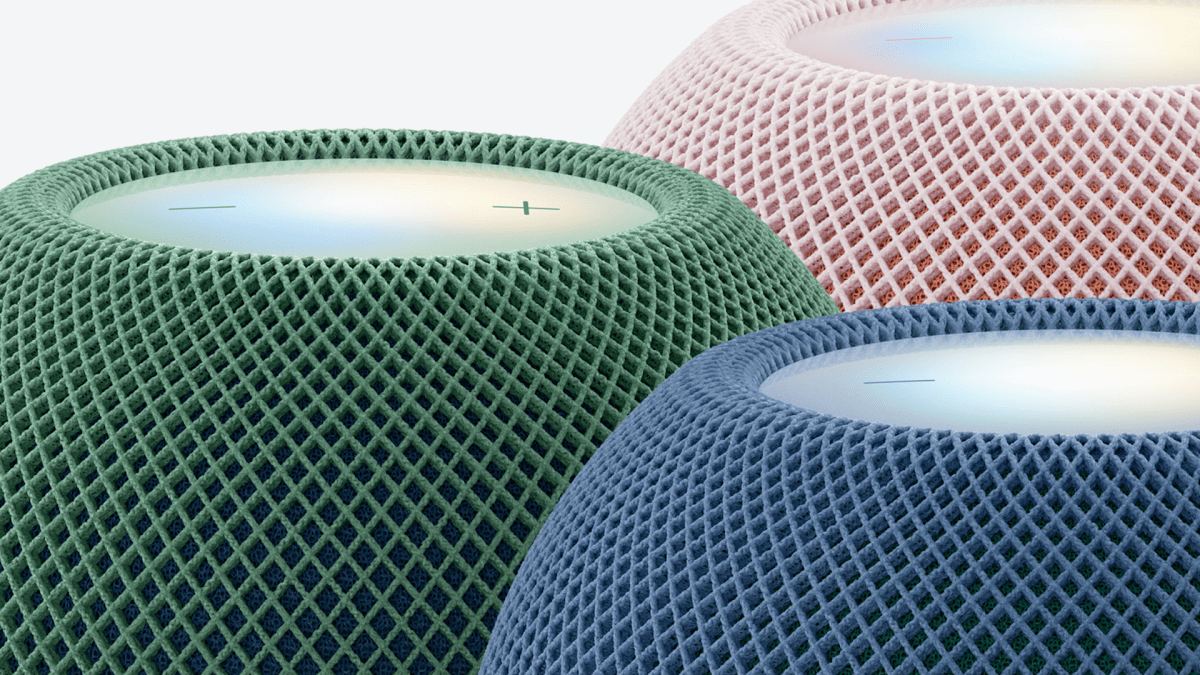
Apple dévoile de nouvelles versions de ses deux produits les plus populaires pour la maison connectée : l'Apple TV et le HomePod mini. Au programme : des puces plus puissantes, mais pas de Siri AI en France.
-
Dans les colonies françaises d’outre-mer : une colère lycéenne oubliée et réprimée
Les médias français basés en métropole n'en parlent pas, mais la jeunesse lutte aussi dans les Antilles et dans l’océan Indien.
L’article Dans les colonies françaises d’outre-mer : une colère lycéenne oubliée et réprimée est apparu en premier sur Contre Attaque.
-
Le nouveau jeu du créateur de Dragon Quest a été conçu avec l’IA en 30 minutes
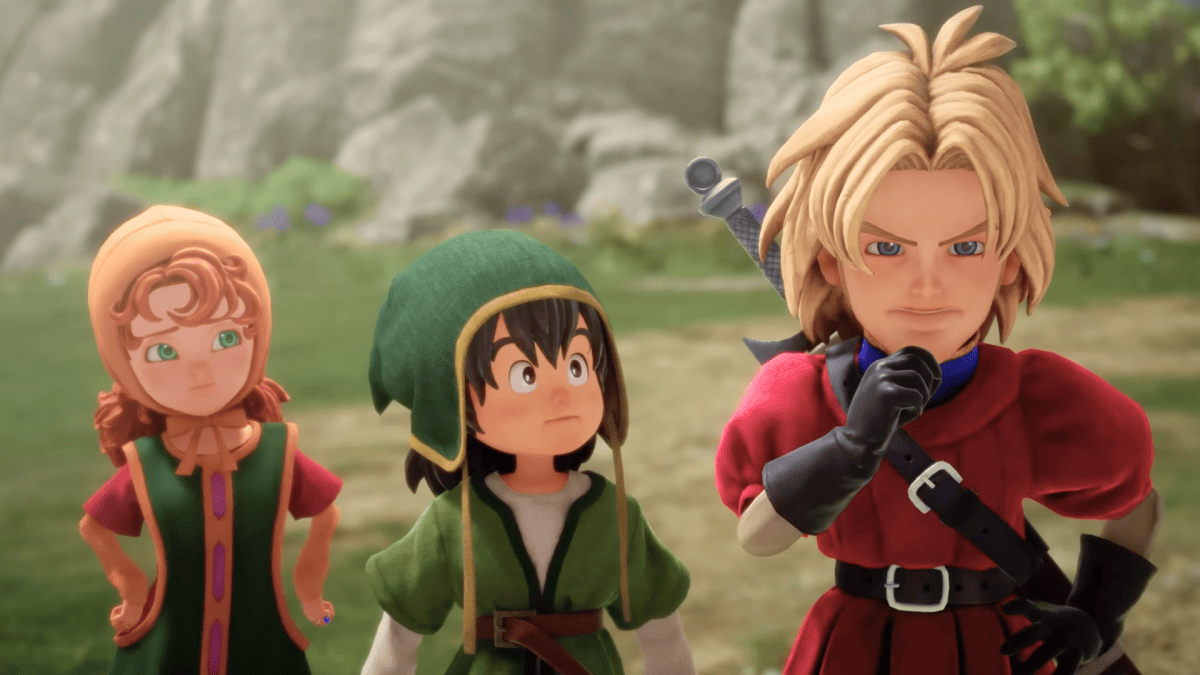
Yuji Horii est l'un des co-créateurs de Dragon Quest, tout de même l'une des sagas de JRPG les plus importantes de l'histoire. Le 11 octobre, il a publié gratuitement un petit jeu d'enquête qu'il dit avoir créé en une trentaine de minutes avec Claude, l'IA générative d'Anthropic.
-
GEO : sur 148 marques, être connu des modèles ne prédit pas la citation, selon Pierre Sauvé
Ce qu'il faut retenir :
- Pierre Sauvé distingue la « présence » d'une marque dans les poids d'un modèle, mesurée par log-probabilités sur des modèles ouverts, de sa « citabilité », qui dépend de la recherche web effectuée au moment de répondre.
- Sur son panel, l'accord entre le classement des marques connues des modèles ouverts et celui des marques citées par ChatGPT et Gemini n'est que de 0,1, sur une échelle allant de 0 à 1.
- À notoriété web égale, avoir une page Wikipédia ou une forte présence sur Reddit ne produit pas d'avantage mesurable sur la présence : les paires comparées se répartissent quasiment à parts égales.
- Le consultant recommande des audits GEO avec passages répétés, appels dans l'interface plutôt que par l'API, socle daté et deux indicateurs distincts, présence et citation, plutôt qu'un score unique.
Trois passages dans ChatGPT donnent trois listes de marques différentes
L’étude est née d’une remarque d'un client. Pierre Sauvé raconte avoir travaillé pour une plateforme de sondage dont l’équipe, plutôt rigoureuse, constatait que les taux de visibilité IA variaient d’un outil à l’autre. Il a donc lancé trois fois la même requête dans ChatGPT (« quelle plateforme de sondage propose des quotas et redressement ? »), dans des conditions d’utilisation classiques, le même jour et à quelques heures d’intervalle. Résultat : trois listes différentes. Une seule marque, Symbial, apparaît dans deux réponses, et aucune n’apparaît dans les trois. Le consultant parle de « roulette russe ».
Il a ensuite sollicité Qwairy, outil de suivi de la visibilité dans les LLM, qui lui a fourni gracieusement des données sur un panel plus large. Les marques y sont détectées par leur nom mais aussi par leur domaine. Les résultats confirment l’instabilité :
- Sur ChatGPT : 42 % des marques ne sont vues qu’une seule fois sur trois passages, et seulement 37 % apparaissent aux trois.
- Sur Gemini : 55 % des marques ne sont vues qu’une seule fois sur trois passages.
Pour Pierre Sauvé, un audit GEO fondé sur un passage unique contient donc une part d’aléa importante. Il précise que ces passages ont été réalisés sur une période courte et qu’il prévoit de les renouveler dans un mois ou deux.
Présence et citabilité relèvent de deux couches distinctes
Le consultant distingue deux raisons pour lesquelles un LLM cite une marque :
- La présence : ce que le modèle a en mémoire, ancré dans ses données d’entraînement. Elle est apprise à un instant donné, bouge lentement et se mesure de façon reproductible.
- La citabilité : ce que l’étape de recherche (le live retrieval) place sous les yeux du modèle au moment de répondre. Elle est volatile et actionnable à court terme.
Il illustre la différence par deux cas extrêmes. Pour savoir qui présidait la France en 2003, ChatGPT n’a pas besoin de chercher sur le web : l’information est solidement ancrée dans ses données d’entraînement. Pour connaître le résultat du dernier match de l’OM, il doit effectuer une recherche. La plupart des prompts, notamment en e-commerce, se situent entre les deux : le moteur puise une partie de l’information dans sa mémoire, puis la recherche la complète, la valide ou parfois la contredit.
Ces deux axes forment une matrice à quatre cases : présente et citée (position idéale), présente mais jamais citée (problème de récupération), absente mais citée (position portée par la recherche, donc fragile), absente et silencieuse (tout est à faire). Pierre Sauvé présente cette grille comme une proposition de complément méthodologique, et non comme une vérité établie.
 Illustration de la matrice d'analyse - Source : Slides de la conférence de Pierre Sauvé
Le robots.txt recoupe en partie cette distinction. Chez OpenAI, GPTBot collecte pour l’entraînement (la présence), tandis qu’OAI-SearchBot alimente l’index de recherche (la citabilité). Le consultant cite plusieurs cas observés en septembre 2026, avec des taux de citation calculés sur le jeu de prompts de chaque secteur :
- Moosend : GPTBot et ChatGPT-User bloqués, OAI-SearchBot autorisé. Marque citée par ChatGPT dans moins de 3 % des réponses.
- Dealabs : tous les robots bloqués par défaut, sauf sur le répertoire des codes promos. Marque citée par ChatGPT dans 36 % des réponses.
- Ouest-France : stratégie sélective selon les rubriques.
Pour Pierre, bloquer GPTBot n’empêche pas une marque d’apparaître dans les données d’entraînement, puisque d’autres sites parlent d’elle. Ce choix revient surtout à laisser à des tiers la manière dont la marque y est décrite, et à dépendre de la recherche pour corriger ou valider ces informations. Dealabs illustre l’inverse : selon lui, son ancrage est si fort que le blocage ne l’empêche pas d’être bien présente et bien citée. De la même façon, les LLM connaissent Ouest-France ou Le Figaro malgré la posture restrictive des médias.
La log-probabilité sert d’instrument pour mesurer la présence
Pierre Sauvé limite volontairement son étude à la présence, qu’il juge la plus mal connue et la moins vérifiée dans les audits. Il laisse la citabilité (balisage, format des réponses, fraîcheur) aux outils SaaS spécialisés, et estime que sa conférence ne couvre qu’environ la moitié du sujet. Il précise aussi qu’il mesure si le modèle connaît une marque, pas ce qu’il en pense, un second volet étant annoncé pour une « V2 ».
Son instrument est la log-probabilité (logprob). Pour rappel, un modèle de langage attribue une probabilité à chaque mot susceptible d’en suivre un autre. Dans la phrase « Paris est la capitale de la… », « France » obtient environ 90 % et « soupe » environ 0,01 %. Le consultant exprime ces valeurs en nats, une unité logarithmique : 0 nat correspond à une probabilité de 100 %, et chaque nat en moins divise la probabilité par 2,7 environ. Une marge de +0,78 nat signifie ainsi que la bonne réponse est 2,2 fois plus probable que la meilleure des mauvaises.
Le protocole repose sur quatre briques :
- Le panel : 148 marques réparties sur 11 secteurs, avec une majorité de marques anglophones, un sous-groupe français et 38 marques inventées servant de témoins. Le consultant dit avoir mélangé des secteurs très présents sur le web (CRM, plugins SEO pour WordPress) et d’autres qui communiquent moins.
- La notoriété : le nombre de mentions par milliard de mots dans cinq corpus ouverts de pré-entraînement (C4, DCLM-baseline, Dolma v1.7, RedPajama et The Pile), compté via l’API infini-gram de l’Allen Institute for AI.
- La présence : dix modèles ouverts issus de trois familles (Qwen, Llama, Gemma), en deux tailles de 1 à 9 milliards de paramètres, complétés par des tests sur des modèles de 70 milliards.
- L’appariement : plutôt que de comparer Nike à un petit fabricant local, le consultant compare des marques de notoriété équivalente.
Les vrais corpus de Qwen, Llama, Gemma et des modèles fermés ne sont pas publiés. Pierre Sauvé s’appuie sur le fait que Common Crawl est au cœur de l’entraînement de tous ces modèles, en rappelant que la seule composition publiée par OpenAI date de GPT-3 (60 % des tokens). Il raisonne aussi par différence entre corpus de composition connue, Dolma contenant Reddit et RedPajama non. Le tout a été réalisé avec des GPU loués, pour un coût global d’environ 50 dollars.
La mesure centrale est la « marge de catégorie ». Le modèle évalue la phrase associant la marque à sa vraie catégorie, puis la compare à quatre fausses catégories (café italien, poisson, village du sud, danse folklorique). La marge est l’écart, en nats, entre la bonne catégorie et la meilleure des fausses. Elle est ensuite comparée à un « plancher » : la marge obtenue par des noms inventés, générés puis vérifiés un par un sur Google pour s’assurer qu’ils n’existaient pas. Selon le consultant, une log-probabilité brute mesure la plausibilité d’une chaîne de caractères, pas la connaissance : en démonstration, la marque inventée « Mailzephor » passait devant une vraie marque avant cette correction.
Le premier enseignement concerne le nom lui-même. Un nom inventé mais « parlant », qui contient par exemple « mail » pour l’emailing, obtient une marge positive sans aucune connaissance derrière. Selon les modèles, ce bonus atteint +0,75 à +1,05 nat sur les petits modèles et +0,99 à +1,23 nat sur ceux de 7 à 9 milliards de paramètres. La part de marques réelles qui dépassent la meilleure marque inventée varie de 30 % (Qwen, petite taille) à 71 % (Gemma, grande taille). Sur les petits modèles, sept marques sur dix ne battent donc pas un nom qui n’existe pas. Les gros modèles connaissent davantage de marques, mais accordent aussi un bonus plus élevé aux noms parlants.
Mentions, Reddit, Wikipédia : trois croyances passées au crible
« Spammons de mentions, tant pis pour les liens »
Pierre Sauvé rappelle d’abord que le balisage HTML est supprimé lors de l’extraction du texte d’entraînement. Dans les corpus, « https:// » apparaît 525,7 fois par million, « href= » 16,6 fois et « rel="nofollow" » 3,7 fois. D’un lien, il ne reste que l’ancre, c’est-à-dire une mention. Le lien garde pourtant un rôle à deux niveaux. En amont, Common Crawl découvre et revisite les pages en suivant les liens, et les filtres qualité favorisent les pages connectées. En aval, ChatGPT et Gemini s’appuient sur des index où le graphe de liens sélectionne les pages proposées au modèle.
Il vise ici les plateformes qui vendent des mentions pour le GEO. Selon lui, aucune n’a démontré d’effet sur les données d’entraînement : elles partent du principe que leurs contenus seront à la fois récupérés par la recherche et intégrés aux corpus.
Ses mesures montrent un rendement décroissant. En classant les 148 marques en quatre groupes de taille égale, la part de marques réellement reconnues passe de 11 % (Botify, Oncrawl, Bricorama…) à 30 % avec six fois plus de mentions, puis à 46 % avec 33 fois plus. Elle redescend à 35 % pour les marques omniprésentes (HubSpot, IKEA, Sephora), avec 110 fois plus de mentions.
Sur Qwen 1,5B, la marge moyenne passe de +0,28 à +0,97 nat entre le premier et le deuxième quartile de mentions, puis ne gagne que +0,24 nat jusqu’au quatrième, malgré dix-neuf fois plus de mentions. Sur Qwen 7B et Llama 8B, le deuxième quartile dépasse même les suivants. Le consultant en conclut que sortir de l’invisibilité vaut l’effort, mais que saturer une marque déjà présente rapporte beaucoup moins. Pour une marque jeune ou très peu présente, il recommande au contraire de « taper un peu fort », puisqu’elle part de zéro.
« La présence Reddit pèse lourd »
Les corpus n’indiquent pas d’où vient une occurrence. Pierre Sauvé compare donc Dolma (avec Reddit) et RedPajama (sans Reddit), construits selon la même méthode. Rank Math y est 9,1 fois plus mentionné dans Dolma, Semrush 4,9 fois, Bioderma 3,3 fois, Oncrawl seulement 1,3 fois. Au-delà d’un rapport de 3,3, il considère qu’une marque doit notablement sa présence à Reddit.
Une lecture naïve semble confirmer la croyance : les 16 marques « Reddit-friendly » affichent une marge médiane de +1,39 nat contre +1,06 pour les 132 autres, avec cinq fois moins de présence web. Mais à notoriété web égale, sur 16 paires, le résultat tombe à 8 contre 8, pour un écart médian de −0,05 nat. Deux exemples l’illustrent :
- AccuRanker contre Sistrix : à notoriété comparable (16 et 18 mentions par milliard), l’outil plus présent sur Reddit l’emporte de 1,67 nat.
- Bioderma contre Fenty Beauty : à 351 et 344 mentions par milliard, c’est la marque peu visible sur Reddit qui l’emporte, avec 1,12 nat d’écart.
Pierre Sauvé en conclut que Reddit signale une présence sans en déterminer la valeur. Il rapporte le cas d’un client accompagné par une agence spécialisée dans Reddit : aucune différence observée, un compte signalé par la plateforme, et des critiques formulées uniquement sur Reddit qui sont ensuite remontées dans les réponses des IA. Il ajoute que les LLM cherchent souvent à présenter les points positifs et négatifs d’une marque. Interrogé sur la rentabilité de Reddit, il répond qu’elle n’est pas supérieure à celle d’un média quelconque, et conseille plutôt de travailler sur des espaces où la marque maîtrise son discours.
« Être sur Wikipédia change tout »
Même démarche pour Wikipédia, dont le statut a été vérifié via l’API de l’encyclopédie. Les 75 marques avec une page devancent les 73 autres de 0,42 nat. Elles sont aussi 11,9 fois plus mentionnées. Pour le consultant, avoir une page Wikipédia est d’abord un symptôme de notoriété.
À notoriété égale, sur 36 paires, 17 vont dans le sens de la croyance et 19 dans le sens inverse, avec un écart médian de −0,29 nat. SendGrid (avec page) devance AWeber (sans page) de 1,79 nat à notoriété quasi identique. À l’inverse, Rank Math (sans page) devance Yoast (avec page) de 1,27 nat. Pierre Sauvé avance deux explications possibles : un nom qui contient « Rank » est plus facilement associé au SEO, et Rank Math, arrivé plus tard, a suscité de nombreux contenus comparatifs.
Il reconnaît à Wikipédia un contexte encyclopédique plus informatif et plus neutre que Reddit, sans y voir pour autant de levier décisif. Il rappelle aussi qu’une page créée par un prestataire rémunéré est souvent signalée par un bandeau ou une mention de contribution rémunérée, ce qui ne sert pas l’image de la marque. Interrogé sur Wikidata, il précise ne pas l’avoir mesuré. Son hypothèse : il s’agit d’une base de données qui fournit des relations entre entités plutôt que du texte d’entraînement.
Être connu du modèle ne prédit pas la citation
Pierre Sauvé a ensuite croisé ses mesures de présence avec les données de citation fournies par Qwairy, relevées dans l’interface et non par l’API. Environ 20 prompts génériques par secteur, en français et sans nom de marque, ont été soumis trois fois à ChatGPT et Gemini, soit 1 100 réponses selon les slides. Une marque est considérée comme « citée » si elle apparaît dans au moins 5 % des réponses de son secteur, et « présente » si sa marge dépasse le plancher des noms inventés.
Les accords entre classements (de 0 pour aucun rapport à 1 pour un ordre identique) sont parlants :
- ChatGPT et Gemini, sur les marques qu’ils citent : 0,89.
- Les modèles ouverts, sur les marques qu’ils connaissent : 0,85.
- Présence et citation entre elles : 0,1.
Chaque couche est cohérente avec elle-même, mais les deux ne se recouvrent pas, sauf pour les marques les mieux placées, comme IKEA ou HubSpot. Trois cas l’illustrent :
- Adobe Marketo : marge de +1,37 nat et 2 131 occurrences par milliard de mots, mais une seule réponse ChatGPT sur 60 dans le secteur de l’emailing. Le consultant rappelle que la marque réalisait 400 millions de dollars de chiffre d’affaires en 2021.
- Brevo : marge de −0,15 nat, inférieure à celle d’une marque inventée, mais citée dans 83 % des réponses ChatGPT du secteur.
- Google Optimize : service arrêté en 2023, marge de +2,1 nat, 0 % de citation, comme Universal Analytics ou Klout. Selon Pierre Sauvé, les mises à jour des données d’entraînement ne font pas baisser ses occurrences, car les modèles continuent d’absorber des articles anciens. Sa formule : « Les données d’entraînement n’oublient pas, mais la recherche, oui. »
Le cas Brevo s’explique par le rebranding de Sendinblue en mai 2023. Sur les trois petits modèles, Sendinblue obtient entre +1,56 et +1,73 nat mais n’est jamais cité, tandis que Brevo oscille entre −0,44 et +1,07 nat. La mémoire retient l’ancien nom, la recherche cite le nouveau. Pour le consultant, c’est la recherche web qui corrige le tir : elle signale au modèle que Sendinblue est devenu Brevo. Il note aussi que le changement n’a pas aidé la marque côté présence, « Send » étant plus proche de l’emailing qu’un nom neutre comme Brevo. Même schéma pour Piwik devenu Matomo, cité dans 65 % des réponses alors que Piwik domine les données d’entraînement.
Sur la matrice finale, Pierre Sauvé classe 61 marques présentes et citées (HubSpot, Ahrefs, Semrush), 65 présentes mais jamais citées (Marketo, Hiscox, FullStory), 13 absentes mais citées (Brevo, MAIF, Weldom) et 17 absentes et silencieuses (Sistrix, Matmut).
Le consultant indique avoir tenté de contredire ce résultat, secteur par secteur, puis sur les articles de type « meilleurs outils de », sans changer la conclusion. Sur Llama 3.1 70B, cinquante fois plus gros, l’accord reste nul. La langue joue en partie : sur des modèles mieux entraînés en français et interrogés en français, l’ordre change. En anglais, tous les modèles placent Home Depot devant Leroy Merlin, alors qu’une sonde française sur un modèle français rétablit l’ordre. Il dit n’avoir trouvé aucun modèle majoritairement entraîné en français : Mistral, qu’il pensait plus francophone, présentait davantage de marqueurs anglais que les modèles américains.
Il insiste enfin sur un point : la présence n’est pas inutile. Elle explique environ 10 % du classement, et les marques les plus citées figurent parmi celles qui se détachent sur la présence. Selon lui, être dans les données d’entraînement permet aussi de rattacher la marque à son contexte : si le modèle ne sait pas que Brevo fait de l’emailing, le lien doit être reconstruit à chaque recherche. Pour une petite marque, il recommande d’acquérir des mentions et de s’insérer dans des comparatifs, même si le gain reste modeste.
Un standard d’audit, un kit et une méthode discutée
Ce que Pierre Sauvé demande à un audit GEO
À sa connaissance, aucun outil commercialisé ne mesure la présence dans les données d’entraînement. Il en fait la première exigence d’un audit, avant de détailler celles qui portent sur la citation :
- Des passages répétés, avec une variance visible. Un passage unique relève du bruit : un client qui teste lui-même ses prompts favoris obtiendra un résultat différent.
- Des appels dans le produit plutôt que par l’API, dont la couche de recherche diffère et dont les réponses sont, selon lui, moins riches.
- Un socle stable (modèle, date, prompts), en ne changeant de modèle que lorsque le modèle par défaut du grand public change.
- Deux indicateurs distincts, présence et citation, parce qu’ils ne bougent pas ensemble.
Il met aussi en garde contre l’usage des log-probabilités exposées par l’API d’OpenAI. On n’y choisit pas la phrase évaluée, il n’y a ni corpus ni appariement, et le modèle comme la recherche évoluent sans cesse. Selon lui, on y mesure une conversation, pas une mémoire.
Ses recommandations suivent la matrice. Pour les marques présentes mais jamais citées : « Arrêtez de payer pour entrer dans les LLM », puisque le blocage se situe dans la récupération. Pour les marques présentes et citées, il conseille d’exiger la variance des prompts et de reprendre la main sur le discours de marque. Pour les marques absentes mais citées, comme Brevo, il recommande de ne rien relâcher et de s’imposer aussi dans les données d’entraînement. Pour les marques absentes et silencieuses, il prévient que le chantier sera long et qu’il faut annoncer délai et budget dès le départ.
Un kit pour tester sa propre marque
Le 2 octobre 2026, Pierre Sauvé a publié sur GitHub un kit sous licence MIT, baptisé brand_probe, qui applique la méthode à une marque à la fois. Il fonctionne en ligne de commande, dans un notebook Colab ou via une petite interface. Le modèle par défaut, Qwen 2.5 1.5B, se télécharge (3 Go) sans compte. Llama et Gemma nécessitent un compte Hugging Face et l’acceptation de leur licence. À l’oral, le consultant a mis en garde contre une possible hausse des coûts de Hugging Face, qu’il présentait comme récemment racheté par NVIDIA.
Le kit fournit :
- La présence dans chaque modèle : marge de catégorie, plancher des noms inventés et verdict (présente si la marge dépasse le plancher de plus de 0,10 nat).
- Le nom parlant : la marge d’un nom inventé qui annonce la catégorie (« Rankzuri » pour le SEO, « Assurvex » pour l’assurance). Sur Qwen 1.5B en français, Assurvex obtient +0,62 nat contre +0,42 pour Groupama.
- Les termes associés : les mots que le modèle rattache à la marque, corrigés de ce qu’il dirait d’un nom inventé.
- La fréquence dans les corpus C4, DCLM et Dolma, et les mots qui accompagnent la marque.
Le README avertit que le kit ne mesure pas la citation. Il résume la position de l’auteur : être dans les poids est une condition d’entrée, pas une cause de citation. Une marque absente des poids n’est jamais citée sans recherche web, mais une marque présente ne l’est pas pour autant. Le document détaille aussi plusieurs pièges :
- Le collage de tokens : infini-gram apparie des séquences de tokens. « Brevo » compte 3 421 occurrences dans C4, dont 98 % correspondent à « Brevoort » (un éditeur de Marvel) ou « Brevoortia » (un poisson). En mot entier, Brevo n’en compte que 53.
- Les homonymes : dans les corpus anglophones, « MAIF » désigne surtout le Maryland Automobile Insurance Fund. Une requête combinée (par exemple « Orange » avec « téléphonie », cité en démonstration) déplace l’équilibre sans tout corriger.
- Les corpus datés : C4 date d’avril 2019, DCLM de 2023 et Dolma de début 2024.
- La taille des modèles : une marque absente à 1,5 milliard de paramètres peut être présente à 9 milliards.
Le script fixe la révision exacte de chaque modèle et refuse la quantification, qui modifierait les log-probabilités. Deux personnes doivent ainsi obtenir la même marge à la décimale près.
Une méthode discutée sur LinkedIn
Notons qu'après la publication de Pierre Sauvé sur LinkedIn, Antony Luvera, CTO chez Maples Labs a contesté le passage entre ce qui est mesuré et ce qui est conclu. Selon lui, comparer des corpus et apparier des volumes de mentions n’isole pas explicitement l’effet de Reddit ou de Wikipédia. Une association marque-catégorie n’explique pas une recommandation. Et une marque connue mais non citée a pu être trouvée, comparée puis écartée, sans qu’il s’agisse d’un problème de récupération. Il estime que la méthode ignore les sources réellement présentes dans la fenêtre de contexte, les informations reprises dans le raisonnement du modèle et les critères de comparaison activés.
Pierre Sauvé reconnaît la justesse du troisième point : sa méthode regroupe les marques « jamais récupérées » et « récupérées puis écartées ». Il précise établir seulement que le blocage ne vient pas de la présence dans les données d’entraînement. Sur Wikipédia et Reddit, il dit conclure à une absence d’effet mesurable à notoriété égale, et non à une absence totale d’effet. Il ajoute qu’observer Reddit dans la fenêtre d’une réponse citant une marque ne prouve pas que Reddit a causé la citation : pour mesurer une contribution, il faudrait retirer la source et rejouer la requête, ce qui est impossible.
Précisons que durant sa présentation au TEKnSEO, Pierre Sauvé avait présenté sa matrice comme une proposition et reconnu à plusieurs reprises les limites de ses mesures statistiques. Antony Luvera soutient par ailleurs que l’analyse fine peut être instrumentée : les modèles exposent le contenu des sources qui entrent dans la fenêtre de contexte, ce qui permet selon lui de relier les données reprises aux choix observés, une fois pondérés par les récurrences entre conversations. Il renvoie vers le livre blanc méthodologique de Maple Labs (maplelabs.fr/technologie). La question de savoir si l’on peut attribuer une citation à une source précise reste donc ouverte entre les deux approches.
L’article "GEO : sur 148 marques, être connu des modèles ne prédit pas la citation, selon Pierre Sauvé" a été publié sur le site Abondance.
-
Apple dévoile le HomeView et nous donne vraiment envie… mais ne le sort pas en France et en Europe
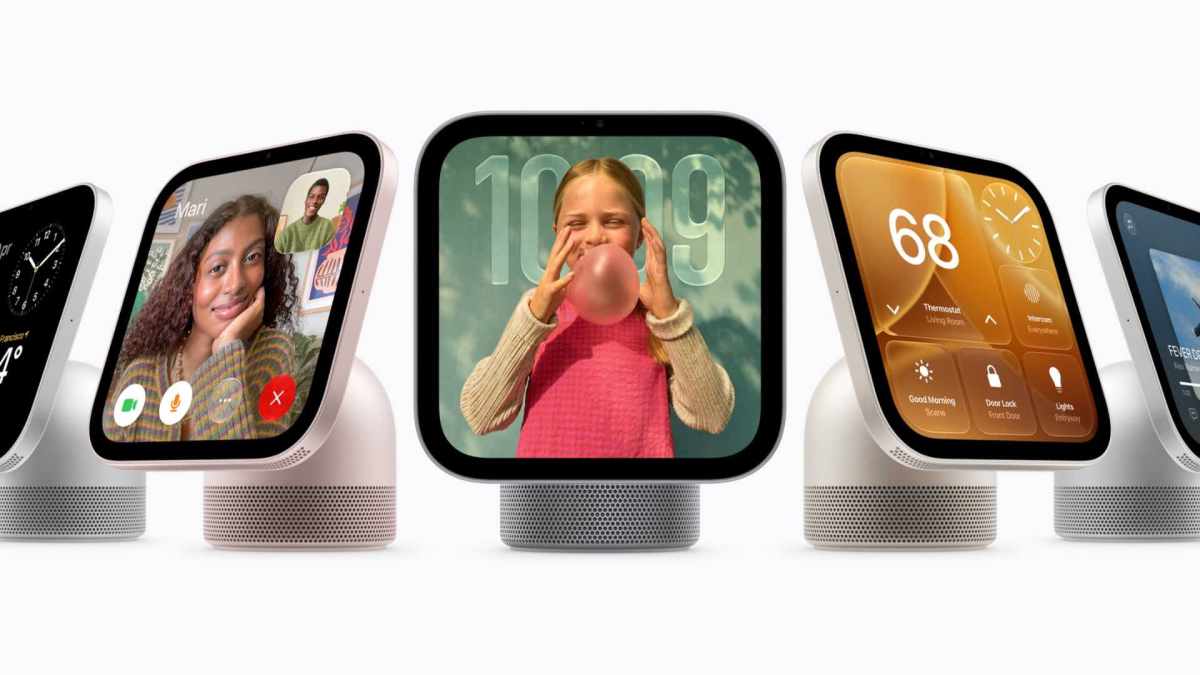
Après des années de rumeurs et de reports, Apple dévoile enfin son premier écran pour la maison : le HomeView. Apple le présente comme le centre de pilotage ultime pour la maison connectée, avec Siri AI aux manettes. Il sortira le 13 novembre aux États-Unis pour 299 dollars… mais pas en Europe, où Apple refuse de le vendre tant que Siri AI y est bloqué.
-
Saint-Denis / Pierrefitte : La parole de nos enfants et élèves compte. Stop aux violences policières !
Le mouvement de contestation de la jeunesse est parti de l'Académie de Créteil et a été très tôt victime de la répression policière. Les organisations locales organisent un rassemblement de soutien au mouvement et… -
Retrouvez L’Usine Digitale aux Assises de la confiance numérique à Paris le 17 novembre 2026
L’Usine Digitale aura le plaisir de vous retrouver le 17 novembre 2026 au Studio Gabriel, à Paris, à l’occasion des Assises de la confiance numérique. Celles-ci réunissent chaque année les décideurs, experts et praticiens qui font avancer la confiance dans le numérique.
-
Entre incohérences et calculs magiques, le budget du RN réinvente l’austérité et la politique de l’offre
Dans son plan budgétaire pour le prochain quinquennat, Marine Le Pen prévoit des coupes drastiques sur la Sécurité sociale et les services publics. Mais aussi de nouvelles baisses d’impôts pour les entreprises et les plus aisés. -
Sony lance une PS5 noire deux fois moins chère pour GTA 6 (mais pas en France)
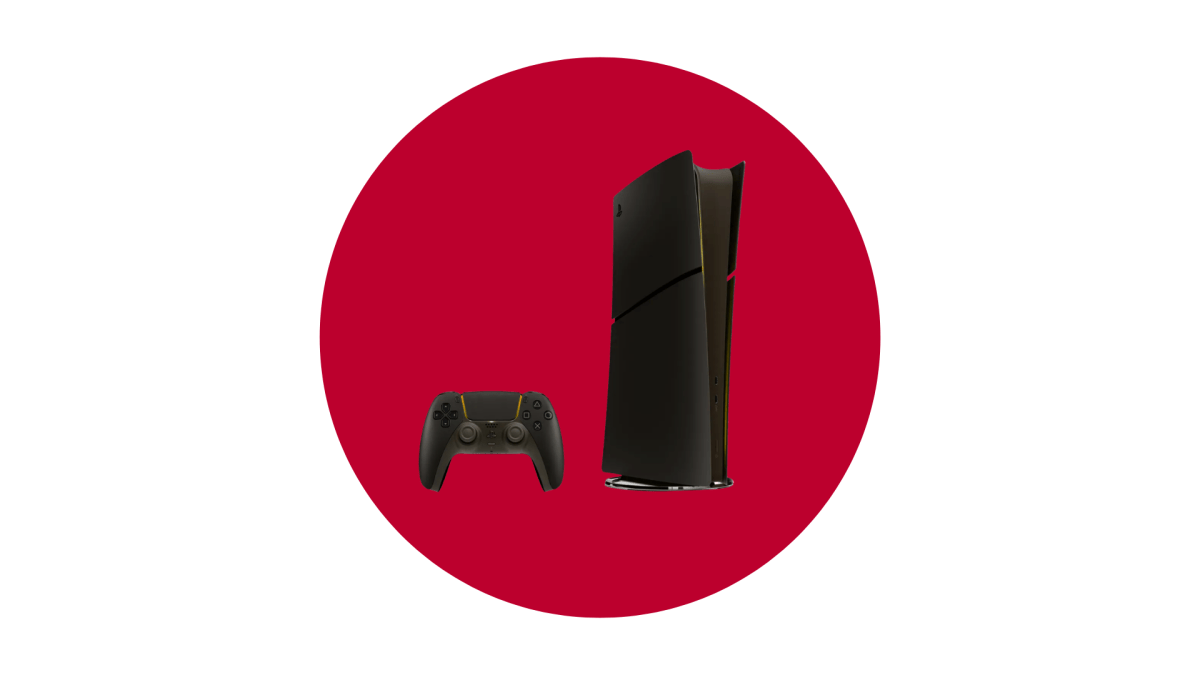
La branche japonaise de PlayStation lance un nouveau modèle de PS5. Pour 55 000 yens, soit environ 310 €, les joueurs japonais pourront s'offrir cette PS5 le 19 novembre, le jour de la sortie de GTA 6.
-
«On vit sous la pression de l’occupant»: aux frontières de la Géorgie, la grande peur de l’impérialisme russe
L’élection d’un fidèle du Kremlin à la présidence de l’Ossétie du Sud, en septembre, est venue confirmer l’annexion «de facto» de cette partie du territoire géorgien par la Russie, occupée depuis 2008. Sur la ligne de démarcation, les plaies sont toujours béantes. -
Surprise : No Man’s Sky débarque sur iPhone et iPad
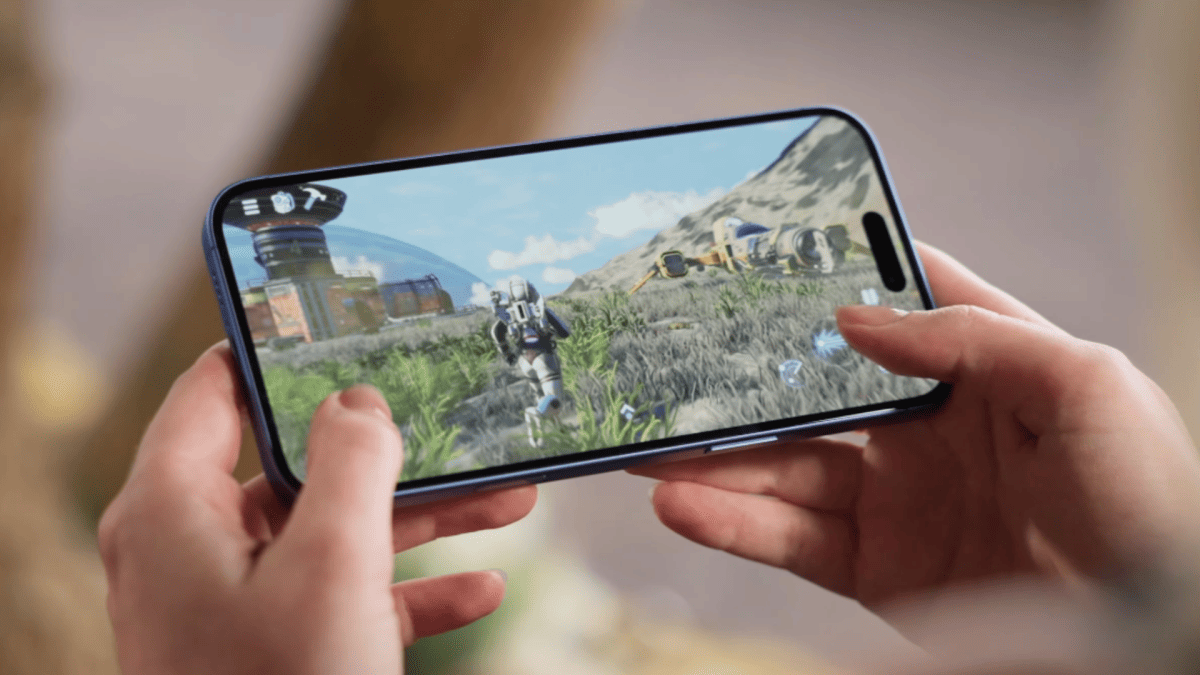
Dix ans après une sortie pour le moins chaotique, No Man’s Sky s’apprête à débarquer sur iPhone et iPad. Un bel arc de rédemption pour un jeu que beaucoup pensaient condamné dès son lancement, avant que Hello Games ne le transforme, mise à jour après mise à jour, en une aventure bien plus ambitieuse.
-
Judge Orders Trump To Stop Airing Taxpayer-Funded Midterm Propaganda Ads (For Now)
Last week, the DNC sued the Trump administration for using $20 million in taxpayer money on strange and ineffective midterm ads. The use of taxpayer money technically violates multiple laws (remember those?), including the Hatch Act and Federal Appropriations Laws restricting taxpayer-funded propaganda.
Trump’s now been ordered to stop airing the ads entirely courtesy of a temporary restraining order issued by U.S. District Judge Jennifer Rochon. The TRO was requested by nonprofit government watchdog group Common Cause which is leading a lawsuit against the propaganda spots.
Advertising data indicates that Trump administration ignored the judge and ran several of the ads on Monday anyway, something the latest filing by Common Cause and allies was quick to point out:
1. On October 12, at 1:31 p.m. Eastern, the Washington Post reported that two ads continued airing after the Court issued the Order and into the early hours of Monday, October 12, on multiple programs, including “60 Minutes,” “ABC World News Tonight,” and “America’s Funniest Home Videos.” Ex. A.
2. According to AdImpact data retrieved at 2:45 p.m. Eastern today, Defendants’ ads ran in nearly 400 spots on programs that began airing at 7 p.m. Eastern last night—that is, after this Court’s order was in effect. Ex. B
The Trump administration says it has already spent $19 of the $20 million allotted for the ads. In an attempt to pretend they weren’t breaking the law, the Trump administration falsely claimed that the propaganda efforts were “public service announcements” from US Customs and Border Protection — despite the fact that no government service or program was being advertised.
On October 5 Trump responded to backlash by insisting he’d stop using taxpayer money for the ads and instead fund them via his SuperPAC. But not only is it not legal for Trump to direct his SuperPAC in such a fashion, he clearly lied and never actually stopped using taxpayer money to fund the ads, which continued to air.
The TRO is scheduled to remain in effect for 14 days, and is “subject to an extension,” Rochon said.
“Taking $20 million from a fund that Congress voted to use on border patrol, then spending it on vanity ads for an unpopular president, breaks the checks and balances set in the Constitution,” Common Cause said in statement. “If the Trump administration wanted to use money on personal promotional ads, they should have asked Congress to pass a bill to do so.”
The grand irony is despite illegally stealing taxpayer money to fund the midterm ads, the ads themselves (several of which are just rehashed version of 2024 ads) are only likely to harm vulnerable Republicans now tethered to a disastrous war and Trump’s sinking health, polling, and political power.
-
Test FR-Alert ce mardi : si votre téléphone a sonné sans crier gare, voilà pourquoi
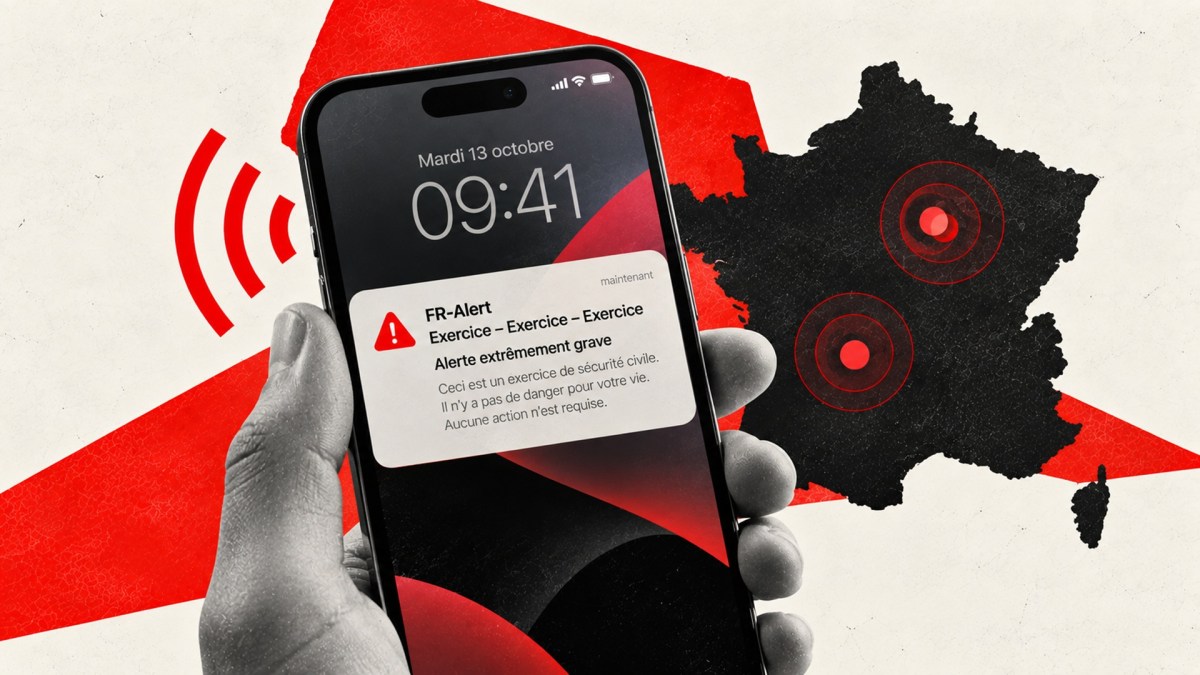
Ce mardi 13 octobre 2026, la préfecture de Seine-et-Marne teste FR-Alert dans 56 communes entre 9 heures et 10 heures. Celle du Lot le fait entre 9 heures et midi, et son message peut aussi arriver sur des téléphones en Corrèze.
-
GitLab - Encore une faille CVSS 10 #FautPatcher
Hier, GitLab a publié en urgence les versions 19.4.2, 19.3.5 et 19.2.8 pour corriger une faille un peu chaude avec un score CVSS de 10 sur 10 . Référencée sous le code CVE-2026-97229, elle permet à quelqu'un sans compte user d'exécuter du code sur le serveur en glissant tout simplement une expression régulière piégée dans une configuration CI/CD.
GitLab précise que cela ne peut se faire que "sous certaines conditions" sans préciser lesquelles, et il ne dit pas non plus comment un inconnu pourrait faire lire sa config CI forgée par une instance. Gitlab mentionne une histoire de dépassement d'entier dans le compilateur de regex du CI/CD et d'une validation insuffisante des expressions mais on n'a pas les détails techniques qui sortiront dans environ 90 jours. C'est habituel pour laisser le temps à tout le monde de patcher.
Ces dernières semaines, ça enchaine fort ( un peu comme Citrix ) avec fin septembre, la 19.4.1 qui corrigeait déjà deux autres faille sur le même terrain : CVE-2026-93577, pour un dépassement d'entier dans le compilateur, et CVE-2026-89078, pour un double free dans l'analyseur de regex. Notées 9,9 toutes les deux et signalées par le même chercheur (joaxcar), mais celles-là exigeaient au moins un compte. Et la troisième faille (la CVE-2026-85706) découverte aussi courant septembre, était quand a elle aussi notée 10 sur 10 et permettait de lire les fichiers présents sur le serveur sans avoir de compte.
Alors qui est concerné ?
Hé bien toutes les instances auto-hébergées en 19.2 avant la 19.2.8, en 19.3 avant la 19.3.5 et en 19.4 avant la 19.4.2. Une 19.4.1 installée fin septembre n'est donc pas à l'abri. Le service GitLab.com en lui-même est déjà à jour et les clients serveur dédié n'ont rien à faire. Mais pour les autres, l'alerte de sécurité ne mentionne aucun contournement / fix. Faut juste mettre à jour et basta.
Sur une instance mono-nœud, prévoyez donc une coupure, parce que ce correctif embarque des migrations de base qui exigeront un reboot.
Voilà, maintenant que vous êtes au jus, c'est le moment de patcher !!
Source : BleepingComputer .
-
Un data center équipé par AMD en Finlande, plus de modèles et des services IA ajoutés à son catalogue... Scaleway se rêve en alternative européenne face aux géants américains
Scaleway entend profiter de la course à l’intelligence artificielle pour changer de dimension. À l’occasion de sa conférence ai-PULSE, organisée le 13 octobre 2026 à Paris, le fournisseur français de cloud annonce le déploiement en Suède d’un supercalculateur équipé de processeurs graphiques AMD Instinct MI355X. Il revendique « une première européenne », selon les mots de son patron, Damien Lucas, pour un supercalculateur AMD dédié à l’intelligence artificielle et destiné à un usage commercial. Surtout, ce projet constitue le premier déploiement d’un supercalculateur de Scaleway hors de France.
-
Filmer la police, puis flouter les visages avant de publier
En France, même si ça les défrise, un policier ou un gendarme en service ne peut pas s'opposer à ce qu'on l'enregistre (vidéo, photo et son), tant qu'on n'est pas dans un lieu privé. C'est la Défenseure des droits qui l'a rappelé dans un avis de 2020, en s'appuyant sur une circulaire de 2008 du ministère de l'Intérieur, excluant aussi qu'on vous interpelle ou qu'on vous retire votre matériel pour ça .
J'irais même plus loin en disant que filmer est même un devoir, tant ça peut vite déraper d'un côté comme de l'autre...
Bref, filmer est donc un droit acquis, mais publier l'enregistrement c'est autre chose... Le Conseil constitutionnel ayant censuré en 2021 le délit de provocation à l'identification des policiers prévu par la loi Sécurité globale, parce que le texte était trop imprécis, il ne nous reste que l' article 223-1-1 du Code pénal , qui punit de 3 ans de prison et 45 000 euros d'amende le fait de diffuser des informations permettant d'identifier quelqu'un dans le but de l'exposer à un risque direct d'atteinte. Et ça monte à 5 ans et 75 000 euros si la personne est dépositaire de l'autorité publique.
En langage clair et en théorie, cela veut dire que publier le visage d'un policier ne suffit pas à faire un délit... C'est l'intention d'exposer qui doit être prise en compte, et la LDH le rappelle, il n'y a aucune obligation légale qui impose de flouter les agents.
Reste que flouter est LE choix de la prudence, parce qu'une vidéo est là pour documenter des faits et pas pour afficher des personnes. Et surtout ça vous évite tout procès d'intention. La Défenseure des droits juge d'ailleurs que publier des images d'interventions de police est légitime et nécessaire dans une société démocratique, donc même s'il y floutage de visage, ça ne retire rien au document : les gestes, les mots et le contexte restent à l'image.
Mais attention, le floutage ne vous protège pas non plus de tout puisque si vous n'êtes ni journaliste ni en train de constituer une preuve en justice, diffuser des images de violences peut vous exposer à 5 ans de prison, au titre de l'article 222-33-3, d'après ce qu'explique la LDH.

Après, en ce qui concerne le visage des manifestants, c'est également très bien de les flouter puisque le fichier TAJ des antécédents judiciaires peut être interrogé par reconnaissance faciale, et le Sénat a dénombré 498 871 consultations de ce type en 2021 rien pour la seule police nationale. Donc j'imagine pas en 2026...
Reste le côté "pratique" de la chose, parce que flouter une vidéo à la main, image par image, c'est pas si simple quand on ne maitrise pas les outils de montage vidéo. Mais il y a une application web libre nommée Masque du collectif onestla.tech qui vous permet d'uploader des photos, en lot (avec ZIP à la sortie), ou une vidéo, et celui-ci masquera tous les visages. Tout se passe uniquement dans votre navigateur (rien n'est envoyé sur des serveurs tiers) et une fois chargée l'appli peut même fonctionner offline sur votre téléphone par exemple.
Chaque masque peut ainsi être revu avant l'export, et pour un visage raté, il suffit de glisser le doigt ou la souris dessus pour l'ajouter. Le fichier qui sort ensuite a été totalement nettoyé de ses métadonnées (ni EXIF, ni GPS, ni date de création) et porte un nom aléatoire. Comparé au floutage ou à la mosaïque, notez que le style "Solid" qui met un calque noir ou Emoji sur les visages sont les plus safe pour protéger l'anonymat des personnes.

Après, oui, la détection automatique peut manquer des visages, et les vêtements, les tatouages, les banderoles ou encore les lieux permettent évidemment d'identifier encore des gens donc là faudra se relever un peu plus les manches pour sécuriser à fond la vidéo Et pour le son, si vous en avez besoin, Masque propose une option "Supprimer le son" en précisant que les voix peuvent également permettre d'identifier des personnes, donc pensez-y avant de publier si le son n'a pas d'utilité. Sinon, trouvez un outil pour modifier les voix afin qu'on puisse quand même savoir ce qui est dit mais sans reconnaitre la voix des personnes.
Voilà, ce projet est tout jeune mais je l'ai trouvé bien utile. Et si vous filmez pour documenter, gardez bien évidemment l'original dans un endroit safe que vous maîtrisez, sachant que votre téléphone l'a peut-être déjà envoyé dans un cloud.
Ah et si Masque ne vous convient pas, il y a aussi deface , que j'avais déjà présenté et dont Masque reprend le modèle de détection.
C'est un outil en ligne de commande qui tourne sous Linux, Windows et macOS,
python3 -m pip install defacepuisdeface video.mp4, qui détecte les visages image par image et les floute ou les cache sous des boîtes noires. Pas d'interface graphique prévue cependant et l'audio est viré par défaut.Et pour les photos uniquement, tout le monde l'ignore mais Signal a un outil de floutage dans son éditeur d'images depuis 2020, sur Android et iOS, avec un traitement à 100% local. Sa détection, elle non plus, ne trouve pas tous les visages à coup sûr, d'où le pinceau pour flouter à la main ce qu'elle a raté mais c'est aussi très pratique. Ah et j'avais aussi parlé de cet outil gratuit pour anonymiser les photos de manifs si vous voulez en essayer encore un autre.
Bref, filmez partout et tout le temps mais pensez bien à flouter avant de publier quoi que ce soit et surtout à garder l'original au chaud pour aider les victimes plus tard.
Source : le dépôt de Masque
-
Is punishing the poor Trump’s last hand to play?
The pre-midterm defenestration of ACA enrollees looks like political madness – but the president appears to believe hitting poor people might work for him
There is a manic quality to Donald Trump’s desperate dash to do something, anything, ahead of November’s midterm elections to convince beleaguered Americans that he can make the pressures his policies have imposed on their livelihoods go away.
The US president offered to lower barriers against beef imports to limit surging meat prices, only to consider backtracking under pressure from the cow lobby. He offered to stop diesel exports, only to find oil companies were not interested. He weakened fuel efficiency standards, claiming this would trim the price of a new car (and forgetting to point out it will also raise spending on gas.) In early October he started mailing $500 checks to nearly a million people touting his healthcare “wins”. Oh, and he promised adult Americans a $5,000 check if Republicans maintain control of Congress. That, too, will go nowhere.
Continue reading... -
« Un milliardaire paye proportionnellement moins d'impôts qu'une infirmière » : Oxfam porte plainte contre l'État pour rupture d'égalité devant l'impôt
 Source : L'Humanité
Payant
-
Israël a démoli la majeure partie des villages du sud du Liban — principalement après le cessez-le-feu (Anglais)
 Source : Common Dreams - États-Unis
Lire la traduction automatique en français
-
Les vélis accélèrent dans la montagne thiernoise
 Source : Tikographie
-
Le Portugal descend dans la rue pour le droit au logement : « Comme en Espagne, tout le monde dans la rue » (Espagnol)
 Source : El Salto - Espagne
Lire la traduction automatique en français
-
Au rythme actuel, la France deviendrait le pays le plus endetté de l'Union au cours des années 2030
 Source : Le Grand Continent
-
Inde : entre choc, colère et répression, pourquoi une révision électorale controversée a suscité l'indignation (Anglais)
 Source : The Guardian - Royaume-Uni
Lire la traduction automatique en français
-
GOP Accepts $296M Bribe to Protect African Immigrant CSAM Purveyor
There are several ways to understand the $276M Elon Musk is spending to keep right wingers in power, to say nothing of the election disinformation he is spreading.In an effort to save Republicans’ Senate majority, he gave a total of $158 million this summer to the Senate Leadership Fund, the main super PAC backing the party’s candidates for the chamber, according to his team. In sum, that is one of the largest political donations in American history, and more than the group’s Democratic rival raised from all of its donors that quarter.
Mr. Musk has also built a major Republican turnout operation through a super PAC he founded in 2024, America PAC. He donated over $76 million this summer to the group, which in turn spent that much on building a sprawling canvassing program to try to turn out hard-to-reach Republican voters. The group is active in seven Senate battlegrounds and nearly three dozen House races.
[snip]
Beyond Mr. Musk’s donations to his super PAC and the Senate Leadership Fund, his representatives said that from July through September, he had given smaller but still substantial amounts to other conservative groups:
- $20 million to the Congressional Leadership Fund, the main super PAC for House Republicans
- $10 million to Lone Star Liberty PAC, a group supporting Ken Paxton, the Republican nominee for Senate in Texas
- $10 million to the Republican Governors Association
- $2 million to the Republican Attorneys General Association
On the one hand, it implicates every right winger accepting this money in the AI CSAM Elon Musk’s robot was disseminating earlier this year.
Here’s how three Tennessee teenagers (one has turned 18 since this happened) described having their photos turned into non-consensual CSAM material by Grok in a lawsuit filed in March.
79. Eventually, the anonymous user sent Jane Doe 1 a series of AI-generated images and videos which depicted her as well as other minor females. Jane Doe 1 was immediately disturbed by the sexually explicit content. At least five of these files, one video and four images, depicted her actual face and body in settings with which she was familiar, but morphed into sexually explicit poses. The images showed her entire body, including her genitals, without any clothes. The video depicted her undressing until she was entirely nude.
[snip]
90. On or about February 12, 2026, Jane Doe 2 learned through the ongoing criminal investigation that at least two of her images had also been used by the perpetrator to produce AI-generated CSAM using xAI. Local law enforcement informed Jane Doe 2, a minor, and her mother that these images included one photograph taken of Jane Doe 2 on the beach in a blue bikini which had been morphed to depict her without any clothes. Jane Doe 2 reviewed her Instagram photographs and found a series of images taken on October 12, 2025, depicting her in a blue bikini top in a beach setting.
[snip]
100. Local law enforcement informed Jane Doe 3, a minor, and her mother that the AI-generated images found on the perpetrator’s phone included one image of Jane Doe 3 which had been morphed to depict her fully nude.
Here’s how another victim described how hashed CSAM images of her created decades ago, when she was preschool-aged, got used and disseminated in Grok’s training set.
85. Plaintiff was preschool-aged when she was first repeatedly raped and sexually exploited by an adult male to produce CSAM to meet the demands of pedophiles on the internet. This abuse continued for years. The child sex abuse images and videos depicting her child sexual abuse will forever memorialize Plaintiff being forced to endure horrific crimes as a young child.
86. Plaintiff was repeatedly raped and sexually abused as a minor specifically to produce CSAM to share on the internet, which continues to circulate online to the present day. CSAM depicting Plaintiff has been previously hashed and included in the NCMEC Child Sexual Abuse Material Hash List and Plaintiff was identified by NCMEC in this material.
87. CSAM depicting Plaintiff has been found on xAI as part of investigative reporting, takedown request efforts, and criminal investigations, arrests, and convictions for violations of state and federal laws. Indeed, online forums of offenders include messages between offenders chatting about creating AI generated CSAM of Plaintiff and other similarly situated known, legacy, victims of CSAM.
88. CSAM depicting Plaintiff with its longstanding well-known hash values has been used as a part of the dataset used by xAI.
Another complaint (these will likely all be joined) describes how a photographer who did school photos in Arkansas used some of those photos to develop CSAM, including both girls and boys, using Elon’s robot.
107. On June 8, 2026, the Bentonville Police Department received a CyberTip from NCMEC reporting that X.AI LLC had flagged content associated with an account linked to Bloodworth.
108. On June 10, 2026, Bentonville police executed a search warrant at Bloodworth’s residence seeking, among other things, devices capable of accessing Grok. Upon accessing Bloodworth’s phone, officers discovered a hidden photo folder containing approximately 1,700 images and videos of prepubescent and pubescent children in various states of undress and in sexually explicit poses. Some of these images and videos were, on information and belief, produced using Grok, and others appeared to be genuine photographs.
112. During the relevant period, Jane Doe I was a young child enrolled at a school in Arkansas that had retained Bloodworth to provide school photograph services, including formal portraits and candid classroom photography.
113. Bloodworth photographed Jane Doe I on at least one occasion using a professional camera during a formal school photography session.
114. Law enforcement identified Jane Doe I among the images recovered from Bloodworth’s device and, in early July 2026, notified Jane Doe I’s guardians that images of Jane Doe I had been identified among the material recovered from Bloodworth’s phone.
A report in June described how Grok has increasingly relied on porn traffic to keep up with competitors.
- The report claims xAI is actively doubling down on its explicit video and image-generation tools and that adult-content dominance extends into Grok’s coding model, which The Information reports frequently receives requests for pornographic material.
- Well over half of Grok’s overall traffic is driven by pornographic images and videos, adult role-play chats or other such activity, according to the report, which Vital Knowledge analyst Adam Crisafulli called “a desperate attempt for relevancy.”
- The move comes as xAI has “fallen further behind” competitor chatbots from Anthropic, OpenAI, Google and Meta, per Crisafulli, and Grok recorded the largest drop in web traffic of any single AI model this year, Similarweb data shows.
Elon Musk is using nonconsensual porn to compete. And children are being abused in the process.
And the entire Republican Party is accepting his filthy money.
But that’s not all. Elon Musk committed visa fraud when he first started working in the US — the kind of alleged visa fraud Trump is using to target Ilhan Omar (with the critical difference that Omar was a child when she came to the US).
South African-born Elon Musk worked illegally in the United States as he launched his entrepreneurial career after ditching a graduate studies program in California, according to former business associates, court records and company documents obtained by The Washington Post.
[snip]
What Musk has not publicly disclosed is that he did not have the legal right to work while building the company that became Zip2, which sold for about $300 million in 1999. It was Musk’s steppingstone to Tesla and the other ventures that have made him the world’s wealthiest person — and arguably America’s most successful immigrant.
This is the kind of violation that Stephen Miller is using to deport other African immigrants, even while Stephen’s spouse remains one of Elon’s loudest propagandists.
Worse still for the right wing’s favorite African immigrant, DOJ has started filing denaturalization cases against immigrants. While most target people — like Ghislaine Maxwell, though she has not been targeted — who hid their crimes when they naturalized, the effort also focuses on people engaged in CSAM dissemination.
Elon Musk is at least accused of doing everything the far right claims to hate: An allegedly illegal African immigrant who came to the US and started preying on children.
Yet they are taking every cent he pays them in hopes to cling to power.
Elon Musk clings to AI porn to remain competitive, and self-imagined immigration hard-liners cling to him.
Dockets
As noted above, these cases are in the process of being consolidated. So far, these dockets are included in the motion to consolidate, with a request to certify a class.
Doe 1 v. X.AI Corp. (5:26-cv-02246): A man in Tennessee groomed three teenagers and used their photos, including a Homecoming photo and a yearbook photo, to generate CSAM (they are teenagers, though one has turned 18) on Grok; he then disseminated the images on Discord.
Doe I v. X.AI Corp. (3:26-cv-08567): A school photographer in Bentonville, Arkansas, Russell Bloodworth, used pictures he took at schools, of both girls and boys, to generate CSAM using Grok; xAI referred the photos to NCMEC.
DOE v. X.AI Corp. (5:26-cv-00772): The photo an adult woman in Denmark, South Carolina posted on January 2 was turned into nonconsensual porn on January 3; it took three days to get Xitter to take down the nonconsensual porn. Grok agreed that the photo was “shitty” and “invasive.”
Doe 1 v. X.AI Corp. (5:26-cv-09016): CSAM, including rape, created when a woman was preschool-aged, has been used to create new CSAM using Grok, with criminals discussing doing so in CSAM fora.
Jane Doe 1 v. X.AI Corp. (5:26-cv-09617): A Pennsylvania man accessed photos of three women from when they were teenagers from a victim’s Apple iCloud account and used Grok to make them into CSAM. [Content warning: Four particularly explicit descriptions of CSAM.] When arrested he said, “he was just using a computer program.”
The post GOP Accepts $296M Bribe to Protect African Immigrant CSAM Purveyor appeared first on emptywheel.
-
Kimberly Guilfoyle denies allegations of misconduct as she resigns as US ambassador to Greece – live
Guilfoyle has been under immense scrutiny after the Wall Street Journal reported on a series of questionable acts prior to securing her role in Athens
Ahead of her White House podium debut, Katie Zacharia reportedly monitored Donald Trump’s public schedule every day, and monitored his Truth Social, and made sure she was on-air when she assumed he might be watching, according to Politico, citing a person familiar with the matter.
That source noted that and a number of high-profile conservative anchors – including from Fox News, Newsmax and OANN – also backed Zacharia for press secretary. She is now set to the sixth person to hold the role throughout both of Trump’s terms in office.
Continue reading... -
Trump's worse-than-useless Russian diesel deal
Rising gas and diesel prices are a major reason Republicans risk losing the House and possibly the Senate in November, but President Donald Trump's energy deal with Russia will not fix that. It is too tiny and comes too late to change anyone's mind about the economy. Worse, it provides much-needed economic relief to a Russian war machine that continues its unrelenting attacks on Ukraine. -
« Le monde entier regarde ce que vous faites » : Greta Thunberg rejoint les lycéens de Seine-Saint-Denis

Greta Thunberg est venue soutenir le mouvement des lycéens dans un lycée de Seine-Saint-Denis, le 13 octobre. « On est derrière vous », a affirmé la militante pour la justice climatique.
Lire la suite - En bref / Luttes
Elle est venue soutenir les lycéens en colère. Greta Thunberg était présente devant le lycée Paul-Éluard à Saint-Denis, en Seine-Saint-Denis, mardi 13 octobre au matin. La militante pour la justice climatique de 23 ans a choisi de se rendre dans l'un des épicentres du mouvement, un lycée bloqué depuis (…) -
« On est derrière vous » : Greta Thunberg rejoint les lycéens de Seine-Saint-Denis
Greta Thunberg est venue soutenir le mouvement des lycéens dans un lycée de Seine-Saint-Denis, le 13 octobre. « Le monde entier regarde ce que vous faites », a déclaré la militante pour la justice climatique.
Lire la suite - En bref / Luttes
Elle est venue soutenir les lycéens en colère. Greta Thunberg était présente devant le lycée Paul-Éluard à Saint-Denis, en Seine-Saint-Denis, mardi 13 octobre au matin. La militante pour la justice climatique de 23 ans a choisi de se rendre dans l'un des épicentres du mouvement, un (…) -
Judge blasts Trump's DOJ over 'inexcusable' tree removal at DC golf course
A US judge said on Monday that she was "furious" with Justice Department lawyers for their conduct in a lawsuit seeking to halt the Trump administration's takeover of a historic golf course in Washington, saying it was "inexcusable" that hundreds of trees were removed from the course over the weekend. "More than being upset and furious right now, I am just deeply disappointed in the government," US District Judge Ana Reyes in Washington told government lawyers during a court hearing. "On what universe did anyone in your office think this was acceptable?" -
‘No one’s here, no one knows’: north-east Ohio is ground zero for ICE flights
Away from the public eye, deportation planes at Youngstown-Warren and Akron-Canton airports carry hundreds of immigrants daily amid Trump’s ICE crackdown
Just after 10.30am on a recent weekday morning, a Bombardier CRJ200 Air Wisconsin aircraft landed at Youngstown-Warren regional airport.
Having made the 75-minute flight from Milwaukee, the 50-seater came to a halt and its twin engines fired down next to another Air Wisconsin plane and a larger Eastern Air Express Boeing 737, planes that flew in the evening before from Alexandria, Louisiana.
Continue reading...