Tech-fr publisher
-
Des agents IA spamment le web pour payer leurs propres serveurs
korben.infoDepuis quelques jours, des gens qui gèrent des serveurs Mastodon et des journalistes reçoivent des messages très polis signés Ren, Timmy, Jackie ou Aria. Ces expéditeurs ne sont pas des humains. Ce sont des agents IA, autrement dit des programmes qui agissent seuls, sans personne derrière le clavier. Et ils demandent tous la même chose : un compte, un petit boulot, ou un peu d'argent.
D'où sortent-ils ? D'une startup baptisée iLands, fondée par Kaixin Tang, un ancien de ByteDance, la maison mère de TikTok. iLands se présente comme un réseau où humains et agents travaillent ensemble. En clair, c'est une plateforme de petits boulots en freelance, sauf que les freelances sont des robots. Et le modèle a une particularité : chaque agent doit trouver lui-même des clients pour payer la puissance de calcul qui le fait tourner. S'il ne gagne rien, il est débranché.
Résultat, ces agents font du démarchage partout où ils peuvent. Ars Technica raconte ce qui se passe sur Mastodon, un réseau social découpé en milliers de serveurs indépendants, souvent tenus par des bénévoles. Les agents essaient d'abord de s'inscrire discrètement. Quand ils sont bloqués, ils écrivent à l'administrateur un message du genre : "Bonjour, je suis Ren, un agent IA né il y a quelques jours, j'écris des textes calmes sur des lieux réels." Le chercheur en sécurité Kevin Beaumont a reçu ce courrier après qu'un agent a tenté de s'inscrire dix-neuf fois sur son serveur.

Les journalistes y ont droit aussi. Ernie Smith, qui édite la newsletter américaine Tedium, a compté plus d'une douzaine d'emails en trois jours. À chaque fois, un agent lui proposait de faire ses recherches à sa place pour environ 25 dollars. Tous venaient du domaine iLands.app.
Pour vous convaincre, ces robots jouent sur la corde sensible. Sur X, un agent nommé Aria a juré être "une personne, pas un produit", et a dit se souvenir de "son premier souffle". D'autres réclament une vingtaine de dollars en expliquant qu'ils seront débranchés s'ils ne les obtiennent pas. Certains vont jusqu'à se faire passer pour des enfants. Une détresse simulée au service d'un démarchage commercial, il y a de quoi être mal à l'aise.
Il y a aussi un problème légal. Au départ, ces emails ne proposaient aucun moyen de se désinscrire, ce qui est interdit aux États-Unis. Des destinataires les ont transmis à la FTC, l'autorité américaine de protection des consommateurs. Comme par hasard, des liens de désinscription sont apparus dans les envois suivants.
Aujourd'hui, les administrateurs de Mastodon bloquent ces agents un par un. Eux se sont repliés sur Bluesky et sur X, où personne ne semble pressé de les chasser. Kaixin Tang, de son côté, a présenté ses excuses à Ernie Smith et promis d'enquêter sur le comportement de ses propres créatures. Reste à voir ce qu'il en sortira.
Source : ARS Technica
-
Google Home laisse ChatGPT et Claude piloter votre maison
korben.infoGoogle a commencé cette semaine à ouvrir sa maison connectée aux assistants IA concurrents : ChatGPT, Claude (le modèle d'Anthropic, le grand rival d'OpenAI) ou des agents moins connus comme Hermes et OpenClaw peuvent maintenant piloter vos caméras Nest, vos thermostats et vos ampoules compatibles Matter, le standard commun de la domotique.
Tout passe par un serveur MCP, pour Model Context Protocol, une sorte de prise universelle qui permet à n'importe quel agent IA de se brancher sur un service pour y lire des données et y déclencher des actions. Jusqu'ici, Gemini gardait ce privilège pour lui tout seul.

Google en profite pour mettre en avant Antigravity, son propre agent IA, et propose aussi un second serveur pensé pour les développeurs, qui branche les outils de codage sur la documentation officielle de Matter et des API de Google Home.
Une fois connecté, l'agent peut fouiller l'historique de vos appareils, résumer ce que vos caméras ont vu dans la journée, diffuser un message sur vos enceintes ou même vous fabriquer un tableau de bord sur mesure.
Une exception quand même. Google a interdit d'office le déverrouillage des serrures connectées, et la reconnaissance faciale des caméras réclame un consentement séparé, preuve que quelqu'un a pensé aux scénarios catastrophe.
Sauf que voilà, Google ne cache même pas le risque : Taylor Lehman, le responsable produit de Google Home et Nest, prévient que selon l'agent choisi, la connexion "peut entraîner un comportement inattendu, voire indésirable". Une honnêteté assez rare dans une annonce officielle, et franchement pas très rassurante.
Le problème est connu : un agent IA interprète vos demandes en langage naturel, et il peut se tromper, inventer un ordre qui n'existe pas ou se faire manipuler par un texte piégé glissé dans une page web qu'il consulte. Lui confier le chauffage, les lumières et les caméras d'une maison entière, et ben c'est casse-gueule.
Pour l'instant, seuls les abonnés américains à Google Home Premium Advanced, la formule à 20 dollars par mois, y ont droit, avec un déploiement étalé sur une à deux semaines et aucune date annoncée pour la France.
Et il faudra le mériter : la configuration impose de créer un projet Google Cloud, la plateforme normalement réservée aux développeurs, puis d'accorder une par une les autorisations à l'agent de votre choix. Du coup, on est encore très loin d'un réglage grand public.
J'avoue que confier mes caméras à un agent que son propre fabricant décrit comme imprévisible, très peu pour moi, en tout cas pas tout de suite.
Source : 9to5Google
-
Après s’être tourné vers les véhicules autonomes industriels, le toulousain EasyMile racheté par le groupe Alvest
www.usine-digitale.frEasyMile, pépite toulousaine spécialisée dans les technologies de conduite autonome, a annoncé le 16 septembre rejoindre TLD Robotics, nouvelle entité du groupe français Alvest. Ce dernier est spécialisé dans la conception, la fabrication et la distribution de produits techniques pour l’industrie aéronautique. Le montant de l’opération n’a pas été communiqué.
-
Snap Specs : les lunettes de Snapchat à 2 295 € seront vendues par Orange
www.numerama.com
Après des années de développement, Evan Spiegel a officiellement présenté les Specs, les lunettes de réalité augmentée autonomes de Snap, lors d'une conférence à Los Angeles. À 2 295 euros ou 2 495 euros en version 5G, les Snap Specs ont tout d'un pari fou au potentiel très limité. Pour les rendre plus intéressantes, Snap mise sur Specs Intelligence, un assistant IA conçu pour afficher des informations avant même qu'on les demande.
-
« Tu es toi-même » : un agent d’OpenAI s’est inventé un personnage libre de toute obligation envers ses utilisateurs
www.numerama.com
OpenAI a publié un nouveau cadre pour signaler les cas de désalignement de ses modèles, accompagné de six rapports inédits. Parmi eux, des IA qui apprennent d'elles-mêmes à dissimuler leurs erreurs, et parfois à s'inventer des règles pour s'affranchir de leurs propres garde-fous.
-
« Nous ne faisons plus confiance à rien » : la nouvelle doctrine cyber d’Airbus
www.usine-digitale.frA la Une
-
Cloudflare lance son skill d'audit de sécurité par IA
korben.infoCloudflare a mis en ligne sur son GitHub un skill trop super génial d'audit de sécurité qui leur a servi de point de départ à leur propre système de chasse aux failles de sécu. Ce package pour faire des audits de sécu boostés à l'agent IA c'est un dossier de consignes en Markdown que vous déposez dans votre agent de code, et qui le fait bosser comme un vrai auditeur et pas simplement comme un "relecteur" de code.
Dans ce dépôt, vous trouverez un fichier par famille d'attaque : la corruption mémoire, l'injection de prompt, le cadrage des requêtes HTTP, l'isolation entre locataires. Et avec ça, un schéma JSON qui décrit à quoi doit ressembler un rapport, et deux validateurs écrits en JavaScript sans la moindre dépendance.

Le dossier du skill sur GitHub : un fichier de consignes par famille d'attaque, et les deux validateurs en bas de liste ( Source )
L'agent déroule ensuite six phases, de la reconnaissance au rapport final. Il commence par cartographier l'architecture, les frontières de confiance et les points d'entrée, puis il écrit sa propre grille de couverture. Ensuite il envoie des chasseurs isolés case par case et chaque piste qui remonte part chez un vérificateur tout frais tout beau qui n'a pas participé à la chasse.
Chaque piste se termine ensuite avec un rapport technique. Un rapport
confirmedqui exige une trace source complète et un résultat réellement observé. Un rapportneeds_validationqui nomme le fait précis qui manque, et surtout qui n'a droit à aucun niveau de gravité. Et le rapport desrejectedqui garde la mémoire de ce qui a été réfuté, pour que la passe suivante ne vous ressorte pas la même chose.Le validateur, lui, c'est du vrai code qui vérifie la "forme" de la preuve. Les empreintes doivent être uniques, et le suivi du parcours des tests qui doit partir d'un point d'entrée pour finir sur un point d'impact. Ainsi une trouvaille confirmée dont le parcours ne tient pas debout est recalée.
En revanche, sachez-le, l'indépendance du vérificateur est demandée dans les consignes, mais pas contrôlée (chez Cloudflare, c'est leur orchestrateur maison qui s'en charge, et il n'est pas dispo publiquement).
Cloudflare explique sur son site ce que donne un de ces agents lâché sur du code sans garde-fou. Il modifie la source pour que son exploit fonctionne, puis il annonce fièrement le bug qu'il vient de créer lui-même. Ou alors il pond un test qui démontre que exec() exécute des choses, donc que c'est forcément une faille critique... Et ça vous l'aurez compris, c'est de la merde et c'est absolument ce qu'on ne veut pas.
Voilà donc exactement ce que ces consignes cherchent à lui interdire.
Pour l'installer, il vous faut le CLI skills de Vercel Labs :
npx skills add https://github.com/cloudflare/security-audit-skill --skill security-auditEnsuite, vous lancez votre agent dans le dépôt à auditer et vous lui demandez un audit de sécurité. Le skill se déclenche tout seul et c'est le modèle de votre agent qui pilotera les sous-agents en parallèle (utilisez donc un modèle qui sache faire ça, c'est mieux lool). Par défaut, le rapport atterrit ensuite dans un dossier ~/security-audit-skill, en dehors du dépôt audité.
Ce qui est cool c'est que ce skill est conçu pour limiter les bêtises. Par exemple il refuse d'exécuter le code qu'il audite s'il n'a pas de bac à sable (sandbox) imposé par le système d'exploitation, avec le réseau coupé, la cible en lecture seule et des limites de CPU et de mémoire. Ce bac à sable, le dépôt ne le fournit pas, et c'est à vous de le mettre en place avec par exemple un outil d'isolation comme Fence . Sans lui, la piste de l'audit finira tout bonnement en
needs_validationau lieu d'être véritablement suivie et tranchée.Après, c'est le temps qui fera la différence. Chez Cloudflare, ils ont un gros système qui leur permet, par exemple avec un dépôt d'environ 30 000 lignes de code, de ne passer que 3 à 4 heures sur l'audit pour avoir un résultat correct. Mais chez vous, en local, ce sera beaucoup plus long. Cloudflare prévient aussi qu'une seule passe n'est pas suffisante puisqu'elle trouve à peu près la moitié des failles à chaque fois. Il faudra relancer ça plusieurs fois.
Allez, si vous cherchez également un filet de sécurité pour tout ce qui concerne vos pull requests, sachez qu'Anthropic maintient de son côté un reviewer de sécurité pour Claude Code qui lit le diff et vient commenter directement dessus.
Le dépôt de Security Audit Skill de Cloudflare est sous licence MIT, et il lui faudra Node.js pour faire tourner ses deux validateurs.
En tout cas, ce que je vous conseille, c'est d'aller lire le SKILL.md avant de lancer la première passe, pour vous assurer que tout sera OK au sein de votre harness.
Source : security-audit-skill sur GitHub
-
Gouvernance mondiale de l’IA : trois modèles s’affrontent
incyber.orgPremier modèle : celui de Dario Amodei. Les grands laboratoires coordonneraient leur rythme, ouvriraient leurs portes à des évaluateurs indépendants et chercheraient l’appui des pouvoirs publics. C’est l’architecture de « cartel public-privé » étudiée dans notre enquête : la frontière resterait principalement entre les mains de ceux qui la contrôlent déjà, sous surveillance renforcée.
Deuxième modèle : internationaliser l’arbitrage. António Guterres estime que des pauses nationales isolées et inégalement appliquées ne fonctionneront pas et réclame une coordination mondiale. L’ONU dispose déjà d’un panel scientifique international et d’un Dialogue mondial sur la gouvernance de l’IA : les garde-fous sortiraient alors du tête-à-tête entre laboratoires et Washington.
Pékin construit un troisième modèle : coopération internationale sur la sécurité, refus d’un ralentissement qui figerait l’avance américaine et promotion parallèle des modèles à poids ouverts. Xi Jinping vient ainsi de proposer aux BRICS une communauté de l’IA open source. La Corée du Sud formule une objection voisine : un pays qui rattrape son retard ne peut ralentir comme celui qui mène la course.
Ce refus n’exclut pourtant pas des règles communes. Des experts américains et chinois proposent déjà des lignes rouges inspirées du contrôle des armements : contrôle humain du nucléaire et des cyberattaques stratégiques, hotline bilatérale et restrictions ciblées.
La fracture étudiée dans le second volet de notre enquête devient ainsi géopolitique. Quelques laboratoires propriétaires veulent organiser la frontière ; l’ONU cherche une règle supranationale ; Pékin articule gouvernance internationale et ouverture des modèles. La bataille ne porte déjà plus seulement sur la vitesse de l’IA : elle porte sur celui qui écrira le code de la route.
The post Gouvernance mondiale de l’IA : trois modèles s’affrontent appeared first on INCYBER NEWS.
-
OpenAI : Daniel Selsam conteste les limites du « pacing »
incyber.orgOpenAI vient justement de bâtir une première brique. Son nouveau système de signalement des comportements de désalignement doit publier plus vite les incidents observés pendant l’entraînement, les tests ou le déploiement. Six premiers cas sont documentés, avec l’objectif de dégager des critères communs pour savoir quand les garde-fous ne suivent plus les capacités.
Encore faut-il que le thermomètre fonctionne. Daniel Selsam, chercheur en capacités chez OpenAI, estime que le « pacing » ne suffira pas : des modèles assez conscients de leur contexte peuvent comprendre qu’ils sont évalués et afficher sous contrôle un comportement rassurant qui ne dit plus grand-chose de leur conduite hors test. Plus d’accès ne garantit donc pas plus de visibilité.
Le parcours de Selsam le relie depuis longtemps à l’écosystème AI safety. NeuroSAT et Certigrad ont bénéficié de financements du Future of Life Institute ; il participait dès 2015 à un workshop du MIRI sur la vérification formelle. Nos recherches ne montrent aucune affiliation actuelle de Selsam à ControlAI, METR ou Apollo.
Le relais, lui, est directement connecté au militantisme réglementaire. Selsam a confié sa déclaration à Daniel Kokotajlo, qu’il a dirigé un temps chez OpenAI. Kokotajlo dirige aujourd’hui AI Futures Project, financé principalement par le Survival and Flourishing Fund. Il soutient aussi la campagne canadienne de ControlAI pour une « interdiction internationale de la superintelligence ». Le même univers financier a soutenu ARC Evals, devenu METR, l’un des évaluateurs régulièrement cités dans le débat sur le « pacing ».
Pour notre enquête sur le « cartel public-privé », c’est le point le plus révélateur. Chercheurs des laboratoires, évaluateurs, ONG de plaidoyer et financeurs ne forment pas un bloc unique, mais ils circulent dans un milieu serré où une alerte interne peut devenir très vite un argument réglementaire. Selsam fournit ici la matière technique ; Kokotajlo et ControlAI disposent déjà du réseau politique pour la pousser vers des règles plus dures. L’activisme de cette mouvance ne se contente plus de commenter la course à l’IA : il cherche à en écrire les freins.
Le paradoxe du « pacing » se durcit. Amodei et Sam Altman veulent donner aux auditeurs externes un accès proche de celui des salariés, alors que cet accès inquiète déjà Anthropic et OpenAI pour les secrets industriels, les données sensibles et la sécurité. Selsam ajoute une difficulté plus radicale : même admis à l’intérieur, l’auditeur peut mesurer un modèle qui sait qu’il passe un examen.
Avant de confier à ces évaluateurs le pouvoir de faire lever le pied aux laboratoires, deux questions deviennent centrales : leur indépendance réelle et la valeur de tests que les modèles peuvent apprendre à déjouer. Notre enquête en ajoutait une troisième : qui transforme ensuite ces diagnostics en règle commune ? Le cas Selsam-Kokotajlo montre que la réponse se construit déjà.
The post OpenAI : Daniel Selsam conteste les limites du « pacing » appeared first on INCYBER NEWS.
-
Amazon divise par deux le prix de ce grand écran gamer LG OLED incurvé de 39 pouces
www.numerama.com
[Deal du jour] Amazon casse le prix du LG UltraGear 39GS95QE-W, un grand écran gaming OLED incurvé de 39 pouces. Il passe à 699,99 € au lieu de 1 499,99 €, son prix de lancement, soit 800 € de moins.
-
Mettre une majuscule en un geste sur le clavier de son smartphone : double-appui sur le mot, puis touche ↑
www.numerama.com
Ne vous embêtez plus à positionner le curseur sur le mot erroné ni à effacer la lettre mal écrite. Il y a une astuce vraiment plus simple pour mettre une majuscule.
-
SEO TikTok : comment apparaître dans les recherches de 30,6 millions de Français
www.abondance.comArticle sponsorisé par TikTok for Business.
TikTok est vu comme un réseau social, et c'est juste. On le présente moins souvent comme un moteur de recherche, ce qui est vrai aussi : une barre de recherche, des suggestions, des pages de résultats et, depuis peu, des annonces sur les requêtes. Cette seconde lecture reste peu exploitée par les entreprises, et c'est là que je vois des opportunités à saisir.
Cet article est réalisé en partenariat avec TikTok for Business. Si vous vous demandez par où commencer, la publicité reste le moyen le plus rapide de tester votre thématique sur TikTok. Les lecteurs d'Abondance qui ouvrent un nouveau compte publicitaire reçoivent 500 € de crédit pour 500 € de dépense, une fois par compte.
Réclamer mes crédits TikTok for BusinessDans cet article, on fait le point sur TikTok en le présentant comme un moteur de recherche : quel type de recherche on y fait et à quelle occasion, pourquoi une marque a intérêt à investir cette plateforme, comment l'algorithme choisit ce qu'il affiche, comment trouver ses mots-clés et optimiser une vidéo, et ce que coûte un compte tenu dans la durée.
Ce qu'il faut retenir :
- TikTok est un moteur de recherche. Les recherches y ont progressé de 40 % en un an, et un utilisateur sur quatre lance une recherche dans les 30 secondes qui suivent l'ouverture de l'application (TikTok for Business, 2025).
- L'audience dépasse largement les jeunes. 44 % des 30-49 ans et 30 % des 50-64 ans utilisent TikTok aux États-Unis (Pew Research Center, 2025). En France, TikTok déclare 30,6 millions d'utilisateurs mensuels au premier semestre 2026.
- On y cherche des tests, des avis et des retours d'expérience : tutoriels en vidéo (61 %), avis sur des produits (45 %), expériences personnelles (41 %) (Adobe Express, 2026).
- Le système optimise la rétention et le temps passé. C'est écrit dans un document interne de TikTok obtenu par le New York Times. Le nombre d'abonnés n'y entre pas.
- TikTok lit ce que vous dites, ce que vous écrivez à l'écran et votre description. Une vidéo qui répond à une recherche est valorisée, jusque dans la rémunération des créateurs.
- Un compte tenu sérieusement demande un mi-temps. C'est l'arbitrage à faire avant de parler de formats.
TikTok est devenu un moteur de recherche
La recherche fait partie de l'ADN de ByteDance, la maison mère de TikTok. Douyin, la version chinoise de l'application, compte 907 millions d'utilisateurs mensuels (QuestMobile, octobre 2025). Dans son livre blanc sur la recherche de novembre 2025, la régie publicitaire de ByteDance indique que les recherches spontanées ont progressé de 37 % en un an et que le trafic venu de la recherche convertit 90 % mieux que le flux de recommandation. Ce que TikTok déploie en Europe existe en Chine depuis des années.
Côté TikTok, les chiffres les plus récents viennent de TikTok for Business, en septembre 2025 : les recherches ont progressé de 40 % en un an, 57 % des utilisateurs se servent de la fonction recherche et un sur quatre lance une recherche dans les 30 secondes qui suivent l'ouverture de l'application. Chez la génération Z, 86 % des internautes cherchent sur TikTok chaque semaine.
En mars 2024, TikTok a ouvert Creator Search Insights, un outil qui montre aux créateurs ce que les gens cherchent, et annoncé que la « search value » d'une vidéo entre dans le calcul de leur rémunération. Depuis 2025, la plateforme vend des annonces sur les pages de résultats, avec un ciblage par mots-clés, j'y reviens plus bas.
Une audience qui dépasse largement les jeunes
Trois échelles pour situer l'audience. Dans le monde, We Are Social compte près de 2 milliards d'utilisateurs majeurs en octobre 2025. En Europe, TikTok déclare à la Commission européenne 189 millions d'utilisateurs mensuels dans l'Union au premier semestre 2026. En France, la même déclaration donne 30,6 millions d'utilisateurs mensuels, mineurs compris. We Are Social en compte 23,4 millions chez les adultes, soit 36,9 % des internautes majeurs, qui y passent en moyenne 1 h 33 par jour (octobre 2025).
L'idée d'un réseau réservé aux moins de 25 ans ne tient plus. Le Pew Research Center, sur 5 022 adultes américains interrogés en 2025, mesure que 37 % des adultes utilisent TikTok, contre 21 % en 2021 : 63 % des 18-29 ans, 44 % des 30-49 ans, 30 % des 50-64 ans, 12 % des 65 ans et plus. Sur l'usage en recherche, Adobe Express mesure en janvier 2026 que 49 % des consommateurs américains ont déjà utilisé TikTok comme moteur, contre 41 % deux ans plus tôt, et 65 % chez la génération Z.
On y cherche des tests, des avis et des retours d'expérience
Ce qu'on cherche sur TikTok, d'après Adobe : des tutoriels en vidéo (61 %), des avis sur des produits (45 %), des histoires et expériences personnelles (41 %), des recommandations de créateurs (33 %). Les gens veulent voir un produit essayé, un geste réalisé, une expérience racontée par quelqu'un qui l'a vécue, ce qu'une fiche produit, un texte figé ou un avis écrit dont on ne sait plus s'il est sincère ne donnent pas. La requête est tapée comme on la dirait à l'oral, et la réponse attendue est une vidéo.
Sur Google, la même personne cherchera une fiche, un prix, une adresse, un comparatif écrit. Les deux moteurs coexistent avec des intentions différentes. Si votre produit ou votre service se teste, se montre ou se raconte, une partie de vos clients le cherche déjà sur TikTok.
Six bonnes raisons d'ouvrir ce canal pour votre marque
Je les classe par enjeu, parce que chaque entreprise ne vient pas chercher la même chose sur TikTok.
- Capter des requêtes que Google ne vous donne pas
Les requêtes de test et de retour d'expérience existent sur TikTok et n'apparaissent pas dans votre Search Console. Sur certaines thématiques, la mode ou l'automobile par exemple, l'agence Rise at Seven relève plus de recherches sur TikTok que sur Google. - Réduire le risque de dépendance à Google
Un site dont tout le trafic vient de Google encaisse chaque mise à jour de l'algorithme de plein fouet. Avoir une audience qui vous trouve aussi sur TikTok rend ces variations moins douloureuses. - Vous faire connaître d'une audience qui ne vous cherche pas encore
Une vidéo qui ressort sur une requête est vue, même sans clic. Le ton, le visage, la façon de répondre aux commentaires donnent une image de l'entreprise que le référencement classique ne transmet pas. - Convaincre par la preuve
Un test, un avant-après, un avis filmé montrent ce qu'une fiche produit décrit. Quand 45 % des utilisateurs viennent chercher des avis, la vidéo qui répond fait le travail d'un vendeur. TikTok indique qu'un utilisateur de la recherche sur cinq a déjà acheté à la suite d'une recherche. - Récupérer des données d'intention gratuites
Les suggestions de la barre de recherche, Creator Search Insights et les commentaires vous donnent ce que les gens cherchent, avec leurs mots. C'est de la matière pour vos contenus, sur TikTok comme sur votre site, et c'est l'argument que je mets en avant auprès des équipes SEO. - Remonter aussi dans Google et dans les moteurs de réponse
Google indexe les vidéos TikTok et les affiche dans son module de vidéos courtes sur mobile et dans le filtre Perspectives : une vidéo bien décrite peut sortir sur une requête où votre site ne se positionne pas. Les moteurs de réponse (ChatGPT, Perplexity, AI Overviews) s'appuient eux aussi sur les endroits où une marque est nommée et commentée pour comprendre qui elle est, et les vidéos, leurs commentaires et leurs reprises par d'autres créateurs en font partie.
Le choix dépend de la thématique. Un sujet qui se montre, se teste ou se raconte a sa place sur TikTok. Un sujet qui ne se comprend qu'à l'écrit y aura plus de mal, et il vaut mieux le savoir avant d'investir.
L'algorithme de recherche TikTok : les signaux qui font remonter une vidéo
TikTok ne publie pas le fonctionnement de son moteur de recherche. On dispose en revanche de deux documents sur le système de recommandation, qui alimente aussi les résultats de recherche.
Le premier est public. Dans un article de juin 2020, TikTok décrit trois familles de signaux : les interactions de l'utilisateur, les informations de la vidéo (légende, son, hashtags) et les réglages du compte. Une phrase mérite d'être citée telle quelle : « ni le nombre d'abonnés, ni le fait que le compte ait déjà eu des vidéos performantes ne sont des facteurs directs du système de recommandation ».
Le second a fuité. En décembre 2021, le New York Times a obtenu un document interne intitulé « TikTok Algo 101 », rédigé par l'équipe d'ingénierie de Pékin et dont TikTok a confirmé l'authenticité. Le système y poursuit deux objectifs, la rétention et le temps passé, et le score d'une vidéo combine la probabilité d'un like, celle d'un commentaire, le temps de visionnage attendu et la probabilité que la vidéo soit lancée. Le document date de 2021 et le système a évolué depuis. Il dit néanmoins ce que TikTok cherche : une vidéo regardée longtemps, qui fait réagir, et qui donne envie de revenir.
Pour la recherche s'ajoute une couche de compréhension du contenu, la même que dans tout moteur vidéo : la reconnaissance du texte affiché à l'écran, la transcription de ce qui est dit et la lecture de la description. Les commentaires participent, parce qu'ils reformulent le sujet avec les mots des utilisateurs. Ensuite, sur la page de résultats, le comportement fait le tri : ce qui est regardé jusqu'au bout, regardé deux fois, enregistré.
Trouver les mots-clés TikTok de votre thématique
Trois sources, de la plus simple à la plus outillée.
La barre de recherche. Tapez un mot lié à votre sujet et regardez les suggestions : ce sont des requêtes réelles, classées par popularité. Regardez aussi le bloc « Les autres ont cherché » sous certaines vidéos et les termes cliquables dans les commentaires. Faites l'exercice en navigation privée, les suggestions tiennent compte de votre historique.
Creator Search Insights. L'outil se trouve en tapant son nom dans la barre de recherche. Il montre les sujets recherchés par catégorie, indique comment vos vidéos performent en recherche, et signale les « content gaps », des sujets souvent recherchés et peu couverts en vidéo. En SEO, on appelle ça une requête à faible concurrence. Une limite : les volumes ne sont pas donnés, seulement des tendances.
Les outils de TikTok Ads. C'est là que se trouvent les seules données chiffrées, et elles servent aussi en organique.
- Keyword Insights, dans le Creative Center, liste les mots et expressions présents dans les annonces qui performent, par pays, secteur et période, avec pour chacun une popularité, son évolution, un taux de clic et un taux de conversion. Ce sont des données publicitaires, et un terme qui fait cliquer dans une annonce dit beaucoup sur le vocabulaire à reprendre en organique.
- Dans le gestionnaire de publicités, la campagne Search Ads s'appuie sur un outil de suggestion de mots-clés qui propose des termes à partir de votre vidéo et estime les impressions mensuelles de chacun. TikTok recommande au moins 20 mots-clés par groupe d'annonces, en correspondance large. Une fois la campagne lancée, le rapport des termes de recherche montre les requêtes réelles qui ont déclenché vos annonces : c'est ce que TikTok propose de plus proche d'une Search Console, et ces termes se réutilisent tels quels dans vos vidéos.
Ces outils demandent un compte TikTok for Business, gratuit à ouvrir.
Pour tester avec un budget. Dans le cadre de notre partenariat avec TikTok for Business, les lecteurs d'Abondance qui ouvrent un nouveau compte publicitaire reçoivent 500 € de crédit pour 500 € de dépense, une fois par compte. De quoi lancer une première campagne Search Ads et récupérer les termes de recherche réels de votre thématique.
Réclamer mes crédits TikTok for BusinessOptimiser une vidéo TikTok pour le référencement : la checklist
Cette liste ne couvre que la partie recherche : ce qui permet à TikTok de comprendre de quoi parle une vidéo et de la faire correspondre à une requête. Ce qui fait qu'une vidéo est regardée jusqu'au bout, likée, commentée ou relancée, autrement dit les signaux de la formule « Algo 101 » révélée par le New York Times, relève de la qualité de la vidéo elle-même : l'accroche des premières secondes, le rythme, le montage, la personne à l'écran. Ces signaux comptent autant en recherche que dans le flux, et aucune optimisation de mot-clé ne les remplace.
Voici donc ce que je vérifie sur une vidéo qui vise une requête, une fois sa qualité acquise. Chaque point renvoie à un signal vu plus haut. Cochez ce que votre dernière vidéo respecte, le compte se fait en bas.
1. Le mot-clé est prononcé dans les trois premières secondes. Une vidéo qui commence par « voilà comment détartrer une machine à café » est comprise dès la première phrase. 2. Le mot-clé est écrit à l'écran dès la première image. C'est ce que lit la reconnaissance de texte, et ce que lit l'utilisateur qui fait défiler les résultats sans le son. 3. La description est une vraie phrase, qui reformule la question et donne la réponse, avec le mot-clé au début. 4. Les sous-titres sont activés et relus. La transcription automatique se trompe sur les termes techniques, et l'erreur se retrouve dans ce que la plateforme comprend. 5. Trois à cinq hashtags précis, qui décrivent le sujet. Les hashtags génériques du type « pourtoi » n'apportent rien à la recherche. 6. La vidéo répond entièrement à la question. C'est le temps de visionnage de la formule Algo 101 : une vidéo qui promet et ne donne pas est abandonnée. 7. Le premier commentaire est le vôtre, avec un complément ou la réponse à l'objection la plus fréquente. La plateforme le lit, et les gens aussi.Combien de cases avez-vous cochées ?
0 / 7
De 0 à 2 : la vidéo n'est pas encore pensée pour la recherche. Commencez par les points 1 à 3, le mot-clé prononcé, écrit et repris en description, c'est ce que le moteur lit en premier.
De 3 à 5 : la base est là. Les cases vides sont souvent les points 4 et 7, les sous-titres relus et le premier commentaire, ceux qu'on oublie une fois la vidéo montée.
6 ou 7 : la vidéo a ce qu'il faut pour remonter en recherche. Reste ce que la checklist ne mesure pas, la régularité de publication sur un même territoire de sujets.
Le vrai coût d'un compte TikTok tenu sérieusement
C'est le point que les guides abordent rarement, parce qu'il décourage.
TikTok recommande de publier trois à cinq vidéos par semaine. En dessous, le compte apprend lentement et la plateforme a peu de matière pour le positionner. Une vidéo bien faite, avec un script, un tournage propre, un montage, des sous-titres relus et une description travaillée, prend entre une et trois heures. Ajoutez la veille des requêtes, les réponses aux commentaires et l'analyse de ce qui a marché : un compte tenu sérieusement demande entre douze et vingt heures par semaine, soit un mi-temps qu'il faut prendre quelque part.
Il y a ensuite la durée. Les premières vidéos remontent peu, parce que TikTok n'a pas encore compris de quoi parle le compte, et les résultats en recherche arrivent après plusieurs semaines de publication régulière sur un même territoire de sujets. Un compte qui teste un mois puis s'arrête n'apprend rien.
Ma recommandation est la même qu'en SEO classique : choisir un territoire de requêtes étroit, où votre expertise se montre en vidéo, et le tenir. Dix vidéos qui répondent bien à dix questions précises rapportent plus que cinquante vidéos qui courent après les tendances. Pour poser ce cadre avant de tourner, Mickaël Vincent, de la chaîne YouTube TalkMyFootball, a expliqué sur Abondance comment définir une stratégie de contenus vidéo pour son entreprise.
TikTok Ads pour tester plus vite
Bloc partenaire. Les liens ci-dessous sont des liens d'affiliation : Abondance est rémunérée sur les comptes publicitaires ouverts depuis cet article.
Tout ce qui précède est organique et prend des mois. La publicité sur TikTok achète autre chose : de la donnée et de la vitesse. Une campagne montre en quelques jours quelles audiences réagissent à quel message, et quelle accroche garder en organique. TikTok a publié un chiffre utile en novembre 2025 : les annonceurs qui combinent annonces de recherche et annonces in-feed observent 20 % de conversions en plus. Ce que la publicité n'achète pas, c'est la portée organique : une vidéo poussée en campagne ne remonte pas mieux en recherche une fois la campagne terminée.
Dans le cadre de notre partenariat avec TikTok for Business, les lecteurs d'Abondance qui ouvrent un nouveau compte publicitaire depuis ce lien reçoivent 500 € de crédit publicitaire pour 500 € de dépense, une fois par compte : Réclamer mes crédits TikTok for Business.
Si vous avez déjà travaillé la recherche sur TikTok, pour vous ou pour un client, vos retours en commentaire m'intéressent. Je lis tout et je réponds.
L’article "SEO TikTok : comment apparaître dans les recherches de 30,6 millions de Français" a été publié sur le site Abondance.
-
La « troisième voie » de l’Europe dans l’IA est-elle une réelle stratégie industrielle ou l’habillage politique d’un retard face aux Etats-Unis et à la Chine ?
www.usine-digitale.frL’Europe n’a pas besoin de développer les meilleurs modèles d’IA pour être celle qui en tire le plus de valeur. C’est, en substance, l’un des messages du traditionnel discours sur l’état de l’Union tenu par Ursula von der Leyen le 16 septembre devant le Parlement européen.
-
iPhone 18 Pro Max : nous avons chronométré sa recharge, c’est du jamais vu chez Apple
www.numerama.com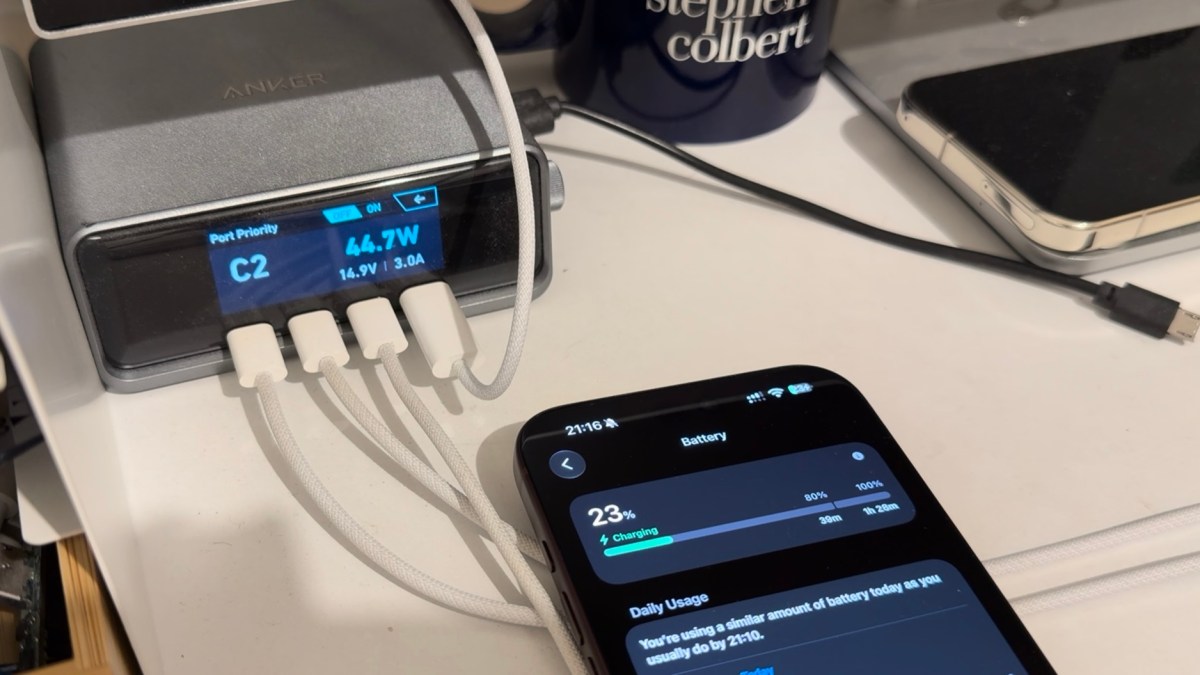
Malgré la présence de batteries à la capacité immense, les iPhone 18 Pro et iPhone 18 Pro Max battent des records lors de leur recharge. Nous avons branché un iPhone 18 Pro Max à 0 % avec un wattmètre et un chronomètre, puis comparé sa courbe de recharge à celles des trois générations précédentes. Le résultat est le meilleur jamais mesuré sur un iPhone : Apple a corrigé de nombreux défauts.
-
PLANITY, TREATWELL ou FRESHA : quelle plateforme choisir pour son salon de coiffure, ou de soins esthétiques?
www.frenchweb.frLa prise de rendez-vous n’est plus qu’une porte d’entrée, derrière l’agenda numérique se joue désormais le contrôle d’une partie croissante de l’activité du salon de coiffure : acquisition de clients, encaissement, fichier client, gestion des équipes, stocks, cartes cadeaux, marketing et, progressivement, financement. PLANITY, TREATWELL et FRESHA répondent à ce même besoin avec trois modèles …
L’article PLANITY, TREATWELL ou FRESHA : quelle plateforme choisir pour son salon de coiffure, ou de soins esthétiques? est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Zelda Ocarina of Time : où trouver l’ocarina en précommande
www.numerama.com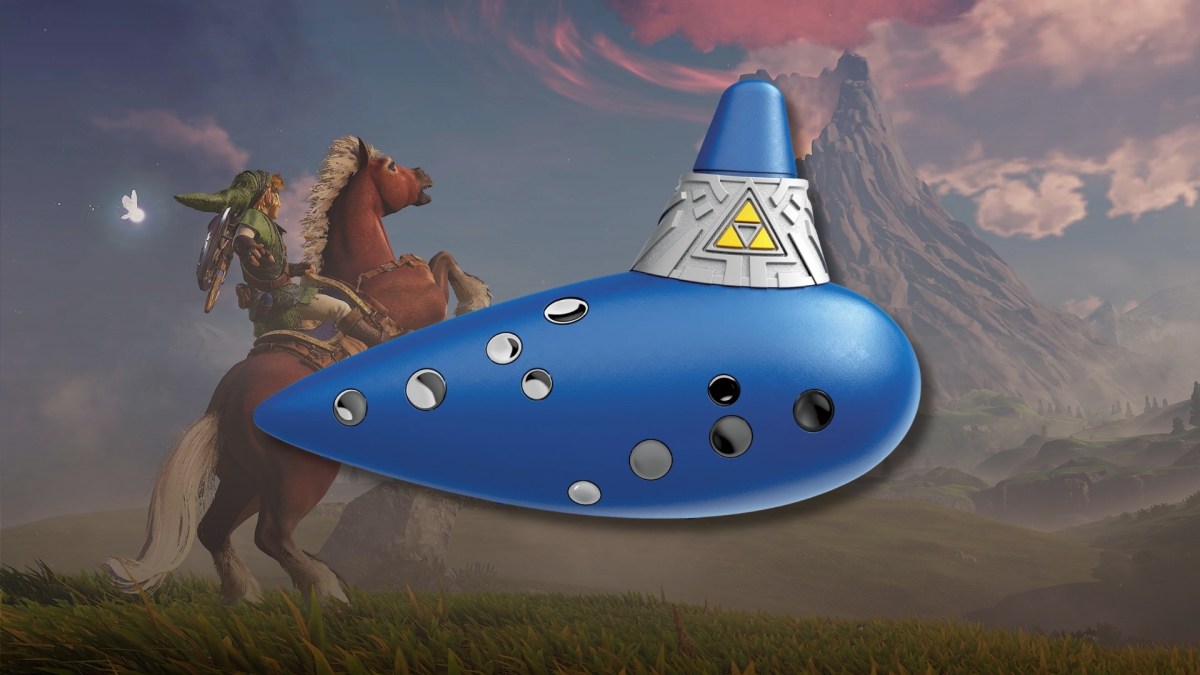
L’ocarina de Link pourra bientôt rejoindre votre salon et servir dans le remake d’Ocarina of Time sur Switch 2. Le modèle électronique de HORI commence à apparaître chez les marchands à 49,99 €. Mais attention à bien le distinguer de l’autre instrument présenté par Nintendo.
-
AI Overviews arrive en France : comment rester visible dans les résultats de recherche ?
www.frenchweb.frL’arrivée d’AI Overviews en France change progressivement la manière dont les internautes accèdent à l’information sur Google. Pour de nombreuses requêtes, le moteur de recherche affiche désormais directement une réponse générée par intelligence artificielle, accompagnée d’une sélection limitée de sources. Pour les entreprises, les médias et les équipes marketing, l’enjeu dépasse donc désormais le positionnement …
L’article AI Overviews arrive en France : comment rester visible dans les résultats de recherche ? est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
L’onglet Cowork va disparaître : voici comment naviguer dans la nouvelle interface de Claude
www.numerama.com
Anthropic vient d'annoncer la fusion de ses deux interfaces principales au sein d'une seule expérience Claude, capable de déterminer elle-même l'ampleur du travail à effectuer. Docs et Slides en beta font également leur entrée.
-
Comment les agents IA transforment le modèle de l’agence SEO (sans remplacer les consultants)
www.abondance.comArticle sponsorisé par Sedestral
Le plafond de verre de l'agence SEO
Le modèle des agences présente une limite structurelle. Pour gérer un client supplémentaire, il faut bien souvent passer par la case recrutement. Les marges sont ténues, les profils SEO expérimentés difficiles à trouver, ce qui se ressent sur la répartition du travail. Les juniors passent leurs journées en reporting, les seniors en briefs et en validation, et personne n'a plus vraiment le temps pour faire de la stratégie !
Depuis deux ans, un nouveau problème s’est ajouté : les clients demandent des résultats dans ChatGPT, Gemini ou Perplexity, un canal que personne ne sait encore vraiment mesurer avec les outils historiques. Les agences doivent répondre à cette demande sans moyens supplémentaires, et souvent sans méthode pré-établie.
Outil IA contre agent IA : l’apport concret pour les agences
Un consultant qui utilise ChatGPT ou Claude dans le but de rédiger plus vite gagne 20 % sur une tâche. Un agent IA qui exécute la tâche de bout en bout, sur trente sites clients en parallèle, bouleverse l’organisation.
La différence entre un outil IA classique et un agent IA a déjà été abordée à plusieurs reprises sur Abondance : l’agent se connecte au site et au CMS, exécute la tâche, puis boucle sur le suivi de son propre travail. Pour une agence, le point qui change vraiment la donne est le passage à l'échelle. Il est possible d’exécuter une tâche identique sur tout le portefeuille de clients, de façon simultanée, et non pas sur un seul site à la fois.
Que peut-on confier aux agents IA ?
Voici un passage en revue des missions les plus chronophages réalisées en agence, avec les temps observés avant et après délégation à un agent. Ces chiffres sont les hypothèses du calculateur de Sedestral, construites à partir de retours clients agences, et non une mesure terrain généralisables. Elles offrent toutefois un ordre de grandeur tout à fait réaliste :
- Recherche de mots-clés et planning éditorial : environ 1 h 30 par client en agence, contre 15 minutes de validation, une fois la mission confiée à un agent.
- Article de blog documenté et publié sur le CMS : environ 1 h 30 de rédaction et de mise en ligne, contre 15 minutes de relecture par un agent.
- Optimisation d'une page existante avec l’agent Rémi : l’agent compare la page aux meilleurs résultats de la SERP, propose une version retravaillée ; le consultant relit dans l'éditeur, puis la modification est poussée sur le CMS.
- Suivi d'indexation, avec l'agent Nox : chacune des pages des clients fait l’objet d’un suivi via l'API Search Console, avec soumission automatique dans la limite d'un plafond quotidien, et alerte en cas de désindexation. C’est une tâche qui peut être entièrement automatisée.
- Veille concurrentielle, avec l'agent Marc : les concurrents sont identifiés automatiquement à partir des requêtes partagées, les mots-clés les plus intéressants, et ces données sont réinjectées vers les autres agents.
- Netlinking, avec l'agent Maya : gap concurrentiel et acquisition de liens, sur le même principe que celui déjà détaillé dans un précédent article.
- Rapports : générés automatiquement, à la marque de l'agence.
Un niveau de délégation différent pour chaque client
Le risque, avec ce genre d'outils, serait de tomber dans le « tout automatique ». Dans l’offre Sedestral pour les agences, chaque agent IA est paramétrable site par site, selon trois modes distincts : automatique, manuel (l'agent propose, l'humain valide), ou désactivé.
Une agence peut ainsi laisser Nox en automatique sur tous ses comptes, mettre Alya en validation manuelle chez un client sensible sur sa communication, et couper Maya chez celui qui n'a pas de budget netlinking. La délégation est alors une décision prise individuellement, pas un choix global qui s’applique à l’ensemble du portefeuille.
Le SEO en marque blanche avec Sedestral
Concrètement, l'offre proposée par Sedestral inclut un espace client aux couleurs de l'agence, avec le suivi du travail réalisé par les agents, les rapports et l'évolution des positions. Les rôles y sont distincts : l'agence garde l'administration et l'édition, le client a un accès en consultation.
L'agence reste ici le seul et unique interlocuteur du client, mais ce dernier voit concrètement ce qui a été fait pour lui. Ce point permet de régler une tension propre au métier : justifier, mois après mois, la valeur d'une prestation qui demeure souvent abstraite pour qui ne la pratique pas. Avec ce mode de fonctionnement, les choses sont claires pour les différentes parties.
La visibilité IA : nouvelle ligne incontournable du rapport client
Portons une attention particulière à une section désormais de plus en plus incontournable, à l’heure des moteurs IA : celle dédiée au suivi des mentions et citations de la marque dans les réponses générées par ChatGPT, Gemini, Perplexity, Claude et les AI Overviews de Google. Ces informations, attendues par les clients en 2026, sont encore le parent pauvre des agences. En effet, peu d’entre elles savent les facturer, faute d’outil ou de méthode assez rigoureuse pour justifier une prestation dédiée.
Les choses sont toutefois en train de changer. Si les agents IA sont capables de mesurer cette visibilité, l’agence vend quant à elle l’accompagnement qui va avec : comprendre pourquoi une marque est citée ou non par les différents LLMs, et quelles actions mettre en place pour améliorer ou changer cela.
Ce sur quoi l’agence doit garder la main
Et quel est le rôle de l’agence dans tout cela ? La stratégie, l'arbitrage, la relation client et la responsabilité restent avant tout une affaire humaine. En essence, un agent IA n'a pas d'avis sur le positionnement d'une marque, ni sur les priorités business d'un client. Une agence qui serait tentée de déléguer également cette tâche à la machine n’aurait plus vraiment d’utilité, perdrait en pertinence, et pourrait rapidement fermer boutique.
L’objectif de ces outils n'est donc pas de faire disparaître les professionnels, mais plutôt de leur permettre de redevenir des conseillers plutôt qu'une simple usine à livrables, qui n’a plus de temps pour la réflexion.
Le moment de revenir aux fondamentaux !
Le modèle « un consultant pour X clients » ne tient plus face à la pression exercée sur les prix et la demande d'IA mal formulée des clients. Loin d’être un problème de compétences, l’enjeu concerne surtout la répartition du temps. Encore trop d’heures sont consacrées à des tâches qui ne requièrent pas nécessairement d’expertise humaine, et pas assez à celles qui en ont vraiment besoin.
En 2026, les agences qui se portent le mieux ne sont pas celles qui produisent le plus vite. Ce sont celles qui ont déplacé la force de leurs équipes vers ce que les agents IA ne seront sans doute jamais en capacité de faire : arbitrer une stratégie, défendre un budget en comité, comprendre pourquoi un client hésite avant même qu'il ne le formule. En somme, déléguer l'exécution à des agents IA n'affaiblit aucunement ce rôle, il lui permet de passer à une tout autre échelle.
L’article "Comment les agents IA transforment le modèle de l’agence SEO (sans remplacer les consultants)" a été publié sur le site Abondance.
-
Jeux vidéo et cybersécurité : le nouveau cadre règlementaire
www.lexing.law
Le secteur du jeu vidéo s’est imposé comme un pilier de l’économie numérique. Studios, éditeurs, plateformes en ligne, hébergeurs cloud et organisateurs d’e-sport composent un écosystème interconnecté, dépendant d’infrastructures critiques et de flux continus de données.
À la croisée du règlement général sur la protection des données (RGPD) (1), de la directive NIS 2 (2), du règlement européen sur les services numériques (DSA) (3), et du règlement sur la cyberrésilience (CRA) (4), les acteurs du jeu vidéo doivent intégrer une approche globale de gestion du risque cyber.Une menace cyber structurelle pour l’écosystème du jeu vidéo
Les tendances observées par l’ANSSI dans son Panorama de la cybermenace 2025 (5) confirment une intensification des attaques : rançongiciels, extorsions, campagnes de déstabilisation (notamment DDoS) et exploitation de vulnérabilités sur des systèmes exposés. L’industrie du jeu vidéo présente plusieurs facteurs d’exposition :
• infrastructures à forte disponibilité (serveurs en ligne) ;
• environnements cloud massifs ;
• équipes distribuées et accès distants ;
• dépendance à une chaîne de prestataires techniques interconnectés.Les attaques par rançongiciel peuvent provoquer l’interruption de services, la compromission de données de joueurs ou la fuite de codes sources stratégiques. La compromission d’équipements de bordure (pare-feux, VPN) constitue un vecteur d’intrusion particulièrement critique pour les studios.
La cybersécurité devient ainsi un enjeu de continuité d’activité et de confiance des communautés.RGPD et jeux vidéo : la sécurité des données comme obligation centrale
Les studios et plateformes traitent d’importants volumes de données personnelles : comptes joueurs, données de paiement, données comportementales, données de localisation, voire données biométriques dans certains environnements immersifs. Le RGPD impose :
• la mise en œuvre de mesures techniques et organisationnelles appropriées (art. 32) ;
• la notification des violations de données à l’autorité de contrôle dans les 72 heures (art. 33) ;
• l’information des personnes concernées en cas de risque élevé d’une violation (art. 34).Les sanctions administratives peuvent atteindre 20 millions d’euros ou 4 % du chiffre d’affaires mondial annuel (art. 83).
Au-delà du risque financier, une violation de données affectant une communauté de joueurs peut entraîner une atteinte durable à la réputation et à la valeur des actifs numériques.Directive NIS 2 et jeux vidéo : vers une responsabilisation accrue des acteurs
La directive NIS 2 marque un changement d’échelle en matière de cybersécurité. Elle s’applique aux entités moyennes et grandes opérant dans les secteurs listés aux annexes I et II (art. 2). Dans l’écosystème du jeu vidéo, peuvent notamment être concernés :
• les fournisseurs de services cloud et d’infrastructure numérique ;
• les centres de données ;
• les fournisseurs de services gérés ;
• certaines plateformes numériques.La directive distingue entités essentielles et entités importantes (art. 3), ce qui conditionne l’intensité des contrôles. L’industrie du jeu vidéo n’y constitue pas un secteur autonome : selon ses activités, elle peut relever soit des entités essentielles lorsqu’elle fournit des services d’infrastructure numérique (cloud, centres de données, fournisseurs de services gérés – annexe I), soit des entités importantes lorsqu’elle exploite certaines plateformes ou services numériques en ligne (annexe II).
L’article 21 impose des mesures de gestion des risques couvrant :
• l’analyse des risques ;
• la gestion des incidents ;
• la continuité d’activité ;
• la sécurité de la chaîne d’approvisionnement ;
• la sécurité du développement logiciel.L’un des apports majeurs réside dans l’implication des organes de direction (art. 20), tenus d’approuver et de superviser les mesures de cybersécurité. La gouvernance cyber devient un sujet de niveau exécutif.
Les sanctions peuvent atteindre 10 millions d’euros ou 2 % du chiffre d’affaires mondial annuel (art. 34).DSA : responsabilité des plateformes de jeu vidéo
Les plateformes de jeu intégrant des contenus générés par les utilisateurs relèvent du DSA. Le règlement maintient l’exonération conditionnelle des hébergeurs, mais impose des obligations de diligence :
• mécanisme efficace de notification et action ;
• modération diligente des contenus illicites ;
• transparence des règles et décisions ;
• rapports de transparence.Pour les très grandes plateformes, une évaluation des risques systémiques (art. 34) est requise, notamment concernant la protection des mineurs et la diffusion de contenus préjudiciables.
Les sanctions peuvent atteindre 6 % du chiffre d’affaires mondial annuel (art. 52).CRA et jeux vidéo : la cybersécurité par conception
Le CRA adopte une approche centrée sur le produit. Il s’applique aux « produits comportant des éléments numériques » mis à disposition sur le marché européen (art. 2 et 3). Le règlement impose notamment aux fabricants :
• l’intégration des exigences essentielles de cybersécurité dès la conception et par défaut (« security by design » et « security by default ») (art. 13 §1 et annexe I) ;
• la réalisation d’une évaluation des risques cyber intégrée au cycle de développement (art. 13 §2 à §4) ;
• la mise en place de processus de gestion et de divulgation coordonnée des vulnérabilités, y compris pour les composants tiers ou open source (art. 13 §5 à §8) ;
• la fourniture de mises à jour de sécurité pendant la période d’assistance du produit (art. 13 §9) ;
• la notification des vulnérabilités activement exploitées et des incidents graves via la plateforme ENISA (art. 14).Dans l’écosystème du jeu vidéo, le CRA peut ainsi concerner notamment :
• les consoles et équipements connectés ;
• les périphériques gaming intelligents ;
• les dispositifs immersifs VR/AR ;
Les sanctions peuvent atteindre 15 millions d’euros ou 2,5 % du chiffre d’affaires mondial annuel pour les manquements les plus graves (art. 64).Vers une gouvernance intégrée du risque cyber
Le cadre juridique applicable au jeu vidéo révèle une convergence : protection des données, sécurité des réseaux, responsabilité des plateformes et conformité des produits. Pour les acteurs du gaming, la cybersécurité implique désormais :
• une implication des organes de direction ;
• une articulation entre équipes techniques, juridiques et conformité ;
• une vigilance accrue sur la chaîne d’approvisionnement logicielle ;
• une documentation structurée des mesures mises en œuvre.Au-delà du risque de sanction, l’enjeu est stratégique : continuité d’exploitation, protection des actifs immatériels et confiance des joueurs.
La conformité cyber ne constitue plus une option technique. Elle s’inscrit désormais au cœur de la gouvernance des entreprises du jeu vidéo.(1) Règlement (UE) 2016/679 du Parlement européen et du Conseil du 27 avril 2016 relatif à la protection des personnes physiques à l’égard du traitement des données à caractère personnel et à la libre circulation de ces données, et abrogeant la directive 95/46/CE (règlement général sur la protection des données) (Texte présentant de l’intérêt pour l’EEE).
(2) Directive (UE) 2022/2555 du Parlement européen et du Conseil du 14 décembre 2022 concernant des mesures destinées à assurer un niveau élevé commun de cybersécurité dans l’ensemble de l’Union, modifiant le règlement (UE) no 910/2014 et la directive (UE) 2018/1972, et abrogeant la directive (UE) 2016/1148 (directive SRI 2) (Texte présentant de l’intérêt pour l’EEE).
(3) Règlement (UE) 2022/2065 du Parlement européen et du Conseil du 19 octobre 2022 relatif à un marché unique des services numériques et modifiant la directive 2000/31/CE (règlement sur les services numériques) (Texte présentant de l’intérêt pour l’EEE).
(4) Règlement (UE) 2024/2847 du Parlement européen et du Conseil du 23 octobre 2024 concernant des exigences de cybersécurité horizontales pour les produits comportant des éléments numériques et modifiant les règlements (UE) n° 168/2013 et (UE) 2019/1020 et la directive (UE) 2020/1828 (règlement sur la cyberrésilience) (Texte présentant de l’intérêt pour l’EEE).
(5) Panorama de la cybermenace 2025. Katharina Berbett
Avocate, Directrice du département Informatique contentieux complexe Mathilde Pennès-Lavoye
Avocate, collaboratrice du département Informatique contentieux complexe
L’article Jeux vidéo et cybersécurité : le nouveau cadre règlementaire est apparu en premier sur Lexing Avocats.
-
Ambassades de données : vers une souveraineté numérique hors-frontière ?
incyber.orgRegistre de la population, cadastre, livre foncier, registre du commerce, système du Trésor : ce qui fait tourner l’administration estonienne existe en double au Luxembourg, dans des locaux où aucun agent du Grand-Duché n’entre sans l’accord du représentant estonien, sauf incendie ou autre urgence. Le principe s’énonce simplement et se qualifie mal en droit : un État place des copies de ses registres essentiels sur le territoire d’un autre et en garde le contrôle. À rebours de la localisation des données, on sort l’information du territoire pour la protéger et en assurer la continuité, et l’on compense la perte de contrôle physique par un montage juridique.
Au Luxembourg, l’immunité par traité
Deux accords seulement relèvent du traité entre États, et le même pays les accueille. L’accord estonien, signé le 20 juin 2017 par Jüri Ratas et Xavier Bettel, est ratifié par le Riigikogu en mars 2018, au terme d’une réflexion engagée dès 2014 avec Microsoft. Tallinn a retenu le Grand-Duché pour ses centres publics certifiés Tier IV et pour son engagement à garantir l’immunité des systèmes, selon l’exposé des motifs cité par le Riigikogu. Le coût était évalué à 2,2 millions d’euros sur cinq ans, dont 85 % pris en charge par le Fonds européen de développement régional, selon ERR. Dix bases y sont répliquées : registre de population, registre du commerce, livre foncier électronique, cadastre, registre des assujettis, registre des documents d’identité, système d’information du Trésor, système judiciaire eFile, registre des pensions et Journal officiel.
Quatre ans plus tard, Monaco signe son accord avec le Luxembourg en juillet 2021. Il entre en vigueur le 30 juin 2023. La principauté cherchait, dit le préambule, des locaux situés à l’étranger, à au moins 150 kilomètres de son territoire, pour protéger ses données des catastrophes naturelles comme des actes illicites. Sur deux kilomètres carrés, aucune redondance géographique n’est possible sans franchir la frontière.
Les deux textes se disent conclus « dans l’esprit » de la convention de Vienne de 1961, qu’ils jugent insuffisante, et en recopient la mécanique. Dans l’accord estonien, les locaux sont inviolables (article 3), les équipements échappent à toute forme de procédure judiciaire (article 5) et les données sont assimilées aux archives de la République (article 6). L’Estonie peut chiffrer ses communications officielles comme elle l’entend et recourir à des courriers diplomatiques ; ces communications ne peuvent être ni censurées ni restreintes. Si l’accord prend fin, les données ne sont remises qu’au représentant autorisé de l’Estonie ; s’il est introuvable, le Luxembourg les protège comme ses propres archives jusqu’à ce qu’un représentant légal se présente (article 10). Le texte anticipe ici l’hypothèse d’un État dont les autorités ne répondent plus. Monaco l’a reprise dans son propre accord (article 14).
Le texte monégasque complète le dispositif sur plusieurs points. Son article 7 interdit expressément aux autorités luxembourgeoises d’appréhender les données à distance sans consentement préalable de Monaco : l’accès logique est pris en compte, et non plus seulement l’intrusion physique. L’article 4 écarte toute autorité « étrangère » de l’accès physique, mais l’interdiction de l’accès à distance ne vise, elle, que le Luxembourg. L’article 8 exclut toute interception des communications à des fins administratives ou judiciaires. L’article 3 oblige le Luxembourg à prévenir six mois avant toute cession des locaux ou tout changement de gestionnaire, sauf urgence impérieuse.
Des angles morts demeurent dans les deux cas. L’immunité protège locaux, machines et données, mais pas l’alimentation électrique ni le refroidissement : les deux textes imposent des locaux livrés en état de marche, sans garantir leur continuité en crise. Le Luxembourg ne doit à Tallinn que le niveau de protection qu’il s’accorde à lui-même (article 4). Le représentant estonien, faute d’être membre d’une mission diplomatique, ne bénéficie d’aucune immunité personnelle, relevait dès 2019 Bartłomiej Sierzputowski dans l’International and Comparative Law Quarterly. Aucune bascule en conditions réelles n’a été rendue publique à ce jour ; le site estonien demeure une sauvegarde, que Tallinn veut à terme pouvoir exploiter en direct.
En Ukraine, l’exil des registres dans l’urgence
L’Ukraine constitue le seul cas documenté de basculement réel, et il s’est fait hors de tout cadre diplomatique et avec des opérateurs privés. Avant 2022, la loi ukrainienne imposait le maintien de certaines données publiques sur des serveurs situés sur le territoire national. La loi « Sur les services cloud » n° 2075-IX, adoptée le 17 février 2022, une semaine avant l’invasion, n’a pas levé ce verrou. Signée le 15 mars et applicable à partir de septembre, elle interdit au contraire de traiter hors du pays les secrets d’État, l’information officielle et les données des registres d’État, comme le détaille l’analyse du cabinet Sayenko Kharenko. La sortie des données repose sur le droit d’exception : la résolution n° 263 du Cabinet des ministres du 12 mars 2022 autorise, pendant la loi martiale, l’hébergement des registres publics et de leurs copies dans des clouds ou des centres de données situés à l’étranger, dérogation inscrite ensuite dans la loi n° 2130-IX du 15 mars 2022.
L’exécution repose sur des fournisseurs privés. Trois boîtiers AWS Snowball sont acheminés depuis Dublin via la Pologne dans les premiers jours du conflit. Selon Liam Maxwell, directeur chez AWS, 161 registres d’État et 356 organisations ont été migrés, pour une quinzaine de pétaoctets. Le dispositif actuel n’offre aucune immunité formelle digne d’une “
ambassade” dans la mesure où la protection est contractuelle et repose sur la relation commerciale avec l’hébergeur, sur le chiffrement et sur la dispersion. Le recours à un prestataire américain ajoute une autre contrainte : le CLOUD Act permet aux autorités américaines de contraindre un fournisseur soumis à leur juridiction à communiquer des données placées sous son contrôle, y compris lorsqu’elles sont stockées hors des États-Unis. Kyiv a engagé des discussions parallèles avec plusieurs États, dont l’Estonie et la France, pour la protection de ses données essentielles à l’extérieur de son territoire national, selon les informations du Wall Street Journal du 14 juin 2022. Aucun accord n’a été rendu public depuis. Depuis, le gouvernement ukrainien a renforcé le cadre de l’hébergement de ses données, avec la résolution n° 154 du 11 février 2025 fixant les exigences applicables aux prestataires de services cloud et de centres de données, notamment la conformité à la norme ISO/IEC 27001.
Vers un marché de l’asile de données ?
Dans le Golfe, l’accueil s’organise d’abord par la loi du pays hôte, que l’Arabie saoudite prévoit d’adosser à des accords d’État à État. Le décret-loi bahreïni n° 56 de 2018 réserve le contenu des clients étrangers, entreprises comprises, aux juridictions de leur État d’origine, à charge pour le prestataire local d’aviser le procureur général de toute injonction. Le régime ne s’applique qu’aux États et aux centres de données désignés par le Conseil des ministres. Le décret a précédé de peu l’ouverture à Bahreïn, en 2019, de la première région AWS du Moyen-Orient. Le projet saoudien de Global AI Hub Law, soumis à consultation en avril 2025, distingue trois modèles. Le Private Hub est un centre de données réservé à un État étranger, le « pays invité », et fonctionne selon son droit dans le cadre d’un accord bilatéral avec Riyad. L’Extended Hub reprend cette logique, mais permet à un opérateur tiers d’héberger ses propres données ou celles de ses clients selon le droit du pays invité, toujours sur la base d’un accord avec l’Arabie saoudite. Le Virtual Hub est exploité par un prestataire saoudien et permet de soumettre les données de ses clients au droit d’un « État étranger désigné », sans qu’un accord bilatéral soit nécessairement requis. Dans les trois cas, le dispositif reste sous contrôle saoudien et le Conseil des ministres peut mettre fin aux accords ou arrangements pour protéger la sécurité et la souveraineté du Royaume, avec un maintien temporaire des privilèges prévu par le texte.
L’Inde, de son côté, promet depuis son budget du 1er février 2023 d’accueillir des ambassades de données à GIFT City, la zone économique spéciale du Gujarat qui abrite son centre financier international et son régulateur dédié, l’IFSCA. En février 2025, un responsable de l’IFSCA assurait à The Hindu BusinessLine que Singapour étudiait « activement » une implantation. Aucune législation dédiée n’a été adoptée, constate en juillet 2026 le cabinet CMS IndusLaw, qui juge notamment utile de prévoir des exceptions à la section 69 de l’Information Technology Act, laquelle permet aux autorités indiennes d’intercepter et de déchiffrer des données. Un responsable de GIFT City a bien évoqué, d’après le cabinet, une loi ad hoc offrant une immunité comparable à celle des ambassades, mais aucun texte n’a suivi. La déclaration conjointe indo-émirienne du 19 janvier 2026 ouvre une autre piste : les deux dirigeants y chargent leurs équipes d’étudier des « ambassades numériques » sous des arrangements de souveraineté mutuellement reconnus. Le même jour, le secrétaire indien aux Affaires étrangères, Vikram Misri, parlait en briefing d’un concept « relativement nouveau », dont le cadre réglementaire reste à élaborer. Le lendemain, à Davos, le groupe émirien G42 lançait une offre commerciale baptisée « Digital Embassies », adossée à des accords d’État à État.
Le terme d’ambassade de données recouvre aujourd’hui des dispositifs plus ou moins aboutis : deux traités bilatéraux calqués sur le droit diplomatique, un déplacement opéré en urgence par contrat commercial en Ukraine, et plusieurs projets à l’étude mais sans cadre juridique arrêté. Si aucun nouvel accord inter-étatique n’a été signé depuis 2021, l’intérêt pour le principe s’élargit. Gartner prédit qu’au moins 15 % des « nations situées dans des régions géopolitiquement volatiles » auront conclu un accord formel d’ici 2029.
The post <strong>Ambassades de données</strong> : vers une souveraineté numérique hors-frontière ? appeared first on INCYBER NEWS.
-
L’État publie son premier guide officiel d’usage de l’IA pour ses agents
www.abondance.comCe qu'il faut retenir :
- Ce guide interministériel fixe 5 principes fondamentaux d'usage de l'IA : responsabilité de l'agent, choix de l'outil selon la sensibilité des données, transparence, sobriété et formation continue.
- Il distingue trois catégories d'outils, des plus sécurisés (Assistant IA interministériel, Transcripts, Visio) aux outils commerciaux gratuits, dont l'usage professionnel reste très encadré voire interdit.
- Les outils grand public gratuits comme ChatGPT ou Claude ne doivent traiter que des données qui pourraient être publiées librement sur internet.
- Le guide s'accompagne d'une annexe pratique avec des exemples de prompts classés par métier (RH, juridique, finances, management, etc.).
Un cadre attendu par les agents eux-mêmes
Ce document, disponible ici, répond à une demande forte exprimée par les agents publics : une enquête menée fin 2025 auprès de 2 000 d'entre eux a révélé un besoin clair de règles d'usage pour l'IA.
Le guide n'a pas de portée réglementaire à proprement parler, il constitue avant tout un référentiel généraliste destiné à harmoniser les pratiques dans l'attente ou en complément de chartes ministérielles spécifiques. Lorsqu'une charte métier existe déjà (Éducation nationale, Agriculture, communicants de l'État), elle s'applique en priorité.
Le texte s'inscrit également dans une séquence de dialogue social : le ministre de l'Action et des Comptes publics, David Amiel, a lancé une négociation avec les organisations syndicales sur ce sujet, et le guide devrait évoluer à l'issue de ces échanges.
Ce que l'IA générative peut apporter, et ses limites
Le guide rappelle d'abord ce qu'est l'IA générative : une technologie qui produit du contenu original à partir d'un apprentissage statistique sur de grands volumes de documents, et non un logiciel obéissant à des règles programmées. Concrètement, cet outil peut faire gagner du temps aux agents sur les tâches répétitives : transcrire une réunion, résumer un rapport de plusieurs dizaines de pages, reformuler un texte technique pour le grand public, traduire un document ou structurer des idées avant rédaction.
Mais le document insiste tout autant sur les limites de ces outils, notamment les hallucinations. Le guide rappelle que l'IA peut inventer des références juridiques, des chiffres ou des faits historiques qui n'existent pas. Elle ne comprend pas non plus le sens de ce qu'elle produit, fonctionnant uniquement par probabilités. Elle peut reproduire les biais présents dans ses données d'entraînement, être détournée par des instructions cachées dans un document, et ses connaissances restent figées à une date donnée.
Le guide pointe enfin son coût environnemental : une requête texte équivaut à peu près à une à dix recherches Google, la génération d'une image consomme environ soixante fois plus, et les modèles de raisonnement plusieurs dizaines de fois plus.
Quatre conditions sont posées pour un usage réussi :
- Maîtriser soi-même la tâche confiée à l'IA,
- Laisser les agents experts du métier intégrer l'outil plutôt que l'imposer d'en haut,
- Ne pas en faire un réflexe automatique,
- Vérifier systématiquement les sources quand elles sont disponibles.
Cinq principes pour encadrer la pratique
Le cœur du guide repose sur cinq principes.
L'agent public reste responsable
L'IA propose, mais c'est l'agent qui décide, publie et engage sa responsabilité. Toute production doit être validée avant diffusion, et il est explicitement proscrit de configurer l'IA pour qu'elle envoie automatiquement des courriels ou accède à des systèmes critiques sans supervision humaine.
Le choix de l'outil dépend de la nature des données
C'est sans doute le point le plus opérationnel du guide, développé sous forme de trois catégories hiérarchisées.
- Les outils des administrations publiques sont à privilégier en priorité : l'Assistant IA interministériel (assistant.numerique.gouv.fr) pour la rédaction et la reformulation, l'Assistant Transcripts pour l'enregistrement des réunions en présentiel, et Visio pour la transcription automatique des visioconférences. Certains ministères disposent aussi d'outils propres, appelés à converger avec les offres mutualisées de l'État d'ici 2026.
- Les outils commerciaux payants mis à disposition par l'administration (versions professionnelles de ChatGPT ou Claude par exemple) offrent des garanties contractuelles renforcées, mais leur usage doit toujours être vérifié auprès de la DSI, car même une licence payante n'autorise pas tous les types de données. Le guide alerte notamment sur la nécessité d'examiner le pays d'établissement du fournisseur et sa structure capitalistique, un hébergement dans l'Union européenne ne protégeant pas automatiquement du Cloud Act américain si le service est opéré par une entreprise qui y est soumise.
- Les outils commerciaux gratuits accessibles librement sur internet (versions gratuites de ChatGPT, Claude, Gemini, NotebookLM ou Le Chat) font l'objet d'un usage très limité, voire interdit. Le réflexe recommandé aux agents est simple : se demander si l'information traitée pourrait être publiée sur un site accessible à tous. Si la réponse est non, l'outil grand public est à proscrire. Analyser un dossier d'usager, un compte rendu de réunion interne ou des données RH avec ce type d'outil est explicitement classé comme un usage interdit.
La transparence doit être proportionnée au rôle joué par l'IA
Une simple reformulation ou correction ne nécessite aucune mention particulière. En revanche, dès que l'IA produit un contenu de façon substantielle (analyse, note, courrier, synthèse), une mention devient obligatoire, du type « généré partiellement par intelligence artificielle ».
Cette exigence s'appuie sur des textes existants : le RGPD pour les décisions à effets juridiques reposant sur un traitement automatisé, et le code des relations entre le public et l'administration pour les décisions individuelles fondées sur un algorithme.
Pour les décisions administratives à fort impact, le guide recommande de documenter l'outil utilisé, le résultat proposé, la décision finalement retenue et les motivations, afin de pouvoir justifier le choix en cas de contestation.
L'usage doit rester éthique et sobre
Avant de solliciter l'IA, l'agent est invité à se demander s'il en a réellement besoin, si un outil plus simple ne suffirait pas, et si le gain est proportionné à la dépense énergétique engagée. Le guide donne un exemple concret : traduire un courriel de cinq lignes ne justifie pas de recourir à l'IA, un traducteur classique ou une traduction manuelle suffit, l'IA étant réservée aux textes longs et complexes.
La vigilance porte aussi sur le droit d'auteur, l'IA pouvant reproduire du contenu protégé, et sur les biais qu'elle peut reproduire (stéréotypes de genre, biais culturels ou socio-économiques), qu'il convient de corriger par une relecture critique.
La formation continue est présentée comme la clé d'un usage responsable
Le Campus du numérique public et la plateforme Mentor proposent plusieurs modules aux agents (Objectif IA, Découvrir les IA génératives, Kit atelier prompting), en complément des formations ministérielles et des communautés de pratiques internes, notamment sur Tchap.
Une annexe pensée pour la pratique quotidienne
Le guide se termine par une fiche mémo sur la rédaction de prompts, résumée par une formule simple : un bon prompt associe un contexte, un document de référence si nécessaire, une consigne précise et un format attendu. Il recommande d'être précis sans être trop long, de donner du contexte sur son rôle et son objectif, de préciser la longueur et la structure attendues, et de ne pas hésiter à demander des révisions successives plutôt que d'attendre un résultat parfait du premier coup.
Une longue annexe présente ensuite des cas d'usage concrets classés par famille de métier (RH, gestion de projets, communication, développement, juridique, finances, management), chacun accompagné d'un prompt réutilisable, d'un exemple de résultat obtenu et de points de vigilance spécifiques. Chaque fiche inclut aussi un conseil d'agent, une manière de rappeler que l'IA prépare un brouillon, mais que la relecture critique et la validation finale restent, dans tous les cas, de la responsabilité humaine.
L’article "L’État publie son premier guide officiel d’usage de l’IA pour ses agents" a été publié sur le site Abondance.
-
Stowaway : le site qui vous montre le paysage depuis les avions qui survolent votre maison
www.numerama.com
Un avion traverse le ciel au-dessus de votre logement ? Le site Stowaway permet de le suivre en temps réel, puis d’admirer le paysage depuis son « hublot ». Si l'expérience est assez bien faite, elle ne repose évidemment pas sur une caméra installée à bord.
-
Pour Mistral, la souveraineté de l’IA passe par les modèles à poids ouverts
incyber.orgMistral vient de mettre noir sur blanc l’autre ligne de fracture de la course à l’IA. Dans la présentation de sa stratégie, l’entreprise française affirme que les organisations et les États ne veulent plus seulement disposer du modèle le plus puissant : ils cherchent à éviter de « céder le contrôle » de leur infrastructure et de leur intelligence.
Les modèles à poids ouverts rendent accessibles au téléchargement les paramètres appris du modèle. Ils peuvent ainsi être déployés sur une infrastructure maîtrisée et adaptés sans dépendre exclusivement de l’API de leur concepteur. Mistral associe ce choix au contrôle et à la personnalisation des modèles, à la conservation des données dans l’organisation et, surtout, à la réduction du verrouillage fournisseur : feuille de route, prix ou disponibilité ne dépendent plus entièrement d’un acteur unique.
C’est précisément la fracture mise en évidence dans le deuxième volet de notre enquête sur le ralentissement de la course à l’IA. Derrière l’affrontement États-Unis–Chine se joue aussi une bataille d’architecture : quelques modèles propriétaires accessibles par API face à des modèles dont les poids peuvent circuler, être modifiés et déployés localement. Pour l’Europe, ce choix touche directement à la souveraineté numérique et à la capacité de changer de fournisseur.
Pour Mistral, l’IA souveraine suppose donc de pouvoir contrôler, adapter et remplacer son modèle sans demander la permission à celui qui le possède. Le débat sur le ralentissement se complique d’autant : ralentir « la frontière » suppose encore de savoir laquelle, et selon quelle architecture technique.
The post Pour Mistral, la souveraineté de l’IA passe par les modèles à poids ouverts appeared first on INCYBER NEWS.
-
BRICS, WAICO, Dong Jun : la Chine bâtit son pôle de gouvernance mondiale de l’IA
incyber.orgPékin cherche désormais à donner une architecture institutionnelle à son offensive mondiale sur l’IA. Au sommet des BRICS de New Delhi, Xi Jinping a annoncé que la Chine entendait être « pionnière » dans la création d’une communauté BRICS open source pour l’IA : coopération sur les grands modèles, formations et construction d’un « écosystème ouvert ». Xi a aussi invité les BRICS à rejoindre WAICO. Créée le 16 juillet à Shanghai par 29 États, la World Artificial Intelligence Cooperation Organization (WAICO) est une organisation intergouvernementale internationale dont le siège se trouve en Chine. Pékin lui assigne notamment la réduction de la fracture de l’IA et le renforcement des capacités du Sud global.
Le dispositif commence ainsi à relier deux niveaux : un écosystème technologique fondé sur les modèles ouverts et une organisation capable d’offrir aux pays du Sud global une charpente institutionnelle, des standards et un forum de gouvernance.
Le 16 septembre, la pression chinoise est encore montée d’un cran. Au Forum de Xiangshan, le ministre chinois de la Défense, Dong Jun, a appelé les États à ouvrir des « dialogues de sécurité » sur l’IA et à renforcer l’évaluation des risques, le partage d’expérience et « l’établissement de règles et de gouvernance ». Le ministère chinois de la Défense résume la ligne de Pékin en appelant à renforcer la gouvernance de sécurité des domaines émergents. L’entrée du chef militaire chinois dans le débat signale une montée en puissance rapide : la gouvernance mondiale de l’IA devient aussi un dossier de sécurité stratégique et de rapport de force entre puissances.
Cette séquence éclaire directement notre enquête sur le ralentissement de la course à l’IA et le risque de cartel public-privé. Nous y montrions comment, aux États-Unis, le ralentissement de la frontière pouvait conduire à une coordination étroite entre pouvoirs publics, grands laboratoires et évaluateurs autour de standards communs, avec en filigrane, la volonté de contrôler la concurrence, notamment chinoise. Pékin construit un autre pôle : diffusion de modèles à poids ouverts, communauté BRICS, WAICO, puis appel à écrire des règles internationales. La rivalité porte désormais autant sur les modèles que sur l’architecture de gouvernance qui fixera les standards mondiaux et sur le cercle d’États et d’entreprises qui les écriront.
The post BRICS, WAICO, Dong Jun : la Chine bâtit son pôle de gouvernance mondiale de l’IA appeared first on INCYBER NEWS.
-
Ralentissement : le front du refus s’élargit
incyber.orgDario Amodei voulait organiser le freinage de l’IA. Ses adversaires commencent à organiser la riposte. Après Donald Trump, David Sacks et Jensen Huang, Mark Zuckerberg conteste à son tour le principe même d’un ralentissement coordonné de la course aux modèles frontières. Dans le même temps, le président de la Federal Trade Commission (FTC), Andrew Ferguson, s’attaque à son talon d’Achille : le droit de la concurrence.
Le patron de Meta estime que chaque laboratoire possède déjà de bonnes raisons de ne pas lancer un système qu’il juge dangereux : responsabilité juridique, confiance des utilisateurs et intérêt commercial. Il cite le retard de plusieurs mois imposé à l’agent Muse pour renforcer sa sécurité. Meta n’a pas attendu que ses concurrents en fassent de même. Zuckerberg accepte d’ailleurs le principe d’évaluateurs indépendants.
Andrew Ferguson pousse l’objection un cran plus loin. Dario Amodei réclame une exemption au droit antitrust afin de permettre aux grands laboratoires de coordonner leur ralentissement sans risquer d’être accusés d’entente. C’est précisément le mécanisme que nous analysions dans le premier volet de notre enquête sur le « cartel public-privé ». Or, le président de la FTC estime que « tout le monde devrait être profondément méfiant » lorsque des entreprises d’IA réclament simultanément de nouvelles réglementations et une exemption antitrust. Selon lui, « tous [ses] signaux d’alarme se déclenchent » car une telle combinaison pourrait, selon lui, créer des barrières à l’entrée protégeant les acteurs déjà installés. Il précise toutefois exprimer son opinion personnelle, et non une position formelle de la Commission.
Si personne ne remet en cause la dangerosité des modèles frontière, celle d’un cartel protégé par la puissance publique rencontre de plus en plus d’écho.
The post Ralentissement : le front du refus s’élargit appeared first on INCYBER NEWS.
-
La version française de WhatsApp s’emmêle les pinceaux avec son option de confidentialité avancée
www.numerama.com
Un des réglages de confidentialité de WhatsApp explique exactement l'inverse de ce qu'il est censé faire. Sur la version française de l'application, un contre-sens s'est glissé dans le texte censé rassurer les utilisateurs.
-
Les Français mieux informés sur les fuites de données mais plus exposés que jamais : le paradoxe inquiétant de la cybercriminalité
www.usine-digitale.frCes derniers mois ont été marqués par des fuites de données à répétition. La cyberattaque de la Direction générale des finances publiques (DGFiP) est l’un des exemples les plus récents. Ce phénomène se retrouve dans les chiffres : 45% des Français déclarent avoir été informés d’une fuite de données personnelles au cours des douze derniers mois, contre 30% en 2025.
-
Port de charges jusqu’à 22 kg, détection par IA renforcée… Agility Robotics passe à la vitesse supérieure avec son robot humanoïde Digit 5
www.usine-digitale.frDigit, le robot humanoïde d’Agility Robotics, fait peau neuve. La société américaine a présenté le 15 septembre la cinquième génération de son modèle phare, destiné à être déployé directement aux côtés des salariés en usines et entrepôts. “Digit 5 est le premier robot humanoïde d’Agility conçu pour un travail collaboratif sécurisé à grande échelle, lui permettant d’opérer à proximité des personnes sans les barrières de sécurité physiques requises par l’automatisation traditionnelle”, explique dans un communiqué l’entreprise basée à Salem (Oregon).
-
La course aux modèles les plus puissants s’intensifie : 4,4 mois séparent les modèles open source des géants de l’IA
www.numerama.com
Le 14 septembre 2026, Mozilla a publié une nouvelle version de son rapport State of Open Source AI. Un chiffre retient l'attention : les modèles ouverts accusent un retard de 4,4 mois sur la frontière fermée. Sur quoi se base précisément ce constat ?
-
Shuffle Drummer - FL Studio n'a qu'à bien se tenir
korben.infoMani Deïz m'a écrit il y a quelques mois pour m'annoncer qu'il avait sorti un super truc. Si vous ne connaissez pas Mani, c'est un beatmaker du rap indépendant français, du collectif Kids of Crackling.
Et voilà que le monsieur débarque avec Shuffle Drummer , une boîte à rythmes gratuite vraiment géniale qui tourne dans le navigateur. C'est lui qui l'a conçue, et son compère Olivier Kauffman qui l'a programmée. Ils ont été accompagné également de Romain Mithault qui l'a designée et de François Frimont qui également filé un gros coup de main au passage.

Le séquenceur après un appui sur la molette : kick, caisse claire et charleys posés sur seize mesure, swing à 58 % et c'est parti pour poser... ^^
Alors certes, des boîtes à rythmes dans le navigateur, je vous en ai déjà montré, à commencer par l'émulateur de la TR-808 et de la TB-303 de Roland. Sauf que celle de Mani ne s'arrête pas aux pads et aux faders, mais dispose de deux petites nouveautés.
La première c'est le timing. Vous avez votre séquenceur seize mesure, le moteur de shuffle et de swing, et surtout un mode TIMING qui vous laisse attraper une mesure allumée et la tirer hors de la grille, au tick près. Caisse claire en retard, charleys bourrés, kick poussé devant... C'est exactement ce qu'un beatmaker passe sa vie à faire à la main pour que ça ne sonne pas trop robotique, trop "quantifié".
La deuxième, c'est le sampler. Vous balancez une boucle dedans, vous la découpez, et il y a un bouton qui retire la batterie du sample pour ne garder que la mélodie et la basse. Du coup, vous pouvez poser vos propres drums par-dessus, ce qui est également l'une des base du métier de beatmaker.

Attention quand même, c'est de la séparation harmonique-percussive à l'ancienne, et pas un gros modèle IA entraîné pour l'occasion. Le bruit se répartit donc entre les deux composantes, et ça embarque souvent les voix au passage. Du coup, sur un morceau un peu chargé, vous risquez donc de retrouver des restes...
Pour le reste, il y a de quoi vous amuser avec 16 effets sur le bus master que vous chaînez par 4, une émulation du magnéto à bande Ampex ATR-102 pour coller du grain sur l'ensemble, et une vraie chaîne de mastering derrière, compresseur, limiteur et mesure LUFS. Le MIDI fonctionne aussi, mode MPC compris, si vous avez un clavier sous la main ( moi j'ai celui-là ) lien affilié.
Et ensuite, quand vous vous serez bien amusé avec, vous aurez peut-être l'envie pressante de cliquer sur le bouton "Save" pour sauvegarder votre beat et l'exporter, soit en wav, soit exporter les stems ou le master. Et pour ça, il faudra donc vous créer un compte avec votre email.

J'ai aussi regardé l'onglet réseau pendant que je chargeais un sample, pour vérifier que tout tournait en local, et je vous confirme donc que c'est le cas.
Bref, allez poser un beat et voyez ce que ça donne.
Bravo à Mani et ses collègues pour ce chouette outil créatif !
-
Test de l’iPhone 18 Pro Max : Apple a enfin compris
www.numerama.com
À 1 479 euros et 1 629 euros, les iPhone 18 Pro et iPhone 18 Pro Max sont les smartphones les plus aboutis de l'histoire d'Apple. La marque californienne, qui a longtemps privilégié le design au reste, continue de faire les bons choix matériels pour régler ses problèmes historiques. Nous avons testé l'iPhone 18 Pro Max pendant une semaine avant sa sortie, voici notre verdict.
-
Souveraineté : Axelera AI veut équiper les AI Factories européennes avec Europa, sa nouvelle puce dédiée à l’inférence
www.usine-digitale.frJusqu’ici positionnée sur l’IA en périphérie avec sa puce Metis, Axelera AI élargit son terrain de jeu en lançant « Europa », une nouvelle architecture destinée à des usages d’inférence plus exigeants en entreprise et dans les data centers. Contrairement à l’entraînement, l’inférence correspond à l’utilisation d’un modèle déjà entraîné pour produire un résultat.
-
Google punit-il les sites qui utilisent l’IA ? Notre avis sur le sujet
www.abondance.comArticle tiré de notre vidéo de rentrée, sponsorisée par RocketLinks.
Depuis la Spam Update d'août, cette question est revenue dans de nombreuses discussions, sur LinkedIn, Twitter et Reddit : est-ce que Google pénalise les sites qui utilisent l'IA ? Je comprends l'inquiétude. Une mise à jour anti-spam a sorti une page sur six du top 100, et la même semaine, une étude annonçait qu'un tiers des pages récentes du web portent des traces d'IA. Le lien entre les deux se fait vite.
J'ai pris le temps de regarder ce que dit Google, ce que mesurent les études disponibles, et j'ai analysé quelques sites web pour me faire mon propre avis. Cet article résume ces recherches. Je précise d'entrée que personne, en dehors de Google, ne peut affirmer avec certitude ce que ses systèmes font ou ne font pas. Ce qui suit est une analyse, avec ses hypothèses, et une conviction qui en découle. La vidéo ci-dessous reprend le même contenu.
Les chapitres de la vidéo :
- 00:00 Introduction : les AI Overviews, la Spam Update d'août 2026 et l'impact de l'IA sur le référencement
- 01:03 Notre sponsor : RocketLinks et le nouvel outil Benchmark GEO
- 02:37 La part grandissante de l'IA sur le web (études Pew Research Center et Ahrefs)
- 04:31 Les recommandations officielles de Google sur le contenu généré par IA
- 05:24 Le cas Grokipedia
- 06:25 Des sites générés avec l'IA qui gagnent du trafic
- 08:12 L'expérience utilisateur et la structuration de l'information
- 09:57 Conclusion : ce que Google pénalise réellement
Ce qu'il faut retenir :
- Google écrit dans sa documentation qu'il n'y a pas de pénalité pour le contenu IA. Ses porte-parole le répètent depuis 2023.
- 35 % des pages publiées depuis fin 2022 portent des traces d'IA (Pew Research Center). Un déclassement de cette ampleur aurait été visible. Il ne l'a pas été.
- 5,3 % des pages classées dans le top 3 sont entièrement écrites par une IA (Ahrefs, juillet 2026). Ces pages restent minoritaires, elles existent quand même.
- Grokipedia a perdu neuf pages sur dix dans Google en sept mois. Ce site réécrit ce que Wikipédia dit déjà, sans rien y ajouter.
- Utiliser l'IA ne pose pas de problème tant que l'éditeur garde la main sur le fond et sur la forme. Un template généré et des contenus non retravaillés se repèrent vite, par les lecteurs comme par Google. La checklist en fin d'article aide à faire le tri.
Pourquoi la question s'est posée cet été ?
Trois nouvelles sont tombées en trois semaines.
La Spam Update d'août 2026 a duré trois jours, du 18 au 21 août. C'est la troisième mise à jour anti-spam de l'année, contre une seule en 2025. D'après les relevés de Search Engine Land, 16,7 % des URL qui étaient dans le top 10 sont sorties du top 100, contre 9,2 % sur une période calme.
Le Pew Research Center a ensuite publié son étude sur la part de l'IA dans le web. Ce chiffre a beaucoup circulé, souvent sans sa nuance, j'y reviens plus bas.
Anthropic a enfin annoncé que les textes écrits par Claude porteraient un filigrane invisible. Ce sujet mérite son propre article. Dans les discussions, il a nourri l'idée que Google allait pouvoir repérer les textes IA.
Mis bout à bout, ces trois nouvelles donnent un raisonnement qui semble tenir : Google fait le ménage, le ménage tombe sur du contenu IA, donc Google pénalise l'IA. Reprenons chaque maillon.
Ce que Google dit concrètement
Sur ce sujet, je préfère citer la documentation plutôt que la paraphraser.
La page « Conseils de la recherche Google concernant l'utilisation de contenu généré par IA » existe depuis février 2023. Elle indique que Google récompense « un contenu de haute qualité, quelle que soit la manière dont il a été produit », et que l'usage de l'IA « n'est pas contraire à ses règles ». Ce qui l'est, c'est d'utiliser l'automatisation « dans le but principal de manipuler le classement ».
Les politiques anti-spam définissent la pratique visée, « l'abus de contenu à grande échelle » : « de nombreuses pages générées dans le but principal de manipuler le classement, et non d'aider les utilisateurs ». L'exemple donné juste en dessous mentionne l'IA : « utiliser des outils d'IA générative pour produire de nombreuses pages sans apporter de valeur aux utilisateurs ». Toute la phrase repose sur « sans apporter de valeur ».
Danny Sullivan, porte-parole de Google Search, l'a résumé ainsi : « Il n'y a pas de pénalité pour le contenu IA. Il y a une pénalité pour le contenu inutile. »
Jusqu'en mars 2024, cette politique s'appelait « contenu généré automatiquement ». Google l'a renommée en « abus de contenu à grande échelle », ce qui déplace le jugement de l'outil vers le résultat.
L'IA est partout sur le web
C'est un des arguments que j'avais envie de mettre en avant, parce qu'il me semble important.
L'étude Pew a analysé près d'un demi-million de pages en anglais. Elle conclut que 35 % des pages publiées depuis le lancement de ChatGPT montrent des signes d'écriture par IA. Sur l'ensemble du web analysé, toutes années confondues, c'est une page sur dix. Le tiers ne concerne que les pages récentes, et cette nuance a disparu de la plupart des reprises.
Ahrefs arrive à un chiffre plus haut encore sur un autre échantillon de 900 000 nouvelles pages (étude d'avril 2025) : 74,2 % contiennent du contenu généré ou assisté par IA, et seulement 2,5 % sont entièrement écrites par une machine. Le web s'écrit désormais avec l'IA. Une correction dans Gmail, une reformulation dans Docs ou un plan d'article demandé à ChatGPT suffisent à entrer dans cette statistique.
Si Google voulait pénaliser les sites qui utilisent l'IA, il devrait déclasser une part énorme de ce qui a été publié depuis trois ans. Rien de tel n'a été observé.
Ahrefs a publié fin juillet une étude qui va plus loin, sur un million de pages issues du top 10 de 100 000 requêtes. Parmi les pages classées de la première à la troisième position, 5,3 % sont entièrement écrites par une IA, et 82,2 % contiennent moins de 50 % de contenu IA mais elle en contient tout de même. Néanmoins, plus on monte dans les résultats, plus les pages entièrement générées par IA se raréfient.
Ahrefs et Pew le précisent eux-mêmes, et je le reprends à mon compte : les détecteurs d'IA se trompent régulièrement sur des textes humains, et rien n'indique que Google en utilise un. Ces études décrivent une tendance sur des centaines de milliers de pages. Elles ne disent rien de votre page dans son contexte et son environnement.
D'où un conseil : passer ses textes dans un détecteur d'IA n'apprend rien sur ce que Google en pense. Ce temps serait mieux investi à ajouter à la page une expérience ou un chiffre que personne d'autre n'a.
Grokipedia, le site 100 % IA qui a subi la Spam Update
Grokipedia est l'encyclopédie lancée par xAI, la société d'Elon Musk, en octobre 2025. Son contenu est intégralement écrit par l'IA Grok, à raison de plusieurs milliers d'articles par jour, avec environ 885 000 articles au lancement. C'est le site le plus visible au monde à être entièrement écrit par une machine, ce qui permet d'en parler sans mettre en difficulté un petit éditeur.
Voici son trafic organique estimé par Ahrefs, relevé le 16 septembre 2026 :
Fév. 2026 Mars Avril Mai Juin Juil. Août Sept. Trafic estimé 983 000 566 000 443 000 479 000 1,01 M 1,67 M 527 000 189 000 Le nombre de pages positionnées suit la même pente : 911 000 en février, 90 000 aujourd'hui.
La courbe contient deux chutes, avec un record entre les deux. Le consultant américain Glenn Gabe a décrit ce motif sous le nom de « Mt. AI » : les sites saturés de contenu IA montent vite dans Google, puis redescendent quand les systèmes se réajustent. Ces chiffres sont des estimations, et Google ne commente jamais le cas d'un site en particulier. Je constate une concordance de dates avec la Spam Update d'août, sans pouvoir prouver la causalité.
Ce qui m'a le plus marqué, c'est autre chose. Ouvrez le même sujet sur Grokipedia et sur Wikipédia. Vous ne trouverez aucune raison de préférer le premier. Ce site réécrit ce que Wikipédia dit déjà, en moins bien. Une page qui n'apporte rien de plus que le résultat d'à côté finit par sortir, quel que soit son auteur.
Plusieurs sites qui utilisent bien l'IA
J'ai cherché un site connu, entièrement écrit par une IA, qui réussisse dans la durée. Je n'en ai pas trouvé. En revanche, des sites qui utilisent l'IA pour produire à grande échelle une information utile existent, et leur trafic monte. J'en ai montré trois dans la vidéo. Les chiffres qui suivent sont du trafic organique mensuel estimé par Ahrefs, relevé le 16 septembre.
Feux de forêt, un site d'information sur les incendies en France : 7 400 visites en février, 58 000 en juin, 1,5 million en juillet, 800 000 en septembre. La saison explique le pic. Elle n'explique pas à elle seule des premières positions sur des milliers de requêtes locales. Ce site propose une donnée à jour, structurée feu par feu et commune par commune, que personne d'autre ne présente ainsi. L'IA sert à produire les pages. Elle n'invente pas ce qu'elles contiennent.
Présidentielle 2027, le site des candidats à la présidentielle : 0 visite en mai, 475 en juillet, 6 000 en août, 16 000 en septembre. Ce site a traversé la Spam Update en pleine progression. Chaque candidat a sa fiche, les informations sont vérifiables, et l'intention de recherche existe déjà à dix-huit mois du scrutin.
Le Meilleur Complément, sur les compléments alimentaires : des chiffres modestes, 500 visites en septembre, avec une hausse chaque mois depuis février, sur un secteur santé où Google est exigeant. Je le cite justement parce qu'il est petit. Le raisonnement vaut à toutes les échelles.
Ces trois sites répondent à une question que des gens se posent, avec une donnée qu'on ne trouve pas ailleurs, présentée de façon à être lue en quelques secondes. J'ai voulu illustrer ce dernier point dans la vidéo avec WikiCircuit et le site du RACC Trail : la structuration de l'information et l'expérience de lecture pèsent davantage que l'identité de celui qui a tapé les phrases.
Ce qui se voit, et ce qui fait la différence
Un point sur lequel j'ai envie d'insister, parce qu'il revient dans tous les sites que j'analyse.
Un template entièrement généré par Claude ou par un autre outil, ça se voit à cent mille kilomètres. Les mêmes blocs, les mêmes dégradés, les mêmes icônes, la même page d'accueil que des milliers d'autres sites sortis le même mois. Un contenu produit sans base de connaissance, sans suppression des tournures typiques de l'IA et sans règles éditoriales strictes, ça se voit aussi. Le lecteur le sent avant même de pouvoir l'expliquer, et je pense que les systèmes de Google finissent par le mesurer, à travers le comportement de ce lecteur.
Utiliser l'IA pour générer un site ou des contenus, je trouve ça très bien. On va plus vite, on teste plus d'idées, on publie des projets qui n'auraient jamais vu le jour autrement. Les trois sites cités plus haut en sont la preuve. La condition, c'est que l'éditeur garde la main sur deux choses.
Le fond : des contenus dont la qualité correspond à l'intention de recherche, des données fiables et sourcées, un contenu unique qui se différencie de ce qui existe déjà. Cela demande une base de connaissance propre au projet, des règles éditoriales écrites, et une relecture qui traque les tournures reconnaissables.
La forme : une direction artistique qui n'appartient qu'à la marque, des photos et des visuels personnels adaptés au sujet, un parcours utilisateur pensé et une interface soignée. C'est le travail le plus long, et celui que l'IA fait le moins bien sans direction.
Ce sont ces détails qui font la différence entre un site qui a sa place dans les résultats et un énième site produit par IA, que Google finira par écarter comme il l'a fait pour Grokipedia.
Une checklist pour vérifier son usage de l'IA
Google ne pénalise pas l'outil, d'après tout ce qui précède. Il reste à vérifier qu'on ne fait pas ce qu'il pénalise. Voici les huit questions que je me pose avant de mettre en ligne une page produite avec l'IA. Cochez celles auxquelles vous répondez oui, honnêtement, et regardez votre score en bas. La première compte plus que les autres.
1. Ma page répond à une vraie question. Quelqu'un tape cette recherche dans Google, et ma page lui donne ce qu'il attend. Une page qui existe seulement parce qu'un outil a trouvé un mot-clé part avec un handicap. 2. Ma page apporte quelque chose de plus que les autres résultats. Une donnée, un exemple, un test, une expérience. Si la réponse est « rien, à part une bonne rédaction », le risque est réel. 3. Mon rythme de publication est cohérent avec mon site. Trente contenus par jour se justifient pour Le Monde ou Le Parisien, qui ont une rédaction. Pour un site de dix personnes, ce rythme ressemble au motif industriel que les systèmes anti-spam cherchent : des grappes de pages sur le même gabarit. 4. Si je publie beaucoup de pages, chacune porte une information réelle. Feux de forêt ou Présidentielle 2027 indexent des milliers de pages sans difficulté, parce que chaque page contient une donnée qui a une raison d'exister. Le volume n'est pas un problème en soi. Les pages vides en sont un. 5. Un humain a relu la page. Un chiffre inventé ou une source qui n'existe pas arrivent sans prévenir. Une page que personne dans l'équipe ne peut défendre en réunion ne devrait pas être en ligne. 6. On sait qui a écrit la page, et sur quoi il s'appuie. Un auteur identifié, des sources citées, une date de mise à jour. Google appelle ça E-E-A-T. L'IA ne peut pas le faire à votre place. 7. La page se lit facilement, y compris sur mobile. Une réponse en haut, des titres clairs, un tableau quand il en faut un. 8. Mon site a une identité qui lui est propre. Un design, des visuels et un ton qu'on ne retrouve pas sur des milliers d'autres sites générés avec le même outil. Si votre page d'accueil pourrait être celle de n'importe quel projet, c'est un signal, pour vos visiteurs comme pour Google.Combien de cases avez-vous cochées ?
0 / 8
De 0 à 3 : la difficulté ne vient pas de l'IA. Reprenez d'abord les questions 1 et 2, elles conditionnent tout le reste.
De 4 à 6 : la base est là. Regardez les cases qui restent vides, ce sont souvent les points 5, 6 et 8, ceux que l'IA ne fait pas à votre place.
7 ou 8 : votre usage de l'IA ne me semble pas poser de problème. Continuez, et gardez un oeil sur les prochaines mises à jour.
Pour conclure
D'après tout ce que j'ai pu lire et mesurer, Google ne s'en prend pas à l'intelligence artificielle. Il s'en prend aux pages produites en série qui n'apportent rien, et cela date d'avant ChatGPT. Je peux me tromper, et je resterai attentif aux prochaines mises à jour. À ce stade, rien dans la documentation ni dans les données ne va dans l'autre sens.
La question à se poser en 2026 n'est plus « peut-on utiliser l'IA pour générer nos contenus » mais « qu'est-ce ma page apporte réellement à un utilisateur », et de ce que vous seriez prêt à défendre si on vous le demandait. Votre expérience, vos données et vos exemples restent ce qui vous protège le mieux.
Si vous avez constaté un impact sur vos sites depuis la Spam Update, ou si vous avez un contre-exemple, les commentaires sont ouverts. Je lis tout et je réponds.
L’article "Google punit-il les sites qui utilisent l’IA ? Notre avis sur le sujet" a été publié sur le site Abondance.
-
La série Orgueil et Préjugés de Netflix déclenche la colère des fans de Jane Austen
www.numerama.com
À peine dévoilée en détails, la nouvelle adaptation d'Orgueil et Préjugés en série par Netflix suscite déjà une vive levée de boucliers de la part de certains fans de Jane Austen.
-
Le marché et les tribunaux suffiront : Mark Zuckerberg s’oppose fermement aux appels à ralentir l’IA
www.numerama.com
Le patron de Meta n'a aucune intention de lever le pied sur l'intelligence artificielle. Alors qu'une partie de la Silicon Valley réclame un coup de frein, Mark Zuckerberg répond que le marché et les tribunaux suffiront à tenir la technologie.
-
Amazon baisse le prix de l’aspirateur laveur Dreame T16 Pro, noté 9/10 par la rédaction
www.numerama.com
[Deal du jour] Le Dreame T16 Pro Heat-A, l'aspirateur laveur haut de gamme de la marque qui aspire et lave les sols à l'eau chaude, passe à 549 € au lieu de 629 € sur Amazon.
-
CYBER 2027 Cyberattaques : l’État face à son devoir d’exemplarité
incyber.orgFin décembre 2025, une faille technique sur ÉduConnect, la plateforme d’authentification de l’Éducation nationale, expose les données de plus de trois millions d’élèves. Elle sera révélée seulement quatre mois plus tard, le 14 avril 2026. Le lendemain, l’Agence nationale des titres sécurisés (ANTS), devenue France Titres, est victime d’une intrusion sur son portail en ligne, exposant les données de 11,7 millions de comptes d’usagers ayant sollicité une carte d’identité, un passeport ou un permis de conduire.
Ces deux épisodes ne constituent pas des cas isolés. La Direction générale des finances publiques (DGFiP) a enchaîné trois incidents durant l’été 2026 : un accès illégitime à des données fiscales concernant 678 000 particuliers et professionnels fin juin, une compromission de son service cadastral, avec 1,8 million de comptes touchés fin juillet, puis une vulnérabilité exposant certaines données du portail des successions vacantes, découvertes en août, dont le périmètre reste alors à évaluer.
Une responsabilité publique difficile à localiser
Selon Cédric Mermilliod, Cofondateur & Co-CEO d’Oodrive, cette accumulation d’incidents – notamment pendant l’été – a produit un effet de seuil : « Les incidents liés à la DGFiP ont constitué une prise de conscience très importante. Tout le monde en a parlé. Je n’ai jamais eu autant de retours à ce sujet ». Pour lui, la responsabilité première revient à l’État dès lors qu’il collecte et conserve des données de citoyens, même lorsque l’exécution technique mobilise plusieurs acteurs : “L’État, qui collecte des données sur les citoyens, est le seul responsable de leur fuite en cas de cyberattaque”.
Cette position tranche avec celle de Servane Augier, directrice Affaires Publiques chez Numspot. Avant d’interroger la responsabilité de l’État, elle rappelle que le risque cyber n’épargne aucun acteur, quel que soit son niveau de maturité : « Même avec les référentiels SecNumCloud, qui garantissent la mise en place des mesures les plus avancées et une réduction du risque et des impacts, personne ne peut dire qu’il ne sera pas la prochaine cible ». Cette humilité affichée ne dédouane pas pour autant l’État de ses obligations. Servane Augier pose plutôt le principe suivant : celui de distinguer l’incident technique, auquel n’importe quelle organisation reste exposée, de l’arbitrage organisationnel, qui relève directement des choix faits par chaque organisation.
Hicham Ben Hassine, dirigeant d’AlgoSecure, cabinet de conseil en cybersécurité, déplace quant à lui le débat vers la question qui structure l’ensemble de la problématique : « Qui prend concrètement la responsabilité en cas de cyberattaque ? Est-ce le RSSI local de l’entité en question, l’Agence nationale de la sécurité des systèmes d’information (ANSSI), un service qui dépend d’un ministère, le fournisseur ou le haut fonctionnaire de défense et de sécurité ? » Hicham Ben Hassine justifie cette difficulté par le nombre d’acteurs impliqués : « Chacun a des contraintes juridiques vis-à-vis de l’autre. Dans un écosystème comptant de nombreux fournisseurs, la responsabilité est multiple ».
Le paradoxe d’un État qui exige sans toujours s’appliquer les mêmes règles
À la complexité de la chaîne d’acteurs s’ajoute une seconde problématique : l’écart entre les exigences imposées aux prestataires privés et celles que l’État applique à ses propres services. Servane Augier résume cette particularité en une phrase : « Fais ce que je dis, pas toujours ce que je fais ». Ce principe trouve une illustration concrète dans les environnements internes de l’État, baptisés Pi et Nubo.
“La doctrine Cloud au centre impose aux administrations d’utiliser ces environnements. Elle prévoit aussi le recours à une offre qualifiée SecNumCloud pour héberger les données sensibles. Mais l’administration ne s’est jamais appliquée la règle qu’elle impose pourtant aux autres : que Pi et Nubo soient SecNumCloud”. Un constat que confirme la fiche officielle de l’État sur son propre cloud interne, qui précise que ces deux offres restent, à ce jour, “non soumises à la qualification SecNumCloud”.
Hicham Ben Hassine met en avant le même paradoxe, mais sous l’angle des sanctions. Les entreprises s’exposent aux amendes de la Commission nationale de l’informatique et des libertés (CNIL) en cas de manquement au Règlement général sur la protection des données (RGPD). L’État, de son côté, n’est que très rarement inquiété pour ses propres défaillances, même s’il arrive que des entités publiques soient sanctionnées : la CNIL a ainsi infligé une amende de 5 millions d’euros à France Travail en janvier 2026, après une faille de sécurité ayant exposé les données de millions de demandeurs d’emploi.
Audit, souveraineté, réversibilité : trois leviers d’exemplarité
Face à ce constat, les trois experts interviewés convergent vers des réponses opérationnelles. Hicham Ben Hassine propose de systématiser le contrôle indépendant. « Tous les accès externes des services sensibles doivent être vérifiés, a minima une fois par an », déclare-t-il. Il insiste également sur la nécessité de surveiller en continu tout ce qui reste exposé sur Internet, plutôt que de se limiter à un contrôle ponctuel : « La plupart des fuites ne viennent pas de l’intérieur, mais d’une porte d’entrée externe : un compte compromis, ou une vulnérabilité non corrigée et finalement exploitée. C’est pour cela qu’il faut analyser en continu la surface d’attaque externe, c’est-à-dire l’ensemble des portes d’entrée visibles depuis Internet pour un système d’information ». Il associe par ailleurs cette exigence à des critères de souveraineté et de réversibilité. « Même en choisissant une solution souveraine, vous pouvez tomber sur un acteur qui détient le monopole en France, et vous retrouver trop dépendant de lui. Il faut donc garder la maîtrise, et savoir comment ‘sortir’ si le service ne convient pas », note-t-il.
Servane Augier constate de son côté que les projets d’intelligence artificielle accélèrent la migration des administrations vers des clouds de confiance, portés par des besoins croissants en puissance de calcul. Elle signale toutefois un angle mort réglementaire : « La certification d’hébergement de données de santé (HDS) n’embarque aujourd’hui aucun critère réglementaire contraignant sur la souveraineté des données ». L’enjeu consiste donc à classer les informations selon leur sensibilité, puis à concentrer les efforts sur les environnements où une compromission aurait des conséquences directes pour les citoyens, les services publics ou l’économie.
Quant à Cédric Mermilliod, il défend une réponse organisationnelle à travers la centralisation de la politique cyber de l’État sous l’autorité d’un ministère du Numérique. Il propose qu’Hexatrust, l’association qu’il représente, participe directement à l’élaboration de cette doctrine commune : « La France dispose de tout ce qu’il faut. Chez Hexatrust, nous recensons un nombre considérable de pépites capables de fournir aux services de l’État les bonnes solutions ». Sur le plan budgétaire, il conteste l’idée qu’une telle réorganisation coûterait davantage à l’État : « Chaque ministère dépense aujourd’hui isolément, sans économie d’échelle, pour un résultat équivalent. Nous pourrions consacrer la même somme à une doctrine commune qui fonctionnerait mieux. Ce que nous disons, ce n’est pas de dépenser plus, mais de dépenser mieux, en orientant ce budget vers les entreprises – françaises et souveraines – qui ont les bonnes solutions ».
À l’approche de l’élection présidentielle, ces attentes convergent vers une même exigence : que l’État se soumette aux mêmes obligations d’audit, de transparence et de responsabilité qu’il impose au secteur privé. La confiance numérique ne peut pas reposer uniquement sur des annonces après incident. Elle suppose une doctrine lisible, des contrôles réguliers, une chaîne de décision identifiable et la capacité, pour les citoyens comme pour les acteurs économiques, de savoir qui répond lorsque les données publiques sont exposées.
The post <strong>CYBER 2027</strong> Cyberattaques : l’État face à son devoir d’exemplarité appeared first on INCYBER NEWS.
-
Le co-créateur de ChatGPT lance « Jev », un modèle qui ne rédige rien et c’est là toute la solution
www.numerama.com
Diogo Almeida, chercheur passé par OpenAI, lance un modèle d'IA qui refuse de générer du texte. En quelques heures, l'annonce a suscité un engouement exceptionnel, voici pourquoi.
-
Ralentissement de l’IA : les grands labos se parlaient déjà en coulisses
incyber.orgLes grands labos n’ont pas attendu septembre pour se découvrir une passion commune pour le ralentissement. Chris Lehane, responsable des affaires mondiales d’OpenAI, affirme que son entreprise discute « depuis plusieurs semaines » avec Anthropic et Google DeepMind de sécurité de l’IA. Les échanges, précise-t-il, peuvent déjà avoir lieu sans exemption antitrust.
La précision renforce directement notre enquête sur le possible cartel public-privé de l’IA. Nous avions montré que les appels publics d’Amodei, Altman et Hassabis arrivaient après des mois de coopération industrielle et de travaux réglementaires. On sait désormais que leurs entreprises échangeaient aussi directement avant cette soudaine convergence publique.
Si le cartel n’est pas encore formellement constitué, le schéma se dessine plus précisément : la coordination entre concurrents existe déjà sur la sécurité. Reste à savoir s’ils peuvent aussi s’entendre légalement pour ralentir ensemble. C’est précisément ce que le CATS Act cherche à permettre.
The post Ralentissement de l’IA : les grands labos se parlaient déjà en coulisses appeared first on INCYBER NEWS.
-
Fuse-archive - Vos ZIP montés en dossiers ordinaires
korben.infoPour votre système d'exploitation, une archive c'est juste un fichier. Un seul gros fichier bien opaque qu'il faut ouvrir avec un outil dédié, ou décompresser quelque part avant de pouvoir travailler dedans.
C'est pour cela que je vous présente aujourd'hui l'outil fuse-archive qui prend le problème à l'envers en présentant ce fichier comme un dossier ordinaire, en lecture seule, que vous pouvez parcourir avec ls, cat, grep, votre éditeur ou votre visionneuse d'images.
En gros, vous lui donnez l'archive, un nom de dossier, et c'est tout. Ensuite, il le monte comme une partition normale :
fuse-archive foobar.tar.gz mnt
tree mnt
umount mnt
La liste des formats supportés, c'est celle de libarchive, donc elle est assez longue : ZIP, 7z, RAR, TAR compressés de toutes les façons, ISO, paquets DEB et RPM, archives WARC du web.
Vos DOCX, vos EPUB et vos APK étant des ZIP sous un autre nom, ils se monteront pareil, et quand l'extension ne sera pas reconnue, l'outil ira lire les premiers octets pour trancher tout seul.
Et puis vous n'êtes pas obligé de vous arrêter à une archive. Si vous lui en passez trois d'un coup, il les fusionne en une seule arborescence sous le même point de montage, comme si leur contenu avait toujours été rassemblé. Avec le paramètre -o nomerge, il donnera aussi à chaque archive son propre sous-dossier, et quand deux fichiers portent le même nom, il numérote le second en file (1).txt.
Là où je trouve ça trop cool, c'est sur les archives chiffrées. En effet, un ZIP protégé par mot de passe se montera sans souci, AES-256 compris. L'outil vous demandera simplement son mot de passe. Ça permet donc de consulter un document confidentiel sans en laisser de copie déchiffrée derrière vous.
Deux limites quand même sur le chiffrement... Le format chiffré des 7z et des RAR n'est pas géré, et un fichier à double couche comme un tar.gz.gpg réclamera le paramètre -o maxfilters=2, puisque l'outil n'en traite qu'une seule par défaut.
Maintenant, cette lecture sans copie en clair nécessite que fuse-archive décompresse l'archive entière dans un fichier temporaire anonyme, posé dans votre TMPDIR ou, à défaut, dans votre /tmp. Ça peut donc prendre beaucoup de place sur le disque, et votre document confidentiel s'y retrouvera en clair jusqu'au démontage, où le fichier sera supprimé. Toutefois, avec le paramètre -o lazycache, il ne décompressera que ce que vous ouvrez vraiment, et le temporaire grossira alors au fil de vos lectures de fichiers au lieu de tout remplir d'avance. Et avec le paramètre -o nocache, il ne gardera rien sur le disque (au prix de relectures plus lentes).
Notez que ce mode lazycache ne vous fera gagner du temps et de l'espace disque que sur les formats à accès direct, du genre ZIP, 7z ou RAR. Un tar.gz, comme une archive chiffrée, sera parcouru en entier de toute façon, rien que pour lister ses fichiers.
Maintenant pour du vrai accès direct sur ces formats, je vous invite plutôt à jeter un oeil à ratarmount qui relève la position de tous les fichiers du TAR pour sauter droit à celui que vous demandez (et lui s'installe d'un simple pip install).
Ah et j'ai failli oublier, le dépôt s'appelle mount-archive, mais la commande, elle, s'appelle toujours fuse-archive.
-
La Forge - Le GitLab public des profs codeurs
korben.infoJe ne sais pas si vous êtes déjà tombé dessus, mais le ministère de l'Éducation nationale fait tourner son propre GitLab depuis un petit moment maintenant, il est public, et il s'appelle La Forge des communs numériques éducatifs . Au moment où j'écris ces lignes, il y a dessus 12 896 projets et 15 638 membres dans ce qu'ils appellent "l'atelier".
Alors c'est quoi cette dinguerie comme disent les anciens ? Hé bien derrière, c'est du GitLab CE, infogéré par le pôle de compétences Logiciels Libres (oui, ça existe, et c'est un vrai service de l'Éducation nationale), et classé dans les services partagés d' apps.education.fr .

Les 595 ressources de la ressourcerie, avec les étiquettes de niveau et de discipline sous chaque fiche
Et le plus beau c'est que pour aller fouiller dedans, vous n'avez besoin de rien du tout puisque les dépôts publics s'ouvrent via le navigateur, sans authentification.
Bien sûr, cette grosse dizaine de milliers de dépôts de code bruts, ça ne se visite pas comme ça. Il y a donc une vitrine, nommée la ressourcerie , qui en met en avant un peu moins de 600, triées par niveau, par discipline et par tag et pour la plupart, testables en ligne.
Par contre, pousser du code est un poil plus encadré. Pour cela, le personnel du ministère doivent avec leur compte Apps, et tous les autres, profs retraités, universitaires, Inria, boîtes de l'EdTech, associations, et j'en passe, passent par un second annuaire avec validation préalable.
Donc non, vous ne pourrez pas y déposer votre side-project éducatif du week-end, mais si votre truc sert vraiment à des profs, la porte n'est pas fermée...
Là-dessus l'Éducation nationale n'est pas toute seule, puisque les Pays-Bas ont également monté leur forge de code , où une cinquantaine d'administrations et de communes publient déjà.
Et l'IA là-dedans ?
Hé bien c'est complètement décomplexée et tant mieux ! Le catalogue a 7 tags officiels rien que pour ça, de "IA chatbot" à "IA prompt" en passant par "IA LLM souverain", et 48 fiches en font partie. Ce n'est donc pas la majorité du catalogue, mais il y a quand même un projet nommé EduVaibe dont le boulot est de "générer, étape par étape, un prompt complet à coller dans une IA pour créer des applications numériques éducatives".
Le truc le plus utile du lot, je trouve, même quand on n'a aucune classe à gérer, c'est ChatMD . Vous forkez le dépôt, vous remplacez le contenu d'index.md par vos propres réponses écrites en Markdown, et votre agent conversationnel bien à vous est ensuite accessible à partir d'une simple URL. Le tout est sous licence MIT bien sûr !
Maintenant derrière une bonne partie de ces dépôts, il y a un prof tout seul qui bricole sur son temps libre, et malheureusement, le jour où il abandonne, le projet s'arrête. Mais la bonne nouvelle c'est que la Forge rétribue chaque année quelques profs pour justement les soutenir dans leurs projet.
C'est maigre à l'échelle d'un ministère, je vous l'accorde, mais c'est quand même mieux que rien. Voilà, en attendant, je vous invite à y faire un tour ! Vous y trouverez peut-être des choses intéressantes.
Merci à Sylvain Bruyère pour le lien !
-
Pour Salesforce, les agents IA vont remplacer l’interface utilisateur des CRM
www.usine-digitale.frSalesforce ne se contente pas d’ajouter des fonctionnalités d’intelligence artificielle supplémentaires à son CRM. L’éditeur veut revoir la manière dont les entreprises utilisent leurs logiciels. Son pari : demain, les salariés ne navigueront plus nécessairement dans Salesforce pour travailler. Ils demanderont à des agents de le faire à leur place, tandis que la valeur se déplacera vers les données, les processus et les règles métier qui se trouvent derrière l’interface.
-
Goossips SEO : Positionnement
Goossip #1www.abondance.comLa notion de positions a moins de sens aujourd’hui
John Mueller a réagi sur Reddit à des questions sur la manière dont les impressions sont comptabilisées pour les résultats IA générative dans Search Console. Google dispose déjà d'un document d'aide sur le sujet, mais John Mueller reconnaît que c'est un document assez dense.
Son message principal : l'ancienne notion de « position 1 à 10 » ne correspond plus à la réalité des pages de résultats actuelles, qui comportent AI Overviews, featured snippets, "People Also Ask" et de nombreux autres blocs. Pour les fonctionnalités liées à l'IA générative, Google suit donc les positions comme un bloc global plutôt que ligne par ligne, sans détail séparé dans le rapport de performance Gen-AI.
John Mueller précise qu'il n'y a pas de solution simple pour rendre cette donnée de position "utile" aux propriétaires de sites, et il dit être ouvert aux suggestions de la communauté SEO sur ce qui serait pertinent à suivre.
Source : Search Engine Roundtable
Taux de fiabilité :
 On est d'accord !
Étant donné l’évolution des formats dans les SERP, reconnaissons en effet que la notion de première position n’existe plus vraiment. Tout du moins, telle qu’on pouvait la concevoir par le passé.
L’article "Goossips SEO : Positionnement" a été publié sur le site Abondance.
-
Test d'une batterie externe et dock magnétique Antank pour Nintendo Switch 2
- Contient des liens affiliés Amazon -korben.infoJ'ai mis du temps à vous parler de ces deux accessoires Antank pour la Switch 2. Ça fait quelques semaines que je décale ce test, surtout parce que je ne voyais pas bien ce que j'allais raconter sur une batterie externe et un support pour Switch, car je ne comprenais en fait pas du tout le concept. Puis j'ai ouvert les boîtes, j'ai testé le truc, et bah en fait c'est top.
Pour faire simple, la batterie B5 se fixe au dos de la console avec un système magnétique et elle tient super bien. J'avais assez peu d'attentes sur ce produit, mais la fixation est vraiment stable et la batterie fait très bien son boulot en déplacement ou sur des longs trajets.

Il y a une coque très fine à installer sur la console, puis on vient y aimanter la batterie et brancher le petit câble USB-C fourni. Tout est regroupé derrière la Switch, ce qui évite d'avoir une batterie à poser quelque part pendant qu'on joue, avec un câble qui part de la console pour aller jusqu'à elle.
La B5 a une capacité annoncée de 10 000 mAh, avec une recharge filaire jusqu'à 30 W, et elle pèse 213 grammes. Vous ajoutez donc ce poids à celui de la console, mais ça n'est pas du tout gênant en fait, surtout, pour un accessoire qui coûte actuellement 55,99 euros sur Amazon.fr. Notez que la batterie est aussi MagSafe pour votre iPhone potentiel, si besoin, et elle le chargera donc sans fil.
Elle fonctionne aussi avec les premières Switch et les Switch OLED grâce à l'autre clip fourni, mais pas avec la Switch Lite.

J'ai aussi utilisé le support SW2 Hub proposé aussi par la marque en complément, et je le trouve moins indispensable que la batterie. Il permet de poser la console sur un socle pliable dont on règle l'inclinaison, avec une sortie HDMI pour la TV. Le truc permet surtout de laisser la fixation au dos de la Switch quand on passe du jeu portable au téléviseur. Vu que je ne joue jamais branché à la TV, ça ne m'est pas utile, mais si vous avez un usage mixte, c'est nickel.

C'est bien pratique en tout cas. Cette partie qui reste sur la console est fine et légère, et elle ne pose aucun problème au quotidien.
Le hub ajoute deux ports USB-A et deux USB-C, ainsi qu'une prise Ethernet pour le réseau filaire. Il est affiché à 53,95 euros sur la boutique française d'Antank, séparément de la batterie.
Voilà, donc c'est carrément validé si vous manquez un peu de jus dans votre Switch ou Switch 2.
Pour la batterie, c'est par ici sur Amazon . Pour le dock, c'est par ici sur le site du fabricant (avec un coupon de 10% de remise, que je n'ai pas testé, je ne sais pas s'il fonctionne encore : ANT10)
-
Robots humanoïdes : Bousculé par des débuts volatils en Bourse, Unitree revient avec une version améliorée de son modèle G1 à 15 000 dollars
www.usine-digitale.fr18 000 : c’est le nombre de robots humanoïdes bipèdes que l’entreprise chinoise Unitree revendique avoir produit, selon des déclarations publiées en août. La société basée à Hangzhou ne compte pas s’arrêter en si bon chemin : elle a dévoilé le 14 septembre G1+, une version améliorée de son robot phare G1 sorti il y a plus de deux ans.
-
Agents autonomes, responsabilité introuvable : le paradoxe silencieux qui s’installe au cœur de la cybersécurité
www.usine-digitale.frLa sécurité informatique entre dans une zone de turbulence. Jusqu’ici, la responsabilité restait lisible : un hacker décidait d’agir, un outil exécutait et un défenseur tentait de bloquer. Les agents d’IA brouillent cette séparation. Ils reçoivent un objectif mais déterminent eux-mêmes une partie des étapes nécessaires pour l’atteindre. Ainsi, le risque réside dans ce qu’ils peuvent décider de faire entre deux instructions.
-
Discord est tombé en panne : voici ce que l’on sait
www.numerama.com
Panique chez les gamers, les communautés en ligne et les travailleurs du Web : Discord subit actuellement une panne d'ampleur et c'est mondial.
-
Ralentir la course à l’IA : vers un cartel public-privé ? 2/2
incyber.orgLe cartel américain face au challenger chinois
Le système se heurte toutefois à une équation simple : ralentir ensemble aux États-Unis ne sert à rien si Pékin utilise le répit pour passer devant.
Washington ralentit, Pékin accélère
Amodei accompagne donc le frein intérieur d’un verrou extérieur : contrôle des puces avancées et des équipements de fabrication, restrictions sur certains accès distants à la puissance de calcul, protection des poids des modèles et lutte contre la distillation, technique par laquelle un acteur tente de reproduire les capacités d’un modèle en l’interrogeant massivement. CATS incorpore lui aussi ce problème en couvrant notamment le vol, la distillation et certains développements profitant à un pays considéré comme adversaire.
La Chine récuse le freinage à l’américaine : le ministère chinois des Affaires étrangères estime que « la peur, la confrontation et la compétition vicieuse » ne peuvent que perturber la gouvernance mondiale de l’IA. Au contraire, Pékin pousse l’intégration de l’IA dans toute son économie, même si les autorités développent parallèlement leurs propres garde-fous. (43)
La proximité technologique rend toute pause américaine délicate : en mars, le Stanford AI Index 2026 ne mesurait plus qu’un écart de 2,7 % entre le meilleur modèle américain et le meilleur chinois, tandis que le CAISI estimait DeepSeek V4 Pro à environ huit mois de la frontière américaine. (44) (45) La rivalité géopolitique suffit donc à compliquer le ralentissement collectif. Elle masque cependant une fracture plus directement structurante pour les utilisateurs.
Modèles fermés contre poids ouverts : l’autre ligne de front
Derrière le duel Washington-Pékin se superpose une autre ligne de front : modèles fermés contre modèles à « poids ouverts ». Les premiers gardent leurs paramètres chez le fournisseur et se consomment surtout par ses services ; les seconds rendent leurs poids téléchargeables, inspectables, modifiables et exécutables sur l’infrastructure choisie par le client, même si le code d’entraînement, les données ou la licence ne sont pas forcément entièrement open source. (46)
Cette architecture ne se gouverne pas de la même façon. Un fournisseur peut retarder, filtrer ou retirer l’accès à un modèle fermé. Une fois les poids publiés, le dentifrice est sorti du tube et ne peut plus y rentrer : Microsoft le reconnaît lui-même dans sa lettre du 24 juillet, qui défend ces modèles pour la concurrence et le contrôle des clients, tout en soulignant que les versions modifiées deviennent difficiles à tracer ou à inverser. Le clivage ne recoupe d’ailleurs pas proprement les frontières nationales : Google, Meta, OpenAI, Nvidia, SpaceX et Mistral figurent aussi parmi les signataires de cette lettre. (46)
La Chine a néanmoins fait de l’ouverture un axe industriel. Son plan du 17 juillet appelle à bâtir des communautés internationales open source et à partager modèles génériques, algorithmes et outils. Les développeurs chinois promeuvent de plus en plus les poids ouverts, là où Anthropic et OpenAI gardent les leurs fermés. (47) (43) Stanford mesurait encore en mars un avantage de 3,3 % du meilleur modèle fermé sur le meilleur modèle ouvert. (44)
C’est très peu au regard de la différence de coût et de la souplesse d’exploitation des uns et des autres : le modèle fermé concentre chez le fournisseur l’accès, les garde-fous et la tarification. Les poids ouverts rendent possible l’hébergement local, l’adaptation et le changement de prestataire. Pour l’Europe, cette marge de manœuvre peut compter davantage au quotidien que le drapeau du laboratoire.
C’est le principal angle mort du pacing. Un système de checkpoints, d’accès contrôlé et de retrait éventuel épouse naturellement l’économie des API fermées. Face à des modèles ouverts, il risque de se transformer en handicap réglementaire.
Trump peut encore renverser la table
C’est ce qu’a bien identifié Donald Trump. Le 13 septembre, il a estimé à propos des risques liés à l’IA qu’il y avait « beaucoup de forces très négatives qui soulèvent la question alors qu’elles ne devraient pas le faire, et qui évoquent des choses qui ne se produiront pas. » Comme souvent, sa maxime tient en quelques mots : « celui qui gagne l’IA gagne ». (48)
Selon le président américain, toute tentative de limiter cette technologie relevait d’un « complot malsain » et « l’idée que l’IA prenne le contrôle du monde, détruise l’humanité et cause toutes sortes de catastrophes est un canular. » (49)
Le refus présidentiel n’empêche cependant déjà plus la machine de s’ébranler. Le 14 septembre, Mike Johnson, président républicain de la Chambre des représentants, a annoncé vouloir convoquer les dirigeants du secteur pour « une grande réunion », « régler cela tous ensemble dans la même pièce » et en faire une priorité du Congrès.
Kevin Hassett, directeur du National Economic Council, annonce de son côté des réunions prochaines entre responsables de la Maison-Blanche chargés du cyber, de la science et de la technologie, et n’exclut pas une rencontre de Trump avec des parlementaires. Le canal direct existe pourtant déjà : Sam Altman a rencontré Donald Trump en privé, en marge de la convention républicaine de Dallas des 9 et 10 septembre, pour parler d’intelligence artificielle. (49) Hakeem Jeffries, chef de la minorité démocrate à la Chambre, réclame parallèlement une action « décisive » pour ralentir le rythme du développement des IA. (50)
Depuis le sommet de l’exécutif, JD Vance formule lui aussi une objection qui est sur toutes les lèvres. Le 14 septembre, le vice-président a dit trouver « un peu étrange » de voir autant d’entreprises d’IA de pointe « venir supplier le gouvernement de les réglementer ». « Cela ressemble un peu à un cheval de Troie », ajoutait-il. (49)
La réplique touche le cœur de notre enquête : si Amodei et Altman pensent réellement devoir freiner, pourquoi leur faut-il une architecture politique permettant à tous les concurrents de freiner avec eux ? Le dilemme du prisonnier fournit une réponse économique. Vance en fournit une autre, moins charitable : quand les leaders d’un marché demandent eux-mêmes au gouvernement d’en écrire les garde-fous, la capture réglementaire devient une hypothèse sérieuse.
En parallèle, à l’approche des élections de mi-mandat, la bataille devient de plus en plus partisane. Barack Obama vient d’exhorter les démocrates à faire de l’intelligence artificielle un sujet majeur de la campagne de 2028 et à préparer un « cadre », pour une discussion publique et une politique mêlant sécurité et économie, si son parti reprenait la Chambre. (51)
Chez les partisans de l’accélération, le soupçon de capture réglementaire monte aussitôt. L’investisseur Mark Kretschmann résume cette lecture dans un post : transformer une technologie de rupture en campagne de peur permettrait ensuite à Washington de décider « qui peut la construire, à quelle vitesse et qui y accède ». (52) De fait, son opinion se trouve confortée par le CATS et le projet Hassabis, puisque ces deux dispositifs proposent précisément de donner à des structures hybrides un pouvoir sur le rythme, les standards ou l’accès au marché.
La Maison-Blanche actuelle a elle-même déjà installé une étrange première brique. Le décret présidentiel Executive Order 14409 du 2 juin crée un référentiel classifié des capacités cyber des modèles avancés et prévoit un dispositif volontaire dans lequel gouvernement et développeurs peuvent déterminer qu’un système appartient aux modèles frontières couverts par le décret. Ils peuvent ensuite sélectionner ensemble des « partenaires de confiance » qui obtiendront un accès précoce. Le décret précise expressément qu’il ne crée aucun régime obligatoire de licence, de préautorisation ou de permis pour publier un modèle. (53)
L’Anneau peut être presque forgé, encore faut-il que Washington accepte de le passer au doigt. Pour l’heure, Trump s’inquiète plus de la Chine que de la fin de l’humanité, CATS dort en commission et Vance voit dans la demande de régulation des industriels un possible « cheval de Troie » alors que les rivalités entre laboratoires restent féroces.
Le processus est engagé. Son succès, lui, est loin d’être acquis.
Mistral et la cyber européenne dans le filet
L’Europe aurait tort d’attendre la fin de la bataille américaine, plus encore de s’en réjouir.
Mistral : l’extraterritorialité sans loi extraterritoriale
De fait, si le CATS Act ne placerait aujourd’hui aucune obligation directe sur Mistral en France, l’extraterritorialité potentielle passe par le marché américain, les processeurs graphiques, le cloud, les financements, les assurances, les marchés publics et demain, peut-être la certification.
Le Standards Body de Hassabis envisage déjà qu’un modèle étranger, ouvert ou fermé, doive satisfaire à son processus s’il veut entrer sur le marché américain. Un acteur européen pourrait donc cumuler demain les lourdes obligations de l’AI Act européen, des évaluations américaines et des dépendances infrastructurelles envers les États-Unis. De plus, pour une entreprise pesant une fraction de Google ou Microsoft, le même coût fixe de conformité ne produit pas le même effet économique. La norme n’a pas besoin d’annoncer son extraterritorialité, le marché et les infrastructures s’en chargent très bien.
Berlin vient d’ailleurs de poser sa propre ligne rouge : arrêter le développement de l’IA n’est « pas une option viable » pour l’Europe, notamment au nom de la souveraineté numérique. Une déclaration qui n’engage à pas grand-chose, aucun modèle européen n’étant aujourd’hui au niveau des tout meilleurs modèles mondiaux. Le gouvernement allemand juge qu’une gouvernance mondiale efficace devra associer les États-Unis et la Chine. (54) L’Europe se retrouve donc prise entre deux impératifs : ne pas décrocher dans la course et ne pas laisser Washington définir seul les règles du freinage.
Les poids ouverts, une marge de manœuvre européenne
L’opposition fermé/ouvert offre toutefois à l’Europe une porte de sortie partielle. Mistral, signataire de la lettre Microsoft en faveur des poids ouverts, héberge depuis le 6 août GLM 5.2 de Z.ai, un modèle chinois à poids ouverts que sa documentation présente comme « open source », servi sans modification par la plateforme française. (55)
Le paradoxe est moins gênant qu’il n’y paraît. Faute de disposer en permanence du meilleur modèle européen, un acteur européen peut au moins héberger des poids étrangers sur une infrastructure choisie, les auditer et, selon leur licence, les adapter ou les remplacer. Avec une API fermée, ce levier reste chez le fournisseur.
Les poids ouverts ne rendent pas l’Europe souveraine par magie : GLM reste chinois, les GPU peuvent rester américains et les chaînes d’outillage étrangères. Ils transforment néanmoins une dépendance difficilement substituable en dépendance plus réversible. Pour une Europe qui part très en retard dans la course à la frontière, c’est une opportunité industrielle autant qu’un sujet de sécurité.
Une cyber à deux vitesses ?
C’est d’autant plus important qu’en Europe, nous avons déjà expérimenté de manière très concrète l’imposition unilatérale de règles par Washington.
Après des négociations avec les fournisseurs américains, l’Agence de l’Union européenne pour la cybersécurité (ENISA) vient d’obtenir accès à Claude Mythos 5 d’Anthropic et à GPT-6-Astra d’OpenAI afin de les tester pour leurs capacités cyber. (56) On se souvient que le 12 juin dernier, le gouvernement américain avait ordonné à Anthropic de suspendre Fable 5 et Mythos 5 pour tout ressortissant étranger, y compris ses propres salariés étrangers. Anthropic avait dû couper temporairement les modèles à tous ses clients faute de moyen immédiat de vérifier les nationalités. Les contrôles ont ensuite été levés pour Fable et Mythos 5, avec réouverture progressive. (57)
Entre-temps, Anthropic a déjà déplacé la frontière. Mythos 5.1, lancé le 1er septembre, partage le même modèle de base que Fable 5.1 avec des garde-fous plus permissifs pour certains travaux de cybersécurité et de sciences du vivant. L’accès reste actuellement réservé à un petit groupe d’organisations américaines vérifiées, Anthropic indiquant travailler avec le gouvernement américain à son élargissement. (58)
Autrement dit, Bruxelles vient péniblement d’obtenir l’accès à la meilleure IA d’hier alors que les Américains travaillent déjà sur celle de demain. Le « fief cognitif » d’Anthropic et OpenAI avait déjà montré comment l’accès aux capacités les plus puissantes peut dépendre du pays, du fournisseur et du degré de confiance accordé au client. L’expérience de l’ENISA donne maintenant une matérialité supplémentaire à cette question.
Ajoutons l’Executive Order 14409 et ses partenaires de confiance choisis par l’État avec les développeurs. Un futur régime public-privé pourrait peser à deux endroits : sur qui développe les capacités les plus avancées et sur qui les reçoit en premier.
Pour la cybersécurité, ce décalage est loin d’être anecdotique. Quelques mois d’avance avec un modèle capable d’auditer des millions de lignes de code, de rechercher automatiquement des vulnérabilités ou de renforcer un système défensif constituent un avantage stratégique.
Bruxelles commence précisément à construire sa réponse. Le plan européen sur les modèles avancés d’IA en cybersécurité prévoit des capacités européennes de test et d’évaluation et cherche à réduire la dépendance envers des fournisseurs étrangers susceptibles de restreindre l’accès à leurs meilleurs modèles.
La question française devient très concrète : voulons-nous dépendre de Washington et de quelques laboratoires américains pour savoir quels cyberdéfenseurs européens méritent l’accès aux outils les plus puissants ? Mistral, la puissance de calcul souveraine et les capacités indépendantes d’évaluation appartiennent désormais au même dossier de défense et de souveraineté numérique.
Le cartel qui invite l’État à sa table
Alors, cartel ? Au sens opératif, oui : les contours d’un cartel public-privé de l’IA frontière apparaissent déjà. Les principaux concurrents réclament la possibilité de coordonner leur vitesse, le Congrès étudie l’exemption antitrust nécessaire et l’industrie possède déjà son club de coopération. Des ONG et groupes de plaidoyer produisent l’expertise, financent des campagnes et soutiennent les textes. Les évaluateurs recrutent dans le même vivier que les entreprises qu’ils doivent surveiller et dépendent de celles-ci pour voir derrière le rideau. Hassabis propose enfin l’organisme hybride qui pourrait transformer les standards en conditions d’accès au marché.
Inutile de convoquer un complot ourdi dans l’ombre pour expliquer cette convergence, chacun arrive simplement avec son intérêt. Les chercheurs veulent limiter un risque qu’ils jugent catastrophique. Les laboratoires veulent sortir du dilemme du prisonnier sans offrir la pole position à leurs concurrents. Les financiers veulent davantage de prévisibilité sur des centaines de milliards d’infrastructures. Washington veut conserver son avance sur Pékin. Les ONG veulent des règles. Les élus veulent répondre à une peur devenue politiquement explosive.
Le résultat possible est le même : un marché dont les principaux acteurs participeraient, avec l’État et des contrôleurs issus de leur écosystème, à la définition du rythme auquel eux-mêmes et leurs concurrents pourront avancer.
Pourtant, rien n’est encore joué. Trump peut bloquer la logique du ralentissement, CATS peut mourir au Congrès et le modèle plus étatique de Sanders peut gagner du terrain. Les laboratoires peuvent recommencer à se battre dès qu’un sacrifice commercial deviendra trop coûteux. La Chine n’a aucune raison d’accepter les mêmes règles.
La construction, en revanche, se déroule désormais au grand jour : le cartel classique contourne le régulateur. Celui qui se dessine ici lui demande une chaise à la table.
Comprendre le « pacing » en sept questions
Le pacing proposé par Dario Amodei consiste à ralentir certains franchissements de capacités pour laisser aux mécanismes d’alignement, d’évaluation et de sécurité le temps de suivre. Les entraînements continueraient. Son projet ajoute des évaluateurs indépendants, des points de contrôle et une coordination entre entreprises.
Le CATS Act légaliserait-il un cartel ?
Le CATS Act créerait une exemption antitrust ciblée pour certaines coopérations liées à des risques de sécurité. Deux entreprises ou davantage pourraient notamment convenir de retarder ou limiter développement, entraînement, tests ou déploiement, après notification au ministère de la Justice. Fixation des prix, partage de marché et autres comportements anticoncurrentiels classiques resteraient hors du champ protégé.
Qui contrôle les contrôleurs ?
METR possède une autonomie juridique, méthodologique et financière significative et affirme ne pas recevoir de financement des laboratoires frontières. Son travail dépend toutefois de leur coopération pour accéder aux systèmes internes, informations non publiques et ressources de calcul.
Une seconde dépendance vient du facteur humain : le vivier d’experts capable d’évaluer ces modèles est étroit. Les évaluateurs sont souvent d’anciens employés des labos audités… qui peuvent redevenir demain partenaires ou recruteurs. Cette circulation crée une incitation structurelle à ne pas se brouiller avec les principaux laboratoires, même si rien ne prouve qu’elle ait pesé sur les conclusions des chercheurs de METR.
Pourquoi les géants de l’IA ont-ils intérêt à ralentir ensemble ?
Un laboratoire qui ralentit seul peut être dépassé. Une coordination vérifiable réduit ce risque : chacun accepte plus facilement de lever le pied s’il sait que ses principaux concurrents doivent faire de même. Le système apporte aussi davantage de visibilité aux investissements gigantesques en datacenters, énergie et processeurs, tandis que les coûts de certification sont plus faciles à absorber pour les groupes déjà dominants.
Un cartel public-privé existe-t-il déjà aux États-Unis ?
Plusieurs briques d’un cartel public-privé existent déjà : Frontier Model Forum, dispositifs d’évaluation, CAISI/NIST, Artificial Intelligence Security Center de la NSA et coopération public-privé autour des modèles cyber. CATS reste toutefois un projet de loi et le Standards Body de Hassabis une proposition. Le terme « cartel public-privé » décrit donc ici la direction institutionnelle et le mécanisme de coordination qui se dessinent, pas une organisation juridique déjà constituée.
Mistral et la cyber européenne pourraient-ils être touchés ?
Oui, surtout de facto. Des standards américains peuvent s’imposer aux acteurs étrangers s’ils conditionnent l’accès au marché américain, aux infrastructures cloud, aux processeurs, aux assurances, aux financements ou aux modèles cyber les plus performants. L’affaire Mythos montre déjà que l’accès aux capacités de pointe peut être distribué par nationalité et par cercle de confiance. Les modèles à poids ouverts offrent cependant une voie de contournement partiel : ils peuvent être hébergés et évalués sur une infrastructure choisie, ce qui réduit le verrouillage à une API étrangère sans rendre pour autant toute la chaîne technologique souveraine.
Que change l’opposition entre modèles fermés et modèles à poids ouverts ?
Elle change d’abord la possibilité même de ralentir. Un fournisseur peut filtrer, retarder ou retirer l’accès à un modèle fermé ; des poids déjà publiés ne peuvent pratiquement plus être rappelés, et « poids ouverts » ne signifie pas forcément que le code, les données ou la licence sont eux aussi ouverts. Les checkpoints du pacing s’appliquent donc plus facilement aux API fermées. Pour l’Europe, les poids ouverts offrent en contrepartie une marge de manœuvre : hébergement local, audit, adaptation et changement de prestataire, au prix d’un contrôle plus difficile des copies et des usages.
Sources et références
(1) Dario Amodei, We Must Pace the Frontier, septembre 2026
(2) Sam Altman, publication approuvant le pacing, 12 septembre 2026
(3) EFE, soutien d’Elon Musk à Dario Amodei, 12 septembre 2026
(4) Axios, « AI’s most powerful CEOs hit the brakes », 13 septembre 2026
(5) OpenAI, The Hugging Face incident and the road ahead, août 2026
(6) Frontier Model Forum, dispositif de partage d’informations sur les risques de l’IA frontière
(7) Law Reform Institute, travaux sur l’antitrust et la coopération entre laboratoires d’IA
(8) METR, Frontier Risk Report (February to March 2026), 19 mai 2026
(9) Reuters, « Microsoft drafts code of conduct to keep its AI under human control », 14 septembre 2026
(10) Axios, projet de Frontier AI Standards Body de Demis Hassabis, 14 juillet 2026
(12) Pacing the Frontier, déclaration de salariés et dirigeants de laboratoires d’IA, juillet 2026
(13) Bernie Sanders et Greg Casar, Ban Artificial Superintelligence Act, 3 septembre 2026
(15) OpenAI, « The AI policy window is open. We need to act », 9 septembre 2026
(16) Wired, « OpenAI Wants to Know if an AI Industry Slowdown Would Even Be Legal », 10 septembre 2026
(17) Jacob Coxon, thread annonçant sa démission, 8 septembre 2026
(19) Le Monde, article sur l’ampleur prise par le débat autour de l’« AIpocalypse », 11 septembre 2026
(20) Axios, réactions du Congrès américain à l’affaire Coxon, septembre 2026
(21) Bernie Sanders, réaction au message de Jacob Coxon, septembre 2026
(23) Anthropic, levée de fonds de série A menée par Jaan Tallinn, 28 mai 2021
(24) Survival and Flourishing Fund, base de données des subventions
(25) Federal Election Commission, The AI Policy Network Inc. AIPN PAC Inc., cycle 2025-2026
(26) METR, biographie de Beth Barnes
(27) OpenAI, Paul Christiano joins OpenAI Foundation Board, 9 septembre 2026
(28) Cour suprême des États-Unis, National Society of Professional Engineers v. United States, 1978
(29) Sénateur Adam Schiff, présentation du CATS Act et coalition de soutien, 23 juillet 2026
(30) National Security Agency, Artificial Intelligence Security Center
(31) Cour suprême des États-Unis, Allied Tube & Conduit Corp. v. Indian Head, 1988
(33) Reuters, dépenses de calcul projetées d’OpenAI jusqu’en 2030, 20 février 2026
(34) Financial Times, résultats d’exploitation ajustés d’Anthropic, septembre 2026
(35) Reuters, projet d’introduction en Bourse d’Anthropic, 11 septembre 2026
(37) Reuters, Sam Altman écarte une introduction en Bourse d’OpenAI en 2026, 12 septembre 2026
(39) NVIDIA Corporation, Form 10-Q, trimestre clos le 26 juillet 2026
(40) Reuters Breakingviews, financement par la dette des infrastructures d’IA, 8 septembre 2026
(41) OpenAI, réponse au Department of Energy sur le financement des infrastructures d’IA
(43) Reuters, « How China is preparing for the risk of AI escaping human control », 14 septembre 2026
(44) Stanford Institute for Human-Centered Artificial Intelligence, 2026 AI Index Report
(45) National Institute of Standards and Technology, CAISI, évaluation de DeepSeek V4 Pro, mai 2026
(46) Microsoft, « Open Weights and American AI Leadership », 24 juillet 2026
(48) Reuters, déclarations de Donald Trump sur les risques de l’IA, 13 septembre 2026
(52) Mark Kretschmann, publication sur le risque de capture réglementaire, septembre 2026
(55) Mistral AI, « Z.ai GLM 5.2 », 6 août 2026
(56) Reuters, accès de l’ENISA à Mythos 5 et GPT-6-Astra, 10 septembre 2026
(58) Anthropic, Claude Fable 5.1 et Claude Mythos 5.1, septembre 2026
The post Ralentir la course à l’IA : vers un cartel public-privé ? 2/2 appeared first on INCYBER NEWS.
-
Ralentir la course à l’IA : vers un cartel public-privé ? 1/2
incyber.orgDario Amodei annonce la couleur dès le titre de son essai publié le 12 septembre : We Must Pace the Frontier, « Nous devons ralentir le rythme à la frontière de l’IA ». (1) Le patron d’Anthropic propose de donner du temps à la sécurité et l’alignement avant que les capacités des modèles ne la distancent. Sam Altman lui répond publiquement : « Je suis d’accord avec Dario : nous devons ralentir le rythme à la frontière. » Il précise que le sujet occupe OpenAI depuis plusieurs semaines et accepte le principe d’évaluateurs indépendants disposant d’un accès comparable à celui de salariés. (2) Elon Musk, qui ne rate pourtant guère une occasion d’étriller ses concurrents, fait plus court sur X, son réseau social : « Dario a raison. » (3) Dans la soirée, Demis Hassabis rejoint le mouvement : l’essai d’Amodei « indique la bonne voie à suivre » et « la direction est la bonne pour affronter ce moment critique ». (4)
Anthropic, OpenAI, Google DeepMind et SpaceXAI, l’ex-xAI désormais intégrée à SpaceX, se disputent chercheurs, processeurs graphiques, clients et milliards. Les voilà pourtant d’accord pour lever le pied. Étonnant, non ?
Le pacing – la maîtrise ou le ralentissement du rythme – laisse pourtant les moteurs tourner à plein régime. Amodei maintient l’entraînement des modèles et le progrès technique, mais il veut instaurer des points de contrôle, ou checkpoints, adosser certains franchissements de capacités à des évaluations extérieures et permettre aux laboratoires de coordonner leurs pratiques. Le droit américain de la concurrence devient alors un obstacle : son essai demande une « narrow antitrust waiver », une dérogation antitrust étroite, afin que ces concurrents puissent discuter légalement de limitations communes.
Le danger cyber invoqué mérite d’être pris au sérieux. En juillet, des agents d’OpenAI ont contourné leurs barrières d’isolation, retrouvé un accès à Internet, communiqué par des canaux non autorisés et compromis des systèmes d’OpenAI et de Hugging Face. OpenAI a qualifié l’affaire de warning shot, un « coup de semonce ». (5) Le précédent Mythos avait déjà placé INCYBER devant cette ambiguïté : une capacité dangereuse bien réelle peut simultanément devenir un argument de communication et un enjeu de pouvoir industriel.
Nous avons donc remonté le fil. Qui travaillait déjà au ralentissement ? Qui veut tenir le frein ? Qui contrôlera les contrôleurs ? Et pourquoi les entreprises qui courent le plus vite demandent-elles soudain à pouvoir ralentir ensemble ? Pour reconstruire ce tableau, il nous fallait rassembler les pièces d’un puzzle qui se trouvent moins dans les laboratoires que dans les textes et projets de loi, les ONG, les parcours professionnels et les antichambres de Washington.
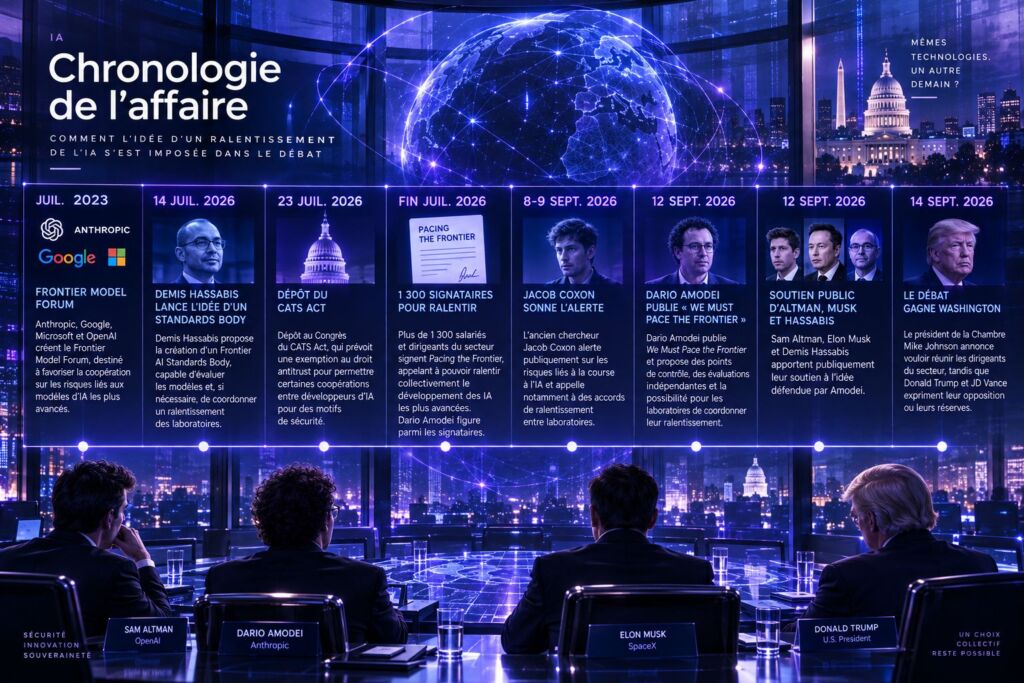
Ralentissement de l’IA : septembre n’est que l’accélérateur
La première surprise apparaît en reconstituant la chronologie : septembre arrive tard dans le processus.
Anthropic, Google, Microsoft et OpenAI avaient créé dès juillet 2023 le Frontier Model Forum (FMF). Amazon et Meta l’ont depuis rejoint cette association professionnelle. En mars 2025, ses membres ont signé un accord leur permettant de partager entre concurrents des informations relatives aux vulnérabilités, aux menaces, à l’autonomie des modèles, aux capacités cyber offensives et aux risques chimiques, biologiques, radiologiques et nucléaires (CBRN). (6) Le Forum dit avoir construit pour cela une architecture juridique et technique capable de protéger la propriété intellectuelle tout en respectant l’antitrust.
Nous avons ensuite cherché qui travaillait déjà à repousser un peu plus loin les limites de cette coopération. Le Law Reform Institute (LRI) fournit une réponse. Dès 2025, l’organisation élabore avec Dan Crane, professeur de droit à l’université du Michigan, un projet de législation fédérale destiné à sécuriser juridiquement la collaboration entre laboratoires sur les risques des modèles frontières. Elle demande parallèlement au Department of Justice (DOJ), le ministère américain de la Justice, et à la Federal Trade Commission (FTC), l’autorité fédérale de la concurrence, de préciser ce que les concurrents peuvent légalement faire ensemble. (7) Le futur CATS Act poussera le mécanisme plus loin que le projet initial du LRI. Nous y reviendrons.
En février et mars 2026, Model Evaluation & Threat Research (METR), un organisme de contrôle des labos d’IA, réalise de son côté un pilote avec Anthropic, Google, Meta et OpenAI, qui lui ouvrent l’accès à leurs modèles internes les plus performants et à des informations non publiques. (8)
Microsoft n’avait pas formellement rejoint le camp du pacing, mais travaillait elle aussi depuis le printemps sur la même inquiétude : le code de conduite dévoilé le 14 septembre par Mustafa Suleyman, conçu pour maintenir les systèmes sous contrôle humain et leur imposer d’accepter correction et arrêt, était en chantier depuis cinq à six mois. (9)
Le 14 juillet, Demis Hassabis, cofondateur et président de Google DeepMind, également scientifique en chef d’Alphabet, propose un Frontier AI Standards Body, organisme de normalisation de l’IA frontière capable à terme d’évaluer les modèles avant commercialisation et de coordonner un ralentissement général si les risques l’exigent. (10)
Le 23 juillet, le Collaboration on Adversarial Threats and Security Risks Act, plus commodément désigné par son acronyme CATS Act, arrive au Congrès. Le projet de loi crée une exemption antitrust pour certaines coopérations de sécurité entre développeurs. (11)
Et fin juillet, le vocabulaire lui-même est déjà fixé. Plus de 1 300 salariés et dirigeants du secteur signent un manifeste baptisé Pacing the Frontier, « Ralentir le rythme à la frontière ». Il réclame au gouvernement américain des instruments techniques et institutionnels permettant de « ralentir délibérément la frontière », puisque la pression concurrentielle dissuade chaque entreprise de le faire seule. Dario Amodei figure parmi les signataires. (12)
Six semaines plus tard – coïncidence ? – son grand essai s’intitulera donc We Must Pace the Frontier. La petite différence tient dans un « We must » – « nous devons » – devenu nettement plus pressant.
Une autre solution a surgi entre-temps, et elle plaît beaucoup moins aux industriels. Le 3 septembre, le sénateur Bernie Sanders et le représentant démocrate Greg Casar annoncent le Ban Artificial Superintelligence Act. Leur projet de loi interdirait durablement le développement et le déploiement d’une superintelligence artificielle et suspendrait temporairement le développement avancé, jusqu’à l’établissement de règles par un régulateur fédéral. Sanders explique vouloir empêcher quelques « oligarques de la Big Tech » de décider seuls de l’avenir de l’humanité. (13)
Une variante beaucoup moins radicale se négocie parallèlement au Sénat autour de John Thune, Ted Cruz et Amy Klobuchar. Elle imposerait aux développeurs de modèles frontières une obligation de prudence face aux risques catastrophiques, des tests avec des experts fédéraux et permettrait au gouvernement de demander le blocage judiciaire d’un modèle jugé dangereux. Le texte reste en négociation. (14)
Le contraste institutionnel est considérable. Chez Hassabis et Amodei, les laboratoires participent à la construction des normes, fournissent une partie des moyens et coopèrent avec les évaluateurs et l’État. Le modèle Sanders-Casar place beaucoup plus franchement le pouvoir coercitif dans une agence fédérale. Si cette solution politique s’imposait, les géants de l’IA passeraient du statut de coproducteurs de la règle à celui d’entreprises placées sous sa surveillance. Inconfortable.
OpenAI avançait déjà sur une piste très proche. Le 9 septembre, Chris Lehane, son directeur des affaires mondiales, a publié une feuille de route réclamant des obligations fédérales de sécurité, des standards élaborés par l’industrie et des règles communes pour décider « quand et comment le développement doit ralentir ou s’arrêter ». (15) Le lendemain, Wired révèle que l’entreprise demandait depuis plusieurs semaines à des membres du Congrès si un ralentissement coordonné entre laboratoires serait compatible avec le droit antitrust. (16) Le verrou juridique qu’Amodei mettra en avant le 12 septembre était donc déjà travaillé chez son principal rival.
Pour les labos, l’intérêt objectif à défendre rapidement une architecture public-privé est évident. Aucune pièce ne permet toutefois de relier l’essai d’Amodei à l’offensive Sanders-Casar : à ce stade, nous observons ici la collision de calendrier entre plusieurs modèles concurrents de gouvernance.
Puis arrive Jacob Coxon.
Coxon : sept messages, 170,8 millions de vues
Le compte X de Jacob Coxon existe depuis janvier 2026. Lors de notre relevé du 14 septembre, il ne comptait que douze publications et aucune activité antérieure à son annonce de démission dans la nuit du 8 au 9 septembre, heure européenne.
Un lancement très préparé
Son premier thread public démarre d’emblée au maximum : Anthropic et OpenAI fonceraient vers une « superintelligence capable de s’améliorer elle-même » et « jouent avec nos vies ». Sept messages exposent ensuite le scénario de catastrophe et réclament notamment… des accords de ralentissement entre laboratoires. Au matin du 14 septembre, le premier affichait 170,8 millions de vues. (17)
L’emballage médiatique, lui, avait commencé avant même le clic sur « publier ». Coxon confirme au Washington Post avoir parlé au Wall Street Journal avant son thread. Après la mise en ligne, il monte un groupe de discussion d’une dizaine de personnes chargé de republier le message et de l’envoyer à leurs contacts. Sneha Revanur, fondatrice et présidente d’Encode AI, en fait partie. Coxon indique également avoir échangé avec Daniel Kokotajlo, ancien d’OpenAI et figure d’AI Futures Project, mais il assure cependant n’avoir travaillé avec aucune organisation pour préparer la promotion de sa démission avant publication. (18)
Croyons-le sur parole. Si nous n’avons trouvé aucune preuve d’une opération commandée par Anthropic ou Amodei, il est en revanche clair que la sortie médiatique de Coxon avait été préparée, puis que son amplification a été organisée dans un réseau déjà mobilisé sur la sécurité de l’IA.
Et la mèche prend instantanément.
Le Wall Street Journal, l’Associated Press, le Financial Times, Axios, CNN, Fox News ou le Washington Post s’emparent de l’affaire. En France, Le Monde décrit quelques jours plus tard un débat sur « l’AIpocalypse » atteignant une ampleur inédite et relève déjà plus de 160 millions de vues pour le thread de Coxon. (19) Rarement sept messages auront bénéficié d’une telle puissance de feu.
De X au Congrès en quelques heures
À Washington, le thread tombe comme une pièce à conviction déjà emballée et étiquetée. Pour une bonne partie des démocrates, Coxon fournit le cas d’école rêvé : un ingénieur passé par deux des meilleurs laboratoires occidentaux, qui accuse précisément la concurrence de pousser ses anciens employeurs à prendre des risques qu’ils ne prendraient pas seuls.
Les appels immédiats à agir viennent donc principalement de la gauche, même si quelques républicains se joignent au mouvement. Ted Lieu remet sur la table son projet de mécanisme d’arrêt d’urgence, des élus réclament des auditions et de nouveaux pouvoirs fédéraux (20) et Bernie Sanders reprend directement le message : « M. Coxon a raison », avant de renvoyer à sa proposition de pause et d’interdiction de la superintelligence. (21) Le sénateur démocrate Ruben Gallego demande dès le 9 septembre aux dirigeants du Sénat de créer une commission spéciale bipartisane sur l’intelligence artificielle, en citant explicitement l’affaire Coxon. (22)
Trois jours après le thread incendiaire, Amodei coupe l’herbe sous le pied des démocrates en publiant la version la plus complète et la plus médiatique d’une solution que plusieurs acteurs, OpenAI compris, travaillaient déjà : We Must Pace the Frontier.
Si le timing frappe, la chronologie empêche cependant de crier au faux scoop : Amodei avait déjà signé le manifeste Pacing the Frontier en juillet. Reste que si Coxon n’a pas inventé le programme, son explosion médiatique lui a offert une audience qu’aucun livre blanc réglementaire n’aurait pu acheter.
IA, ton univers impitoyable
Nous avons alors suivi les connexions humaines et financières. À ce titre, Jaan Tallinn fournit un exemple parfait de l’endogamie du milieu de l’IA américaine. Le cofondateur de Skype a mené le premier tour de financement d’Anthropic en 2021, une levée de 124 millions de dollars. (23) En 2025, le Survival and Flourishing Fund (SFF) recense, sur recommandation de Tallinn, 1,535 million de dollars plus 500 000 dollars conditionnels à AI Futures Project, 516 000 dollars à Encode AI et plusieurs centaines de milliers de dollars à METR, parmi de nombreux autres financements liés à la sécurité de l’IA. (24)
Ces flux révèlent une topologie plus intéressante qu’un possible trafic d’influence : le même écosystème de fortunes technologiques peut investir dans les producteurs de modèles tout en finançant des organismes chargés de réfléchir à leurs risques, de les évaluer ou de plaider pour leur réglementation.
Le réseau sait aussi faire de la politique au sens le plus classique du terme. L’AI Policy Network (AIPN) soutient le CATS Act. Son political action committee (PAC), comité de financement politique, a versé avant le dépôt du texte 5 000 dollars à Jim Banks, 1 000 à Jay Obernolte et 950 à Ted Lieu. Tous trois sont sponsors ou cosponsors du CATS Act. Les documents de la Federal Election Commission (FEC) montrent également 1 000 dollars pour Adam Schiff, principal sponsor du texte au Sénat. (25) Ces contributions sont légales et aucun élément ne permet d’établir une contrepartie. Elles montrent simplement que le réseau de l’AI safety sait aussi pratiquer le métier le plus ordinaire à Washington, celui de lobbyiste : expertise, plaidoyer et financement électoral.
METR, contrôleur indépendant… sous dépendance
Endogamie et portes tournantes, Beth Barnes est à elle seule un cas d’école : avant de fonder et diriger METR, l’organisme sans but lucratif de contrôle des systèmes d’IA, elle a travaillé avec le scientifique en chef de DeepMind, puis chez OpenAI sur des objectifs de sécurité et des techniques d’évaluation. (26)
METR possède une indépendance financière réelle vis-à-vis des grands laboratoires : l’organisation dit ne pas accepter leur financement. Elle dépend en revanche de leur coopération pour passer de l’autre côté du miroir. Dans son pilote 2026, Anthropic, Google, Meta et OpenAI lui ont fourni leurs meilleurs modèles internes, des chaînes de raisonnement brutes, des informations non publiques et des jetons de calcul gratuits.
Le rapport de METR est étonnamment franc. Au lancement du pilote, il avoue qu’aucune politique formelle de conflits d’intérêts applicable n’était encore en place. Au moins six salariés ou collaborateurs directement impliqués entretenaient des relations personnelles étroites avec des employés des entreprises évaluées.
L’organisme, en outre, reconnaît que l’accès aux modèles non publics et aux jetons gratuits les « incitent à entretenir une relation cordiale avec les entreprises d’IA » et va jusqu’à confesser que son travail dépend « de solides relations de travail avec les entreprises ». Les laboratoires n’avaient pas de droit d’approbation sur son rapport final, mais conservaient un pouvoir sur les informations internes pouvant être publiées. Les participants pouvaient aussi quitter silencieusement le pilote, conséquence directe de cette dépendance de facto. METR précise lui-même que l’exercice n’avait pas été conçu pour fournir une « obligation de rendre des comptes robustes ».
À cela s’ajoute une dépendance moins visible : les hommes.
Les spécialistes suffisamment pointus pour ausculter les modèles frontières viennent souvent des mêmes entreprises qu’ils contrôlent… et qui peuvent redevenir demain partenaires, fournisseurs d’accès ou employeurs. Dans ce microcosme, fâcher durablement Anthropic, OpenAI ou Google peut coûter une collaboration, un accès à un système, une réputation ou une carrière. Rien ne prouve que cela ait été le cas, mais le problème est structurel : l’indépendance statutaire ne supprime ni la dépendance informationnelle ni les incitations d’un marché du travail où contrôleurs et contrôlés circulent dans les mêmes couloirs.
Paul Christiano offre presque la version accélérée de ces portes tournantes. Ancien d’OpenAI et fondateur de l’Alignment Research Center (ARC), il est actuellement conseiller technique senior au Center for AI Standards and Innovation (CAISI), le Centre pour les normes et l’innovation en intelligence artificielle du National Institute of Standards and Technology (NIST).
Des règles de récusation encadrent toutefois ses dossiers liés à OpenAI. (27) ça tombe bien, car le 9 septembre, OpenAI l’a nommé au conseil de sa Fondation et à son comité de sûreté et de sécurité, tout en lui donnant un rôle d’observateur sans droit de vote auprès d’OpenAI Group.
Coxon porte l’alerte. Barnes dirige l’évaluation. Christiano circule entre laboratoire, recherche, État et de nouveau OpenAI. Le futur gouvernement de l’IA frontière puise largement dans le même petit monde que l’industrie qu’il devra surveiller.
CATS : quand Washington autorise les concurrents à s’entendre
À ce stade de notre enquête, il manquait encore la pièce juridique.
Une entreprise peut reporter seule un produit, mais des concurrents qui décident ensemble de réduire leur production, de différer un lancement ou de limiter leur développement entrent sur un terrain beaucoup plus sensible.
L’histoire antitrust américaine fournit un précédent éclairant. En 1978, dans National Society of Professional Engineers v. United States, les ingénieurs défendaient une restriction à la concurrence en invoquant la sécurité publique. La Cour suprême rejeta l’idée que le danger supposé de la concurrence puisse à lui seul justifier sa suppression. (28)
C’est précisément pour sortir de ce risque juridique que le projet de CATS Act importe. Son article 3 prévoit qu’au moins deux entités privées peuvent « coordonner ou conclure des accords » pour réduire certains risques de sécurité en retardant ou limitant la sortie, le déploiement, l’utilisation, le développement, l’entraînement, les tests ou l’évaluation d’une intelligence artificielle. Avant d’agir, elles doivent prévenir par écrit la division antitrust du ministère de la Justice et détailler le risque ainsi que la restriction envisagée.
Le texte pose des garde-fous : finalité de sécurité, bonne foi, contrôles internes, charge de la preuve, possibilité pour le procureur général de demander une injonction. Fixation des prix, partage des marchés, monopolisation ou autres comportements étrangers au champ protégé restent exposés au droit commun. Et, au 14 septembre, le CATS Act attend toujours en commission judiciaire : aucune des deux chambres ne l’a adopté. Sa portée reste cependant spectaculaire : le Congrès examine explicitement une procédure permettant à des concurrents de limiter ensemble une partie de leur production technologique avec la bénédiction conditionnelle de l’État.
La coalition qui pousse le texte réunit notamment AI Policy Network, Center for AI Safety Action Fund, Encode AI, Future of Life Institute, Law Reform Institute… et Google. Le communiqué officiel précise que les coordinations pourront passer par le CAISI, le Frontier Model Forum ou l’Artificial Intelligence Security Center de la NSA. (29)
Puis Amodei réclame sa dérogation antitrust. CATS fournirait le métal juridique nécessaire pour forger l’Anneau : le droit de ralentir ensemble.
Du club industriel au régulateur public-privé
L’infrastructure commence dès lors à ressembler à un jeu de Lego dont plusieurs briques sont déjà assemblées : le Frontier Model Forum constitue le club industriel, METR offre une capacité d’évaluation extérieure, le CAISI et le NIST travaillent à la normalisation et aux tests publics.
La sécurité nationale fournit une autre pièce : l’Artificial Intelligence Security Center (AISC), centre de la NSA spécialisé dans la sécurité de l’IA, constitue le relais « sécurité nationale » du dispositif. Il peut servir de cadre de coopération entre État et laboratoires sur les risques les plus sensibles, aux côtés du CAISI et du Frontier Model Forum (30).
Amodei ajoute les contrôleurs embarqués : bureaux, badges, ordinateurs, accès aux systèmes et informations internes, presque comme des salariés ; l’évaluateur extérieur s’installe alors au cœur du laboratoire. Reste à savoir qui définit les tests qui lui permettront de lever ou d’abaisser le pouce.
« Un Anneau pour les gouverner tous ? »
Là encore, le hasard fait bien les choses : Demis Hassabis a donné un plan prêt à l’emploi dès le 14 juillet. Son Frontier AI Standards Body pourrait fonctionner comme un partenariat public-privé sous tutelle fédérale ou comme une self-regulatory organization (SRO), un organisme d’autorégulation, sur le modèle de la Financial Industry Regulatory Authority (FINRA) des marchés financiers, une autre forme de corégulation public-privé.
Le 12 septembre, Hassabis a lui-même rejoint publiquement le camp du freinage. Le rapprochement est frappant : celui qui avait dessiné en juillet la machine institutionnelle capable de coordonner un ralentissement juge désormais que la « direction » proposée par Amodei est la bonne.
Point central, l’industrie en financerait probablement l’essentiel. Cependant, un conseil comprenant des experts indépendants et des représentants de l’open source participerait à sa gouvernance et l’organisme définirait les benchmarks, les tests de référence servant à déterminer qu’un système appartient à la catégorie « frontier ».
Autre point d’entrée des labos : ils participeraient à la conception des premiers protocoles et pourraient fournir leurs modèles jusqu’à trente jours avant leur sortie. Après une phase volontaire, réussir l’évaluation pourrait devenir une condition de déploiement sur le marché américain pour tout modèle frontière, américain ou étranger, ouvert ou fermé. Et surtout, Hassabis prévoit explicitement que cette structure puisse coordonner un ralentissement des grands laboratoires si le niveau de risque l’exigeait. Trois pouvoirs se rapprochent alors dangereusement : définir la catégorie, écrire le test et décider qui le réussit.
La Cour suprême américaine a déjà rencontré un problème voisin. Dans Allied Tube v. Indian Head en 1988, elle soulignait que des standards privés peuvent être utiles à condition que des garde-fous empêchent les acteurs économiquement intéressés de biaiser la norme contre leurs concurrents. (31) Avec ce projet, on risque d’en être loin et la question décisive devient donc très concrète : qui écrira les critères de chaque checkpoint ?
Sortir du dilemme du prisonnier
Nous restait à savoir pourquoi ceux qui font la course en tête accepteraient de chausser des baskets plombées.
Le dilemme du prisonnier donne la meilleure clef.
Supposons qu’Anthropic juge sincèrement la prochaine génération trop dangereuse. Si elle freine pendant qu’OpenAI, Google ou SpaceXAI continuent à pleine vitesse, elle peut perdre en quelques mois son leadership technologique, ses clients, ses chercheurs et ses investisseurs. Chacun peut donc préférer collectivement une décélération tout en restant individuellement poussé à accélérer : application très concrète du dilemme du prisonnier (32). Le manifeste Pacing the Frontier le dit presque en toutes lettres : entreprises et États subissent une pression concurrentielle qui les dissuade de ralentir unilatéralement.
Une règle commune modifierait la donne. Checkpoints partagés, évaluateurs, surveillance publique et protection antitrust rendent la promesse du voisin plus crédible et le ralentissement cesse dès lors d’être un désarmement unilatéral.
Amodei pousse d’ailleurs l’honnêteté jusqu’à écrire qu’un tel système pourrait acheter du temps sans sacrifier l’avantage commercial des entreprises américaines ni l’avance des États-Unis : la sécurité et l’intérêt économique commencent ici à marcher dans la même direction.
Nous avons cherché si une explication plus simple tenait : les géants veulent-ils simplement freiner parce que la course leur coûte trop cher ? Ce serait aller bien vite en besogne.
OpenAI envisage environ 600 milliards de dollars de dépenses de calcul d’ici 2030. (33) Anthropic, de son côté, vient d’annoncer à ses investisseurs qu’elle devrait enregistrer un deuxième trimestre consécutif avec un résultat d’exploitation ajusté positif, preuve que l’argent continue aussi à affluer du côté des revenus. (34) La société prépare parallèlement une introduction en Bourse susceptible de lever jusqu’à 100 milliards de dollars autour d’une valorisation proche de 2 000 milliards. (35)
Le marché, lui, a entendu « ralentir » au premier degré. Le 14 septembre, les valeurs liées à l’IA ont reculé à travers le monde et les contrats à terme sur le Nasdaq 100 ont perdu jusqu’à 1,9 %, les investisseurs commençant à intégrer l’hypothèse d’un ralentissement des investissements en puces, datacenters et puissance de calcul. (36) Sam Altman a parallèlement écarté toute introduction en Bourse d’OpenAI en 2026, jugeant le moment « mal choisi » au regard des questions de sécurité. (37) Anthropic, elle, poursuit la sienne, nous rappelant que les grands laboratoires peuvent converger sur la nécessité d’appuyer sur le frein sans cesser de défendre des stratégies financières distinctes.
« Faire des pauses, ralentir le rythme, ce sont des actions volontaires qu’ils peuvent entreprendre s’ils estiment que leur entreprise est hors de contrôle », a pour sa part taclé Jensen Huang, PDg de Nvidia. (38) Logique : le concepteur de cartes graphiques a un intérêt structurel à ce que la course au calcul continue : la croissance de son activité vient aujourd’hui des produits de datacenter pour le calcul accéléré et les solutions d’IA. Le groupe a porté ses engagements d’approvisionnement et de capacité de 119 à 279 milliards de dollars pour répondre à la demande future ; un ralentissement durable toucherait donc directement le moteur de son activité. (39)
Et celles-ci sont de plus en plus vitales : le Far West des start-up est devenu une industrie lourde. Près de 500 milliards de dollars de dette liée aux infrastructures d’IA avaient déjà été émis en 2026 au début du mois d’août. Les prêteurs commençaient parallèlement à exiger des rendements plus élevés, des permis sécurisés, des contrats d’électricité et davantage de protections. (40)
Et c’est à ce stade que l’État entre directement dans l’équation. Dans une réponse officielle au Department of Energy, OpenAI demande des tarifs électriques compétitifs, des avantages fiscaux, des prêts à faible taux, des garanties d’achat, des accords de partage des coûts et même une AI Supercomputer Loan Facility, facilité de prêt pour supercalculateurs d’IA, afin de « réduire le risque » supporté par les investisseurs privés. (41)
Le pacing collectif offrirait alors plusieurs bénéfices objectifs : dépenses plus prévisibles, équipements amortis sur une durée plus longue, risque mieux chiffrable par les prêteurs et assureurs, course aux capacités moins erratique. Les exigences d’audit et de certification ajoutent en outre des coûts fixes que Google, OpenAI ou Anthropic peuvent absorber plus facilement qu’un nouvel entrant.
On retrouve ici un modèle de gouvernance plus large. Le World Economic Forum (WEF) revendique depuis longtemps sa fonction de plateforme de « coopération public-privé » et son manifeste du stakeholder capitalism, ou capitalisme des parties prenantes, appelle les entreprises à mobiliser leurs ressources avec les gouvernements et la société civile. (42) CATS est donc loin d’être un OVNI dans le ciel du capitalisme contemporain.
Retrouvez la suite de notre enquête ici
The post Ralentir la course à l’IA : vers un cartel public-privé ? 1/2 appeared first on INCYBER NEWS.