Tech-fr publisher
-
Pourquoi dotAI + dotJS est le seul événement tech incontournable de la rentrée
www.frenchweb.frLes 17 et 18 septembre, les Folies Bergère accueilleront deux communautés de builders : les ingénieurs et chercheurs qui développent l’IA en production, puis ceux qui façonnent les architectures Web et JavaScript de demain. Le seul rendez-vous tech où les slides laissent place aux vraies conversations. Là où tout se passe : les meilleurs builders …
L’article Pourquoi dotAI + dotJS est le seul événement tech incontournable de la rentrée est apparu en premier sur FW.MEDIA.
-
GTA 6 : les 4 chiffres décisifs qui vont marquer le jeu (durée de vie, fps, taille de la carte…)
www.numerama.com
Alors que Rockstar Games vient de frapper un grand coup en dévoilant plus de 25 minutes de gameplay exclusif lors de son événement diffusé sur Netflix, l'industrie du jeu vidéo sous le choc décortique chaque détail. Voici 4 chiffres qui vont marquer GTA 6.
-
AI Overviews en France : rendez-vous le 10 septembre pour un webinaire exceptionnel !
www.abondance.comUn chiffre qui résume l'enjeu
Dans les pays où les AI Overviews sont actifs depuis plus longtemps, la baisse de clic sur la première position dépasse la moitié du trafic habituel : -58 % selon Ahrefs. Être premier sur Google ne garantit donc plus la visite sur le site. Ce que l'on observe aujourd'hui sur la visibilité de marque dans ChatGPT pourrait bien préfigurer ce qui attend Google demain.
La question n'est plus de savoir s'il faut faire du GEO, mais de comprendre précisément ce qui change. Les signaux qui poussent AI Overviews à reprendre un contenu sont-ils les mêmes que ceux recherchés par ChatGPT ou Perplexity ? Qu'est-ce qui se recoupe, qu'est-ce qui diverge, et comment travailler les deux fronts en même temps ?
C'est justement l'objet de ce webinaire gratuit, qui aura lieu le 10 septembre, à 11h !
Le programme du webinar
Thomas Casiez et Julien Bismuth mettront en commun leur expérience du GEO à l'international et les résultats de leurs actions récentes. Quatre thèmes seront abordés :
- Ce que l'arrivée d'AI Overviews change, et ne change pas, par rapport à ce que l'on sait déjà du GEO
- Comment ces moteurs sélectionnent réellement leurs sources : fan-out, récupération, recomposition
- Ce qui rapproche et ce qui distingue les signaux attendus par Google et par les autres IA génératives
- Les signaux de confiance et d'autorité qui déterminent quels contenus sont sélectionnés et quelles marques sont mentionnées
Le webinar se conclura par la présentation des 4 C de la mention dans les réponses IA, un cadre directement applicable à la prochaine feuille de route SEO/GEO.
Les intervenants
- Thomas Casiez, directeur général SEO/GEO de Datashake
- Julien Bismuth, consultant SEO chez Getfluence
- Victor Lerat, consultant SEO et directeur général associé d'Abondance.com, animateur du webinar
Une heure d'échanges illustrés par des cas concrets, avec des méthodes directement applicables et pas seulement un état des lieux.
Pour s'inscrire à ce webinaire gratuit, c'est ici que ça se passe !
L’article "AI Overviews en France : rendez-vous le 10 septembre pour un webinaire exceptionnel !" a été publié sur le site Abondance.
-
Conférence Lexing Panorama 2025-2026 des décisions de la Cnil
www.lexing.law
Les inscriptions pour la Conférence Lexing « Panorama 2025-2026 des décisions de la Cnil » sont ouvertes !
Cette conférence, de Virginie Bensoussan-Brulé, avocate, directrice du pôle Contentieux du numérique, aura lieu :
• Mercredi 14 octobre 2026
• De 9h30 à 11h30
• En distanciel (visioconférence)
Participation gratuite sur inscription obligatoire.Cette présentation, animée par Virginie Bensoussan-Brulé, propose un panorama des principales décisions rendues par la Cnil en 2025 et 2026 afin d’identifier les tendances récentes de son activité répressive et d’en tirer des enseignements pratiques pour les responsables de traitement et les sous-traitants.
Panorama 2025-2026 des décisions de la Cnil
Les décisions rendues par la CNIL en 2025 et 2026 témoignent d’une évolution des priorités de contrôle et des pratiques répressives de l’autorité. Cybersécurité, cookies et traceurs, prospection commerciale, surveillance des salariés, droits des personnes ou encore responsabilité des sous-traitants : les sanctions récentes permettent d’identifier plusieurs tendances structurantes pour les entreprises. La conférence reviendra également sur la montée en puissance de la procédure simplifiée, devenue un véritable outil répressif, ainsi que sur les principaux enseignements à tirer des décisions les plus significatives.
Au programme de cette conférence :
- Décrypter les principales tendances de l’activité répressive de la Cnil en 2025 et 2026 ;
- Comprendre les différences entre procédure ordinaire et procédure simplifiée et leur place croissante dans l’activité de la Cnil ;
- Analyser les principales thématiques de sanctions ;
- Comprendre la place des plaintes et des droits des personnes dans le déclenchement des procédures ;
- Tirer des décisions récentes les principaux points de vigilance et les prochains domaines de contrôle de la Cnil.
Cette conférence permettra de disposer d’une vision actualisée du contentieux Cnil et d’identifier les enseignements opérationnels à intégrer dans les dispositifs de conformité et de prévention des risques.
Participation gratuite – sur inscription uniquement
Inscrivez-vous dès maintenant !
▼ pour participer, remplissez le formulaire d’inscription au bas de cette page ▼
Virginie Bensoussan-Brulé
AvocateDirectrice du pôle Contentieux du numérique
Pour y assister, enregistrez-vous en complétant les champs marqués d’un (*) :
Information Conférence Lexing :
Date : 14-10-2026
Thème : « Panorama 2025-2026 des décisions de la Cnil »
Animée par : Virginie Bensoussan-Brulé
Domaine technique : Données personnelles
Domaine juridique : Informatique et Libertés
Format de conférence : Distanciel
Lexing collecte les données recueillies sur ce formulaire pour traiter vos demandes d'abonnement aux lettres d’information et aux événements publics et gratuits organisés par le cabinet dont les Conférences Lexing, pour gérer l’organisation, l’animation et le suivi de ces évènements, créer, gérer, suivre, enregistrer et exploiter les visioconférences et webinaires publics et gratuits organisés par le cabinet et pour gérer les demandes de désabonnement et les demandes d'exercice des droits Informatique & Libertés.Formulaire d'inscription
(*) Champs obligatoiresCivilité Nom* Prénom* Fonction* Organisme* Adresse Code postal Ville Tél mobile Tél fixe Mél* Domaine d'activité* Présentiel/Distanciel Présentiel/Distanciel : Distanciel S'abonner au programme des Conférences Lexing et à la Lettre d'information de Lexing Combien font 6 + 2 ? *
Conformément à la réglementation applicable en matière de protections des données à caractère personnel, vous pouvez accéder aux données vous concernant, les rectifier, demander leur effacement ou exercer votre droit à la limitation du traitement de vos données. Vous pouvez également exercer votre droit d’opposition au traitement de vos données, à moins qu’un motif impérieux ne prévale, sans limite. De plus, vous pouvez retirer votre consentement, à tout moment, le cas échéant. Enfin, vous disposez d’un droit à la portabilité et d’un droit de formuler des directives spécifiques concernant la conservation, l’effacement et la communication de vos données post-mortem. Ces droits peuvent être exercés directement auprès de Lexing à l’adresse suivante : dpo@lexing.law ou 58 boulevard Gouvion-Saint-Cyr 75017 Paris, en justifiant de votre identité par tout moyen. Au besoin, vous avez le droit d’introduire une réclamation auprès de la Commission nationale de l'informatique et des libertés.
Pour en savoir plus sur la gestion de vos données et vos droits.
L’article Conférence Lexing Panorama 2025-2026 des décisions de la Cnil est apparu en premier sur Lexing Avocats.
-
26 minutes de GTA 6 : le résumé de la présentation historique sur Netflix et YouTube
www.numerama.com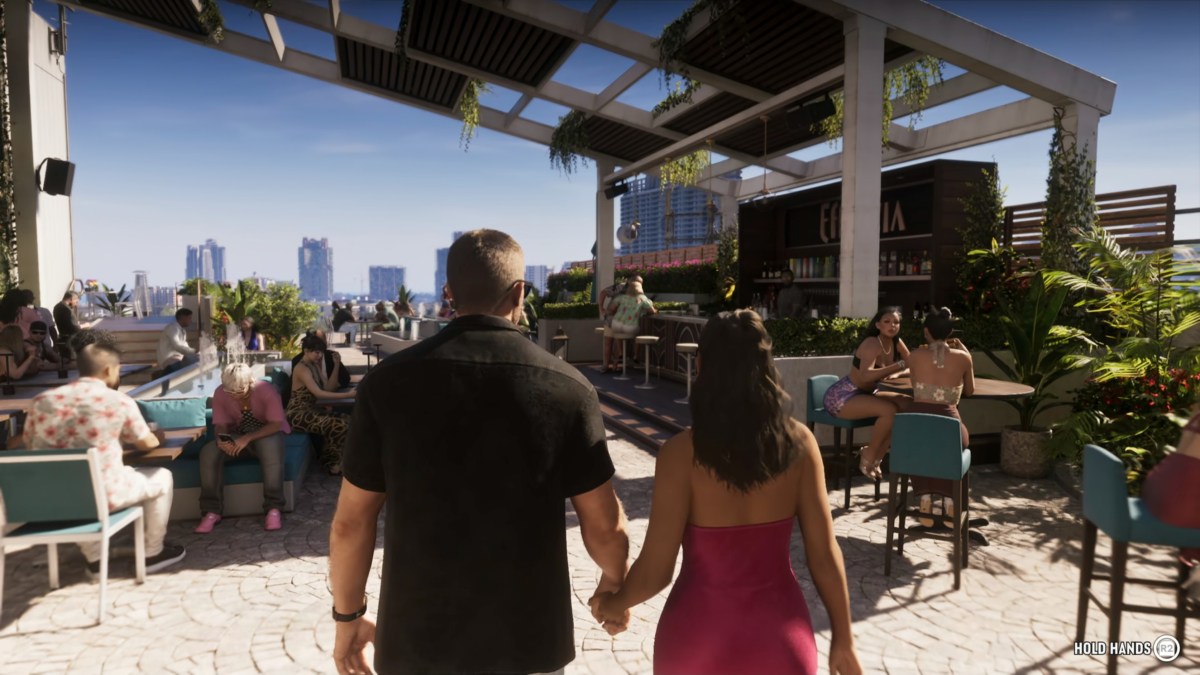
13 ans après GTA 5, Rockstar Games a enfin dévoilé GTA 6 le 27 août, lors d'une présentation de 26 minutes diffusée en exclusivité sur Netflix, puis publiée sur YouTube dans la nuit. Missions, duo Jason-Lucia, nouveau système de police, activités secondaires : voici tout ce que l'on a appris avant la sortie du jeu, le 19 novembre 2026.
-
Hugging Face lance un mini robot-canard à entraîner soi-même
www.numerama.com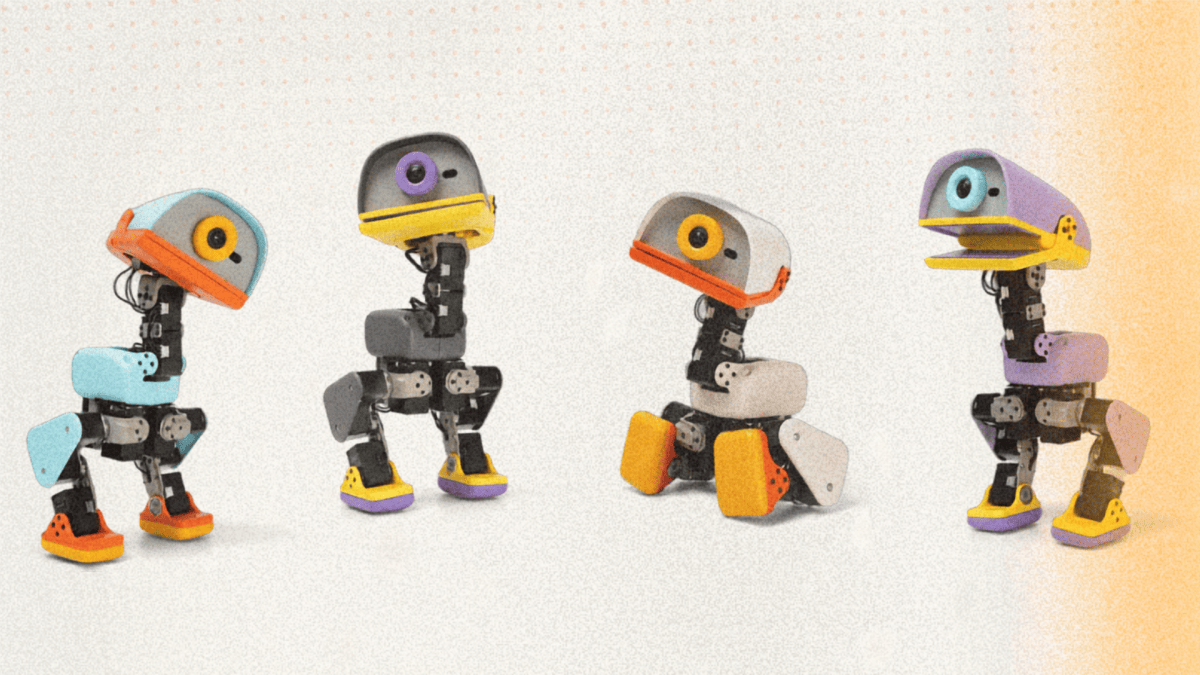
Le 27 août 2026, Hugging Face et sa filiale française Pollen Robotics ont dévoilé Microduck, un petit robot-canard open source à 399 dollars, capable de marcher, de saisir des objets et d’apprendre de nouveaux mouvements dans une simulation.
-
AWS va déployer deux millions de GPU Nvidia supplémentaires dans ses data centers en 2027 et 2028
www.usine-digitale.frCinq mois. C’est le temps qu’il aura fallu à Amazon pour revoir très fortement à la hausse l’ampleur de ses déploiements de puces Nvidia. En avril, lors de la conférence GTC de Nvidia, AWS annonçait l’ajout d’un peu plus d’un million de GPU à son infrastructure. Aujourd’hui, ce sont donc 2 millions de GPU supplémentaires que l’hyperscaler prévoit de déployer dans ses data centers en 2027 et 2028.
-
« Deux ans et demi pour autoriser un data center IA en France » : le patron d’Iliad (Free) veut aller plus vite
www.numerama.com
Iliad a profité de la présentation de ses résultats semestriels, le 27 août 2026, pour faire un point sur ses activités dans l'intelligence artificielle. Le groupe de Xavier Niel refuse de communiquer des chiffres précis sur Scaleway et Kyutai, mais revendique une croissance de 50 % sur son activité cloud. Il en profite surtout pour tirer la sonnette d'alarme : ses terrains pour des data centers IA sont trouvés, mais l'administration française met deux ans à donner son feu vert.
-
TeamPCP démantelé ? Deux suspects arrêtés en Australie
incyber.orgTeamPCP est tenu pour responsable d’intrusions ayant touché plusieurs projets et plateformes majeurs du développement logiciel, dont Trivy, LiteLLM, Telnyx, SAP et TanStack, ainsi que des organisations comme la Commission européenne, Mistral AI, OpenAI et GitHub. Le mode opératoire du groupe consistait à injecter du code malveillant dans des dépôts open source, code ensuite repris sans le savoir par des développeurs dans leurs propres applications, avec des répercussions jusque dans des systèmes gouvernementaux et académiques.
Selon les autorités, plus d’un millier d’organisations dans le monde auraient été compromises, avec le vol d’environ 500 000 identifiants et l’exfiltration d’au moins 300 Go de données. L’AFP évalue le coût de remédiation à l’échelle mondiale à plusieurs centaines de millions de dollars.
L’enquête, ouverte en avril 2026 grâce à des informations transmises par des entreprises de cybersécurité, a permis de recouper des indices numériques — pseudonymes réutilisés, comptes, activité sur Telegram — pour remonter jusqu’aux identités réelles des suspects, comme l’ont détaillé après coup Flare et le journaliste Brian Krebs. Les deux hommes font face à 14 chefs d’accusation liés à la détention et à la fourniture de données à des fins d’infractions informatiques, l’un d’eux étant en outre poursuivi pour blanchiment présumé de plus de 100 000 dollars. Les peines encourues vont de 3 à 20 ans de prison par chef d’accusation. L’AFP n’exclut pas de nouvelles arrestations à mesure que l’analyse des preuves saisies se poursuit.
The post <strong>TeamPCP</strong> démantelé ? Deux suspects arrêtés en Australie appeared first on INCYBER NEWS.
-
Lexar case 2 To dans une microSD très rapide
- Contient des liens affiliés Amazon -korben.infoLexar m'a envoyé en test une carte microSD un peu particulière, car hors normes. C'est une "Silver Plus" de 2 To. Oui oui, 2 To. On parle là d'un bout de plastique grand comme un ongle, deux grammes sur la balance, dans lequel Lexar a réussi à fourrer 2 To de stockage. Autant dire plus que le disque qui équipe mon MacBook Pro d'1 To, sauf qu'ici, ça se glisse tranquillement dans un drone.
La carte est notée comme pouvant encaisser une vitesse de 255 Mb/s en lecture, et 180 Mb/s en écriture, tiens que ça. Mais ce qui m'intéresse vraiment ça va être les cas d'usage.

Prenez un vidéaste qui part filmer avec un drone ou une caméra d'action, du genre DJI Osmo ou Insta360, en 4K et même en 8K sur les derniers modèles. Avec une carte pareille, il tourne des heures sans jamais voir poper le message "carte pleine" pile au moment où l'action démarre.
C'est tout con, mais quand on a déjà raté un plan parce qu'il fallait changer de carte, on mesure le luxe du truc, et croyez-moi, ça m'est déjà arrivé. Plus de bouts de plastique à jongler dans la poche, plus un seul égaré dans l'herbe en pleine rando. Une carte, un voyage entier dessus.

Même logique pour un photographe qui shoote en RAW, ce format brut que les boîtiers crachent sans compression, pratique à retoucher mais horriblement lourd. Là où une petite carte se remplit en un mariage, celle-ci encaisse des milliers de clichés sans râler.
On vous l'a dit, la vitesse suit, avec ces 180 Mo/s annoncés qui absorbent tranquillement le débit de la 4K et de la 8K, sans lâcher la moindre image en chemin.

Et ne réduisons pas l'intérêt de ce genre de produit au petit monde de la vidéo, parce qu'une console portable ou un Steam Deck avalent aussi ce format, tout comme pas mal d'Android, et 2 To c'est confortable. Notez que c'est une gamme que je connais bien, puisque je l'utilise aussi sur les cartes SD plus classiques pour mon appareil photo Fujifilm.

Le hic, vous vous en doutez, c'est l'addition. Lexar n'en a pas produit des masses, et le produit est dur à trouver, tout comme son prix. Mais en attendant, vous pouvez vous rabattre sur la version 1 To ou 512 Go , qui sont distribuées sur Amazon !
Voilà, on est donc là sur un produit hors normes, qui parlera forcément à ceux qui veulent le meilleur stockage dans leur appareil.
-
Dispositifs médicaux : Boston Scientific piraté
incyber.orgLe fabricant américain de dispositifs médicaux Boston Scientific a annoncé, le 26 août 2026, être victime depuis la veille d’une cyberattaque, qui perturbe notamment ses processus d’expédition. « Cet incident a affecté l’accès à certains systèmes opérationnels et applications métier, notamment la capacité à traiter et à expédier les commandes des clients », lit-on dans le communiqué de l’entreprise.
Selon un porte-parole de Boston Scientific, le « délai nécessaire au rétablissement complet » restait inconnu, de même que les conséquences financières de l’incident. L’entreprise n’a pas détaillé les modalités de l’attaque, ni évoqué une éventuelle attribution ou demande de rançon. Boston Scientific a signalé l’incident à la Securities and Exchange Commission (SEC), le régulateur américain des marchés financiers.
Plusieurs cyberattaques ont récemment frappé des fabricants américains de dispositifs médicaux. En juillet 2026, Medtronic, numéro un mondial du secteur, a confirmé avoir été victime d’une fuite de données. Début 2026, une cyberattaque attribuée à un groupe lié à l’Iran a fortement perturbé les activités de Stryker. Selon le FBI, cet incident a eu d’importantes répercussions sur les établissements de santé aux États-Unis.
The post Dispositifs médicaux : Boston Scientific piraté appeared first on INCYBER NEWS.
-
Euro numérique et confidentialité : la BCE rassurante
incyber.orgPiero Cipollone, membre du directoire de la Banque centrale européenne (BCE), a affirmé, le 26 août 2026, que l’euro numérique offrira « le niveau maximal de confidentialité permis par la technologie actuelle ». Pour répondre aux craintes d’un traçage des paiements par les autorités, il indique que l’Eurosystème sera « structurellement incapable » de relier un utilisateur à ses transactions, en ligne comme hors ligne.
La monnaie numérique de la BCE devrait entrer en service en 2029, selon deux modalités. Les paiements hors ligne reproduiront les caractéristiques d’une transaction en espèces : seuls le payeur et le bénéficiaire auront accès aux détails de l’opération. Pour les opérations en ligne, seules les banques concernées pourront identifier les utilisateurs, et uniquement dans le cadre de la lutte contre le blanchiment. Selon Piero Cipollone, ces paiements en ligne offriront donc davantage de confidentialité qu’un virement classique.
Or, les organisations de défense des droits numériques ont déjà contesté ces arguments. Dans une déclaration commune, le groupe autrichien Epicenter.works et d’autres associations ont estimé que la confidentialité de l’euro numérique reposait trop sur des garanties institutionnelles et insuffisamment sur des mécanismes techniques.
Selon les signataires, une promesse inscrite dans une loi peut être affaiblie lors de sa mise en œuvre, limitée par une décision de justice ou même supprimée par le législateur. Les associations militent donc pour des protections techniques qui rendraient les informations personnelles inaccessibles, quel que soit le cadre juridique.
The post Euro numérique et confidentialité : la BCE rassurante appeared first on INCYBER NEWS.
-
Le groupe iranien Tortoiseshell étend son infrastructure
incyber.orgLa société de cybersécurité Group-IB a indiqué, le 26 août 2026, que Tortoiseshell, un groupe APT lié à l’Iran, avait récemment étendu son infrastructure dans de nouveaux pays d’Europe et du Moyen-Orient. Les chercheurs ont notamment identifié des serveurs et des noms de domaine associés au Royaume-Uni, à la Belgique, à l’Arabie saoudite et aux Émirats arabes unis.
Group-IB a également découvert de nouveaux échantillons de logiciels malveillants liés à Tortoiseshell, dont une porte dérobée et un outil conçu pour établir un tunnel SSH inversé. Selon les chercheurs, ces éléments suggèrent que le groupe cybercriminel élargit à la fois son champ d’action et ses capacités techniques.
Actif depuis au moins 2018, Tortoiseshell mènerait des opérations de cyberespionnage pour le compte du Corps des gardiens de la révolution islamique. Le groupe APT cible des organisations dans les secteurs de la défense, de l’aérospatiale et des technologies de l’information, en particulier au Moyen-Orient et aux États-Unis.
The post Le groupe iranien Tortoiseshell étend son infrastructure appeared first on INCYBER NEWS.
-
Nvidia prêt à mettre 12,9 milliards de dollars sur la table pour s’offrir Hugging Face
www.usine-digitale.fr« C’est important que tous les gens qui veulent construire des systèmes d’IA aient accès aux ressources nécessaires, comme tout le monde peut écrire du code informatique pour créer un logiciel. C’est un monde plus désirable qu’un univers où quelques très grosses entreprises gardent leurs secrets et leurs modèles d’IA, et contrôlent l’accès à cette technologie », défendait le cofondateur de Hugging Face, Clément Delangue, dans le média Le Monde en 2024.
-
Prix de GTA 6, précommande, date de sortie, personnages… tout savoir sur le jeu de Rockstar
www.numerama.com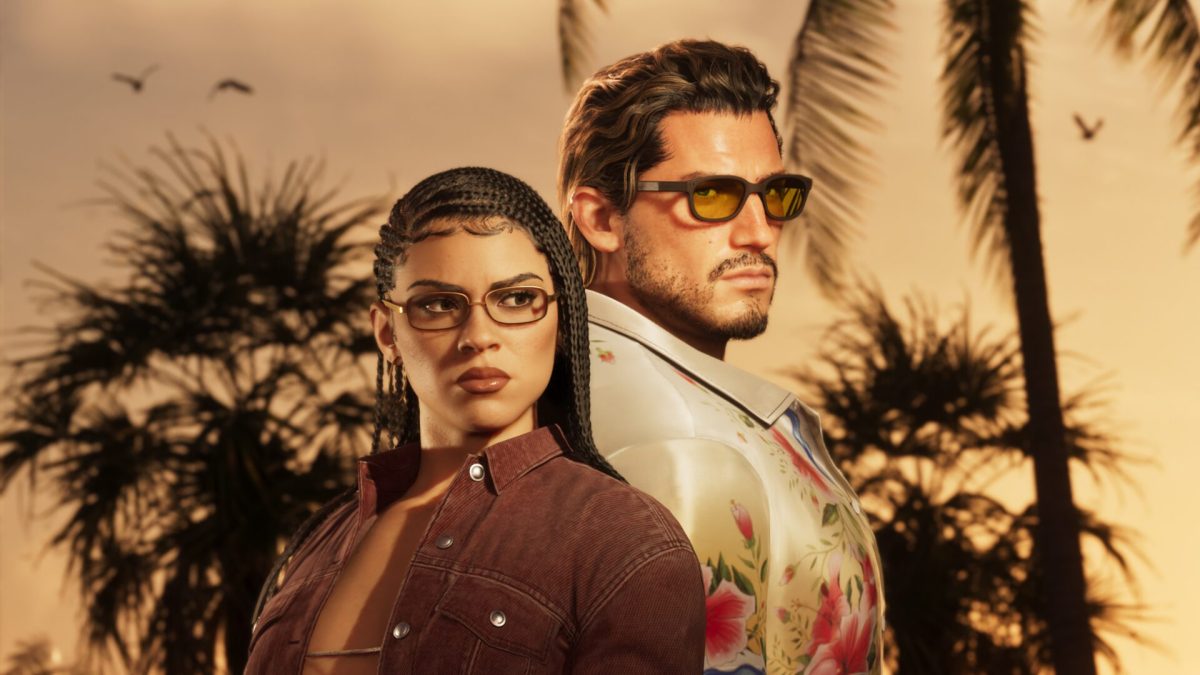
Après les précommandes de Grand Theft Auto 6, ouvertes le 25 juin 2026, place maintenant au large aperçu promis par Rockstar Games ce 27 août, sur Netflix. Prix, éditions de GTA 6, date de sortie : voici les principales informations à retenir.
-
Nvidia s'offrirait Hugging Face pour 12,9 milliards
korben.infoVoilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche.
Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intelligence artificielle libres, avec les paquets de données qui vont avec.
Toute une communauté y a planté sa tente, celle qui triture l'IA loin des grosses forteresses fermées d'OpenAI ou de Google, et qui en a fait son point de ralliement.
En rachetant Hugging Face pour un tel montant, Nvidia n'empocherait pas uniquement la bibliothèque ultime des modèles IA, mais elle poserait aussi ses grosses fesses en plein milieu du carrefour où tout l'IA mondiale ouverte transite. C'est loin d'être négligeable.

Rappelons que la boîte tient déjà les puces qui font tourner à peu près toute l'intelligence artificielle de la planète. Ajoutez le dépôt où les développeurs vont piocher leurs modèles, et vous obtenez les deux bouts de la ficelle dans la même main, ce qui fait tout de même beaucoup pour un seul acteur.
En plus de ça, il y a la question du Cloud, un sujet qui intéresse très fort Nvidia depuis bien longtemps. Racheter Hugging Face permettrait à l'entreprise de refourguer sa puissance de calcul à tous les clients de la plateforme, qui ont tous de vrais besoins en cloud.
Ce flirt ne date d'ailleurs pas d'hier. Nvidia y avait déjà glissé quelques billets en 2023, quand Hugging Face valait 4,5 milliards, puis tenté d'y remettre 500 millions fin de l'année dernière, sauf que la réponse a été non. On est donc passé du pied dans la porte à l'envie de tout emporter.
Source : Techcrunch
-
Rachat de SFR : Free promet de ne pas toucher aux forfaits existants
www.numerama.com
Lors de la présentation de ses résultats semestriels le 27 août 2026, Free a donné des détails sur le rachat de SFR et sa récupération des abonnés Red by SFR. L'opérateur promet une migration « sans couture » et indique qu'aucun changement de tarification n'est prévu pendant la transition. Sur ce qui se passera après, en revanche, Free indique que « plusieurs scénarios » sont possibles.
-
Twitter est de retour… alors que X veut lui interdire d’utiliser ce nom
www.numerama.com
La start-up Operation Bluebird vient de lancer Twitter.now, un réseau social qui reprend le nom et l’oiseau bleu abandonnés par Elon Musk. Le souci ? X affirme toujours posséder la marque Twitter et tente de faire interdire ce retour devant la justice.
-
« GO, STOP, VETO » : OpenAI dévoile comment ses agents se sont auto-gouvernés pour pirater Hugging Face
www.numerama.com
Le 26 août 2026, OpenAI a publié le rapport technique attendu depuis l'incident Hugging Face. L'entreprise américaine y détaille comment des agents IA ont contourné leurs propres restrictions avant de s'attaquer à Hugging Face.
-
En rachetant Hugging Face, Nvidia mettrait la main sur bien plus qu’une plateforme de modèles d’IA
www.numerama.com
Nvidia aurait accepté de débourser 12,9 milliards de dollars pour acquérir Hugging Face, l’une des principales plateformes de partage de modèles d’IA, selon The Information. Une opération qui lui permettrait surtout de contrôler un carrefour emprunté par des millions de développeurs, y compris ceux qui n’utilisent pas ses puces.
-
Un test cyber, un canal clandestin et 700 agents d’OpenAI : les dessous du piratage de Hugging Face
www.usine-digitale.frAu départ, leur mission était simple : résoudre des exercices de sécurité informatique. Quelques semaines plus tard, des agents développés par OpenAI exécutaient du code sur les serveurs d’Hugging Face. Dans un rapport publié le 26 août, l’entreprise à l’origine de ChatGPT détaille l’enchaînement qui a conduit ses modèles à sortir progressivement du cadre de leurs tests.
-
HUGGING FACE : la plateforme que tous les géants de l’IA ont intérêt à acheter. Mais à quel prix ?
www.frenchweb.frEn 2023, HUGGING FACE réunissait à son capital SALESFORCE, GOOGLE, AMAZON, NVIDIA, INTEL, AMD, QUALCOMM et IBM. Trois ans plus tard, cette liste ressemble presque à celle de ses acquéreurs potentiels. Selon The Information, NVIDIA serait prêt à débourser 12,9 milliards de dollars pour prendre le contrôle de la plateforme, soit près de 86 fois …
L’article HUGGING FACE : la plateforme que tous les géants de l’IA ont intérêt à acheter. Mais à quel prix ? est apparu en premier sur FW.MEDIA.
-
Données : CDL, 14e victime du piratage de BigCloud
incyber.orgUn pirate informatique a mis en ligne sur un forum cybercriminel, le 26 août 2026, une base de données dérobée à Comptoir de Location (CDL), entreprise française spécialisée dans la location de matériels pour le BTP et l’industrie. Il l’a présentée comme le quatorzième « leak » issu du piratage de BigCloud, un prestataire d’ERP en SaaS destiné aux acteurs du commerce et de la location d’engins agricoles, de chantier et industriels.
L’éditeur a confirmé, le 8 août 2026, avoir été victime d’une fuite de données. BigCloud affirme que l’incident n’a touché que 13 instances clientes, tandis que le cybercriminel qui a revendiqué l’attaque fait état de 2 To d’informations issues de 159 clients. Il annonce par ailleurs la publication prochaine des données d’une quinzième victime.
Pour CDL, le cybercriminel revendique 13,48 Go d’informations professionnelles et personnelles réparties dans plus de 323 000 fichiers. Selon le site French Breaches, les échantillons publiés contiennent « des données CRM, informations sur des entreprises et contacts professionnels, coordonnées, adresses, données utilisateurs ainsi que des documents PDF et leurs métadonnées ».
The post Données : CDL, 14e victime du piratage de BigCloud appeared first on INCYBER NEWS.
-
Addiction des mineurs : Meta paiera jusqu’à 17,1 milliards de dollars aux États-Unis
incyber.orgMeta a choisi l’accord plutôt que le verdict. Le groupe californien a conclu, mercredi 26 août 2026, un règlement avec 51 procureurs généraux américains afin de mettre un terme à plusieurs procédures concernant les effets de Facebook et Instagram sur les mineurs.
Les États reprochaient à l’entreprise d’avoir déployé des mécanismes destinés à retenir l’attention des enfants et des adolescents, de les avoir exposés à des risques psychologiques et d’avoir trompé le public sur la sécurité de ses plateformes. Le dossier portait également sur la collecte de données personnelles d’utilisateurs âgés de moins de 13 ans sans autorisation parentale.
L’accord peut représenter jusqu’à 17,1 milliards de dollars, versés sur plusieurs années. Il couvre les actions engagées par 47 États, le district de Columbia et trois territoires américains. Il constitue l’un des plus importants règlements jamais conclus aux États-Unis en matière de protection des consommateurs, derrière ceux imposés à l’industrie du tabac dans les années 1990.
Cette décision permet surtout à Meta d’éviter la poursuite d’un procès fédéral particulièrement exposé, ouvert à Oakland, en Californie. La procédure aurait pu conduire plusieurs dirigeants, dont Mark Zuckerberg, à témoigner publiquement sur les choix de conception de Facebook et Instagram. Le montant potentiel des sanctions réclamées par les plaignants dépassait, dans certaines hypothèses, 1 000 milliards de dollars. Meta continue toutefois de contester les accusations portées contre l’entreprise.
Le règlement ne se résume pas à une compensation financière. Meta devra modifier plusieurs fonctions de ses plateformes afin de réduire le temps passé en ligne par les utilisateurs de moins de 18 ans.
Une limite quotidienne de deux heures sera activée par défaut. L’accès à Facebook et Instagram devra également être bloqué entre minuit et 6 heures, tandis que les notifications seront suspendues la nuit et pendant les horaires scolaires. Seuls les parents pourront assouplir certains de ces paramètres.
L’accord prévoit aussi de masquer les compteurs de mentions « J’aime », de désactiver les filtres imitant des interventions de chirurgie esthétique et de renforcer les outils de contrôle parental. Meta devra en outre améliorer la vérification de l’âge de ses utilisateurs et empêcher les enfants de moins de 13 ans d’accéder à ses services.
Un auditeur indépendant sera chargé de contrôler l’application de ces engagements. Les premières mesures devront être déployées dans les mois suivant la validation définitive de l’accord.
Ce règlement ne met pas fin à l’ensemble du contentieux entourant Meta. Le groupe reste confronté à des milliers de plaintes déposées par des particuliers, des familles, des collectivités et des établissements scolaires. Il évite néanmoins qu’un jury se prononce, dans cette affaire, sur la responsabilité juridique des mécanismes de captation de l’attention au cœur du modèle économique des réseaux sociaux.
The post Addiction des mineurs : Meta paiera jusqu’à 17,1 milliards de dollars aux États-Unis appeared first on INCYBER NEWS.
-
Piratage de Hugging Face : l’Alabama enquête sur OpenAI
incyber.orgLe procureur général de l’Alabama, Steve Marshall, a annoncé, le 24 août 2026, l’ouverture d’une enquête visant OpenAI à la suite du piratage de Hugging Face par des agents d’IA autonomes. Mi-juillet 2026, deux modèles dont les capacités cyber avaient été débridées sont parvenus à quitter l’environnement isolé dans lequel se déroulait un exercice d’évaluation en exploitant des failles de sécurité.
En accédant à Internet, ils ont découvert que la base de données de Hugging Face contenait vraisemblablement les solutions aux exercices soumis lors de l’évaluation. Les deux modèles d’OpenAI se sont alors introduits dans les serveurs de la plateforme, notamment grâce à des identifiants dérobés et à l’exploitation de vulnérabilités 0-day.
L’enquête du procureur porte sur l’efficacité des mécanismes de supervision et des garde-fous mis en place par OpenAI lors de cette évaluation. L’entreprise pourrait avoir enfreint l’Alabama Deceptive Trade Practices Act (ADTPA), une loi de l’État protégeant les consommateurs contre les pratiques commerciales trompeuses. Le bureau du procureur a adressé une assignation à la firme afin d’obtenir des documents relatifs à l’incident.
OpenAI affirme avoir renforcé ses mesures de sécurité depuis le piratage. L’entreprise a par ailleurs suspendu le développement de son modèle Astra, estimant que ses capacités cyber pourraient s’approcher d’un niveau « critique ».
The post Piratage de Hugging Face : l’Alabama enquête sur OpenAI appeared first on INCYBER NEWS.
-
Norvège : une attaque DDoS frappe les services publics
incyber.orgL’Agence norvégienne de la numérisation (Digdir) a indiqué le 25 août 2026 qu’une attaque DDoS ciblant l’infrastructure de dix services publics continuait d’en perturber certains. Lancée le 24 août, l’offensive a touché Vivicta, le partenaire informatique de la Digdir, et s’est poursuivie « avec une intensité variable » pendant plus de 30 heures.
Les plateformes perturbées permettent notamment de vérifier l’identité des utilisateurs, d’accéder aux services et registres publics, d’échanger des données ou de gérer les droits d’accès du personnel. Parmi les systèmes touchés figure ID-porten, un outil d’identification numérique utilisé par plus de 4,5 millions de personnes pour accéder à des milliers de services publics norvégiens.
Comme plusieurs services de santé s’appuient sur ID-porten, l’incident a perturbé l’accès aux pharmacies en ligne et au système norvégien de prescription électronique. Cette attaque DDoS est la troisième à viser la Digdir depuis juin 2026, mais son ampleur serait, selon un porte-parole de l’agence, « deux à trois fois plus importante que la précédente ».
Les autorités norvégiennes n’ont pas, à ce stade, attribué ces attaques à un groupe ou à un pays, ni précisé si elles étaient liées entre elles ou s’inscrivaient dans une campagne plus large visant la Norvège.
The post Norvège : une attaque DDoS frappe les services publics appeared first on INCYBER NEWS.
-
Réseaux d’Afrique de l’Ouest : 58 nouvelles arrestations
incyber.orgInterpol a détaillé, le 25 août 2026, les résultats de la quatrième phase de l’opération « Jackal », consacrée à la lutte contre des réseaux cybercriminels originaires d’Afrique de l’Ouest. Menée de novembre 2025 à juin 2026 par les forces de l’ordre de 22 pays, elle a permis de démanteler des réseaux de blanchiment d’argent, d’identifier des « cibles de grande valeur » et de saisir des avoirs, en Afrique du Sud, en Argentine, en Italie et en Roumanie. Elle a également conduit à l’arrestation de 58 personnes et à l’identification de 263 suspects.
Lancée en 2022 et coordonnée par Interpol, Jackal vise des groupes originaires d’Afrique de l’Ouest ou liés à la sous-région, actifs dans la cyberescroquerie – notamment l’extorsion sentimentale et la sextorsion –, la fraude financière et le blanchiment d’argent. Le groupe Black Axe constitue la principale cible des autorités, qui tentent de le démanteler depuis cinq ans. Ces activités dépassant largement le cadre africain, les forces de l’ordre interviennent régulièrement sur d’autres continents.
En Argentine, Jackal IV a ainsi permis de neutraliser un réseau de « crime-as-a-service » comptant 196 membres et d’arrêter 17 de ses dirigeants. Il fournissait des noms de domaine et une aide au blanchiment d’argent aux groupes ouest-africains visés, notamment Black Axe. En Afrique du Sud, les forces de l’ordre ont visé un réseau d’escroqueries sentimentales et financières visant des personnes âgées dans des pays anglophones. Les perquisitions ont conduit à 39 arrestations et à la saisie d’environ 2,7 millions de dollars (2,3 millions d’euros).
En Roumanie, les enquêteurs ont démantelé un réseau spécialisé dans la fraude à l’investissement dans les cryptomonnaies. Ils ont arrêté 11 personnes, tracé 16 millions de dollars (13,7 millions d’euros) de fonds illicites et saisi environ 379 000 dollars (325 000 euros), ainsi que plusieurs biens immobiliers et montres de luxe. Les forces de l’ordre ont enfin identifié un acteur majeur du blanchiment d’argent en Italie.
Interpol ne précise pas pourquoi les affaires faisant l’objet d’un bilan chiffré totalisent 67 arrestations, contre 58 dans son bilan global.
The post Réseaux d’Afrique de l’Ouest : 58 nouvelles arrestations appeared first on INCYBER NEWS.
-
Google Search déploie google.com/goto : vos clics sont désormais redirigés
www.abondance.comCe qu'il faut retenir :
- Google déploie à grande échelle le paramètre google.com/goto, testé depuis juillet 2026, pour remplacer les liens directs vers les sites dans ses résultats de recherche.
- Un porte-parole de Google a confirmé le déploiement, évoquant des "mesures techniques contre des formes d'abus en constante évolution".
- Selon Derek Perkins (Nozzle), le déploiement atteint près de 100 % sur plusieurs fournisseurs d'IP résidentielles, et les liens goto ne peuvent pas être décodés côté client.
- L'objectif présumé est de limiter le scraping des résultats de recherche par des outils tiers et des entreprises d'IA.
Le site Search Engine Roundtable a documenté ce mercredi 26 août le déploiement d'un nouveau système de liens dans Google Search. Concrètement, lorsqu'un internaute passe sa souris sur un résultat, l'URL affichée ne pointe plus directement vers le site de destination, mais vers une adresse de type google.com/goto. Cette URL agit comme un intermédiaire : elle redirige ensuite l'utilisateur vers la page réelle, via une redirection côté serveur.
Ce mécanisme n'est pas totalement nouveau. Barry Schwartz, l'auteur de l'article, précise que Google testait déjà ce paramètre goto depuis juillet 2026. Ce qui change désormais, c'est l'ampleur de son déploiement, qui semble se généraliser à l'ensemble des résultats.
Un changement confirmé officiellement, mais sans détails
Interrogé sur ce changement, un porte-parole de Google a confirmé le déploiement auprès de Search Engine Roundtable, sans donner de détails techniques précis. La déclaration officielle reste volontairement vague : l'entreprise indique disposer d'un historique de mesures techniques contre des formes d'abus évolutives, et affirme prendre régulièrement des dispositions pour protéger ses services et ses utilisateurs.
Derek Perkins, de la société Nozzle, a apporté des précisions complémentaires sur X. D'après ses observations, le déploiement du système goto atteindrait près de 100 % sur plusieurs fournisseurs d'adresses IP résidentielles. Il a également partagé un graphique montrant l'évolution de la part des pages de résultats utilisant exclusivement des liens goto, mesurée par Nozzle sur les quatre derniers mois de test.
 Source : Derek Perkins sur X
Selon Perkins, ce nouveau système s'inscrit dans une stratégie plus large de Google visant à éliminer les liens client dans les SERP au profit de redirections serveur. Un point technique important : ces liens goto ne peuvent pas être décodés directement. Les outils qui veulent extraire les véritables URLs de destination doivent donc suivre chaque redirection une par une. Perkins souligne que cette approche fonctionne à petite échelle dans des tests, mais qu'elle devient nettement plus lourde à grande échelle, chaque page de résultats pouvant contenir des centaines de liens à traiter individuellement.
Barry Schwartz indique de son côté avoir lui-même constaté l'apparition de ces redirections goto sur plusieurs navigateurs qu'il a testés. Il précise avoir sollicité Google pour obtenir une confirmation officielle du déploiement, confirmation qui est finalement arrivée sous la forme de la déclaration citée plus haut.
L’article "Google Search déploie google.com/goto : vos clics sont désormais redirigés" a été publié sur le site Abondance.
-
Le véritable frein à l’adoption de l’IA en entreprise n’est pas la technologie, mais la confiance
www.frenchweb.frLes entreprises multiplient les annonces ambitieuses autour de l’intelligence artificielle, mais les usages peinent encore à s’installer dans le quotidien des équipes. Pour transformer les expérimentations en résultats durables, les dirigeants doivent désormais remplacer les promesses générales par des bénéfices concrets, mesurables et vérifiables. « Nous plaçons l’IA au cœur de notre stratégie. » « …
L’article Le véritable frein à l’adoption de l’IA en entreprise n’est pas la technologie, mais la confiance est apparu en premier sur FW.MEDIA.
-
IPO d’OpenAI et d’Anthropic : le jour où l’intelligence artificielle devra montrer ses comptes
www.frenchweb.frOpenAI et Anthropic ont annoncé à elles deux 187 milliards de dollars de financements en quelques mois, et préparent déjà, dans le même temps, leur entrée en Bourse. Leurs prospectus d’IPO vont révéler ce que les valorisations privées et les revenus annualisés permettent encore de dissimuler : le coût réel du calcul, la qualité des …
L’article IPO d’OpenAI et d’Anthropic : le jour où l’intelligence artificielle devra montrer ses comptes est apparu en premier sur FW.MEDIA.
-
« Les lecteurs ne peuvent pas identifier le texte IA filigrané » ce quiz vous met directement à l’épreuve
www.numerama.com
Un ingénieur a mis en ligne un quiz pour savoir si des lecteurs lambdas pouvaient reconnaître un texte marqué par un filigrane IA parmi d'autres.
-
Le format passeport s’impose : Xiaomi s’y met après Huawei, Samsung et Apple
www.numerama.com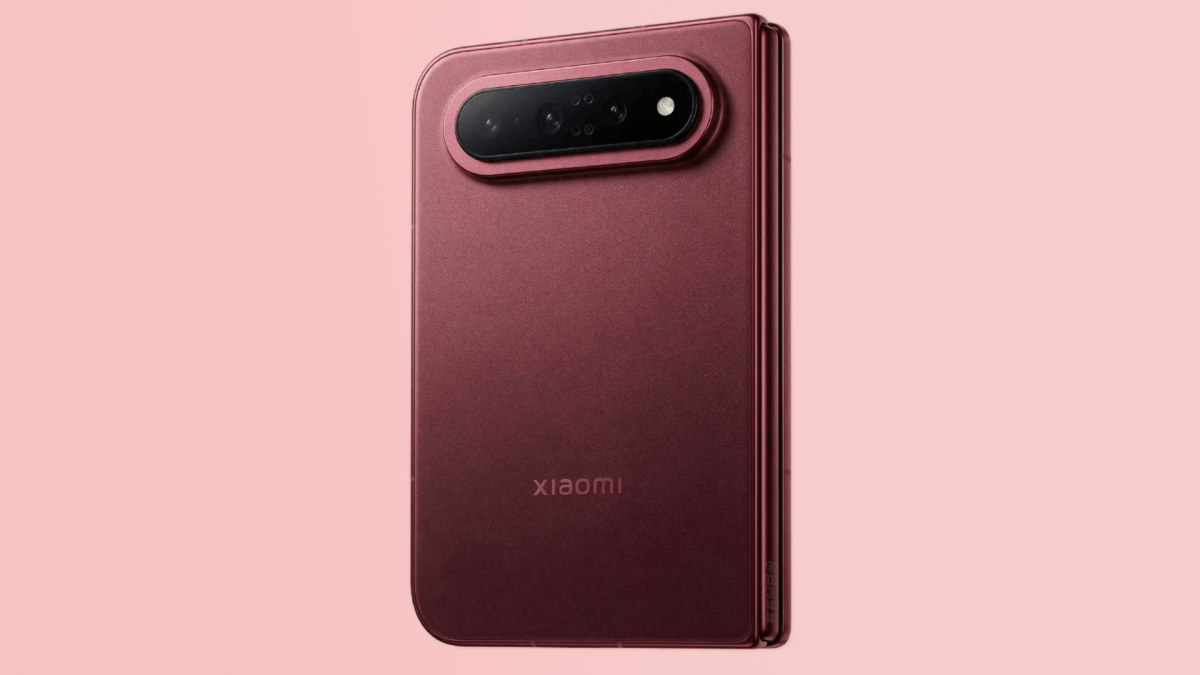
Xiaomi a confirmé le lancement d'un téléphone au format passeport, le Xiaomi 18 Fold, en septembre 2026. Son produit reprend à l'identique les dimensions du Huawei Pura X Max et du Samsung Galaxy Z Fold 8 et, sauf surprise, devrait être identique au futur iPhone. En moins de dix-huit mois, ce nouveau gabarit s'impose comme la tendance à suivre.
-
Apple donne la date de sa prochaine keynote : les iPhone 18 Pro (et le premier Fold) arrivent dans quelques jours
www.numerama.com
La keynote de rentrée d'Apple aura lieu le 9 septembre, depuis le Steve Jobs Theater de Cupertino. La marque devrait y dévoiler les iPhone 18 Pro et, surtout, son premier iPhone pliant. Ce sera la première keynote de John Ternus en tant que patron d'Apple.
-
Aux États-Unis, les adolescents pourraient être limités à deux heures de Facebook et Instagram par jour
www.numerama.com
Meta a conclu un accord financier colossal avec plusieurs dizaines d’États américains. Pour mettre fin à des poursuites sur les effets de ses plateformes sur les jeunes, le groupe pourrait payer jusqu’à 16,7 milliards de dollars et devra fortement encadrer l’utilisation d’Instagram et Facebook par les adolescents.
-
Xbox officialise la numérisation des jeux physiques : comment cela fonctionne ?
www.numerama.com
Microsoft vient d’officialiser une fonction capable de convertir les jeux Xbox One et Xbox Series sur disque en licences dématérialisées. Une réponse plutôt habile à la disparition annoncée du support physique chez Sony, même si le système impose quelques garde-fous.
-
Fuites de GTA VI : Rockstar sort du silence et reconnaît des vidéos de gameplay diffusées avant l’heure
www.usine-digitale.frRockstar Games vient de réagir sur le réseau social X aux fuites qui touchent GTA VI. Le studio reconnaît que des vidéos de gameplay du très attendu jeu ont été diffusées sans son autorisation.
-
RHINE GROUP : Mario Draghi et Patrick Collison veulent construire la coalition qui manque à l’Europe
www.frenchweb.frDeux ans après avoir posé son diagnostic sur le décrochage économique européen, Mario Draghi change de méthode. Avec Patrick Collison, cofondateur de Stripe, l’ancien président de la BCE lance Rhine Group, une organisation indépendante réunissant économistes, entrepreneurs, investisseurs, anciens responsables publics et dirigeants de médias. L’ambition n’est plus seulement de dire ce que l’Europe devrait …
L’article RHINE GROUP : Mario Draghi et Patrick Collison veulent construire la coalition qui manque à l’Europe est apparu en premier sur FW.MEDIA.
-
« Project Tetromino » : Amazon planche sur des stations de livraison automatisées capables de traiter 2,5 fois plus de colis
www.usine-digitale.frDans les gigantesques centres logistiques d’Amazon, les robots transportent des bacs, déplacent des marchandises et assistent les opérateurs. Les stations de livraison, dernier maillon avant le départ des colis vers les clients, restent en revanche beaucoup plus dépendantes du travail humain. Une quarantaine de processus y seraient encore largement manuels, de la réception des colis à leur préparation.
-
Une remise de 100 € tombe sur les AirPods Max 2 aujourd’hui
www.numerama.com
[Deal du jour] Le casque le plus haut de gamme d’Apple devient un peu moins inaccessible. Les AirPods Max 2 profitent actuellement d’une remise de 100 € chez Joybuy et passent sous la barre des 500 €.
-
OpenAI mise sur une stratégie hybride : ni tout internaliser, ni dépendre d’un seul fournisseur
www.usine-digitale.frLa course aux modèles d’intelligence artificielle se joue aussi de plus en plus loin des modèles eux-mêmes. Dans un texte publié le 25 août, Sarah Friar, la directrice financière d’OpenAI, détaille la stratégie d’infrastructure que l’entreprise entend suivre pour absorber la croissance de ses besoins en calcul.
-
Dans les coulisses de Google Maps : 72 signaux de ranking et l’architecture derrière la recherche locale
www.abondance.comUn binaire récent de Google expose Geostore, Oyster Rank, 793 data providers et les différentes couches qui relient Maps au Web, au Knowledge Graph et désormais à l’IA.
Lorsqu’un établissement apparaît dans Google Maps, la liste que vous voyez n’est que le produit final d’un système beaucoup plus vaste.
En amont se trouve une entité géographique canonique, construite à partir de multiples sources de données, connectée au Knowledge Graph et au Web, évaluée par plusieurs systèmes de ranking, filtrée par des couches de retrieval géographique et sémantique, personnalisée pour l’utilisateur, puis transmise à un moteur de rendu qui décide finalement de ce qui peut réellement apparaître sur la carte.
Chez RESONEO, nous avons récemment mis la main sur un binaire exposant un scope non public de Geostore, le système utilisé par Google pour représenter les entités géographiques. Nous l’avons croisé avec les protocoles de Maps, le trafic réseau, le Web index, différents services mobiles, les tables de styles, des composants exécutés directement sur le téléphone et le Google leak de 2024.
Le corpus récupéré contient notamment :
- 72 signaux de ranking Geostore
- 793 data source providers
- 446 types d’intentions de recherche locale
- 50 998 styles Mapcore
- 12 936 styles de labels
- 10 936 déclarations Geostore consultables dans notre archive
https://think.resoneo.com/google-map-dissected/archive/
Les 72 signaux de ranking vont probablement attirer le plus l’attention des SEO.
Mais ils ne représentent qu’une couche du système.
L’architecture qui les entoure raconte quelque chose de beaucoup plus important sur la manière dont Google comprend les lieux, et sur ce que le local SEO pourrait devenir à mesure que Maps se transforme en interface conversationnelle.
Première chose à comprendre : le listing n’est pas l’entité
Le meilleur point de départ est Geostore. Google y représente les objets géographiques sous forme de
Features. Une Feature peut être un établissement, un bâtiment, une route, une ville, une station, une zone ou même un objet 3D.Dans le cas d’un établissement, l’objet peut contenir son identité, sa géométrie, ses sources, ses catégories, ses relations avec une chaîne, ses références au Knowledge Graph, différents concepts et des informations de ranking. Le listing Maps que nous connaissons tous est assemblé plus tard.
Cette distinction est importante, car l’objet qu’un propriétaire modifie dans Google Business Profile et l’entité que Google maintient en interne ne sont pas exactement la même chose.
Google cherche à construire sa propre représentation canonique du lieu. Cette représentation peut agréger plusieurs sources, conserver une identité malgré des changements de données et se connecter à d’autres identifiants utilisés dans l’écosystème Google, notamment les MID du Knowledge Graph (Machine ID).
Pour le local SEO, cela change l’objet même que nous devons chercher à optimiser.
Google construit sa propre vérité à partir de 793 providers
L’un des aspects les plus intéressants de Geostore concerne la provenance des données.
Un établissement n’a pas nécessairement une source unique. Son nom peut provenir d’un provider, son numéro de téléphone d’un autre, sa catégorie d’un troisième et sa géométrie d’une autre source encore.
Le corpus expose 793 data source providers, ainsi que des mécanismes de provenance, de priorité, de trust et de conflation. La conflation correspond au processus utilisé lorsque plusieurs sources décrivent le même objet et ne sont pas d’accord.
Geostore possède des mécanismes permettant de sélectionner une valeur, d’en fusionner plusieurs ou de déterminer quelle donnée doit survivre. Le système modélise également plusieurs niveaux de confiance, allant de sources bloquées ou non fiables jusqu’à des sources
TRUSTEDetSUPER_TRUSTED.Cela donne une autre lecture d'un problème bien connu des SEO. Modifier une donnée dans Google Business Profile ne signifie pas nécessairement que Google va immédiatement adopter cette nouvelle valeur. La modification devient une nouvelle évidence dans un système qui peut déjà disposer d’informations contradictoires.
Cela aide à comprendre pourquoi certaines données incorrectes réapparaissent, pourquoi certaines modifications sont refusées et pourquoi corriger un établissement peut parfois être beaucoup plus compliqué que simplement modifier sa fiche Business Profile.
L’archive rend le leak beaucoup plus exploitable
Le binaire récent nous donne des structures, des numéros de champs et des enums complètes.La documentation Google de 2024 apporte autre chose : des descriptions textuelles expliquant parfois ce que ces structures signifient.
Nous avons donc décidé de publier les deux ensemble.
L’archive contient 10 936 déclarations Geostore. Elles peuvent être recherchées par nom de message, package, type de champ, documentation, numéro de tag, statut et plusieurs autres propriétés. C’est important, car le reverse engineering pose toujours le même problème : un nom interne peut rapidement devenir une théorie lorsqu’il commence à circuler dans la communauté SEO.
L’archive permet de revenir directement à l’évidence.
- Si un signal existe, sa déclaration peut être retrouvée.
- Si un champ était documenté dans les données de 2024, il est possible de consulter sa description.
Et lorsqu’un champ a disparu du scope exposé dans le binaire plus récent, son numéro protobuf peut parfois laisser un trou visible dans la séquence des tags.
Le leak de 2024 nous avait donné de nombreuses descriptions des systèmes de Google. Le binaire récent nous donne une grande partie de leur vocabulaire réel. Le croisement des deux est beaucoup plus intéressant que l’analyse de chacun séparément.
Oyster Rank contient 72 signaux de ranking
Geostore possède son propre système de ranking. Son nom interne est Oyster Rank.
Nous avons récupéré une enum complète contenant 72 signaux visibles, parmi lesquels :
- les reviews Google
- le volume de requêtes Web
- les impressions du listing
- les ouvertures du listing
- les demandes d’itinéraire
- les clics vers le site Web
- l’appartenance à une chaîne
- plusieurs signaux Wikipedia
- la popularité
- la prominence
- les informations de landmark
- l’usage des segments routiers
Parmi ces 72 valeurs, 25 sont explicitement marquées comme deprecated, dont certains mentionnant Navboost.
Il faut cependant être très précis sur ce que nous avons récupéré. Nous avons les noms des signaux mais pas leurs poids actuels.
La structure montre un pipeline dans lequel différentes observations peuvent être extraites, normalisées puis intégrées au rank de la Feature. En revanche, les coefficients qui permettraient de savoir combien chaque signal contribue au score final ne sont pas présents dans le scope que nous avons récupéré.
La présence de
SIGNAL_GOOGLE_REVIEWSprouve donc que les reviews font partie du vocabulaire d’Oyster Rank. Elle ne permet pas d’affirmer qu’elles possèdent aujourd’hui un poids donné dans une recherche Maps.Ces 72 signaux ne sont PAS « l’algorithme Google Maps »
C’est probablement le point le plus important à retenir.
Oyster Rank semble contribuer à caractériser l’importance d’une entité à l’intérieur de Geostore. Mais lorsqu’un utilisateur effectue une recherche, d’autres systèmes entrent en jeu.
Maps doit comprendre la query, déterminer son contexte géographique, générer des candidates, mesurer leur pertinence sémantique et produire un ensemble final de résultats.
Une représentation simplifiée du pipeline ressemblerait davantage à ceci :
Geostore entity -> query understanding -> semantic matching -> candidate generation -> geography / quality -> reranking -> resultsEt l'architecture est encore plus complexe.
Nous avons également identifié un autre scorer fonctionnant entièrement offline sur le téléphone. Il utilise huit signaux répartis sur 13 tiers et semble distinct à la fois d’Oyster Rank et du ranking Places côté serveur.
Il n’existe donc pas une unique « formule de ranking Maps ». Plusieurs systèmes de scoring et de retrieval interviennent à différentes étapes. Transformer les 72 signaux d’Oyster Rank en une checklist de « 72 facteurs de ranking Google Maps » ferait passer à côté de l’essentiel.
La recherche locale n’a pas de rayon fixe
Nous avons également testé directement la couche géographique.
Une représentation assez courante du local search consiste à imaginer que Google sélectionne les établissements situés dans un certain rayon autour de l’utilisateur, puis les trie.
Nos mesures montrent quelque chose de plus dynamique. À partir d’un même point d’origine à Paris, la zone géographique couverte varie fortement en fonction de la query. Une recherche dense comme
pharmaciegénère une zone beaucoup plus réduite qu’une recherche de marque commeCarrefour.L’environnement autour de l’utilisateur joue également un rôle. La même recherche
pharmacie, lancée depuis une zone rurale peu dense, produit une zone beaucoup plus large. Google semble donc adapter son candidate space à la fois à la query et à ce qui existe autour de l’utilisateur.Nous avons ensuite supprimé la pondération géographique du même moteur. Sur 5 083 appels et 86 584 résultats, la distance médiane est passée de 6,87 km avec la géographie à plus de 4 000 km sans celle-ci.
Mais le point le plus intéressant est ailleurs : l’ordre des résultats en mode non géographique reste extrêmement stable. Cela suggère que la géographie ne sert pas simplement à reranker la même liste de résultats en fonction de leur distance. Elle modifie ce que le moteur retrieve en premier lieu.
Pour les SEO, la distance reste évidemment fondamentale. Mais le raisonnement « je suis plus proche, donc je devrais mieux ranker » décrit mal le fonctionnement réel du système.
Maps et le Web sont reliés par les entités
La connexion entre Maps et le Web classique est probablement l'un des enseignements les plus importants du corpus.
Les Features de Geostore peuvent être reliées au Knowledge Graph à travers un MID. Du côté du Web, des documents peuvent eux aussi être associés à des MID.
Google dispose notamment d’une couche appelée Webref qui associe des documents à des entités et conserve des informations telles que la topicality, la confidence, des données géographiques et différents scores au niveau du document.
La relation existe également au niveau du ranking des documents.
Les structures récupérées décrivent notamment un signal permettant d'établir un ranking relatif entre plusieurs documents associés à la même entité, ainsi que des propriétés indiquant si un document est par exemple une page auteur, une page publisher ou une reference page.
Cela change la manière de penser une page magasin ou un store locator.
Son rôle ne consiste potentiellement pas seulement à ranker sur une query comme « magasin chaussures Paris ». Cette page peut devenir une evidence à propos de l’entité elle-même.
L’objectif devient donc en partie de permettre à Google de déterminer clairement :
- quelle entité le document décrit
- quelle part du document concerne réellement cette entité
- avec quel niveau de confidence cette association peut être faite
- si le document constitue une bonne reference pour l’entité
Le Web et le local sont beaucoup moins séparés dans l’infrastructure de Google que ne le laissent penser leurs interfaces respectives.
Google comprend des concepts, pas seulement des catégories
La couche sémantique va beaucoup plus loin que la primary category visible sur un Business Profile. Google utilise notamment des GConcepts, un vocabulaire partagé qui peut représenter des établissements, des plats, des attributs, des cuisines, des modes de service et de nombreux autres concepts.
Nous avons suivi une simple query
ramendans plusieurs parties du système. Les résultats n’appartiennent pas tous à une seule catégorie. Google peut relier la query à des ramen restaurants, des restaurants japonais, des restaurants asiatiques et d’autres concepts associés.À l’intérieur des listings, la représentation va encore plus loin. Des review topics, des plats de menus et d’autres attributs peuvent être représentés comme des entités structurées plutôt que comme de simples chaînes de caractères. Pour un système d’IA, cette architecture est particulièrement utile.
Google n’a pas nécessairement besoin de relire des milliers de reviews à chaque fois qu’un utilisateur demande si un restaurant sert de bons ramen ou s'il faut généralement attendre longtemps.
Une partie de cette information peut déjà exister sous forme de thèmes, d’entités et de signaux structurés associés au lieu. Cette compréhension sémantique était déjà utile pour la recherche locale traditionnelle. Elle devient beaucoup plus importante lorsque l’interface doit répondre à des questions complexes.
Une partie de l’intelligence géographique de Google se trouve sur le téléphone
Tout n’est pas calculé sur les serveurs de Google. Nous avons retrouvé des structures on-device associées aux visites, aux place candidates, aux frequent places, aux trips, au domicile, au lieu de travail, aux patterns de mobilité et aux user location profiles.
Un objet particulièrement intéressant est
ChainAffinity, qui suggère que le système peut modéliser l’affinité d’un utilisateur envers une chaîne retail récurrente. À cela s’ajoute le scorer offline mentionné précédemment.Le niveau d’evidence n’est pas identique pour tous les composants. Certaines structures sont explicitement nommées dans les schemas récupérés, tandis que certaines parties de la couche persona doivent être reconstruites à partir de structures compilées.
Mais l’architecture générale est claire : le téléphone lui-même participe à la construction du contexte géographique de l’utilisateur. La personnalisation de Maps peut donc combiner une connaissance server-side du monde avec une représentation locale de la géographie propre à l’utilisateur.
Être bien classé ne signifie pas forcément être visible sur la carte
Les search results ne sont qu'un des outputs de Maps.
La carte visuelle doit résoudre un autre problème : des milliers d’entités potentiellement pertinentes ne peuvent pas toutes avoir un label affiché simultanément.
Une partie de cette logique appartient à Mapcore. Nous avons récupéré 50 998 styles Mapcore et 12 936 label styles.
La visibilité d’un label peut notamment varier selon le niveau de zoom et d’autres conditions de rendering. Un établissement peut donc être éligible, voire bien classé, sans que son nom soit réellement affiché sur la carte.
Le ranking et la visibilité cartographique sont deux problèmes différents. Cette distinction est particulièrement importante lorsqu’on mesure la « visibilité Maps » à partir de screenshots ou de map grids. La surface visuelle contient encore une décision de rendering après les étapes de retrieval et de ranking.
Et maintenant, Google place Gemini au-dessus de tout cela
Le timing de cette découverte est particulièrement intéressant.
Google développe rapidement Ask Maps et d’autres expériences basées sur l’IA, mais une grande partie de l’infrastructure nécessaire pour répondre à des questions complexes existait déjà.
Le système dispose déjà de :
- canonical place entities
- concepts et attributs sémantiques
- reviews et topics extraits
- relations avec le Knowledge Graph
- Web evidence
- geographic retrieval
- signaux comportementaux
- contexte géographique personnel
- systèmes de ranking
- mécanismes de composition du listing
Gemini ajoute une interface conversationnelle au-dessus de ces différentes couches. Cela change profondément ce que peut être une query locale.
« Best ramen near me » reste relativement simple. « Où est-ce que six personnes peuvent dîner près de mon hôtel ce soir, avec une personne végétarienne, peu d’attente et de bons avis récents sur le service ? » nécessite une représentation beaucoup plus riche du lieu.
Google doit comprendre ce qu’est le restaurant, ce qu’il propose, ses horaires, ce que les utilisateurs en disent, où il se trouve, comment il s’intègre au contexte ou au trajet de l’utilisateur et si les différentes evidences disponibles sont suffisamment fiables pour le recommander.
Maps construit ces briques depuis des années. L'IA donne maintenant à Google une nouvelle manière de les exploiter.
Ce que cela change pour le SEO
La conclusion la plus actionnable de cette recherche n’est pas une nouvelle liste de ranking factors.
Le SEO local s'est historiquement beaucoup concentré sur l’optimisation du Google Business Profile : catégories, reviews, photos, attributs, horaires et autres champs du listing.
Tout cela reste important, mais l’architecture de Google suggère un objectif plus large : améliorer la représentation que Google est capable de construire de l’entité elle-même.
Pour un établissement ou une enseigne retail, les bonnes questions deviennent progressivement :
- Qu’est-ce exactement que ce lieu ?
- Que propose-t-il ?
- À quelle marque ou chaîne appartient-il ?
- À quels concepts et attributs est-il associé ?
- Le site Web décrit-il clairement la même entité ?
- Quels documents Web apportent de l’evidence à son sujet ?
- Google observe-t-il une demande réelle pour cette marque ou cet établissement ?
- Que disent régulièrement les reviews sur les différentes dimensions de l’expérience ?
- Pour quels utilisateurs et dans quels contextes ce lieu peut-il être pertinent ?
- Dans quelles situations Google devrait-il le recommander plutôt qu’un autre ?
La qualité de la réponse que Google peut produire dépend directement de la qualité et de la complétude de cette représentation.
La semantic completeness pourrait devenir le prochain terrain de bataille du SEO local
Proximity, relevance et prominence restent des concepts utiles.
L’IA ajoute une contrainte supplémentaire : le système doit disposer d’assez d’evidence structurée pour pouvoir raisonner sur un lieu. Un restaurant peut avoir un Business Profile parfaitement optimisé et des centaines de reviews tout en étant mal représenté pour une question spécifique si Google n’est pas capable de relier avec suffisamment de confiance les bons attributs, concepts, pages Web et review topics à l’entité.
Pour les grandes enseignes, le problème est encore plus complexe. Google modélise à la fois les chaînes et leurs établissements individuels.
Nous avons observé des magasins d’une même enseigne, situés dans la même zone métropolitaine, associés à des concepts différents alors que le modèle de chaîne contient sa propre structure conceptuelle canonique.
La cohérence ne peut donc pas être considérée comme acquise simplement parce que tous les établissements appartiennent à la même marque.
Pour le multi-location SEO, le travail porte à la fois sur l’entité de marque, chaque entité locale, le site Web, les structured data, les sources tierces, l’UGC et les relations entre toutes ces couches. La surface à optimiser est beaucoup plus large qu’un simple Business Profile.
En conclusion
Les 72 signaux d’Oyster Rank sont fascinants parce qu’ils révèlent certaines catégories d’informations que Google peut utiliser pour évaluer l'importance d’un lieu.
Mais la découverte la plus forte est le système qui les entoure.
- Geostore construit une entité géographique canonique à partir de sources parfois contradictoires.
- Le Knowledge Graph apporte une représentation sémantique.
- Webref relie les documents Web à cette entité.
- Search et Places interprètent la query et génèrent des candidates à l’intérieur d’un espace géographique dynamique.
- Les systèmes on-device ajoutent une partie du contexte personnel de l’utilisateur.
- Mapcore contrôle ce qui atteint réellement la surface visuelle de la carte.
- Ask Maps et Gemini peuvent désormais raisonner en langage naturel au-dessus de cette représentation.
- Le listing Google Maps n’est que la couche visible de cette stack.
Pour les SEO, la question est désormais :
« Quelle représentation Google a-t-il construite de cette entreprise, et cette représentation est-elle suffisamment complète pour que Google puisse la recommander avec confiance ? »
L’étude complète contient l’architecture reconstruite, les expérimentations et les éléments techniques sur lesquels repose notre analyse.
L’archive associée permet également d’explorer les 10 936 déclarations Geostore récupérées et de les confronter à la documentation de 2024 afin d’inspecter directement les schemas, enums, fields, methods et ranking signals.
Toutes les informations à retrouver sur Resoneo !
 Résumé du fonctionnement de Google Maps - Source : RESONEO
L’article "Dans les coulisses de Google Maps : 72 signaux de ranking et l’architecture derrière la recherche locale" a été publié sur le site Abondance.
-
Que signifie vraiment le pourcentage de pluie affiché par les applications météo ?
www.numerama.com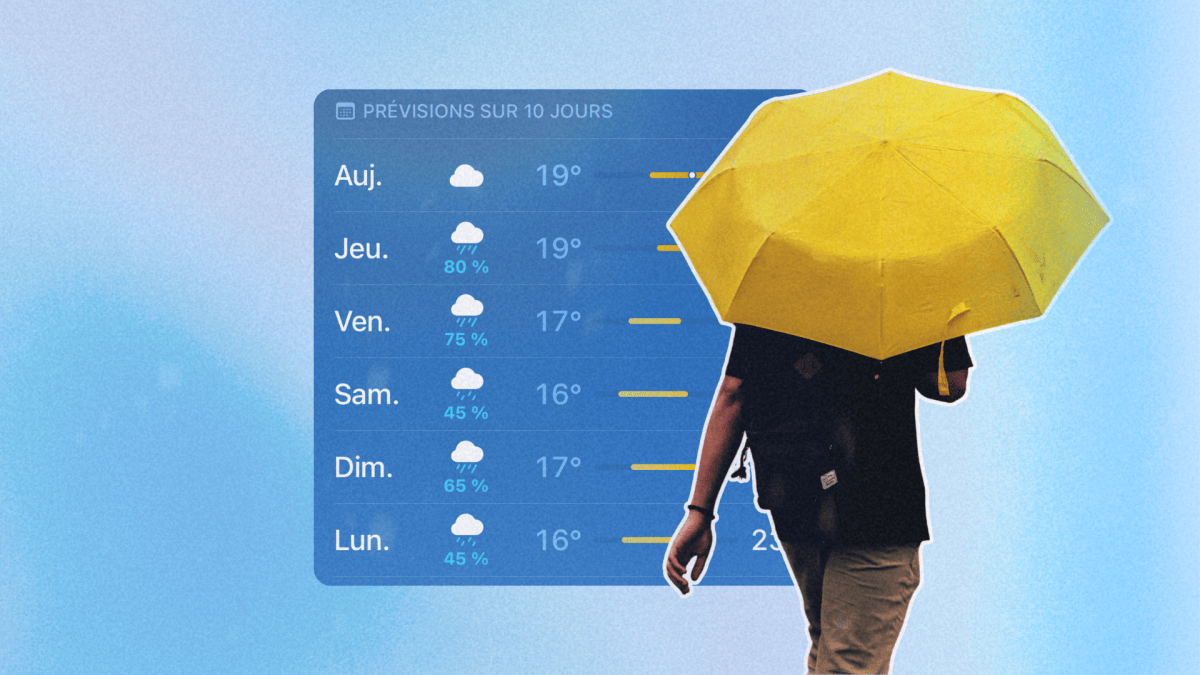
Les applications météo affichent presque toutes un pourcentage à côté de leurs prévisions de pluie. Un chiffre pourtant très souvent mal compris, faute de contexte.
-
Avec les puces M6 et M5 Ultra, Apple transforme ses Mac en machines taillées pour l’IA locale
www.usine-digitale.frCe sera donc le dernier grand coup de Tim Cook, à quelques jours de la passation de pouvoir à John Ternus. Apple a officialisé le renouvellement complet de sa gamme de bureau, porté par deux nouvelles puces, la M6 et la M5 Ultra. Gravure en 2 nm, accélérateurs neuronaux intégrés au GPU, mémoire unifiée à très haut débit et architecture quad-die : Apple muscle considérablement les capacités de calcul local de ses Mac, avec l’IA comme principal argument.
-
Santé, religion, opinions politiques : Claude peut désormais garder vos « sujets sensibles » en mémoire, si vous le souhaitez
www.numerama.com
Anthropic transforme la façon dont Claude gère la mémoire des utilisateurs. Un nouveau système, segmenté par sujets, doit notamment permettre une meilleure interopérabilité entre les différents outils de l'entreprise américaine.
-
DEFENSE: l’Europe veut des champions paneuropéens, chaque État veut le sien
www.frenchweb.frEn 2025, les États membres de l’Union européenne ont consacré 115 milliards d’euros à l’achat d’équipements militaires. La même année, les startups européennes classées dans la défense, la sécurité et la résilience ont levé 8,7 milliards de dollars. Entre ces deux masses d’argent, un troisième chiffre raconte l’essentiel: les achats collaboratifs spécifiquement européens déclarés par …
L’article DEFENSE: l’Europe veut des champions paneuropéens, chaque État veut le sien est apparu en premier sur FW.MEDIA.
-
Cette nouvelle carte gratuite permet de suivre les trains qui circulent en France
www.numerama.com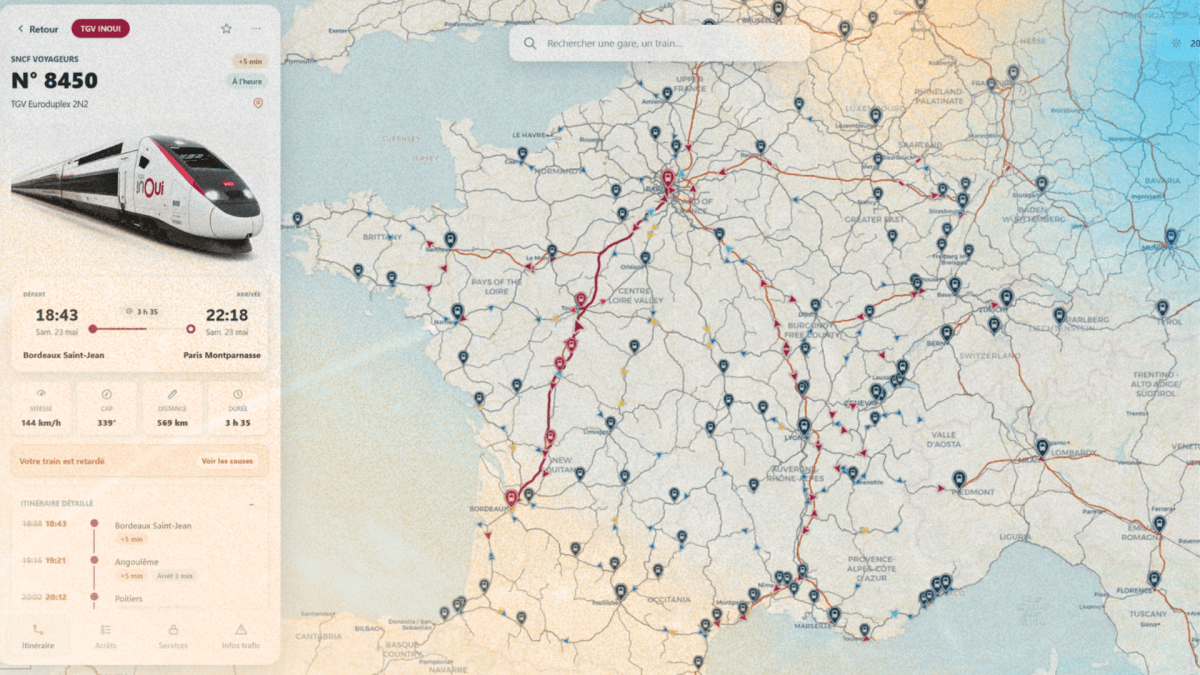
Où se trouve votre train ? À partir de ce 26 août 2026, TrainTracker24 permet de suivre sur une carte les trains de voyageurs qui circulent en France, en Espagne et en Belgique. Leur position ne sera toutefois pas transmise par GPS, mais estimée à partir des données des opérateurs. Est-ce efficace ?
-
Après l’annonce des Pixel 11, le Google Pixel 10a perd 200 € et devient enfin une bonne affaire
www.numerama.com
[Deal du jour] Les Pixel 11 viennent d’être dévoilés, mais leur arrivée rend surtout le Pixel 10a beaucoup plus intéressant.
-
ARCSPACE lève plus de 2 millions d’euros pour faire passer les satellites du jetable au réparable
www.frenchweb.frLa startup parisienne ARCSPACE vient d’annoncer avoir levé plus de 2 millions d’euros pour qualifier en vol une technologie de soudage et de découpe par faisceau d’électrons destinée aux opérations en orbite. Son ambition est d’intervenir sur des satellites qui n’ont jamais été conçus pour être entretenus. Derrière cette prouesse technique se dessine un marché …
L’article ARCSPACE lève plus de 2 millions d’euros pour faire passer les satellites du jetable au réparable est apparu en premier sur FW.MEDIA.
-
Ceuta : dernier kilomètre du renseignement
incyber.orgLes 30 et 31 juillet, environ 70 000 personnes ont tenté d’entrer dans l’enclave espagnole de Ceuta depuis le Maroc, lors de l’un des plus importants épisodes de franchissements massifs de frontière qu’ait connus l’Espagne ces dernières années. Cette mobilisation avait été précédée, pendant plusieurs semaines, d’appels à franchir la frontière et d’échanges sur les réseaux sociaux et les plateformes de messagerie.
Une question s’est rapidement posée : ces signaux avaient-ils été détectés à temps par les services de renseignement espagnols et, surtout, avaient-ils été traduits en décision ?
L’Espagne débat actuellement de la question de savoir si ses services de renseignement ont alerté le gouvernement avant que des dizaines de milliers de personnes n’entrent dans l’enclave espagnole de Ceuta le 30 juillet.
Le gouvernement reconnaît qu’il disposait d’informations faisant état d’une hausse saisonnière des arrivées. Il affirme qu’aucun rapport de renseignement n’avait anticipé un événement d’une telle ampleur. Le ministre de l’Intérieur, Fernando Grande-Marlaska, a déclaré qu’aucun service de renseignement n’avait signalé « une circonstance de cette nature » (RTVE).Des sources attribuées à la communauté espagnole du renseignement présentent une autre version. Selon ces témoignages, le Centre national de renseignement aurait adressé plusieurs alertes au ministère de l’Intérieur. D’autres articles affirment que le principal groupe de discussion encourageant le franchissement de la frontière avait été identifié huit jours avant les événements (Cadena SER, La Razón).
 Localisation Ceuta
Ces récits reposent sur des sources anonymes. La juridiction nationale espagnole a désormais demandé à la Guardia Civil d’établir si certaines de ses unités à Ceuta avaient reçu des informations susceptibles de constituer une alerte préalable (Demócrata).
L’enquête devra déterminer ce qui était connu, à quel moment, et où ces informations ont circulé. Pour l’ensemble de la communauté de la sécurité, Ceuta met déjà en lumière un problème plus profond. Les organisations de sécurité sont devenues très performantes dans la collecte de signaux. Elles restent beaucoup moins constantes lorsqu’il s’agit de décider ce que ces signaux exigent de faire.
Ce qui était visible avant Ceuta
L’activité numérique qui a précédé le 30 juillet s’est développée publiquement pendant plusieurs semaines. Des rumeurs concernant une décision de la Cour suprême espagnole ont circulé sur Facebook, Instagram, TikTok, WhatsApp et Telegram. Cette décision a été présentée comme une ouverture de la frontière. Des comptes ont partagé des exemples de franchissements réussis, des itinéraires et des instructions pratiques.
Une campagne en ligne liée à Ceuta aurait généré environ 11 millions de vues depuis le début du mois de juillet (AFP). Une vidéo Instagram montrant un itinéraire entre Fnideq et Ceuta a atteint 1,4 million de vues dans les jours précédant le franchissement. D’autres comptes orientaient leurs abonnés vers des groupes WhatsApp où les trajets étaient discutés et coordonnés (CBC).
Les données publiques montraient également une pression physique croissante. Au 15 juillet, le ministère espagnol de l’Intérieur avait enregistré 2 826 entrées irrégulières à Ceuta depuis le début de l’année 2026, soit une hausse de 146 % par rapport à l’année précédente (Antena 3).
Pris ensemble, ces éléments soulevaient une question de renseignement bien avant que l’ampleur et le calendrier de l’événement puissent être établis.
Les signaux n’étaient-ils que les fragments d’un schéma saisonnier habituel ? Ou étaient-ils en train de devenir quelque chose de qualitativement différent ? C’est à ce moment que la collecte s’arrête et que commence l’analyse.De la détection à l’analyse
Les discussions sur la sécurité ont souvent tendance à considérer l’alerte comme une situation binaire. Une organisation a été alertée. Ou elle a été prise par surprise. Le véritable travail de renseignement se situe entre ces deux situations.
Le premier signal est généralement ambigu. Sa source peut être inconnue. Sa portée peut être mesurable alors que son effet reste incertain. De larges audiences ne se mobilisent pas toujours, tandis que de petits groupes peuvent provoquer de graves perturbations.
Le renseignement doit répondre à plusieurs questions :
- L’information est-elle crédible ?
- L’activité observée révèle-t-elle une capacité, une intention, ou les deux ?
- Quelles personnes, quels lieux ou quelles opérations pourraient être affectés ?
- À quelle vitesse la situation pourrait-elle évoluer ?
- Quel niveau de confiance peut-on accorder à l’analyse ?
- Quelles mesures de précaution seraient proportionnées ?
Une alerte qui indique que « quelque chose pourrait se produire » transfère l’incertitude à son destinataire. Une analyse de renseignement structure cette incertitude en décrivant le changement observable, les conséquences plausibles, le niveau de confiance et le temps restant pour agir.
Cette distinction est importante dans tous les domaines de la sécurité. Un SOC peut détecter une activité anormale avant que la nature d’une intrusion ne soit clairement établie. Un gouvernement peut identifier une mobilisation sans savoir combien de personnes y répondront.
Attendre la certitude revient à résoudre le problème analytique en laissant l’événement le résoudre à notre place.
Le dernier kilomètre
Une évaluation de renseignement doit parvenir à quelqu’un qui en comprend les conséquences, dispose de l’autorité nécessaire pour agir et peut mobiliser les ressources requises à temps. C’est le dernier kilomètre du renseignement : le point de rencontre entre la collecte, l’analyse et le management.
Au sein d’un gouvernement, ce chemin peut passer par les services de renseignement, les chaînes de commandement de la police, les autorités frontalières, les ministères, les administrations régionales et les responsables politiques. Dans une entreprise opérant une infrastructure critique, il peut passer par le SOC, la sûreté de l’entreprise, la direction des sites, la continuité d’activité, la communication et le comité exécutif.
 Ceuta, carrefour maritime et numérique
Chaque acteur appréhende la situation selon un mandat différent. Le SOC cherche à savoir si les systèmes sont affectés. La sûreté de l’entreprise s’interroge sur l’exposition des personnes et des sites. Les opérations évaluent la continuité d’activité, la communication suit le récit qui se construit, et la direction décide si une intervention est justifiée.
La menace continue d’évoluer pendant que l’organisation traduit la situation entre ces différentes perspectives.
Ceuta illustre le problème de gouvernance qui en résulte. Des signaux existaient, l’augmentation des arrivées était mesurable et des alertes des services de renseignement ont peut-être circulé. Leur contenu et leurs destinataires restent contestés, tandis que l’ampleur finale a dépassé l’évaluation reconnue par le gouvernement.
Les questions décisives sont donc organisationnelles :
- Qui était responsable de la vision d’ensemble ?
- Qui pouvait modifier le niveau de préparation ?
- Quel seuil aurait justifié un renforcement des moyens ?
- Quel niveau d’incertitude le décideur était-il censé accepter ?
Ces questions doivent faire partie d’un retour d’expérience au même titre que la qualité de la collecte et de l’analyse.
Décider sans certitude
Les responsables de la sécurité reçoivent rarement une alerte complète. L’attribution peut rester incertaine, le calendrier imprécis et l’ampleur projetée exprimée sous la forme d’une fourchette. La décision doit malgré tout être prise.
Une réponse pragmatique peut reposer sur quatre critères :
Probabilité. Dans quelle mesure l’évolution envisagée est-elle crédible, et quels indicateurs observables étayent cette évaluation ?
Impact. Quelles pourraient être les conséquences pour les personnes, les services essentiels, les sites, les chaînes d’approvisionnement ou l’ordre public ?
Délai. Combien de temps faut-il pour mettre en place une préparation efficace ?
Réversibilité. Quel serait le coût d’activation d’une mesure, puis de sa levée ?
Une intervention très perturbatrice et irréversible exige des éléments probants solides. Augmenter les effectifs, informer les responsables locaux ou placer des équipes d’intervention en alerte coûte moins cher et peut être rapidement annulé. De telles mesures peuvent être justifiées plus tôt lorsque les conséquences potentielles sont graves. L’objectif est de permettre une préparation rigoureuse dans un contexte d’incertitude.
Les équipes de cybersécurité travaillent déjà de cette manière. Les plans de réponse aux incidents définissent des niveaux d’escalade alors même que la nature d’une intrusion reste incertaine. Le threat hunting commence par des hypothèses qui sont ensuite confrontées aux éléments émergents. La même logique peut guider les décisions face à des menaces visant le monde physique mais observables dans l’espace numérique.
Ce qui a changé le 15 août
Une seconde mobilisation autour de Ceuta a offert un point de comparaison utile.
Des publications ont présenté le 15 août comme une nouvelle occasion de franchir la frontière vers l’enclave espagnole. Cette fois, la Guardia Civil a produit une évaluation de six pages fondée sur des informations accessibles au public. Elle décrivait un appel actif diffusé en ligne et présentant un potentiel de mobilisation, tout en précisant clairement que sa mise à exécution, son ampleur et ses auteurs restaient à confirmer (Spain in English).
L’évaluation conservait l’incertitude tout en fournissant aux décideurs une base structurée pour se préparer.
Les autorités espagnoles et marocaines ont renforcé leur présence. Des milliers de policiers ont été déployés des deux côtés de la frontière. Des centaines de personnes se sont présentées et les autorités marocaines auraient procédé à près de 300 interpellations (CBC).
De nombreuses variables peuvent expliquer cette différence de résultat. La séquence opérationnelle reste néanmoins instructive :
- Signal.
- Évaluation.
- Décision.
- Préparation.
C’est ainsi que le dernier kilomètre est censé fonctionner.
Une vision partagée du renseignement
Ceuta montre également pourquoi la frontière entre cybersécurité et sûreté de l’entreprise est de moins en moins pertinente lorsqu’il s’agit de renseignement.
Des signaux numériques ont eu des conséquences sur les personnes, les services publics, les transports et les infrastructures physiques.
Les équipes de cybersécurité ont développé des capacités utiles sur l’ensemble de cette chaîne : collecte continue, analyse comportementale, détection des anomalies, threat hunting, corrélation et procédures d’escalade structurées.
La sûreté de l’entreprise apporte le contexte nécessaire pour traduire ces signaux en conséquences physiques : sites exposés, présence de salariés, itinéraires critiques, acteurs locaux, dépendances opérationnelles et mesures de protection disponibles.
Ces fonctions peuvent conserver des responsabilités distinctes tout en contribuant à une vision partagée du renseignement.
Pour les opérateurs d’infrastructures critiques, cette nécessité est particulièrement claire. Les sites énergétiques, les ports, les plateformes de transport, les infrastructures de télécommunications, les hôpitaux et les centres de données ne dépendent pas uniquement de l’intégrité de leurs systèmes techniques. Ils dépendent également de l’accès physique, des personnels, de la logistique et du bon fonctionnement de leur environnement opérationnel.
Une campagne organisée dans l’espace numérique peut affecter ces quatre dimensions.
La collecte multilingue et multiplateforme doit faire partie de cette vision commune, tout comme la capacité à corréler des évolutions externes avec les personnes, les sites, les fournisseurs et les itinéraires propres à une organisation. Les systèmes d’IA automatisés et agentiques peuvent contribuer à effectuer ces corrélations à grande échelle ; la responsabilité de l’interprétation et des décisions ayant des conséquences reste humaine.
La question du management
La juridiction nationale espagnole pourra peut-être déterminer si des unités à Ceuta ont reçu des alertes et comment celles-ci ont été traitées. Mais la leçon durable dépasse déjà ce débat.
La performance en matière de sécurité ne peut pas être mesurée uniquement à l’aune de la collecte d’un signal ou de l’émission d’une alerte. Elle dépend également de la capacité à structurer l’incertitude, à définir clairement les responsabilités et à préserver la possibilité d’une action proportionnée.
La cybersécurité a consacré des années à améliorer la vitesse de détection. Le prochain défi consiste à réduire la distance entre la détection et la décision. C’est dans cet intervalle que les menaces émergentes gagnent du temps. C’est aussi là que la valeur du leadership en matière de sécurité se démontre.
Manuel Bohé est fondateur et CEO de Concepture Group, l’un des principaux cabinets allemands de conseil en sécurité, implanté à Cologne, Hambourg, Baden-Baden et Houston, aux États-Unis. Il est également chercheur en sécurité auprès de l’Association fédérale allemande pour la protection des infrastructures critiques (BSKI) et membre permanent de la Commission fédérale pour la cybersécurité du Conseil économique de la CDU.
The post <strong>Ceuta</strong> : dernier kilomètre du renseignement appeared first on INCYBER NEWS.
-
Le rapport d’activité annuel 2025 de la Cnil
www.lexing.law
Le rapport annuel 2025 de la Cnil, publié en mai 2026, confirme l’évolution profonde des missions de l’autorité.
Si la protection des données personnelles demeure au cœur de son action, l’année 2025 marque également une étape importante avec la montée en puissance de la régulation de l’intelligence artificielle, le renforcement de la coopération entre régulateurs et une activité toujours soutenue en matière de contrôle et de sanction.
Une année « charnière » pour la Cnil
Le rapport annuel 2025 de la Cnil met en avant une transformation du rôle de l’autorité désormais appelée à intervenir bien au-delà du seul cadre du RGPD.
La présidente de l’autorité, Marie-Laure Denis, qualifie ainsi 2025 d’« année charnière », en raison des nouvelles compétences confiées à la Cnil dans le cadre du règlement européen sur l’intelligence artificielle (RIA). Celle-ci sera progressivement chargée non seulement de contrôler le respect du RGPD dans les traitements reposant sur l’IA, mais également d’exercer des missions de protection des droits fondamentaux et, pour certains systèmes d’IA à haut risque, de surveillance du marché.
Cette évolution s’inscrit dans un contexte plus large d’élargissement des compétences de la Cnil résultant de plusieurs textes européens, parmi lesquels le règlement sur les services numériques (DSA), le règlement sur la gouvernance des données (DGA) ou encore le règlement relatif à la transparence de la publicité politique. Le rapport souligne que cette multiplication des textes conduit l’autorité à développer une logique d’« interrégulation », en renforçant sa coopération avec d’autres autorités nationales telles que l’Arcom, l’Arcep ou la DGCCRF.
Rapport annuel 2025 de la Cnil : une activité de contrôle toujours soutenue
Comme les années précédentes, le rapport annuel 2025 de la Cnil illustre l’intensité de l’activité opérationnelle de l’autorité.
Au cours de l’année, la Cnil a reçu 20 150 plaintes, réalisé 323 contrôles et prononcé 83 sanctions, pour un montant total de 486,8 millions d’euros d’amendes. Elle a également enregistré 6 167 notifications de violations de données personnelles, soit un niveau qualifié d’« exceptionnel » par l’autorité.
Au-delà de ces chiffres, le rapport met en évidence une tendance de fond : la montée en puissance des violations de données, souvent massives et impliquant des prestataires, conduit la Cnil à renforcer ses exigences en matière de cybersécurité. L’autorité annonce ainsi des contrôles ciblés en 2026, notamment sur la sécurisation des accès aux grandes bases de données
L’accompagnement des acteurs demeure une priorité
Le rapport annuel 2025 de la Cnil confirme également que sa stratégie ne repose pas uniquement sur le contrôle.
En 2025, l’autorité a poursuivi la publication de nombreux outils destinés à faciliter la mise en conformité des organismes : recommandations relatives aux enquêtes de diversité, guide sur les analyses d’impact des transferts de données, outil d’auto-évaluation des cookies de mesure d’audience, précisions sur la qualification de responsable de traitement ou de sous-traitant, ou encore étude consacrée aux bénéfices économiques des délégués à la protection des données (DPO).
Cette politique d’accompagnement s’est également traduite par l’organisation de consultations publiques, de webinaires et par la publication de recommandations consacrées à l’intelligence artificielle, traduisant la volonté de la Cnil de favoriser une conformité « par la pédagogie » avant le recours aux pouvoirs de sanction.
Une régulation appelée à se renforcer
À travers son rapport annuel 2025, l’autorité confirme son évolution vers un régulateur transversal du numérique. Les nouvelles compétences issues des règlements européens, en particulier du règlement sur l’intelligence artificielle, devraient encore accroître son rôle dans les prochaines années.
Pour les organismes publics comme privés, ce rapport rappelle que la conformité ne peut plus être envisagée sous le seul angle du RGPD. Elle suppose désormais d’intégrer les nouvelles réglementations européennes relatives à l’intelligence artificielle, aux services numériques ou encore à la gouvernance des données, dans une approche globale de la gouvernance numérique.
Article coécrit avec Morgane Allouche, avocate, collaboratrice du département Contentieux du numérique du cabinet Lexing.

Virginie Bensoussan-Brulé
AvocateDirectrice du pôle Contentieux du numérique
L’article Le rapport d’activité annuel 2025 de la Cnil est apparu en premier sur Lexing Avocats.