Tech-fr publisher
-
« Les cartes zombies sont de retour en ligne » : comment une faille Visa permet de ressusciter des cartes expirées
www.numerama.com
Trois chercheurs ont démontré qu'une carte bancaire périmée peut, dans certaines conditions, redevenir opérationnelle en paiement sans contact.
-
Claude peut désormais envoyer des mails à votre place, même sans validation
www.numerama.com
Claude peut désormais rédiger, transférer et envoyer des mails directement depuis Gmail, a annoncé Anthropic le 18 août 2026. Une nouvelle étape vers un assistant capable d’agir à votre place, avec une validation humaine activée par défaut.
-
Ligue 1+ : une infime partie des matchs sera proposée en 4K UHD pour la saison 2026/2027
www.numerama.com
La plateforme Ligue 1+ s'apprête à lancer le coup d'envoi de sa deuxième saison. Deux nouveautés cette année : 100 % des matchs chaque week-end, et quelques affiches en 4K UHD.
-
L’Américain Groq lève 350 millions de dollars et se réinvente en cloud d’inférence après son accord avec Nvidia
www.usine-digitale.frGroq veut tourner la page. La start-up américaine vient de boucler une série A de 350 millions de dollars (300 millions d’euros environ). L’opération, menée par la société d’investissement Disruptive, valorise désormais l’entreprise à 3,5 milliards de dollars, contre 6,9 milliards de dollars il y a moins d’un an.
-
Cette grosse promotion sur la Switch 2 tombe juste avant la hausse de septembre
www.numerama.com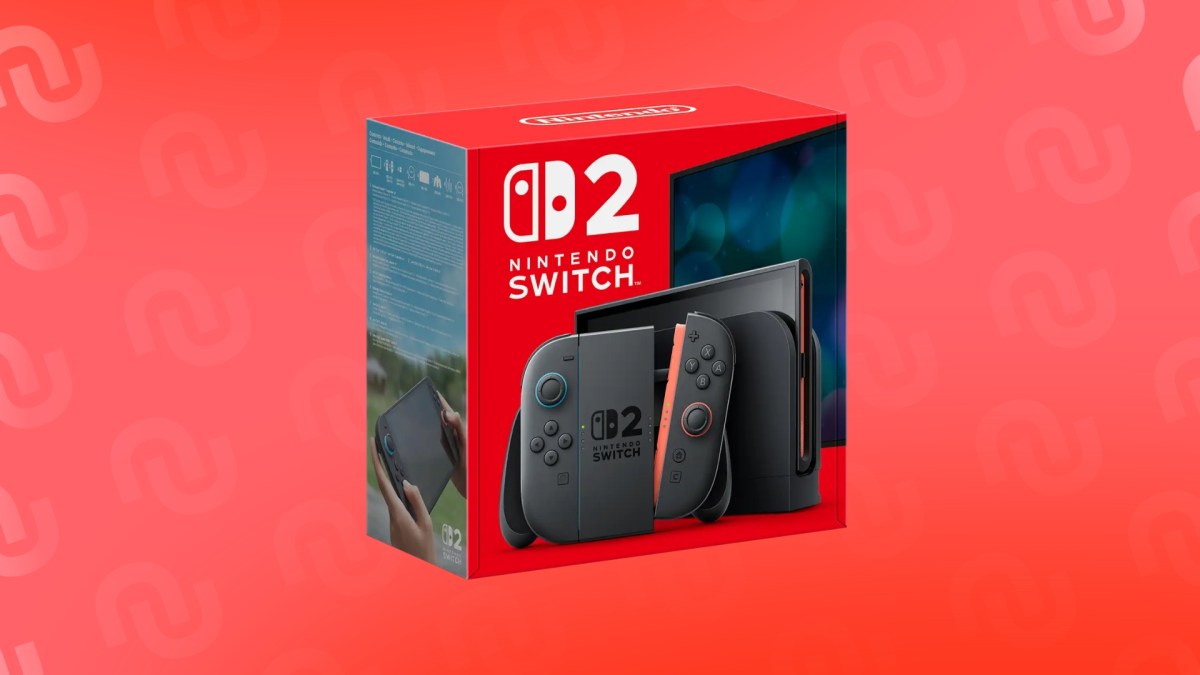
[Deal du jour] Alors que la Nintendo Switch 2 passera de 469,99 € à 499,99 € le 1er septembre 2026, AliExpress fait tomber la console à 374,28 €. Attention toutefois : il s’agit d’une version britannique, parfaitement utilisable en France, mais livrée avec une prise secteur anglaise.
-
OpenAI lance ChatGPT for Teens : une version dédiée aux 13-17 ans censée mieux encadrer les risques liés à l’IA
www.usine-digitale.frOpenAI a dévoilé ChatGPT for Teens, une déclinaison du chatbot pensée pour les 13-17 ans « conçue pour aider les jeunes à apprendre, à développer leur esprit critique, à approfondir leurs connaissances et à utiliser l’IA en toute confiance». La bascule s’opère automatiquement dès que le système estime qu’un utilisateur est mineur, ou si celui-ci déclare se situer dans cette tranche d’âge.
-
300 000 € dorment sur ce site et n’importe quel internaute peut tenter de les gagner
www.numerama.com
N’importe qui peut mettre son ordinateur au travail pour tenter de récupérer les 300 000 € qui dorment sur ce site. La somme est bien réelle, la méthode parfaitement légale et aucune inscription n’est nécessaire. Seul problème : vos chances sont faibles (infiniment faibles).
-
« Nous suspendons certains entraînements de nos modèles d’IA de pointe » : OpenAI met un coup de frein dans la course aux capacités après l’affaire Hugging Face
www.numerama.com
Face à des signaux jugés préoccupants sur les capacités cyber d'Astra, son futur modèle de langage dans l'IA, OpenAI a annoncé le 18 août 2026 la suspension de certains entraînements par apprentissage par renforcement.
-
Étude Ahrefs : un mois après leur lancement en France, les AI Overviews font déjà chuter le CTR de 23 %
www.abondance.comCe qu'il faut retenir :
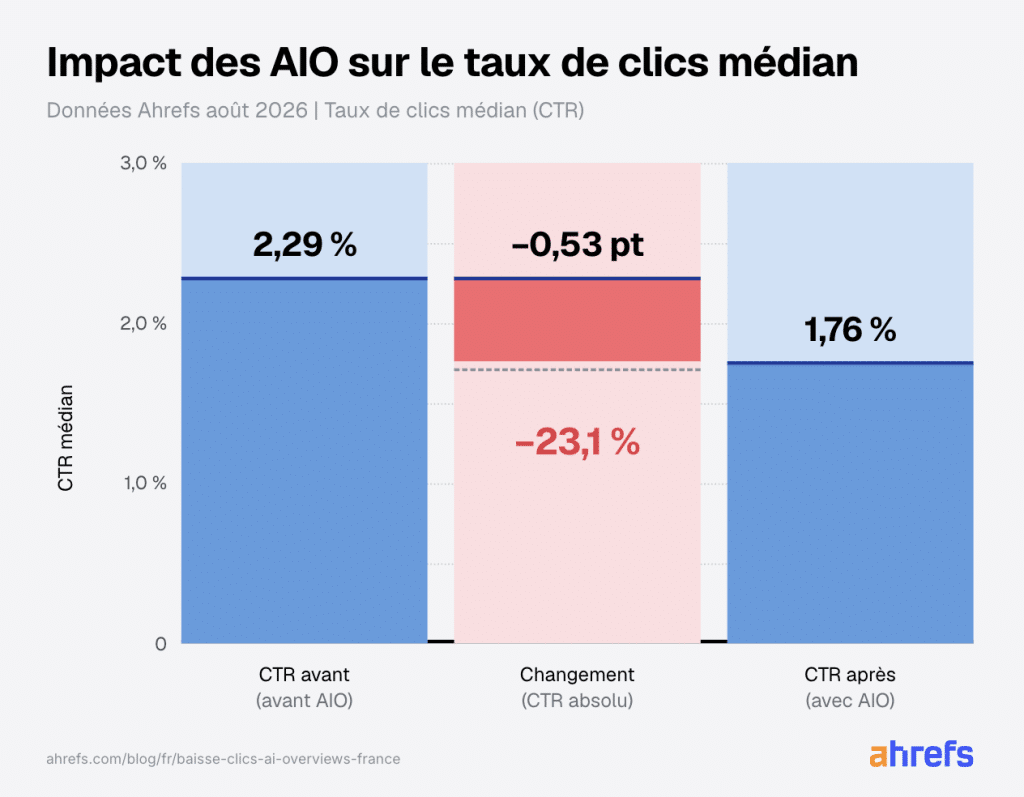
- Les domaines très exposés aux AI Overviews (plus de 20 % de leurs requêtes concernées) perdent 23,1 % de CTR en neuf jours, un chiffre qui monte à −24,8 % une fois neutralisée l'évolution du groupe témoin (+2,3 % sur la même période) 82,2 % des domaines très exposés perdent du CTR
- À la médiane, sur l'ensemble du panel de 963 domaines, la baisse est de 5,7 % de CTR et 8,8 % de clics
- Près de la moitié des domaines du panel (48 %) ont perdu plus de 10 % de leurs clics, et 5 % en ont perdu plus de la moitié
- Les domaines en .fr sont plus touchés (−12,3 % de clics) que la moyenne du panel (−8,8 %)
- La santé est le secteur le plus exposé (taux d'AI Overview de 22,2 %) et le plus touché (−20,4 % de CTR)
- Selon l'étude mondiale d'Ahrefs, la baisse de CTR en position 1 sur les requêtes avec AI Overview est passée de −34,5 % au printemps 2025 à −58 % fin 2025
Ce que montre l'étude
Dans une nouvelle étude publiée hier, Ahrefs a comparé deux populations de domaines pour isoler ce qui relève spécifiquement des AI Overviews d'une simple variation saisonnière.
Les domaines très exposés, c'est-à-dire ceux dont plus de 20 % des requêtes déclenchent un AI Overview, enregistrent une baisse moyenne de CTR de 23,1 % en neuf jours. Sur ce même groupe, 82,2 % des domaines perdent du CTR : à ce niveau d'exposition, s'en sortir est devenu l'exception plutôt que la règle.
Le groupe témoin, composé de domaines dont moins de 2 % des requêtes déclenchent un AI Overview, sert de point de comparaison. Sur la même période, son CTR progresse de 2,3 %. Ahrefs précise que le −23,1 % du groupe très exposé est calculé sans retrait de cette évolution du témoin : une fois cette hausse prise en compte, l'effet réel attribuable aux AI Overviews atteint −24,8 %.
Autrement dit, les domaines très exposés n'ont pas seulement perdu 23 % de CTR, ils ont aussi raté la légère hausse dont le reste du marché a profité sur la même période.
Une relation à peu près linéaire entre exposition et perte de CTR
En comparant la variation du taux de clics au taux d'AI Overview sur l'ensemble des domaines étudiés, Ahrefs obtient une pente de −0,9 : chaque point de taux d'AI Overview supplémentaire coûterait environ un point de CTR.
Ahrefs formule cet ordre de grandeur comme un repère opérationnel, pas comme une prédiction. L'étude précise elle-même qu'une pente n'est pas une prédiction, que certains sites très exposés s'en sortent, et que d'autres, peu exposés, reculent pour des raisons sans rapport avec l'IA.
Les impressions montent, les clics tombent
Selon Ahrefs, il y a eu peu de perte de positions dans les SERP fin juillet. Les pages continuent de s'afficher aussi souvent qu'avant, parfois davantage, mais elles sont moins cliquées. Le cas le plus marqué du panel affiche +183 % d'impressions pour −1,9 % de clics, soit un CTR divisé par plus de trois.
Les chiffres à la médiane sur l'ensemble du panel
Sur l'ensemble des 963 domaines retenus dans l'étude, et non plus seulement sur le groupe très exposé, la médiane du panel affiche une baisse de 5,7 % de CTR et de 8,8 % de clics.
La répartition des pertes de clics sur ce panel est la suivante :
- 48 % des domaines ont perdu plus de 10 % de leurs clics
- 19 % en ont perdu plus de 30 %
- 5 % en ont perdu plus de 50 %
Presque un site sur deux a donc perdu plus de 10 % de ses clics quotidiens, et un sur vingt en a perdu la moitié, en seulement neuf jours.
Ahrefs signale par ailleurs que l'exposition va probablement continuer de progresser : le taux d'AI Overview médian des sites étudiés est aujourd'hui de 5,4 %, et 29 % d'entre eux dépassent déjà 10 %. Ces taux ont augmenté sur tous les marchés depuis 2024, selon l'étude.
Les .fr plus touchés que la moyenne
Les domaines en .fr du panel perdent 12,3 % de clics en médiane, contre 8,8 % pour l'ensemble des sites étudiés. Ahrefs avance une explication : les sites français seraient plus exposés aux AI Overviews que les acteurs internationaux présents sur le marché français.
Le secteur santé, le plus touché
Un secteur se détache nettement dans l'étude : la santé, avec un taux d'AI Overview de 22,2 %, le plus élevé relevé, et une baisse de CTR de 20,4 %.
Ahrefs explique ce résultat par la nature des requêtes santé, majoritairement informationnelles et à réponse courte, c'est-à-dire le type de requête que l'AI Overview absorbe le mieux : la réponse tient dans l'encart et l'utilisateur repart sans avoir besoin de cliquer. Pour Ahrefs, ce qui détermine l'exposition au risque n'est donc pas tant la verticale que l'intention derrière les requêtes : une requête à laquelle un paragraphe suffit est une requête à risque, tandis qu'une requête qui suppose un outil, un compte, un prix, un achat ou un avis humain résiste mieux.
Une trajectoire qui pourrait s'aggraver
L'étude situe ces résultats français dans une trajectoire plus large observée à l'échelle mondiale. Sur cette étude mondiale, l'impact des AI Overviews sur le CTR de la position 1 est passé de −34,5 % au printemps 2025 à −58 % fin 2025. Selon Ahrefs, l'effet ne s'atténue pas avec le temps : il s'accentue, à mesure que l'AI Overview se déclenche sur davantage de requêtes et que les utilisateurs prennent l'habitude de moins cliquer.
Ahrefs indique vouloir relancer cette analyse sur une fenêtre plus longue pour suivre l'évolution du marché français, sans affirmer à ce stade qu'il suivra la même trajectoire que le marché mondial.
Des ordres de grandeur cohérents avec d'autres études
Ahrefs rapproche ses résultats de mesures publiées par d'autres acteurs sur l'effet des AI Overviews sur le CTR organique : une baisse de 49,4 % à 65,2 % relevée par Seer Interactive, une baisse supérieure à 50 % selon Kevin Indig, et une baisse de 47,5 % selon Authoritas.
Méthodologie de l'étude
Ahrefs a suivi les 1 000 domaines générant le plus de clics en France entre avril et juillet 2026, via des données agrégées de Google Search Console. Les domaines dont l'historique ne couvrait pas l'intégralité de la période ont été écartés, ce qui ramène le panel final à 963 domaines.
Pour chaque domaine, Ahrefs a calculé la moyenne quotidienne de clics, d'impressions et de CTR sur les 28 jours précédant le 22 juillet 2026, puis sur les 9 jours suivant cette date.
Ahrefs a également mesuré le taux d'AI Overview de chaque domaine, c'est-à-dire la part de ses requêtes France qui déclenchent un AI Overview. Cette donnée sert à répartir les domaines entre le groupe très exposé (plus de 20 % de requêtes concernées) et le groupe témoin (moins de 2 %), afin d'isoler l'effet propre aux AI Overviews de l'évolution générale du CTR sur la période, saisonnalité de fin juillet comprise.
L'étude précise que le chiffre de −23,1 % de CTR médian pour le groupe très exposé est la variation brute observée, sans retrait de l'évolution du groupe témoin. Sur la même période, le CTR du groupe témoin progresse de 2,3 %. En intégrant cet écart, l'effet réel attribué aux AI Overviews est estimé à −24,8 %.
L’article "Étude Ahrefs : un mois après leur lancement en France, les AI Overviews font déjà chuter le CTR de 23 %" a été publié sur le site Abondance.
-
Apple et la Commission européenne trouvent un compromis sur le DMA : nouvelle grille tarifaire pour l’App Store dès octobre
www.usine-digitale.frApple va modifier les conditions commerciales pour les développeurs distribuant des applications dans l’Union européenne à partir du 1er octobre 2026. Fruit d’une « étroite collaboration » avec la Commission européenne, selon les termes de la société américaine, ce changement doit mettre fin aux désaccords concernant les conditions imposées aux développeurs et la distribution d’applications en dehors de l’App Store.
-
Jamais vu à ce prix, cet immense écran OLED de Samsung remplace deux moniteurs 27 pouces
www.numerama.com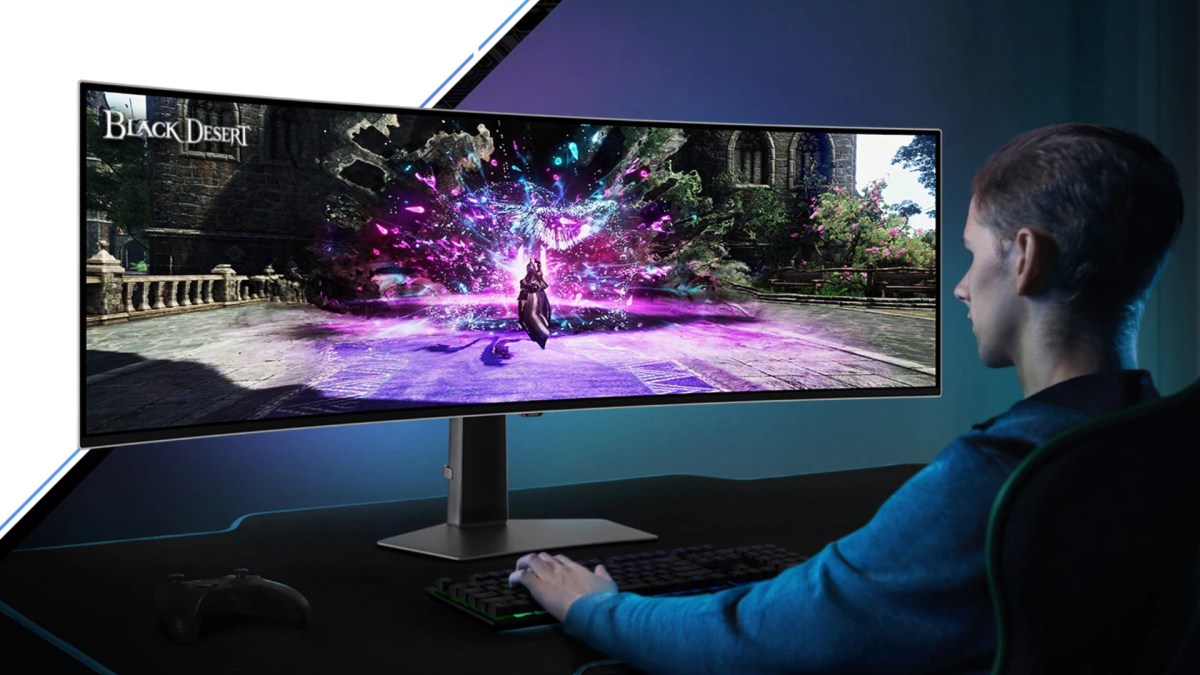
[Deal du jour] Le Samsung Odyssey OLED G9 condense l’équivalent de deux écrans QHD dans une immense dalle OLED de 49 pouces. Ce dernier, habituellement coûteux, est désormais proposé à 669,99 € chez Carrefour, son prix le plus bas à ce jour.
-
Quand personne ne vérifie la date d'expiration de votre CB
korben.infoTrois chercheurs de l'université du Massachusetts à Amherst ont réussi à régler pour 3,19 dollars d'achats dans un supermarché avec une carte bancaire périmée !
Leur secret ?
Glisser une app maison entre la carte et le terminal qui trafique la date d'expiration de la carte.
En fait, leur montage relaie les échanges NFC et modifie au passage un champ que personne ne protège : la date d'expiration lue par le terminal. Leur papier s'appelle Zombie Cards Back Online , et a été présenté à USENIX Security 2026.

La mécanique tient en réalité à une bizarrerie du réseau Visa. Une carte annonce sa date d'expiration à deux endroits différents, et sur le kernel Visa, la date que le terminal consulte pour ses contrôles locaux n'est reliée à aucune signature. La banque, elle, regarde l'autre. Les deux devraient être liées cryptographiquement mais elles ne le sont pas.
Pire, ce kernel transmet à la banque un TVR entièrement à zéro. Le TVR, c'est le champ qui raconte ce que le terminal a vérifié et ce qui a coincé. Rempli de zéros, il ne raconte plus rien, du coup, la banque autorise une transaction sans savoir que les contrôles d'en face ont été contournés.
Reste que la portée est plus étroite que le tour de force le laisse croire. Sur cinq banques américaines testées, une seule a validé l'opération de bout en bout dans des conditions de laboratoire, permettant de payer jusqu'à 500 dollars. Une autre a laissé passer le terminal puis refusé côté banque. De leur côté, les kernels Mastercard, American Express et Discover, eux, ont rejeté les modifications.
Il faut aussi avoir la carte expirée à portée de NFC, et que la banque ait réémis la nouvelle avec le même numéro de compte, ce que les auteurs décrivent comme une pratique d'émetteurs américains.

Bref, c'est pas si simple et tous les essais ont eu lieu aux États-Unis donc rien ne dit non plus ce que ça donnerait sur un terminal français, où le sans contact plafonne de toute façon à 50 euros par paiement, 150 euros cumulés et 5 opérations avant que ça ne réclame le code. Puis de toute façon, le numéro de CB change intégralement à chaque renouvellement de carte, donc bon...
Six ans plus tôt, l'équipe de David Basin publiait The EMV Standard: Break, Fix, Verify , une application Android en relais sur du Visa sans contact, ce qui permettait de payer sans saisir de code. C'est vrai que les failles du paiement sans contact ne datent pas d'hier mais ce qui est neuf ici, c'est cette histoire de faiblesse au niveau de la date d'expiration.
Voilà, comme d'hab, Visa a été prévenu en mai 2025, relancé en décembre mais ni Visa ni les banques n'ont annoncé le moindre correctif pour le moment...
-
Son imprimante HP imprime enfin sur Mac - Merci Claude Code
korben.infoHier, je suis tombé sur ce tweet :

Kuber, un développeur de 19 ans a demandé à Claude Code, de lui pondre un pilote pour sa vieille imprimante pour macOS. Et visiblement, ça a intéressé pas mal de monde puisque le tweet a fait +3 millions de vues.
Il a ensuite publié le dépôt sur Github et la transcription complète de la session. Et ce que ça raconte c'est surtout un bras de fer avec macOS, et un montage bidouillesque au possible qui finit par tenir sur une machine virtuelle Linux et un daemon root.
Pour la petite histoire, son imprimante est une HP Laser 1008a. C'est en réalité une Samsung rebrandée car HP a racheté la division impression de Samsung , il y a une dizaine d'années. Et ces machines parlent un langage un peu niche qui est le SPL3. C'est un langage maison qui n'est ni du PostScript ni du PCL standard. Et comme vous vous en doutez, HP n'a jamais sorti de pilote macOS pour cette gamme. Donc officiellement, cette imprimante ne peut pas imprimer depuis un Mac.
La mission a donc consisté à recompiler SpliX, un pilote libre qui parle le SPL3 et à se battre avec macOS pour qu'il puisse causer via l'interface USB de l'imprimante déclarée en IPP-over-USB. Il a fallu ensuite ruser en mettant en place une VM Linux afin de faire tourner h24 un codec de HP uniquement dispo sous Linux. Et voilà ! La file d'impression envoie le travail sur un port local, un daemon root le récupère, le fait passer par le codec dans cette VM, et écrit le résultat directement sur l'USB.
Bref, ça marche et ça imprime maintenant depuis n'importe quelle application.

Alors vous l'aurez compris, ce n'est pas vraiment un dev de pilote pour macOS mais plutôt une espèce d'assemblage de différents éléments pour la plupart libres, afin de réussir à imprimer sous macOS avec ce modèle d'imprimante. Mais ce qui est intéressant, c'est que le mainteneur de SpliX a débarqué sur le dépôt de Kuber avec une archive de fichiers de test et une série de questions. Cela veut dire que si lui et Kuber trouvent l'octet qui diffère, la VM Linux et le daemon root vont disparaître et il ne restera plus qu'un paquet tout ce qu'il y a de plus classique à installer.
Voilà c'est finalement la seule partie de l'histoire où on répare vraiment quelque chose. Mais ça reste quand même une belle histoire où l'IA permet de s'affranchir des limites techniques imposées par les fabricants et éditeurs de logiciels. Et ça, moi j'adore !
Source : le fil de Kuber sur X , avec la transcription intégrale de la session et le dépôt du projet .
-
Le CD de Quake était foireux avant même d'être pressé
korben.infoEn mai 1996, sur le forum Usenet consacré à Quake , des joueurs prenaient déjà les paris... Le jeu n'était pas sorti, le CD non plus, et la question qui tournait en boucle à l'époque c'était : combien de temps tiendrait la protection anti-copie du jeu ? Certains misaient deux semaines après la sortie, d'autres 5 jours maximum...

De son côté, id Software s'apprêtait à presser son shareware sur un disque mais Quake n'occupait que 22 Mo des 640 disponibles. Du gâchis de place ? Pas vraiment puisque le reste du CD a été rempli avec tout le catalogue maison. Des jeux complets en versions chiffrées, c'est-à-dire plusieurs DOOM, Final Doom, Hexen, Heretic qu'on déverrouillait par téléphone...

Le CD est finalement sorti le 30 août 1996 et le concept était bien pensé, sur le papier en tout cas... Le programme affichait un nombre de onze chiffres, les Américains appelaient le 1-800-ID-GAMES, un opérateur encaissait la thune et donnait en échange un numéro de déverrouillage à retaper. Le premier nombre changeait à chaque lancement et tournait toutes les 5 minutes, précisément pour qu'un code ne puisse pas servir deux fois.
Mais le 8 octobre suivant, coup de tonnerre ! Le groupe GNOMON sortait QCRACK.EXE pour faire tout sauter ! Ça n'aura pris que 39 jours !

Ce qu'ils avaient compris, c'est que le numéro donné au téléphone ne contenait aucun secret. Il attestait simplement du paiement et de rien d'autre. Le programme livré sur le CD savait fabriquer ce numéro tout seul à partir de celui qu'il venait lui-même d'afficher, et son seul travail consistait donc à comparer les deux.
Toute la protection tenait, comme souvent, dans le fait que personne n'était censé regarder comment ça fonctionnait.

Toutefois, ce mécanisme de vente n'était pas vraiment une bourde d'id Software. Eux n'étaient que les clients de TestDrive Corp, qui vendait cette solution brevetée .
Et ce brevet expliquait très précieusement comment ça fonctionnait... Le poste de l'utilisateur produit un numéro, l'opérateur distant le valide et renvoie un code d'activation, et c'est le poste de l'utilisateur qui vérifie ce code. Le brevet va même jusqu'à donner son exemple, à savoir un numéro dont les chiffres totalisent 10, et un code de retour dont les chiffres totalisent 15.

La faille était donc déposée à l'office des brevets quatre ans avant que le CD arrive en rayon.
Le reste raconte quand même une fin de production difficile. La base qui associe chaque jeu à son identifiant contenait également une faute de casse sur Final Doom, "Final" au lieu de "final", ce qui envoyait la génération du code chercher le mauvais fichier. Résultat, le client qui appelait et payait pour Final Doom n'arrivait pas à le déverrouiller.
Alors que le pirate, lui, y arrivait à tous les coups !
Et si je vous raconte tout ça c'est surtout parce que Fabien Sanglard s'est amusé à redémonter le CD-Rom cet été , et qu'il y a aussi trouvé de jolies surprises comme une version en clair de cette base posée juste à côté de sa version chiffrée + des fichiers temporaires et des sauvegardes d'éditeur oubliés au pressage.
Je vous invite vraiment à lire son analyse, c'est super intéressant !
Source : PC Gamer
-
L’édition d’août 2026 de Réacteur est en ligne !
www.abondance.comAu programme de cette édition Réacteur d'août 2026 :
- Comment déployer un agent de données dans Data Studio ? [Partie 1], par Chloé Nieuwjaer
- Reddit en 2026 : le canal marketing que la France n'a pas encore découvert pour le SEO, par César Gaston
- AI Overviews en France : les 3 signaux pour 2027, par Juliette Bègue
- Brave Search, la vraie porte d'entrée pour être cité par Claude, par Raouf Douihech
- Difficulté SEO d'un mot-clé : toutes les méthodes et ce qu'elles valent vraiment [Partie 2], par Alexis Rylko
On remercie chaleureusement nos 5 auteurs pour leur réactivité et surtout la qualité des articles publiés : Chloé, Raouf, Juliette, Alexis et César
En bonus : comme à l’accoutumée, cette nouvelle édition accueille également notre veille de août 2026 et une présentation des outils qui ont retenu notre attention ces dernières semaine !
Et, si ce n’est pas encore le cas, abonnez-vous !
Comment déployer un agent de données dans Data Studio ? [Partie 1]
Par Chloé Nieuwjaer, Consultante SEO Senior, Data Analyste & Formatrice Freelance
À découvrir dans cette première partie :
- Le Conversational Analytics, ce nouveau chat intégré à Data Studio qui permet d'interroger ses données stockées dans BigQuery en langage naturel, sans écrire une seule ligne de SQL.
- Ce que contient réellement une réponse de l'agent : pas juste un résultat brut, mais un raisonnement affichable, une contextualisation en langage naturel, une mini-analyse et des suggestions de questions complémentaires.
- Une comparaison concrète et détaillée entre une requête SQL écrite à la main et le raisonnement complet de l'agent pour arriver au même résultat, avec le détail de sa chaîne de pensée sur un cas réel (les villes du département du Nord).
- Un piège de données bien réel révélé au passage : comment une simple requête peut confondre deux villes homonymes situées à l'autre bout de la France.
- Les prérequis techniques à avoir en tête avant de se lancer : compte Google d'entreprise, projet Google Cloud, BigQuery, et les API à activer.
 Ce qu'on a aimé :
Une présentation qui va au-delà du simple mode d'emploi et documente vraiment ce qu'il se passe "sous le capot" : le raisonnement complet de l'agent, en anglais et non retouché, permet de voir précisément comment il interprète le schéma de données, formule ses hypothèses et anticipe les biais avant même d'exécuter sa requête. Chloé Nieuwjaer illustre son propos avec un vrai jeu de données (les mots-clés liés au trail en France), ce qui rend la démonstration concrète plutôt que théorique. On attend avec intérêt la suite, qui promet un tutoriel de configuration complet et un regard critique sur les limites de l'outil.Lire l’article : Comment déployer un agent de données dans Data Studio ? [Partie 1]
Reddit en 2026 : le canal marketing que la France n'a pas encore découvert pour le SEO
Par César Gaston, fondateur de Skilfut
À découvrir dans cet article :
- Les chiffres qui placent Reddit au 4ème rang mondial des sites les plus visités, et pourquoi le marché francophone reste encore largement vierge comparé aux États-Unis.
- Pourquoi la mise à jour Google de 2023, en privilégiant les discussions humaines authentiques face à la prolifération de contenus IA, a fait de Reddit l'un des premiers bénéficiaires sur les requêtes à forte intention d'achat.
- Le rôle central que jouent les threads Reddit dans les réponses des IA génératives, et pourquoi ça change la donne pour les marques présentes sur la plateforme.
- La méthode concrète pour construire un compte crédible sans se faire bannir : karma, cartographie des bons subreddits, et le délai à respecter avant toute action promotionnelle.
- Les pièges qui trahissent instantanément un contenu promotionnel déguisé, et pourquoi un ton "trop soigné" est justement ce qui vous fait repérer par la communauté.
Ce qu'on a aimé :
Un article qui vient d'un vrai praticien du sujet, avec des chiffres concrets tirés de l'expérience terrain de l'agence Skilfut (une communauté de 4 000 membres générant plus de 50 000 impressions hebdomadaires, par exemple). César Gaston ne vend pas Reddit comme une solution miracle mais insiste au contraire sur la patience nécessaire : 4 à 6 semaines minimum de contribution non promotionnelle avant d'espérer être bien reçu. Les pièges détaillés (schémas répétitifs, ton trop parfait, marque citée en ouverture) sont le genre de détails opérationnels qui manquent souvent dans ce type de contenu. Une porte d'entrée utile sur un canal encore largement ignoré par les équipes marketing françaises.Lire l’article : Reddit en 2026 : le canal marketing que la France n'a pas encore découvert pour le SEO
AI Overviews en France : les 3 signaux pour 2027
Par Juliette Bègue, Marketing manager chez Ahrefs France
À découvrir dans cet article :
- Le décalage exact entre la France (20,9% des mots-clés à fort volume) et les États-Unis (44,4%), et pourquoi rien ne suggère que la France plafonnera en dessous du niveau américain.
- Le sens de propagation des Aperçus IA, du bas vers le haut du funnel, avec le calendrier secteur par secteur : la santé déjà saturée, la finance et le voyage manifestement bridés, le B2B et le e-commerce en milieu de gué.
- La preuve chiffrée qu'être bien classé sur Google et être cité dans un Aperçu IA sont deux choses différentes, avec des cas concrets où 38 à 43% des sources citées ne figurent même pas dans le top 10.
- Le chiffrage précis de ce que coûte un Aperçu IA en clics perdus, passé de -34,5% à -58% de CTR en seulement 8 mois aux États-Unis, avec la méthode pour appliquer ce calcul à votre propre trafic.
- Un plan d'action en 5 mouvements pour être cité, et une expérimentation qui invalide au passage une idée reçue très répandue sur le schema markup.
Ce qu'on a aimé :
Un article qui transforme un sujet souvent traité de façon anxiogène en feuille de route concrète, en s'appuyant sur des données Ahrefs solides plutôt que sur des impressions. Juliette Begue ne se contente pas d'annoncer la tendance : elle chiffre le retard français, le calendrier par secteur et même le coût en trafic avec un exemple concret. La partie sur le poids de YouTube dans les citations (20% des liens cités) et sur l'inutilité du schema markup comme levier GEO tranche avec beaucoup de discours ambiants sur le sujet. Du concret, des chiffres, un plan d'action directement actionnable.Lire l’article : AI Overviews en France : les 3 signaux pour 2027
Brave Search, la vraie porte d'entrée pour être cité par Claude
Par Raouf Douihech, Consultant SEO & GEO chez DocShipper
À découvrir dans cet article :
- Le test grandeur nature de l'auteur : un site bien classé sur Google et Bing, mais totalement absent de l'index Brave, et invisible aux yeux de Claude jusqu'à une seule manipulation.
- Les preuves qui confirment que Claude s'appuie sur Brave et non sur Google : jusqu'à 79,2% des URLs citées par Claude figurent dans le top 10 de Brave, contre seulement 34% pour Google.
- Un diagnostic reproductible en 2 minutes pour savoir si votre propre site est visible ou non par Claude.
- Les trois portes d'entrée réelles de l'index Brave (query channel, page channel, crawler propre), et pourquoi le formulaire de soumission ne fait en réalité que forcer un re-crawl.
- Les trois crawlers distincts d'Anthropic à connaître, et les deux pièges de configuration qui bloquent silencieusement votre visibilité sans que ça apparaisse nulle part dans votre robots.txt.
Ce qu'on a aimé :
Un article qui part d'un test personnel daté et vérifiable, mais qui ne s'arrête pas à l'anecdote : Raouf Douihech est allé chercher la mécanique complète derrière le résultat, code du Web Discovery Project de Brave à l'appui, et croise deux études indépendantes (Profound et MERJ sur 35 000 citations) pour asseoir sa démonstration. La partie sur les trois crawlers d'Anthropic et les pièges de configuration CDN/pare-feu est le genre de détail opérationnel qui fait souvent défaut ailleurs. Honnête aussi sur ses propres limites, avec la nuance apportée sur TurboPuffer, second sous-traitant apparu depuis mai 2026, dont le rôle exact reste flou.Lire l'article : Brave Search, la vraie porte d'entrée pour être cité par Claude
Difficulté SEO d'un mot-clé : toutes les méthodes et ce qu'elles valent vraiment [Partie 2]
Par Alexis Rylko, Consultant SEO chez iProspect
À découvrir dans cette seconde partie :
- La méthode des rising stars, pour transformer l'observation d'un concurrent jeune et comparable en véritable règle de sélection de mots-clés.
- La méthode des zones de compétitivité, illustrée par deux cas réels très contrastés : un petit blog e-commerce et un site gouvernemental.
- Pourquoi allintitle, souvent présentée comme une méthode avancée, est en réalité l'une des plus datées, avec un exemple frappant où aucun résultat de la première page ne contient le terme recherché dans son titre.
- Le vrai fonctionnement du KGR (Keyword Golden Ratio), sa formule, ses seuils, et les trois particularités qu'on oublie systématiquement quand on l'applique.
- Deux méthodes complémentaires plus rarement évoquées : les slots par formats dominants et les SERP ouvertes vs verrouillées, avec des exemples concrets sur "prêt immobilier" ou "femme de ménage".
Ce qu'on a aimé :
La suite logique et tout aussi rigoureuse de la première partie, avec le même souci de confronter chaque méthode à des cas réels plutôt qu'à de la théorie. Alexis Rylko ne se contente jamais d'expliquer une méthode : il en pointe systématiquement les limites, ce qui est particulièrement salutaire pour allintitle et le KGR, deux approches qui reviennent régulièrement dans les formations SEO sans qu'on interroge vraiment ce qu'elles mesurent. La conclusion reformule intelligemment la question à se poser : non pas "ce mot-clé est-il difficile", mais "mon site est-il capable de remplacer l'un des résultats en place". Un article de référence à garder sous la main.Lire l’article : Difficulté SEO d'un mot-clé : toutes les méthodes et ce qu'elles valent vraiment [Partie 2]
Comme tous les mois, cette nouvelle édition de Reacteur s’accompagne d’une rubrique dédiée aux derniers outils à tester et les articles qui ont retenus notre attention sur le web !
L’article "L’édition d’août 2026 de Réacteur est en ligne !" a été publié sur le site Abondance.
-
GeForce NOW dans Firefox - 2 000 jeux PC dispo sans rien installer
korben.infoAlors ça c'est cool ! NVIDIA vient d'ajouter Firefox à la liste des navigateurs autorisés à faire tourner GeForce NOW. Un ordi, un onglet, et plus de 2 000 jeux PC se lancent maintenant en streaming sans qu'un seul octet du jeu n'arrive sur votre disque.
C'est tout le concept du service de cloud gaming de NVIDIA avec une machine RTX chez eux, et une image qui arrive chez vous. Comme ça, votre ordinateur ne fait plus que décoder une vidéo sans rien installer ni avoir une grosse carte graphique.
Après GeForce NOW c'est un peu différent de Xbox Cloud puisque ça permet de jouer aux jeux que vous avez acheté. Ce n'est pas un catalogue imposé en accès libre. GeForce NOW se connecte à vos comptes Steam, Epic Games Store, GOG, Xbox PC Game Pass et Ubisoft Connect, puis ouvre la bibliothèque que vous avez déjà payée.

Firefox de son côté garde en plus ses habitudes de navigateur. Comme ça vous pouvez laisser un appel Discord dans le Split View, le walkthrough du jeu dans un autre onglet, et vous basculez en plein écran quand la partie démarre. Plus besoin de basculer sur ce navigateur de faible qu'est Chrome quand l'envie vous prend de jouer ^^.
Mozilla annonce jusqu'à 1440p et jusqu'à 120 images par seconde, et précise que ce plafond est réservé aux abonnés Ultimate. En dessous, le palier Performance donne aussi du 1440p mais s'arrête à 60 fps. Ce qu'Ultimate achète vraiment par contre, c'est la fluidité, l'accès aux machines RTX 5080 et les files d'attente les plus courtes.
L'autre compteur est plus embêtant je trouve puisque les abonnements Performance et Ultimate sont plafonnés à 100 heures de jeu par mois, dont jusqu'à 15 heures non consommées qui peuvent basculer sur le mois suivant. Ça laisse un peu plus de trois heures par jour quand même, mais ce n'est plus vraiment illimité.
Reste un problème, je trouve dans cette annonce : ça ne concerne que Windows uniquement. Firefox sur macOS et sur Linux n'est pas concerné, et personne n'a encore dit si ça viendrait... Snif... Après, les joueurs Linux, eux, ont leur client natif GeForce NOW , enfin sorti de bêta donc ça compense un peu mais quand même...
Pour essayer, mettez Firefox à jour, allez sur play.geforcenow.com et connectez-vous. De son côté, NVIDIA promet d'en dire plus à la Gamescom le 25 août prochain.
Source : blog Mozilla
-
Google Spam Update d’août 2026 : nouvelle mise à jour anti-spam
www.abondance.com
Le spam de nouveau dans le viseur de Google
En juin 2026, Google déployait une Spam Update. La firme de Mountain View nous propose une nouvelle mise à jour similaire pour l'été.
Comme le précise Google dans sa communication : « Aujourd’hui, nous avons publié la mise à jour anti-spam d’août 2026 sur Google Search. Il s’agit d’une mise à jour anti-spam normale, et elle sera déployée dans toutes les langues et lieux. Le déploiement peut prendre quelques jours à être terminé. Plus d’informations sur les mises à jour antispam sont disponibles sur https://lnkd.in/gshkDEU3
Nous mettrons à jour notre page d’historique des sorties de classement à la fin du déploiement : https://lnkd.in/epYqNUQw »
Retrouvez toutes les dernières updates de Google sur notre page dédiée.
Spam Update : la différence avec la Code Update
Les mises à jour anti-spam ciblent spécifiquement les pratiques de spam sur les sites web, comme le contenu généré automatiquement en masse, le contenu de faible qualité ou dupliqué, les redirections trompeuses, et d'autres abus visant à manipuler le classement. Elles ont pour objectif de nettoyer les résultats de recherche des contenus trompeurs ou abusifs en améliorant les systèmes automatisés anti-spam de Google.
Les mises à jour du cœur de l'algorithme (Core Update) sont à la fois plus larges et profondes. Elles permettent de réévaluer la qualité, la pertinence et la satisfaction des contenus affichés dans les résultats de recherche. Contrairement aux spam updates, ces mises à jour ne ciblent pas spécifiquement le spam.
Que faire en cas d'impact d'une Spam Update ?
Pendant la mise à jour : rien. Attendez la fin de la mise à jour avant de faire des analyses et d'identifier les pages ou rubriques touchées. Vous pouvez également réaliser un audit SEO afin de vous aider à corriger les problèmes.
Si vous êtes impacté par une SPAM Update, consultez les règles de Google en matière de spam afin de vous assurer que vous les respectez. Apporter des modifications peut aider votre site à s'améliorer si Google ne détecte plus de spam sur votre site. Néanmoins, dans le cas d'une mise à jour spécifique au spam de liens, apporter des modifications peut ne pas entraîner d'amélioration :
Lorsque nos systèmes suppriment les effets que les liens spammeurs peuvent avoir, tout avantage en termes de classement que ces liens pouvaient générer auparavant pour votre site est perdu. Les avantages potentiels en termes de classement générés par ces liens ne peuvent pas être récupérés.
Si ce concept d'Update est nouveau pour vous ou vous inquiète, on vous conseille ces articles :
- « Ne paniquez pas ! » : comment appréhender les annonces Google ?
- Google Updates : comprendre les mises à jour Google
- Algorithmes Google : Définitions, Historique et Fonctionnement [Guide 2025]
- FAQ : Comprendre et résoudre une action manuelle liée au spam
Rendez-vous dans quelques semaines pour faire le bilan de cette Spam Update !
Pourquoi se tenir informé des updates de Google
Rester informé des dernières évolutions de l'algorithme de Google est nécessaire pour tous les propriétaires de sites. Les core updates peuvent avoir un impact majeur sur le trafic, et anticiper ces changements offre un avantage concurrentiel. On vous explique avec quels outils suivre les mises à jour des algorithmes de Google !
L’article "Google Spam Update d’août 2026 : nouvelle mise à jour anti-spam" a été publié sur le site Abondance.
-
Firefox déploie son IA « Smart Window », mais Mozilla prend d’infinies précautions pour ne fâcher personne
www.numerama.com
Neuf mois après un violent tollé communautaire lié à l'intégration de l'intelligence artificielle dans son navigateur, Mozilla officialise « Smart Window ». Mais cette fois-ci, la fondation a retenu la leçon : le mot d'ordre absolu est le contrôle utilisateur.
-
Apple annonce la fin de deux ans de bras de fer avec l’Europe sur l’App Store
www.numerama.com
Après deux ans de bras de fer, Apple affirme avoir trouvé un compromis avec la Commission européenne sur l’avenir de l’App Store. La taxe par installation disparaît et les paiements alternatifs deviennent plus accessibles, mais l’entreprise continuera de prélever une commission sur les applications distribuées ailleurs.
-
Ce petit robot change d’humeur pendant qu’il recharge votre MacBook (et il tombe à 25 €)
www.numerama.com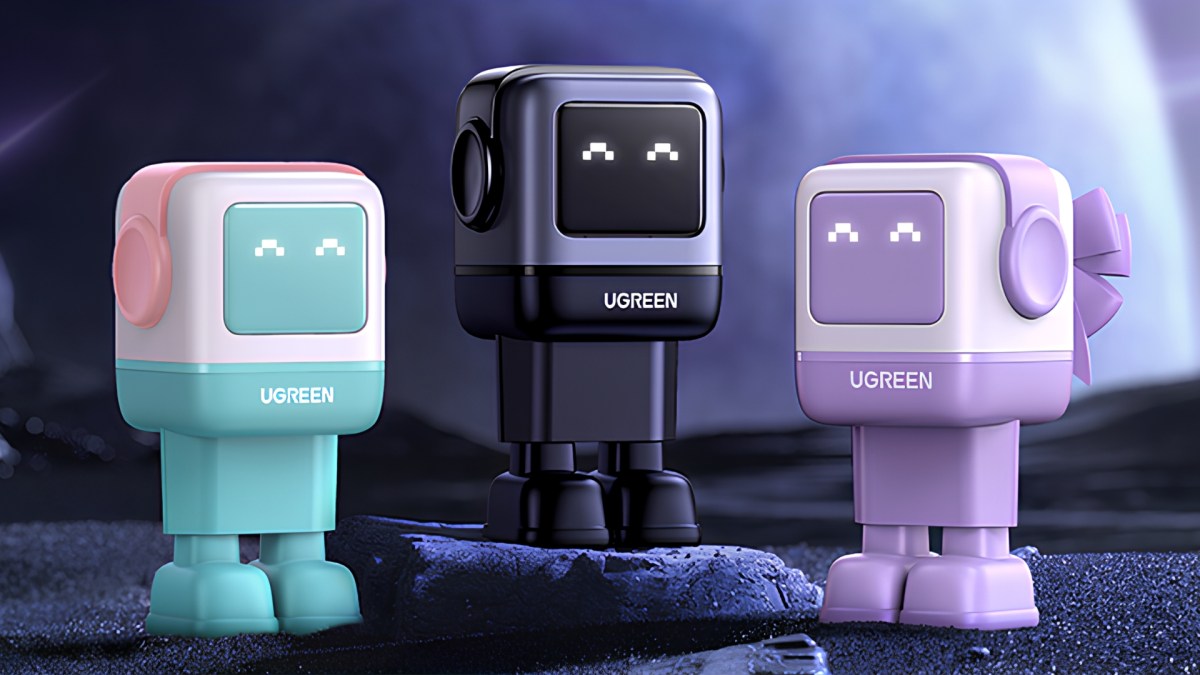
[Deal du jour] Il affiche une nouvelle expression à mesure que la batterie se remplit, mais ce n’est pas qu’un gadget de bureau. Avec ses trois ports et ses 65 W, le chargeur Ugreen Uno peut aussi alimenter un MacBook Air. Il est actuellement affiché à 24,99 € chez PcComponentes.
-
« Tracking » pour les autres, « publicité ciblée » pour Apple : pourquoi le système de consentement de l’iPhone va devoir changer
www.usine-digitale.frApple va devoir revoir en Allemagne certaines de son système « App Tracking Transparency » (ATT), introduit en 2021 pour encadrer le suivi des utilisateurs d’iPhone et d’iPad à des fins publicitaires.
-
Nourrir l’IA avec les cadavres d’entreprises : Google pose 10 millions de dollars pour racheter les mails d’une compagnie aérienne morte
www.numerama.com
Google a déboursé 10 millions de dollars pour racheter les archives internes de Spirit Airlines, une compagnie aérienne en faillite. L'objectif ? Nourrir ses modèles d'IA avec la mémoire numérique d'une entreprise entière.
-
Nvidia garantit jusqu’à 105 milliards de dollars pour le méga data center d’OpenAI dans l’Ohio
www.usine-digitale.frNvidia va apporter jusqu’à 105 milliards de dollars (90 milliards d’euros environ) de garanties financières pour le PORTS-Pike Technology Campus, un futur campus de 8 GW situé dans l’Ohio et développé par SB Energy, filiale du japonais SoftBank, selon l’agence Reuters. Il s’agit de l’un des plus importants projets de data centers dédiés à l’IA jamais annoncé.
-
Réseaux sociaux et mineurs : la décision du Conseil constitutionnel
www.lexing.law
Réseaux sociaux et mineurs : la décision du Conseil constitutionnel trace une feuille de route pour les législateurs européens
A la suite de la censure du dispositif français limitant l’accès des mineurs aux réseaux sociaux, Virginie Bensoussan-Brulé, directrice du pôle Contentieux numérique de Lexing, a été interrogée par MLex sur la portée de cette décision en France et en Europe. Loin d’exclure toute réglementation, le Conseil constitutionnel impose surtout au législateur de construire des mesures ciblées, proportionnées et assorties de garanties suffisantes notamment en matière de vérification de l’âge et de protection des données personnelles.
Dans sa décision n° 2026-911 DC du 14 août 2026, le Conseil constitutionnel ne remet pas en cause la légitimité de l’objectif poursuivi : la protection de l’intérêt supérieur de l’enfant peut parfaitement justifier des restrictions à l’accès des mineurs à certains services numériques.
En revanche, il rappelle une exigence essentielle : plus la restriction apportée aux libertés est générale, plus le législateur doit être en mesure de démontrer qu’elle est nécessaire, adaptée aux risques identifiés et accompagnée de garanties suffisantes.
Cette décision intervient alors que plusieurs États européens réfléchissent eux aussi à des dispositifs limitant l’accès des mineurs aux réseaux sociaux. Interrogée par MLex, Virginie Bensoussan-Brulé souligne que, si la décision du Conseil constitutionnel n’a évidemment pas d’autorité juridique directe à l’étranger, la méthode de contrôle retenue est largement transposable.
Les droits en présence ne sont en effet pas propres au droit français : liberté d’expression et d’information, droit au respect de la vie privée, protection des données personnelles et droits de l’enfant sont également protégés par la Charte des droits fondamentaux de l’Union européenne et par la Convention européenne des droits de l’homme.
D’une interdiction générale à une régulation fondée sur les risques
La décision ne signifie donc pas qu’une interdiction générale serait juridiquement impossible en toutes circonstances. Elle montre toutefois qu’un tel dispositif sera sensiblement plus difficile à justifier qu’un régime ciblé.
Le Conseil constitutionnel reproche au texte français d’englober très largement des plateformes permettant aux utilisateurs de communiquer ou de partager des contenus, sans prendre suffisamment en considération leurs fonctionnalités, leurs contenus, les risques propres à chaque service ou encore les mécanismes de protection déjà mis en place.
Le futur cadre juridique devra ainsi probablement opérer davantage de distinctions selon :
- l’âge et le degré de maturité des mineurs ;
- la nature du service concerné ;
- les fonctionnalités proposées ;
- les risques effectivement identifiés ;
- les dispositifs de protection déjà disponibles.
Cette logique rejoint celle retenue au niveau européen. Les lignes directrices de la Commission européenne relatives à la protection des mineurs au titre du DSA privilégient une approche fondée sur les risques.
Elles s’intéressent aux systèmes de recommandation, à la lecture automatique des contenus, aux notifications persistantes ou encore à certaines techniques de conception susceptibles de favoriser un usage excessif, plutôt qu’à une interdiction uniforme de tous les services accessibles aux mineurs.
Vérification de l’âge : protéger les mineurs sans généraliser l’identification
La vérification de l’âge constitue l’un des points les plus sensibles du débat.
Une obligation de contrôle applicable à l’ensemble des utilisateurs peut en effet conduire à imposer également aux adultes de justifier leur âge et entraîner le traitement de volumes importants de données personnelles.
Un dispositif juridiquement solide suppose donc des garanties fortes : minimisation des données, limitation des finalités, séparation entre l’identité de la personne et la preuve de son âge, durée de conservation strictement limitée, sécurité, exactitude des mécanismes employés, contrôle indépendant et possibilité de recours.
Le Comité européen de la protection des données insiste lui aussi sur une approche proportionnée et fondée sur les risques. Lorsque cela est possible, une logique de non-conservation devrait même être privilégiée : une fois l’âge vérifié, les données ayant servi à cette vérification n’ont pas vocation à être conservées.
Le modèle développé au niveau européen apparaît particulièrement intéressant à cet égard. Il repose sur une idée simple : une plateforme n’a pas nécessairement besoin de connaître l’identité de son utilisateur ni son âge exact ; elle doit seulement pouvoir savoir si celui-ci se situe au-dessus ou au-dessous du seuil d’âge applicable.
Un tiers peut ainsi procéder à la vérification et transmettre uniquement cette information à la plateforme.
L’intelligence artificielle ne fait pas disparaître les risques
L’estimation de l’âge au moyen de systèmes d’intelligence artificielle peut permettre d’éviter le recours systématique à une pièce d’identité.
Elle ne supprime cependant pas les difficultés juridiques ; elle les déplace en partie.
Exactitude du résultat, faux positifs, biais, risques de discrimination ou traitement de caractéristiques physiques, voire biométriques selon les technologies utilisées, doivent être pris en compte. Une solution alternative et un recours effectif sont donc indispensables lorsque l’estimation est erronée.
Les lignes directrices européennes distinguent d’ailleurs la vérification de l’âge, privilégiée dans les situations les plus sensibles ou lorsqu’un seuil légal s’impose, de simples mécanismes d’estimation de l’âge pouvant être adaptés à d’autres contextes.
Réguler les fonctionnalités plutôt que les applications ?
La décision du Conseil constitutionnel pourrait enfin encourager une évolution de l’approche réglementaire.
Sur le plan juridique, agir directement sur les fonctionnalités susceptibles de créer ou d’amplifier un risque peut apparaître plus proportionné que d’interdire l’accès à une application dans son ensemble, à condition que le lien entre la fonctionnalité concernée et le risque à prévenir soit établi.
Systèmes de recommandation susceptibles d’enfermer le mineur dans certains contenus, autoplay, notifications persistantes ou mécanismes de conception favorisant l’engagement peuvent ainsi faire l’objet de mesures spécifiques.
La décision du Conseil constitutionnel ne consacre donc nullement un droit absolu des mineurs à accéder à tous les réseaux sociaux. Elle peut, en revanche, être lue comme une feuille de route à destination des législateurs français et européens : identifier précisément les risques, cibler les services et les fonctionnalités concernés, proportionner les mesures à l’âge des utilisateurs et inscrire directement dans la loi des garanties suffisantes en matière de vérification de l’âge et de protection de la vie privée.
Interview de Virginie Bensoussan-Brulé par Matthew Newman : « Block on French social media ban exposes risl for EU states with similar ideas », MLex, 17 août 2026 (accès réservé).
Virginie Bensoussan-Brulé
AvocateDirectrice du pôle Contentieux du numérique
L’article Réseaux sociaux et mineurs : la décision du Conseil constitutionnel est apparu en premier sur Lexing Avocats.
-
La France va revoir son projet d’interdiction des réseaux sociaux aux moins de 15 ans
incyber.orgLe projet français visant à interdire l’accès aux réseaux sociaux aux moins de 15 ans ne verra finalement pas le jour sous sa forme actuelle. Le Conseil constitutionnel a censuré la mesure phare du texte, estimant qu’elle portait une atteinte disproportionnée à la liberté d’expression et de communication, tout en soulevant des interrogations sur la protection de la vie privée liée à la vérification de l’âge.
Le dispositif, qui devait entrer en vigueur le 1er septembre, concernait notamment TikTok, Instagram, Snapchat et X, ainsi que certaines fonctionnalités de plateformes et services de messagerie. Les Sages ont notamment pointé un périmètre jugé trop large, incluant des services pour lesquels les risques liés à l’usage par les mineurs ne sont pas suffisamment établis.
L’exécutif entend toutefois poursuivre son projet. Emmanuel Macron a demandé au gouvernement de préparer une nouvelle version du texte, compatible avec les exigences constitutionnelles et le droit européen, avec une présentation envisagée au printemps 2027.
Cette décision intervient alors que plusieurs pays renforcent leurs restrictions concernant l’accès des mineurs aux plateformes sociales. L’Australie, qui a instauré une interdiction pour les moins de 16 ans fin 2025, fait toutefois face à des difficultés de contrôle et de contournement. Le débat devrait également s’intensifier au niveau européen, la Commission européenne ayant annoncé la préparation de nouvelles mesures sur l’accès des mineurs aux réseaux sociaux.
The post La France va revoir son projet d’interdiction des réseaux sociaux aux moins de 15 ans appeared first on INCYBER NEWS.
-
Trump autorise le hack back pour le secteur privé
incyber.orgLe président des États-Unis, Donald Trump, a signé, le 12 août 2026, un mémorandum de sécurité nationale (NSPM) créant le premier programme formel de hack back privé outre-Atlantique. Ce texte autorise les sociétés de cybersécurité privées à mener des opérations offensives contre des groupes cybercriminels établis à l’étranger. Le National Coordination Center (NCC) administrera le dispositif, sous l’autorité de deux directeurs exécutifs nommés respectivement par les départements de la Justice (DoJ) et de la Sécurité intérieure (DHS).
Une entreprise souhaitant participer devra recevoir un agrément, conclure un contrat avec le DoJ ou le DHS, puis obtenir une autorisation écrite avant chaque opération. Elle pourra alors recourir légalement à des techniques de cybersurveillance, y compris à l’aide d’un logiciel-espion, ainsi qu’à des cyberattaques visant à perturber ou saboter les infrastructures exploitées par des criminels.
Le NSPM définit également les cibles autorisées : des groupes criminels étrangers d’envergure menant des campagnes de rançongiciel, de hameçonnage, de sextorsion ou de fraude à l’investissement contre des victimes américaines. Ces activités auraient causé 20,8 milliards de dollars (18 milliards d’euros) de pertes en 2025. Le NSPM exclut formellement toute opération sortant de ce cadre, sous peine de sanctions pénales.
Dans son préambule, le mémorandum affirme que le secteur privé américain dispose « d’un avantage historiquement sous-utilisé », fondé sur une « profondeur technique » et une « vitesse opérationnelle » que le gouvernement ne peut égaler. Ce texte marque un revirement de la politique de la Maison Blanche : en mars 2026, le directeur national du cyber, Sean Cairncross, excluait tout recours à des campagnes offensives privées.
Plusieurs professionnels du secteur comparent ce programme aux lettres de marque accordées autrefois à des corsaires pour combattre des pirates étrangers. En normalisant le hack back privé, le dispositif crée en effet un précédent susceptible de bouleverser les équilibres de la cybersécurité mondiale.
Ses défenseurs y voient une réponse opérationnelle au manque de moyens des agences gouvernementales pour lutter contre la cybercriminalité. Ses opposants pointent des risques d’escalade, allant de l’incident diplomatique aux représailles contre des intérêts américains.
Des juristes ont également relevé plusieurs lacunes dans le texte. Il ne prévoit ni règles précises sur la responsabilité en cas de dommages collatéraux à des tiers, ni critères permettant de déterminer quels groupes criminels étrangers peuvent relever du dispositif. Les règles précises du programme doivent être fixées dans les 60 jours.
The post Trump autorise le <strong>hack back</strong> pour le secteur privé appeared first on INCYBER NEWS.
-
Nvidia CMP 170HX - La VRAM était bien là, bridée par le firmware
korben.infoJe viens d'apprendre qu'une carte Nvidia normalement dédiée au minage de cryptomonnaies, vendue avec 8 Go de mémoire en expose aujourd'hui 64 Go, sans que rien n'ait été remplacé ou soudé dessus... C'est ça la magie de Nvidia, la mémoire était bien là depuis le début, mais était juste maintenue en sommeil par le firmware.
Cette carte, la CMP 170HX est sortie il y a 5 ans pour miner de l'Ethereum. Elle est bâtie sur le GA100, le même silicium 7 nm que l'accélérateur A100 que Nvidia vend aujourd'hui autour de 3 500 dollars en version 40 Go. Et la mémoire HBM2e qu'on y trouve est physiquement présente sur la carte, quoi qu'affiche la fiche technique. Alors certes, débrider une carte Nvidia par logiciel n'a rien de neuf puisqu'on transformait déjà des GeForce en Quadro en 2013.
Mais cette fois, le déverrouillage exploite un bug de chargement de signature dans le BootROM du Falcon, le microcontrôleur de sécurité qui garde le démarrage de la puce. Et ce dernier se fait grâce à un outil nommé cmpunlocker , publié sous licence GPL.
Si vous voulez vous lancer, il vous faudra du Linux x86-64, un accès root et le pilote libre nvidia-open en version 610.43.0x. Votre carte 8 Go passera ainsi à 64 Go, une carte 10 Go à 40 Go, et les unités de calcul bridées reviendront naturellement avec. Et surtout, ce patch survit au redémarrage !
Le PCIe, lui, ne se déverrouille qu'à moitié. Passer de Gen1 à Gen2 est logiciel, mais la largeur reste coincée à quatre lignes parce que Nvidia a laissé 24 condensateurs de couplage vides sur le circuit imprimé. Aller au-delà du x4 veut donc dire les souder à la main et ça c'est pas donné à tout le monde.
Reste que ça donne environ 1 Go/s vers la carte. À titre d'exemple, un utilisateur du forum développeurs de Nvidia a réussi à charger un modèle 70B quantifié en une quarantaine de secondes, contre une dizaine avec la modification matérielle et le Gen2 x16. Pour de l'inférence sur une seule carte, ce goulot ne se paie donc qu'au chargement.
Le même utilisateur mesure un taux de 27,3 tokens par seconde en décodage sur un modèle Qwen2.5-72B, pour 150 à 180 watts, et explique que lors de ses tests, le GPU a réclamé un reset autour de 95% d'occupation mémoire, sur de très grandes fenêtres de contexte. Rien de gênant donc. Deux réserves par contre, et elles ne sont pas décoratives.... La première c'est que l' ECC figure toujours dans la liste des problèmes non résolus du projet, avec le NVLink et le PCIe Gen4, alors que c'est précisément le mécanisme qui pourrait nous dire si la mémoire déverrouillée tient dans la durée. Et la seconde, c'est que le palier des 80 Go a été testé, mais rejeté car instable.
Sur la question qui fâche maintenant, à savoir celle du silicium mis au rebut qui serait bridé car défectueux, ValdikSS, dans un fil sur Hacker News , écrit n'avoir trouvé jusqu'ici aucune carte dont la RAM soit réellement défectueuse. Le bridage ressemble donc à de la segmentation commerciale plus qu'à du recyclage de puces ratées, mais pour le moment, personne n'a fait tourner ces 64 Go assez longtemps pour le prouver.
Reste le prix... La 170HX se trouvait peu de temps avant ça, autour de 250 dollars sur eBay mais depuis que l'exploit circule, elle dépasse les 1 000 $... Bref, le verrou a sauté, et le prix est en train d'exploser !
Source : Tom's Hardware
-
Robotique : Unitree dévoile « Superman », un humanoïde qui bat des records de vitesse et de saut, avant son entrée en Bourse
www.usine-digitale.frAprès avoir présenté deux humanoïdes téléopérés, Unitree poursuit sa démonstration de force avec « Superman ». Développé en un peu plus de trois mois, le nouvel humanoïde est présenté par son constructeur comme capable d’atteindre une vitesse de pointe de 12,66 mètres par seconde (45,6 km/h) - une allure légèrement supérieure aux quelque 44,7 km/h atteints par Usain Bolt lors de son record du monde du 100 mètres en 2009. Le robot est également capable d’effectuer un saut vertical sans élan d’environ deux mètres, avec des jambes de 0,85 mètre.
-
Un AirTag révèle où finissent les livres qu’Amazon achète et détruit en masse
www.numerama.com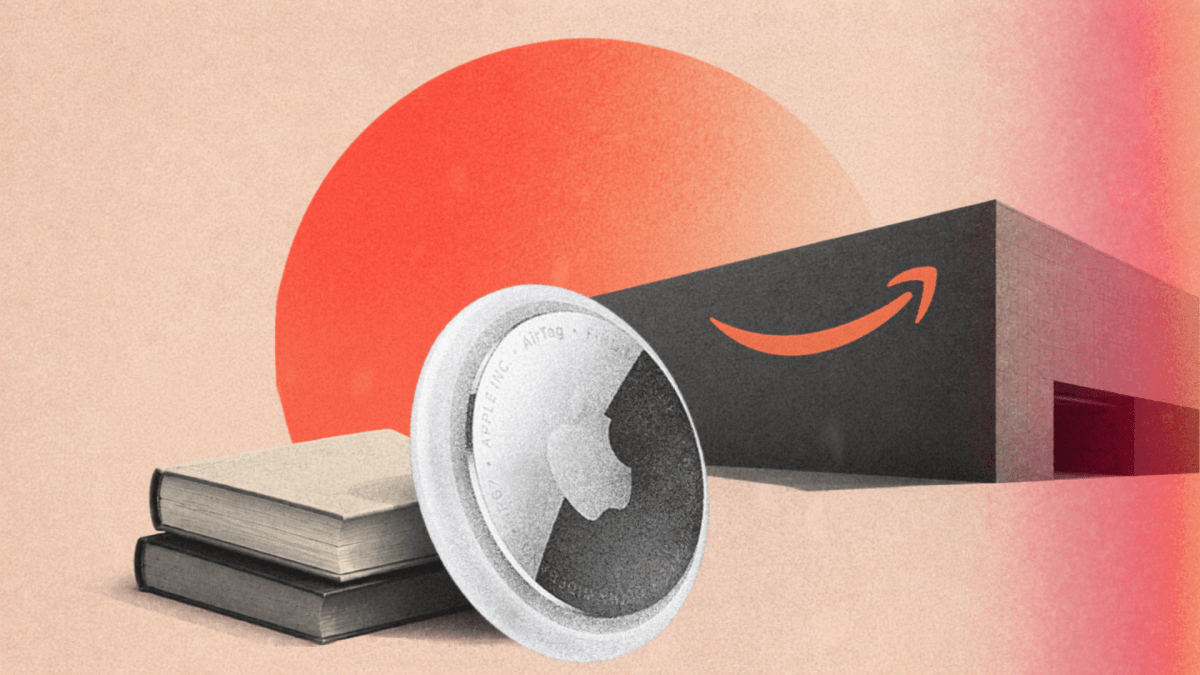
Dans une enquête publiée le 17 août 2026, 404Media raconte avoir caché un AirTag dans un livre rare. Le traceur a conduit les journalistes jusqu’à un entrepôt Amazon de Las Vegas, où des montagnes d’ouvrages seraient découpées puis numérisées pour entraîner des IA.
-
Un atelier japonais double la VRAM des RTX 2080 Ti pour pas cher
korben.infoDans la préfecture de Saitama, au Japon, une petite boutique s'est fait une spécialité qui tombe à pic en pleine flambée des prix de la mémoire, celle de faire passer une vieille GeForce RTX 2080 Ti de 11 à 22 Go de VRAM pour environ 45 000 yens, soit 282 dollars ou un peu moins de 250 euros.
Le procédé n'a rien d'un tour de passe-passe logiciel et repose entièrement sur une vraie dextérité au fer à souder, puisqu'il faut dessouder les onze puces GDDR6 de 1 Go montées d'origine, les remplacer par onze modules Samsung de 2 Go, ajuster quelques résistances sur le circuit imprimé que tous les modèles n'acceptent pas, puis flasher un VBIOS adapté pour que la carte reconnaisse ses nouveaux 22 Go.

La 2080 Ti se prête bien à l'exercice grâce à sa configuration mémoire un peu bâtarde de 11 Go, qui se double proprement là où d'autres cartes coincent.
Autant le dire tout de suite, ce gain ne rapporte strictement rien en jeu, le bus mémoire restant bloqué à 352 bits, la bande passante à 616 Go/s et la puissance de calcul du processeur graphique ne bougeant pas d'un pouce.
L'intérêt se trouve entièrement du côté des modèles d'intelligence artificielle que l'on fait tourner chez soi, là où c'est la quantité de mémoire disponible, et elle seule, qui détermine si un modèle parvient à se charger ou non.
En passant de 11 à 22 Go, on débloque toute une série de modèles de langage quantifiés qui refusaient jusque-là de tenir, et surtout on les garde entièrement en mémoire vidéo au lieu de déborder sur la mémoire système, ce qui change complètement la fluidité de l'ensemble.
Le calcul financier finit de rendre l'idée séduisante, avec une modification facturée 282 dollars, des cartes déjà transformées vendues à partir de 430 dollars et un ensemble complet qui tourne autour de 500 dollars une fois cumulé avec une 2080 Ti d'occasion, quand les GPU récents taillés pour l'IA et dotés d'autant de mémoire réclament facilement plus de 1 000 dollars.
Il reste quand même deux réserves de taille, à commencer par l'architecture Turing de cette carte qui remonte à 2018 et commence à accuser son âge sans profiter des optimisations des générations récentes, et surtout par la disponibilité, l'atelier n'ayant reçu que 200 puces Samsung, de quoi transformer une petite vingtaine de cartes avant de devoir se réapprovisionner.
Bref, c'est rigolo mais ça ne va pas tout de suite changer le monde.
Source : Tom's Hardware , xingyao74043
-
Rendre une voiture invisible pour les caméras
korben.infoAu début du mois d'août, une Toyota Yaris de 2009 est passée devant une caméra Flock à Las Vegas sans être "vue". Car même si la caméra l'a filmée correctement, le logiciel de détection, lui, n'a rien inscrit dans ses logs, comme si la rue était restée vide...
J'ai trouvé ça intéressant parce que ça ne nécessite pas de grande technologie... Non, il faut juste que la voiture soit recouverte d'un certain motif généré à l'aide d'un ordinateur. C'est un motif qui ne cache rien puisque la plaque d'immatriculation reste à sa place réglementaire et est parfaitement visible.
Mais ce qu'il faut savoir avant pour bien comprendre comment ça fonctionne, c'est qu'une caméra de lecture de plaques ne lit pas une plaque en permanence. Elle repère d'abord un véhicule dans l'image, puis va chercher la plaque dessus. Du coup, en cassant la première étape, la seconde n'a jamais lieu. La plaque reste donc visible mais le système n'a pas l'idée d'aller la lire...

Derrière l'expérience, on retrouve Bill Swearingen, un vieux de la vieille de la sécu qui a cofondé SecKC, le meetup sécurité de Kansas City. Son projet s'appelle noRecognition et fonctionne comme un fuzzer. Il génère un motif, le passe devant des modèles de détection, note ce qui échoue, et recommence et ainsi de suite... 31,7 millions de tests plus tard, il produit alors des motifs à la demande pour déjouer ce genre de caméra.
Alors pourquoi quelqu'un irait dépenser un an de calcul machine là-dessus ? Hé bien parce que Flock revendique 93 plaques correctement lues sur 100, pour plus de 20 milliards de lectures par mois et que l'Institute for Justice a recensé au moins 27 automobilistes innocents arrêtés, détenus ou emprisonnés depuis 2018 à cause d'une de ces erreurs de lecture...
Et dans près des deux tiers des cas, les policiers s'en sont rendu compte après avoir sorti leur arme. Bref, la polémique enfle aux États-Unis, encore plus depuis février dernier, dans l'Arkansas, quand un couple s'est retrouvé injustement menotté au bord de la route à cause d'une de ces caméras, pendant que leur bébé de six semaines attendait dans le siège auto.
Swearingen a même mis à dispo publiquement un tableau de bord public qui affiche en toutes lettres les résultats chiffrés qui sortent de ses modèles réels avec l'impression et la caméra simulées. Son tableau de bord indique également que pour le moment, aucun motif unique ne bat encore les onze modèles de caméra de son banc d'essai, en même temps, et surtout, il a mesuré jusqu'à 64 % d'écart entre les chiffres de son labo et les vrais tests réalisés dans le monde extérieur. J'ai rarement vu une page de vente aussi peu vendeuse ^^ mais au moins c'est honnête.

Et ça n'a pas empêché sa campagne Kickstarter de dépasser de 20 fois son objectif. Ses motifs générés se vendent en t-shirts et en hoodies, mais ce qui vaut pour une carrosserie ne vaut pas forcément pour un vêtement. En effet, une portière est plate, rigide et ce qui y est imprimé est fixe. Alors qu'un tissu se plie et se déforme, et Swearingen prévient qu'un motif imprimé trop grand ou trop petit cessera de fonctionner sans que ça ne se remarque.

Et chez nous en France ?
Hé bien les lecteurs de plaques tournent aussi donc possiblement, ça pourrait aussi fonctionner ici. Mais tout ceci reste géré au niveau de l'État et des communes, et c'est contrôlé par la CNIL. Même si on n'en est pas loin, ce n'est donc pas encore dans ce cauchemar très américain où ce sont des dizaines de réseaux privés comme Flock, revendus clé en main aux villes, qui font la loi, peu importe le taux d'erreur du logiciel.
Source : Bitdefender
-
Garantir moins d’électricité aux data centers pour les raccorder plus vite : la solution contre-intuitive face aux réseaux saturés
www.usine-digitale.frLa course à l’intelligence artificielle se heurte de plus en plus à la contrainte très concrète de l’accès à l’électricité. Alors que la demande de calcul explose, les délais de raccordement des data centers peuvent désormais atteindre 5 à 10 ans dans certains marchés, selon une étude publiée ce 18 août par Boston Consulting Group (BCG).
-
Le site à envoyer à tous ceux qui vous copient collent depuis ChatGPT
korben.infoVous posez une VRAIE question à un collègue, et ce connard vous renvoie 800 mots sortis d'un chatbot et qu'il n'a manifestement pas relus. C'est chiant hein ? Parce qu'à ce tarif, autant rien lui demander et aller directement sur ChatGPT vous-même. Hé bien bonne nouvelle, il existe maintenant un site à lui envoyer pour l'éduquer un chouilla sans que vous ayez à lui faire la leçon vous-même.
Ce site s'appelle dontpastetheai.com , et le site propose 2 explications sur pourquoi c'est pas cool de répondre en copiant collant un machin issu d'un LLM. Il y a la version "polie" que vous pouvez trouver ici, et la version énervée lisible ici qui demande direct "devine qui l'IA va remplacer en premier ?".
À vous de voir si vous voulez garder de bonnes relations avec cette personne... : une polie, qu'on peut envoyer à son manager, et une colérique sur
/angry/qui demande "devine qui l'IA va remplacer en premier ?".
Maintenant, le reproche tel qu'il est formulé par ce site n'est pas esthétique. Personne ne se plaint que le texte pue le généré par un modèle IA à des kilomètres... Non, on se plaint de ce qu'il faut faire avec. Parce que celui qui colle sans lire n'a pas supprimé le travail de lecture, il l'a déplacé sur vous. Il a gagné trente secondes et vous en a coûté cinq minutes.
Ça rejoint un peu ce dont je vous parlais déjà en janvier à propos de l'impact des LLM sur l'open source . On refile la vérification du contenu IA aux mainteneurs du projet... Et ici, quand quelqu'un vous envoie un contenu IA, il vous refile sa lecture. C'est le même geste mais à deux échelles différentes.
Maintenant, si vous aussi vous avez tendance à faire ça, c'est-à-dire à copier-coller des sorties d'IA pour "instruire" vos amis et collègues, sachez que tout n'est pas perdu. Vous pouvez évoluer et corriger ce travers grâce à ces quelques conseils simples. Déjà, lisez ce que l'IA vous envoie et écrivez vous-même votre propre version avec vos mots. Extrayez le passage qui répond vraiment à la question de votre correspondant et jetez le reste à la poubelle. Pas la peine d'être verbeux inutilement comme ChatGPT, trois phrases suffisent. Vous pouvez aussi citer l'extrait utile en disant pourquoi. Et le dernier conseil, le move que peu de gens osent faire en 2026 parce que quasiment tout le monde a un égo de la taille d'une pastèque, c'est tout simplement de répondre que vous ne savez pas ou que vous n'avez pas d'opinion tranchée sur tel ou tel sujet. Pas besoin d'aller demander à une IA ce qu'elle en pense si vous-même n'en savez rien. Dire "je ne sais pas" reste une réponse valable.
Surtout que répondre à tort et à travers en mode "no-brain" avec de l'IA, ça va vous décrédibiliser de fou... C'est prouvé scientifiquement grâce au travail de 2 chercheurs de l'université d'Arizona qui ont fait passer treize expériences à plus de cinq mille participants sur cette question précise. Un professeur qui annonce corriger avec de l'IA perd ainsi 16 % de la confiance de ses étudiants, un graphiste 20 % de celle de ses clients. Même en testant avec des formulations adoucies, du genre "ça n'a servi qu'à la relecture" ou "un humain a tout relu", la confiance baisse quand même.
Sauf qu'ils ont mesuré autre chose dans la foulée. Se faire démasquer par quelqu'un d'autre est PIRE que d'avouer par soi-même qu'on a utilisé une IA. Donc annoncer ce qui vient du modèle coûte bien moins en crédibilité mais dans les 2 cas, y'a quand même une facture à payer. Elle est juste moins salée quand vous annoncez la couleur.
À garder en tête quand même : ces chiffres portent sur des situations précises, une copie corrigée, une publicité, un graphiste jugé par son client, une lettre de motivation. Personne n'a mesuré ce que ça coûte réellement dans un fil Slack ou un échange mail entre des gens qui se connaissent. Mais au jugé, je dirais que c'est encore plus décevant...
Maintenant, attention... Claquer dans la gueule ce genre de manifeste à quelqu'un, c'est parfois plus violent que la faute qu'on lui reproche. À vous donc de bien doser... une remarque sincère et délicate fera sûrement mieux d'ailleurs.
Mais bon, peu importe, je pense quand même que respecter ce principe c'est plutôt sain. Et le relever en douceur comme ceci, ça vous évitera d'être injustement considéré comme l'un de ces boomeurs mentaux anti-IA qui trainent en ce moment sur X ou équivalent ^^.
Ah et force à Laink !
Source : dontpastetheai.com
-
Apple fait fuiter ses propres secrets : iPhone pliant, AirPods à caméra… une tonne de références ont été découvertes dans macOS
www.numerama.com
À quelques semaines de sa keynote de rentrée, Apple a vendu la mèche toute seule. En distribuant la version quasi finale de macOS 26.7, Apple a oublié de masquer des dizaines de références à des appareils encore secrets.
-
Gadgetbridge - L'appli qui gère votre montre connectée sans Internet
korben.infoGadgetbridge est une application Android libre qui va vous faire zizir parce qu'elle permet de remplacer l'app merdique du fabricant de votre bracelet ou montre connectée ou encore de vos écouteurs Bluetooth. Comme ça, terminé le compte obligatoire pour utiliser vos "wearables" et fini les serveurs du constructeur localisés en Chine ou je ne sais où qui reçoivent vos heures de sommeil ou votre fréquence cardiaque minute par minute... Puis surtout, ça permet de n'avoir plus qu'une seule application Android pour tous vos appareils et ça c'est cool aussi !
Surtout que ça fonctionne en OFFLINE... Hé oui, le manifeste de cette app indique bien que jamais, Ô grand jamais, elle ne se connectera au net. Y'a même pas la permission dans l'app, c'est bloqué au niveau du code.

Maintenant, concrètement, Gadgetbridge permet de recevoir vos notifications à votre poignet, de répondre aux appels avec réponses préenregistrées, de paramétrer des alarmes, de lancer une lecture de musique, d'avoir du suivi d'activité et de sommeil, ainsi que vos tracés GPS de vos trop rares séances de sport. Et bien sûr, tout reste en local sur votre téléphone. Notez que AsteroidOS , dont je vous ai déjà parlé, fait pareil mais un cran plus bas, uniquement dans la montre.
Gadgetbridge supporte actuellement 529 modèles de 74 fabricants, d'Amazfit à Garmin, avec Pebble, Sony, Huawei et Xiaomi. Mais prenez le temps de lire la fiche technique de votre modèle car tous ne sont pas supportés en intégralité.
Reste maintenant le prix à payer, et il ne vient pas de Gadgetbridge.

En effet, sur les Amazfit et Xiaomi récents, l'appairage se négocie avec les serveurs du constructeur. Il faut donc appairer une première fois avec l'appli officielle, puis en extraire la clé. Même histoire chez Fossil, dont les montres HR sortent en plus avec un firmware de démo que seule l'appli maison sait remplacer. Chez Nothing aussi, la CMF Watch Pro veut une clé extraite d'un téléphone rooté, alors que les Pro 2 et Pro 3 s'en passent.
Une appli qui aurait la permission d'aller sur Internet irait chercher cette clé toute seule mais comme celle-ci ne peut pas, faudra le faire vous-même (c'est expliqué comment dans la doc).
De leur côté, les Garmin s'appairent directement, sauf quelques modèles qui veulent avoir vu l'appli officielle une fois. Mais la météo, et l'AGPS sur certaines montres, réclament des identifiants à renouveler tous les 90 jours, et Gadgetbridge propose d'y répondre avec de faux jetons OAuth. Après si vous voulez revenir ensuite à celle du constructeur, faudra peut-être relancer une remise à zéro d'usine.

Après pour les irréductibles qui voudraient quand même du réseau, un module séparé, Internet Helper, est arrivé début 2026. Il relaie les requêtes des applications de la montre, s'installe à part, et nécessite sa propre autorisation.
Voilà, tout cela s'installe depuis F-Droid sur tout Android 6.0 ou plus récent, sous licence AGPLv3, et le code est dispo sur Codeberg.
-
Amazon détruit des livres pour nourrir ses IA
korben.infoSi comme moi, vous aimez les livres, ce que je vais vous raconter aujourd'hui va vous rendre fous ! Hier, 404 Media a publié une enquête qui suit le trajet d'un AirTag. Mais pas n'importe lequel... C'est un AirTag qu'un libraire a glissé, à la demande de la rédaction, dans un livre parti au sein d'une commande d'un millier d'ouvrages. Et son terminus va vous surprendre (ou pas, parce qu'on commence à les connaitre les lascars...) : un entrepôt Amazon de Las Vegas.
Ce qu'on apprends dans l'article de 404 Media c'est qu'en fait, là-bas, une équipe interne baptisée VGT3 reçoit des tonnes de cargaisons de livres, en découpe les reliures et les passe au scanner afin d'en numériser les pages.
Pour la blague, le logo de cette équipe est un tyrannosaure gueule ouverte qui semble dévorer un livre. Ironique n'est-ce pas ?

Des salariés du site racontent eux-mêmes sur un forum d'employés Amazon, que les livres ne survivent pas à l'opération.
Et c'est ça qui rend dingo tout le monde, moi le premier !
Amazon, interrogé, a répondu qu'il achetait des livres par des canaux commerciaux pour "développer et améliorer ses produits et services". Oui, c'est vague mais c'est fait exprès.
Maintenant, calmez vos palpitations cardiaques, ce qu'ils numérisent (et détruisent), ce ne sont pas des incunables , c'est-à-dire des livres anciens édités avant l'invention de l'imprimerie (donc faits à la main). Les libraires interrogés précisent en effet, que les commandes en gros n'incluent jamais les ouvrages les plus anciens sans codes ISBN. Ce qu'ils achètent en fait, ce sont des titres sans presque aucun marché de revente, tirés à peu d'exemplaires ou écrits dans une langue que peu de gens lisent.
Et c'est pile poil ce qui fait leur valeur pour un entraîneur de modèle IA. Ces textes n'ont jamais été numérisé, donc ils n'ont jamais été aspirés par personne, et ont été imprimés avant que le web ne se remplisse de slop IA. Ces livres-là ne sont pas vraiment "précieux" mais comme ils sont rares et de niche, ils sont convoités par les géants de l'IA.
Maintenant ce qui me met en colère quand je lis cet article, c'est surtout cette histoire de destruction du bouquin... Parce que numériser un livre sans l'abîmer, ce n'est pas un rêve utopiste d'archiviste, hein... C'est possible avec des machines qu'il est facile de se procurer. Je pense par exemple à ce ScanRobot autrichien qui est sur le marché depuis 2007 et déjà vendu dans plus de soixante pays.
 Charger la vidéo depuis YouTube
Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles.
En savoir plus
Voir cette vidéo sur YouTube
Il glisse un prisme dans la pliure, aspire les pages de part et d'autre via des petits trous, remonte en photographiant le texte, puis retourne la page d'un souffle d'air grâce à des capteurs optiques et des lasers repèrent le moment où deux feuilles se lèvent ensemble. Et la cadence est plutôt bonne puisqu'elle peut aller jusqu'à 2 500 pages à l'heure, sans que le dos du livre ne soit tranché.
La Bibliothèque du Congrès en a une, le Trinity College Dublin aussi, l'université de Sydney, le Getty Research Institute...etc. L'Internet Archive, lui, tournait déjà en 2021 à environ 3 500 livres par jour dans une vingtaine de centres.
D'ailleurs, j'en parlais dans un article sur un scanner à 250 pages par minute en novembre 2012. J'écrivais qu'au début ça y allait au massicot, et que depuis, les bras robotisés avaient pris le relais pour les ouvrages anciens. Et là on est presque 14 ans plus tard, la plus grosse librairie du monde est retournée au massicot, comme des bourrins préhistoriques.
Sur le motif de la découpe elle-même, Ars Technica avance que la vitesse et le moindre coût ont pris le pas sur la conservation, et c'est vrai que ces bouquins existent ailleurs, et que découper un exemplaire d'occasion sans valeur marchande ne fait de mal à personne. Oui c'est vrai mais c'est incroyablement triste car on peut faire autrement. La preuve, quand Google, OpenAI ou Microsoft numérisent des livres, eux les empruntent dans des bibliothèques ou les offrent ensuite à celles-ci. Les livres peuvent continuer leur vie, alors qu'Amazon n'est pas du tout dans ce cercle vertueux. Et c'est sans parler des auteurs de tous ces livres qui ne savent même pas que leur travail vient d'être absorbé pour l'éternité par une IA...
Bref, Amazon prend un exemplaire dont le texte n'a jamais été numérisé, le déstructure en tokens pour son propre profit puis détruit le livre... Si tout le monde faisait ça, au bout d'un moment, de nombreux ouvrages anciens disparaitraient je pense... Et faut pas oublier que cette destruction de livres c'est surtout un choix délibéré de leur part.
Ray Bradbury doit se retourner dans sa tombe, mais je suis certain que si les gens protestaient massivement contre ça, ils changeraient leurs méthodes de sagouins.
Source : 404 Media
-
Le Mac mini M4 à 699 € est enfin de retour sur Amazon (mais vous pourriez le recevoir après le M5)
www.numerama.com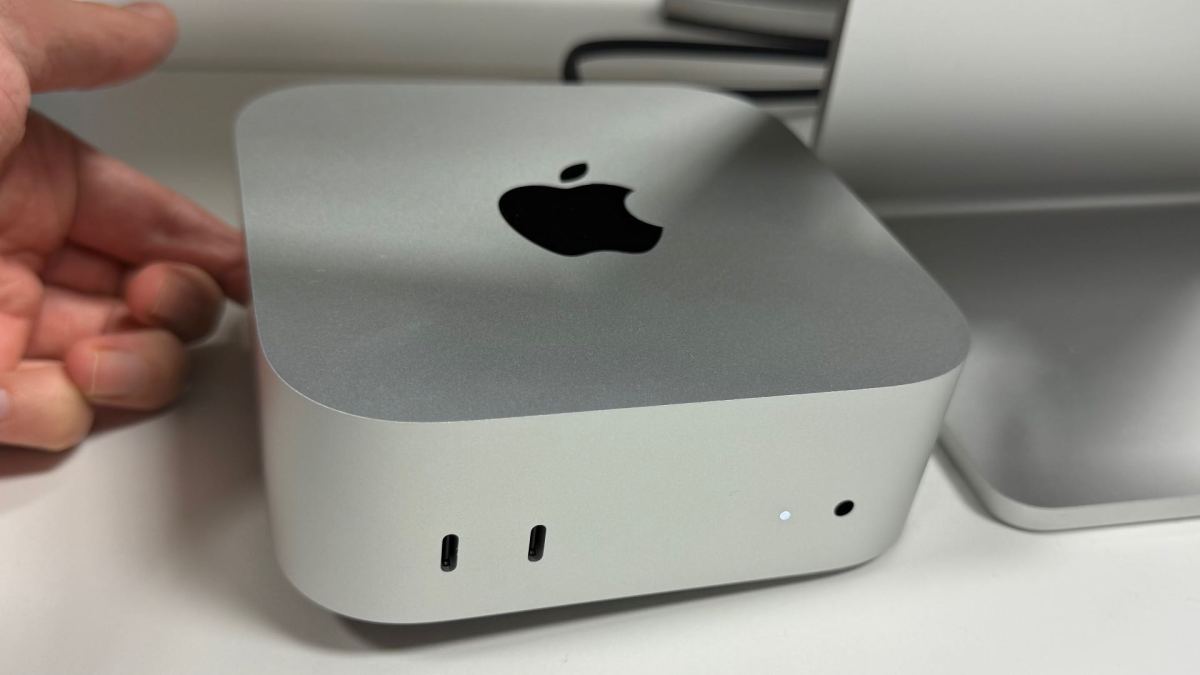
[Deal du jour] Depuis la hausse généralisée des prix d’Apple fin juin, le Mac mini M4 d’entrée de gamme avait disparu à 699 €. Amazon rouvre les commandes à ce tarif, contre 949 € sur l’Apple Store, même si sa disponibilité reste encore toute relative.
-
Les 15 000 entreprises qui découvriront NIS 2 après le vote
www.frenchweb.frLa directive NIS 2 est entrée dans le droit européen en décembre 2022. Pourtant, des milliers d’organisations françaises n’ont toujours pas mesuré ce qu’elle implique pour elles. Entre la transposition nationale en cours et les sanctions qui peuvent atteindre 2 % du chiffre d’affaires mondial, le temps de la découverte progressive est terminé. Voici comment …
L’article Les 15 000 entreprises qui découvriront NIS 2 après le vote est apparu en premier sur FW.MEDIA.
-
Query fan out : pourquoi l’IA change la manière dont les moteurs explorent le Web
www.frenchweb.frLe query fan out modifie une mécanique fondamentale de la recherche en ligne : une question peut désormais déclencher plusieurs recherches parallèles avant qu’une réponse ne soit produite. Une évolution qui oblige aussi les éditeurs et les professionnels du SEO à revoir leur approche. Le moteur de recherche ne répond plus seulement à la requête …
L’article Query fan out : pourquoi l’IA change la manière dont les moteurs explorent le Web est apparu en premier sur FW.MEDIA.
-
Pourquoi il faudra bientôt se méfier des compteurs de vues sur YouTube
www.numerama.com
À partir du 24 août 2026, YouTube comptabilisera une vue dès qu’une vidéo commencera à être diffusée. Un changement très visible pour les internautes, qui risque surtout de rendre les compteurs publics beaucoup plus flatteurs.
-
Le code de GoldenEye 007 est enfin sorti de sa cartouche
korben.infoEnfin !! Le compteur du projet de décompilation de GoldenEye 007 affiche dorénavant 208 fichiers traités sur 208, et cela pour les trois versions de la cartouche, japonaise et européenne comprises. Le dernier commit du dev KholdFuzion est d'ailleurs classe, puisqu'il porte le titre "*james bond will return. *".
Oh yeah !

Techniquement, le code C reconstitué ressort du compilateur sous la forme d'une ROM identique à celle de 1997, octet pour octet. C'est précisément ce que veut dire le mot "matching" dans ces projets. Ce n'est donc pas un jeu équivalent qui se comporterait pareil que le jeu d'origine... Non, c'est exactement le même binaire !
Après comme vous vous en doutez, le dépôt, lui, n'embarque pas tous les assets nécessaires à la compilation, pour des questions de droits d'auteur comme d'hab. Le README du projet nous explique ainsi qu'il faut posséder une copie du jeu, et que les scripts iront extraire ce qui manque de votre côté.
Après c'est pas cette recompilation qui fait que GoldenEye devient soudainement "moddable". En effet, il l'est depuis longtemps, via le GoldenEye Setup Editor de SubDrag, Wreck et Zoinkity, capable d'importer vos propres modèles 3D dans le jeu.
Ce qui change par contre, c'est que jusqu'ici on éditait des structures dans un binaire, alors que maintenant on modifie le moteur en C et on recompile. C'est le même chemin qu'avait pris ce bon vieux Duke Nukem Zero Hour l'an dernier .
 Charger la vidéo depuis YouTube
Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles.
En savoir plus
Voir cette vidéo sur YouTube
Et c'est d'ailleurs ce que fait KholdFuzion à côté, avec GoldenRecomp , qui recompile la ROM en exécutable PC natif. Avec ça, le jeu peut tourner sur un ordinateur. Apparemment, c'est plutôt stable, et le son est bon.
Mais toute l'interface multijoueur reste à faire, le ciel du barrage part en vrille parce que le moteur de rendu ne digère pas les commandes de dessin maison, et certaines armes tirent trop vite maintenant que tout tourne à 60 images par seconde. Ce n'est donc pas encore vraiment jouable.
Aucune release n'a été publiée à ce jour, ni même un tag, ce qui veut dire qu'on est encore loin d'un portage installable comme celui de Zelda 64 . Faudra compiler vous-même, après avoir "build" une ROM depuis la branche du projet conçue pour ça.
Dans le même style, n'oubliez pas l'existence de GoldenEye-Recomp de SunJaycy , qui lui, est déjà jouable avec du multijoueur en ligne, mais qui n'a rien à voir avec tout ça puisqu'il recompile la version Xbox 360 qui n'est jamais sortie, et pas la N64.
Bref, si vous attendiez un exécutable à lancer ce soir, ce n'est pas ce que vous aurez mais ce qui s'annonce ensuite est très prometteur !
-
DGFiP : le piratage pousse Matignon à accélérer le chantier cyber de l’État
incyber.orgLe piratage de la DGFiP devient un test grandeur nature pour la nouvelle politique cyber de l’État. Lundi 17 août, Sébastien Lecornu a présidé une cellule interministérielle de crise consacrée à l’incident. À son issue, le Premier ministre a chargé l’Agence nationale de la sécurité des systèmes d’information (ANSSI) de mener un audit approfondi afin d’identifier les circonstances de l’attaque et les éventuelles faiblesses ayant permis l’exfiltration. Matignon souhaite également accélérer le plan de sécurisation des systèmes d’information publics présenté au printemps.
Les intrusions dans le SI de la DGFiP avaient eu lieu en juin et juillet 2026 à partir d’identifiants usurpés appartenant à un agent de l’administration fiscale et à un tiers habilité. Les accès avaient été coupés, mais l’exfiltration n’avait pas été identifiée à ce moment-là. Les investigations lancées après les revendications de l’attaquant ont finalement établi que des données fiscales et cadastrales avaient été consultées ou extraites : revenu fiscal de référence, quotient familial, taux de prélèvement à la source ou encore informations relatives à certains biens immobiliers. Les espaces personnels des contribuables et leurs mots de passe n’ont pas été compromis, selon Bercy.
L’exécutif cherche désormais à inscrire sa réponse dans un cadre plus large. Fin avril, après plusieurs incidents ayant visé des services de l’État, Sébastien Lecornu avait annoncé 200 millions d’euros supplémentaires pour renforcer les applications, les capacités de détection et la cryptographie post-quantique. À compter de 2027, chaque ministère devra également consacrer 5 % de son budget numérique à la cybersécurité. Le plan prévoit par ailleurs la création d’une nouvelle autorité numérique rattachée directement au Premier ministre et chargée notamment de mieux standardiser et sécuriser les infrastructures ministérielles.
Cette future structure, baptisée Ariane, doit participer à la nouvelle gouvernance du numérique de l’État. Sa création ne remet toutefois pas en cause le rôle de l’ANSSI en matière de cybersécurité : lors de travaux parlementaires consacrés aux vulnérabilités numériques françaises, le gouvernement a présenté Ariane comme un outil de pilotage plus large du numérique public, notamment pour traiter des problèmes structurels comme l’authentification forte, la gestion des identités ou l’obsolescence des systèmes.
Avec la DGFiP, l’enjeu n’est donc plus seulement d’annoncer de nouveaux moyens, mais de vérifier leur traduction dans les administrations. Les conclusions de l’audit doivent désormais alimenter de nouvelles mesures opérationnelles attendues en septembre.
The post DGFiP : le piratage pousse Matignon à accélérer le chantier cyber de l’État appeared first on INCYBER NEWS.
-
GitLab - la faille qui a fait rouvrir une version morte
korben.infoGitLab a sorti hier (lundi 17 août), un correctif d'urgence , complètement en dehors de son calendrier habituel, pour une faille qui permet à quelqu'un sans compte ni mot de passe de modifier ou de supprimer vos projets publics et des données utilisateur. Hé ouais c'est chaud et c'est pour ça que son score CVSS est de 9,4 sur 10.
5 jours plus tôt, le 12 août, GitLab publiait son patch de routine pour la 19.2, 19.1 et 19.0. C'est un périmètre normal puisque sa politique de maintenance ne couvre que la version stable et les deux précédentes. Mais comme là, on est dans l'exceptionnel, ce correctif du 17 août en couvre une quatrième, la 18.11, dont le support avait pris fin le 16 juillet dernier. Ils sont allés rouvrir une branche morte juste pour patcher ce GROS problème !
La faille elle-même, on n'en sait presque rien par contre. Estampillée CVE-2026-19478, c'est une histoire de directive GraphQL, mais GitLab ne dit ni laquelle, ni dans quelles conditions ça se déclenche. Les détails techniques sortiront vers la mi-novembre, c'est-à-dire 90 jours après le correctif, comme d'habitude, histoire d'être sûr que tout le monde ait patché son install.
Maintenant, la bonne nouvelle c'est que si vous êtes sur GitLab.com ou sa version Dedicated , vous n'avez rien à faire, puisque c'est déjà patché. En fait cette histoire ne concerne que les instances auto-hébergées.
Et parmi elles, tout le monde n'est pas impacté de la même manière. En effet, le vecteur d'attaque passe par le réseau et vise les projets publics. Cela veut dire que votre instance planquée derrière un VPN, sans visibilité publique, risque beaucoup moins que celle qui expose ses dépôts à Internet.
Ensuite, pour la mise à jour, ça dépend d'où vous partez. Entre la 18.2 et la 18.10, aucun correctif n'existe sur votre branche. Il faudra upgrader jusqu'à la 18.11.11, en vous arrêtant aux paliers de 18.5 et 18.8 s'ils sont sur votre route.
Si vous tournez déjà en 18.11, prenez la 18.11.11. Sur une 19, c'est 19.0.8, 19.1.6 ou 19.2.4. Et plus ancien que 18.2 ? Bah là, GitLab ne liste pas ces versions parmi les affectées, mais elles ne reçoivent plus de correctif depuis un bon moment, donc ce serait bien de mettre à jour quand même, hein...
Pour le moment, personne n'a signalé d'attaque et aucun exploit ou PoC n'a fait surface sur GitHub. Ça ne veut pas dire grand-chose, je vous l'accorde mais on se rassure comme on peut...
Allez, bon courage !
Source : The Hacker News
-
GIMP abandonne le XCF
korben.infoVoici ce que je considère être une excellente nouvelle pour tous les utilisateurs de GIMP ! L'équipe derrière le projet est en train de préparer le successeur du XCF, son format de projet depuis 1997. C'est même devenu le plus gros chantier du mainteneur Jehan, et ce qui se dessine ressemble fortement à une espèce d'archive zip bourrée de XML.
À ce jour, ce bon vieux XCF stocke toute sa data dans un seul bloc qu'il faut alors relire et réécrire en entier, à chaque enregistrement. C'est lourdingue et c'est pour ça que sur sa roadmap, la team GIMP explique qu'un format basé sur une archive permettrait de charger les données à l'usage et d'ouvrir des projets bien plus lourds.
Le zip + du XML est une vieille recette côté graphisme. GIMP figure d'ailleurs déjà parmi les applications compatibles OpenRaster , dont la spécification décrit une archive zip contenant un document XML pour la structure des calques. Sauf que l'OpenRaster sert à échanger des images entre éditeurs, alors que ce nouveau format devra contenir un projet de travail complet.
Grâce à ce nouveau format, GIMP promet des sauvegardes plus rapides, puisqu'il n'y aura plus que les parties modifiées à mettre à jour. Et l'auto-save deviendra enfin faisable. Woohoo !!
Par contre, le vrai morceau, celui qui compte, arrivera plus tard. En effet, GIMP 3.6 doit apporter la gestion des pages et l'animation directement dans le logiciel, à la place du vieux plug-in d'animation bien connu des galériens que vous êtes ^^. Ce sont 2 fonctions que le XCF encaisse mal, comme tout ce qui devient gros ou compliqué, finalement...
Mais rassurez-vous, vos vieux fichiers ne partent pas à la benne pour autant car GIMP s'engage à charger les XCF dans toutes ses versions à venir. Jehan a même corrigé ce printemps, dans ce code XCF, un bug oublié depuis 1999 .
Alors je sais que vous êtes trèèèès impatients, mais les détails techniques sont encore en cours de conception, et la version de développement 3.3.2 qui doit ouvrir le bal se fait attendre. La 3.4 avance donc sans date ce qui fait que la roadmap reste flexible et évolutive.
D'ici là, c'est GIMP 3.2.6 qui arrive, avec les classiques corrections de bugs, en attendant cette épiphanie qui changera le quotidien de beaucoup de graphistes adeptes du libre !
Source : Development Update, August 2026
-
Goossips SEO : Hreflang & Indexation
Goossip #1www.abondance.comLes URLs alternatives hreflang ne sont pas toujours indexées
Gary Illyes (Google) a clarifié le fonctionnement des URLs alternatives hreflang lors de la canonicalisation, suite à une question posée sur LinkedIn par Faiez Javaid. La question initiale était la suivante : Si Google choisit une seule URL /lang/ comme canonique et affiche les autres comme "non indexées" dans GSC, comment se fait-il que Google puisse quand même afficher ces autres versions linguistiques dans les résultats de recherche ?
La réponse de Gary Illyes en deux points :
- Noms alternatifs : lorsqu'une URL est canonicalisée, les autres URLs de son cluster de duplicats peuvent devenir des "noms alternatifs". Elles peuvent apparaître dans les résultats si la requête de l'utilisateur le justifie, le cas le plus courant étant les requêtes site:, qui peuvent afficher des URLs qui redirigent en réalité, sans être "indexées" au sens propre.
- Les alternates hreflang fonctionnent de la même façon : ce sont des noms alternatifs, pas des URLs indexées au sens strict.
Source : Search Engine Watch
Taux de fiabilité :
 On est d'accord !
Voir des versions linguistiques/régionales d'une page apparaître en SERP alors que GSC les signale "non indexées" n'est pas forcément le signe d'un problème. Ces URLs ne sont ni cassées ni ignorées, elles sont simplement rattachées à la version canonique comme noms alternatifs, et Google peut les faire remonter dans des contextes précis (hreflang, requêtes
site:, etc.). Utile à garder en tête si un client ou un audit s'inquiète de voir des URLs hreflang marquées "non indexées" dans Search Console.L’article "Goossips SEO : Hreflang & Indexation" a été publié sur le site Abondance.
-
Sony ne sait toujours pas quand la PS6 sera lancée
www.numerama.com
À l'occasion d'une interview accordée au Wall Street Journal, Hiroko Totoki, CEO de Sony, a révélé que la crise des composants avait logiquement un impact significatif sur ses activités. Le business PlayStation, particulièrement, est touché.
-
« L’IA devrait être comme le Wi-Fi » : dans ce bar chinois, DeepSeek est à volonté
www.numerama.com
À Pékin, un bar propose à ses clients d’utiliser gratuitement et sans limite le modèle d’intelligence artificielle DeepSeek, le tout autour d’une bière. Un concept repéré par Reuters, qui illustre la place prise par l’IA dans le quotidien chinois.
-
Cyberattaque de la DGFiP : le bilan officiel grimpe à 678 000 victimes, loin des millions de données revendiquées par le hacker, sur fond de retard dans la transposition de NIS 2
www.usine-digitale.frDifficile d’affirmer que la directive NIS 2 aurait permis d’éviter la cyberattaque qui a frappé la Direction générale des finances publiques (DGFiP). Mais l’affaire intervient dans un contexte particulièrement embarrassant pour l’exécutif : près de deux ans après l’échéance fixée par Bruxelles, la France n’a toujours pas transposé ce texte européen destiné à renforcer le niveau de sécurité informatique des acteurs essentiels, dont les administrations publiques.
-
L’ère du ChatGPT gratuit et sans publicité touche officiellement à sa fin
www.numerama.com
Six mois après de premiers tests aux États-Unis, OpenAI annonce le déploiement global des bannières publicitaires dans la version gratuite de ChatGPT. Face aux inquiétudes sur la vie privée, la startup a ajusté ses plans initiaux à propos du ciblage.
-
Un script pour virer les produits sponsorisés d'Amazon
korben.infoAllez, on va faire un jeu. Cherchez un disque dur externe sur Amazon et regardez où pointe le premier lien de la page. Bingo, ça part sur une adresse en /sspa/click, autrement dit un emplacement publicitaire. Et c'est pas le mieux noté, c'est pas le moins cher, non, c'est juste celui qui a payé le plus pour être là.

Et moi, ce qui me saoule vraiment, c'est que les filtres n'y peuvent rien.
Pour remédier à cela il faut sortir l'artillerie. J'ai d'abord pensé à faire un filtre uBlock Origin, puis à me coder une extension Firefox, avant de me rappeler que Tampermonkey tournait déjà dans mon navigateur.
Direction le repo Greasy Fork, donc, où traîne un script qui fait exactement ça . Une cinquantaine de règles CSS, qui dégagent du DOM les résultats sponsorisés de la recherche, les carrousels promo, les encarts publicitaires de la fiche produit, l'upsell Prime et les bannières de marque.
On passe ainsi de ça :

À ça :

Et ça fonctionne super sur toutes les versions d'Amazon, y compris Amazon.fr.
Trois réglages attendent dans le menu du gestionnaire de scripts. Un compteur qui affiche en bas de page ce qui a été retiré et pourquoi, une journalisation console pour les curieux, et une option qui redirige les pages de navigation vers la vraie liste de résultats.

Attention quand même à ce qui saute en plus des pubs. Le bloc "Les gens qui ont acheté ça, ont aussi acheté ça". Le script s'attaque aussi à Rufus, l'assistant d'achat maison et côté installation, il vous faut Tampermonkey, Violentmonkey ou Greasemonkey. Sur Firefox, ça s'arrête là. Par contre sur Chrome, depuis la version 138, il faut en plus activer un switch "Allow User Scripts" sur la fiche de l'extension, coupé par défaut sur toute extension fraîchement installée.
Voilà, j'espère que ça vous aidera à avoir un Amazon un peu plus propre. Maintenant, n'oubliez pas, Amazon, c'est le mal, donc si vous avez les moyens de payer 2x plus cher la même chose et que vous aimez passer votre vie dans les transports ou en bagnole à faire une espèce de chasse au trésor à travers toute la ville, pour trouver le produit qu'il vous faut, le mieux reste encore et toujours d'acheter dans des magasins physiques. Lol.

