Tech-fr publisher
-
Après le trilogue, la bataille pour le contrôle de l’Euro numérique continue
incyber.orgIl y a encore loin de la coupe aux lèvres pour l’euro numérique. Le trilogue européen du 30 septembre n’a débouché sur aucune avancée majeure [1]. Deux jours après la troisième réunion politique entre Parlement européen et Conseil consacré au sujet, le groupe de travail du Conseil a donc remis le dossier sur la table le 2 octobre [2]. Le sujet semble patiner, puisqu’aucun nouveau compromis n’a depuis été rendu public et qu’une nouvelle réunion est déjà programmée le 14 octobre.
Lors du trilogue du 30 septembre, les discussions se sont notamment concentrées sur les frais facturés aux commerçants et les plafonds de détention. Sur ce dernier point, le désaccord illustre presque grandeur nature les conclusions de notre enquête. Le Parlement prévoit que la Commission fixe un plafond par acte délégué, sur recommandation de la BCE. Le Conseil préfère laisser la BCE déterminer les limites effectives, mais à l’intérieur d’un plafond général décidé par les États.
Le débat ne porte donc plus seulement sur le montant de ce plafond, les fameux 3 000 euros régulièrement évoqués et qui ne constituent toujours pas un seuil définitif, mais sur celui qui contrôlera ce paramètre. L’architecture peut techniquement appliquer automatiquement une limite et le politique négocie encore qui pourra la fixer.
Même bataille derrière les frais. Le Conseil propose de les indexer dans un premier temps sur ceux des cartes de débit, éventuellement pendant dix ans, avant de passer à un calcul fondé sur le coût réel du paiement. Le Parlement veut ramener cette transition à cinq ans et n’autoriser le nouveau calcul que s’il réduit la facture des commerçants.
C’est précisément l’un des enseignements de notre enquête sur l’euro numérique : entre ce que l’infrastructure peut faire et ce qu’elle fera effectivement s’intercalent des garde-fous juridiques, mais aussi des choix politiques modifiables. Plafonds, frais, données ou mécanismes antifraude ne sont pas gravés dans le marbre du code, mais de simples variables. Après trois trilogues, Bruxelles négocie toujours qui pourra les changer.
Sources et références
[1] Agence Europe, 30 septembre 2026 – « Euro numérique –PE et Conseil de l’UE confrontent leurs positions sur le modèle de compensation et les plafonds de détention »
[2] Conseil de l’Union européenne, 2 octobre 2026 – Working Party on Financial Services and the Banking Union (Digital Euro)
The post Après le trilogue, la bataille pour le contrôle de l’Euro numérique continue appeared first on INCYBER NEWS.
-
Pourquoi cette étrange pub pour Walter White tourne-t-elle en boucle sur X depuis des années ?
www.numerama.com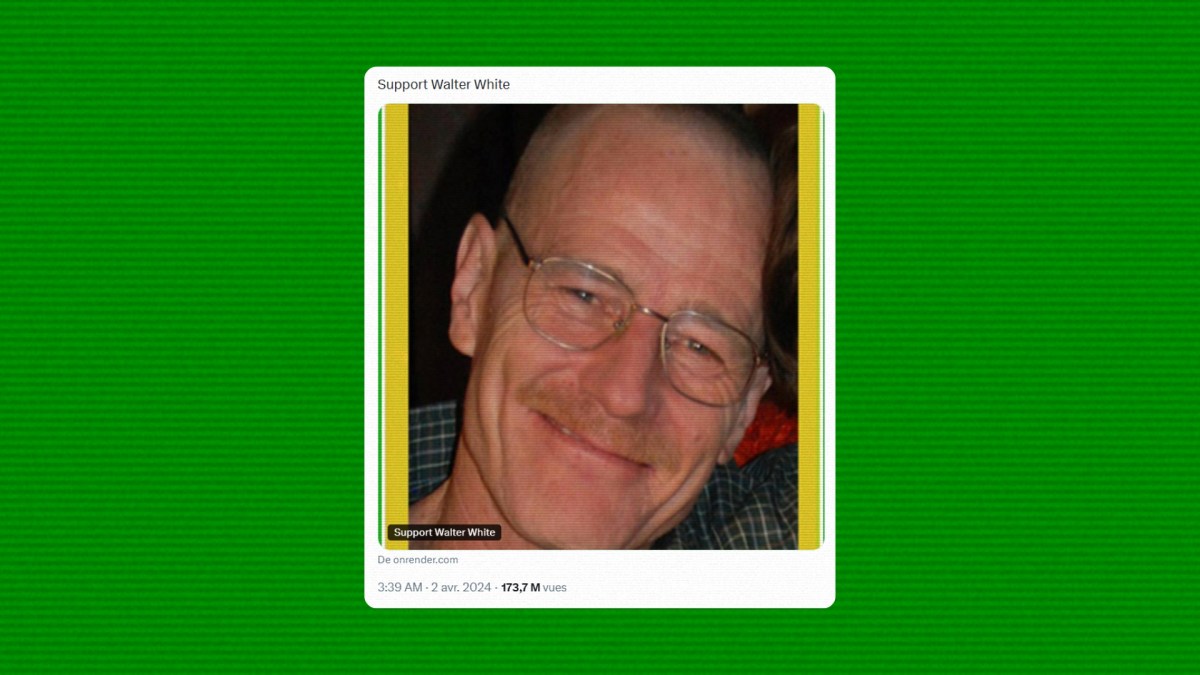
Une étrange publicité mettant en scène Walter White revient sans cesse dans les fils X. Cette dernière cumule désormais plus de 170 millions de vues et renvoie vers un site qui invite les internautes à « soutenir » le personnage de Breaking Bad, à laisser leur nom et éventuellement leur adresse e-mail. Le tout sans expliquer clairement qui l’a créé, ni pourquoi quelqu’un paie encore pour le promouvoir aussi massivement.
-
L’Europe tient une nouvelle licorne dans la robotique “next-gen” : la start-up allemande RobCo atteint une valorisation d’un milliard de dollars
www.usine-digitale.frL’Allemagne est sans nul doute le pays européen le plus dynamique dans la robotique “next-gen”. Elle abrite notamment RobCo, qui a annoncé le 5 octobre avoir dépassé le milliard de dollars (892 millions d’euros) de valorisation, le faisant accéder au statut de “licorne”. Selon le Wall Street Journal, la start-up a réalisé la vente de 40 millions de dollars (35,7 millions d’euros) d’actions secondaires détenues par ses salariés. Elle a par la même occasion fait entrer deux investisseurs : les capital-risqueurs Cherry Ventures et European Tech Collective.
-
Nouveau décodeur Freebox : Free donne enfin de ses nouvelles
www.numerama.com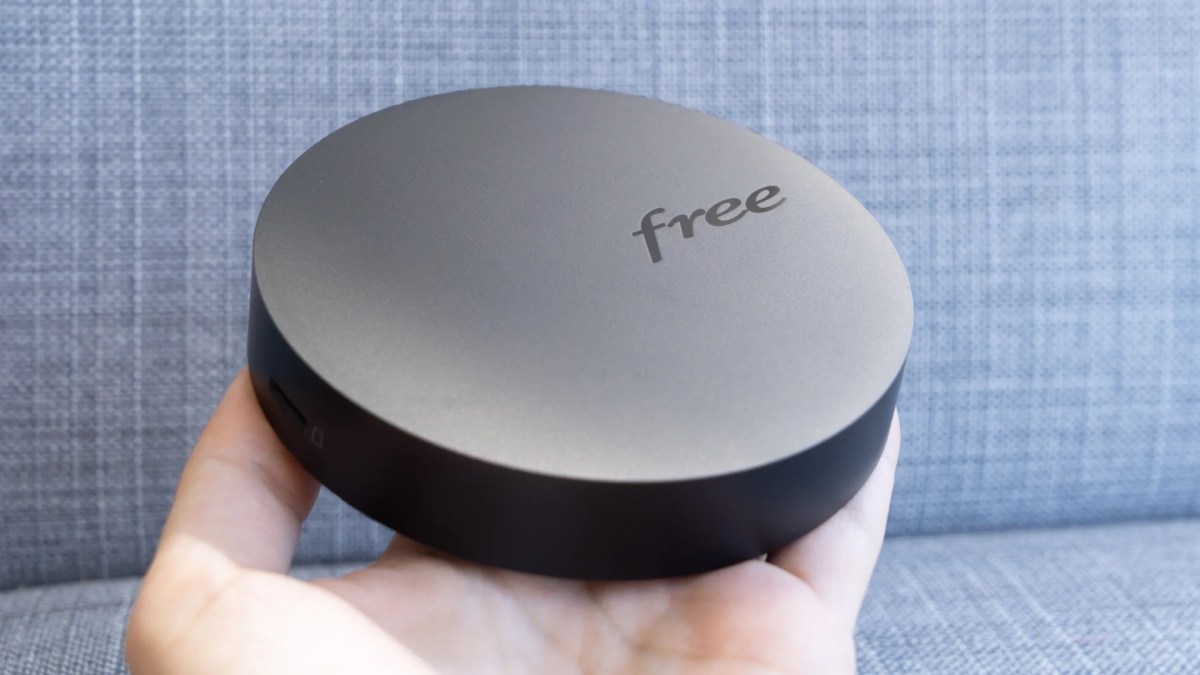
Promis par Xavier Niel lors du lancement de la Freebox Ultra en janvier 2024, le nouveau Freebox Player est désormais prévu pour début 2027. L'opérateur ne dévoile rien, mais certains imaginent déjà une sorte de « Super Player ».
-
[IA Insider] Aleph Alpha, Mistral AI, Reflection... Les modèles open-weight occidentaux veulent en découdre avec leurs rivaux chinois
www.usine-digitale.frÀ la une
-
Il a entièrement recodé 8 vieux OS en HTML + un VB6 qui sort des .exe.
korben.infoWiesław Šoltés , un développeur open source spécialiste de .NET et d'Avalonia, a publié d'un coup sur son Github, plusieurs reconstitutions de Windows 3.1, 95, 98, Me, 2000, XP, Vista et même Mac OS 9 directement utilisables dans le navigateur ! Vous cliquez sur le lien, la page se charge en moins de deux secondes, et hop, vous voilà devant le Program Manager, le menu Démarrer ou le Finder.

Les huit bureaux au démarrage : Windows 3.1, 95, 98 et Me en haut, 2000, XP, Vista et Mac OS 9 en bas
Et ce ne sont pas des coquilles vides comme on le voit parfois mais de vrais OS complets. Le Windows 3.1 compte 28 applications rangées dans les groupes d'origine du Program Manager, XP en a 56, et Windows Me monte à 60 app en comptant les panneaux de configuration. Donc si vous n'avez jamais connu ces machines en vrai parce que vous êtes un.e petit.e jeune, c'est l'occasion de tripoter vous-même ce que vos aînés vous racontent depuis des années.

Le Démineur de Windows 3.1, ouvert par-dessus les groupes du Program Manager
Toutes les applis d'un même bureau partagent en plus un disque virtuel. Ainsi, sous Windows 95, un document enregistré dans Notepad apparaîtra dans l'Explorer tout comme dans l'invite MS-DOS, et l'interpréteur de commandes gère les redirections et les jokers (les *) sans soucis.
Voici par exemple le début d'une petite séquence que propose le README, à taper dans une invite de commande MS-DOS pour créer un fichier :
CD "C:\My Documents"
ECHO Hello from DOS>hello.txt
TYPE hello.txt
DIR /B *.txt
L'invite MS-DOS de Windows 95 après la séquence ci-dessus : hello.txt est créé, lu puis listé
Côté jeux, XP propose le Spider Solitaire, une Dame de pique contre trois adversaires pilotés par l'ordinateur et un flipper dont le tableau original, s'inspire de Space Cadet. Vista, quant à lui, ressort Chess Titans, Mahjong Titans, Purble Place et InkBall avec ses gadgets sur le côté, et Mac OS 9 a son Finder spatial, ses 33 tableaux de bord et sa Graphing Calculator.

Le flipper de Windows XP, une table originale inspirée de Space Cadet

Chess Titans sous Vista, avec l'horloge, le diaporama et le calendrier en gadgets

Mac OS 9 et sa Graphing Calculator, qui trace ici y = sin(x)
Maintenant, ce qui m'a intrigué, c'est comment ça peut démarrer aussi vite ???
Eh bien tout simplement parce que rien n'est émulé ! Par exemple, un émulateur comme v86 , dont je vous parlais en 2022, traduit à la volée le code machine x86 en WebAssembly pour faire tourner Windows lui-même dans le browser. Mais ici, il n'y a ni noyau Windows ni processeur virtuel, car chaque fenêtre, chaque menu et chaque application ont été réécrits en HTML, CSS et modules JavaScript. Les fenêtres sont donc des éléments de page web ordinaires, que le navigateur affiche comme n'importe quel site.
Le code, lui, est volontairement dépouillé, avec par exemple Windows 3.1 qui n'a besoin d'aucun framework ni d'aucun bundler, ou encore le bureau de Windows 95 qui s'affiche via un simple
python3 -m http.server.Seuls le fond d'écran, les économiseurs et certaines opérations de dessin passent par le GPU en WebGPU, avec un repli sur WebGL2 puis sur Canvas 2D si votre machine ne suit pas. Et sur Windows 3.1 comme sur Mac OS 9, l'image ne se redessine que quand quelque chose change, donc un bureau au repos ne relance aucun rendu au niveau GPU.
Pour le poids, pareil, c'est super léger. Cache désactivé, chaque "OS" charge très peu de data : 183 Ko pour Windows 95, 180 Ko pour Mac OS 9 et 306 Ko pour Windows 2000. Et XP et Vista montent à 4,5 et 2,5 Mo. À titre de comparaison, DrawingSpace , un éditeur de diagrammes façon Visio du même auteur, écrit en C# et compilé en WebAssembly avec Uno Platform, en réclame 17 Mo.

DrawingSpace, l'éditeur de diagrammes du même auteur, écrit en C# et compilé en WebAssembly
Le revers de la médaille, vous l'aurez compris, c'est que vous n'avez pas Windows sous la main, mais sa reconstitution. Aucun programme d'origine ne s'exécute, et l'équivalence au pixel près n'a pas été établie. Pour montrer à quoi ressemblait un bureau à quelqu'un qui ne l'a pas connu, ou pour choper un peu de code afin de développer votre propre bureau Windows HTML pour y mettre votre site web, c'est parfait. Mais pour relancer un logiciel d'époque tel qu'il était, faudra passer par v86, par Infinite Mac pour Mac OS 9, ou encore par RetroTick , qui exécute les vrais .exe Windows et DOS.
Mais le plus beau morceau de tout ce que le garçon nous a sorti, c'est je trouve, VB6 Studio Web , publié le même jour. C'est un Visual Basic 6 dans un onglet, avec sa boîte à outils, sa fenêtre Properties, son concepteur de formulaires et un débogueur pas à pas. Vous appuyez sur F5 et le projet d'exemple (une saisie de commandes shopping) se lance aussitôt. Et le code VB n'est pas confié à un eval JavaScript, mais réellement exécuté par un compilateur et une machine virtuelle maison, avec 37 types de contrôles différents dispos.

VB6 Studio Web après un F5 : le projet d'exemple Order Entry tourne dans l'IDE
Ouvrez ensuite l'exemple Calculator par File, New Project..., puis lancez File, Make Calculator.html, et votre programme deviendra une page HTML unique qui embarquera son propre runtime. Sur l'exemple Calculator, ça m'a donné un fichier de 1,9 Mo qui s'ouvre directement depuis le disque, sans l'IDE, et qui répond bien 42 quand je lui demande de faire un 6x7 (ouais, six-seven, on soutient la cause lycéenne ici !).
Pour ceux qui ont des archives, il peut aussi ouvrir les projets .vbp et .vbg d'époque, depuis des fichiers, un dossier ou un ZIP, et il embarque même un agent de code qui pilote l'IDE avec votre propre clé OpenAI, Anthropic ou Gemini.
L'entrée voisine, "Make Calculator.exe" (Win32 AOT), va encore plus loin puisqu'un éditeur de liens PE32 et un générateur de code x86 écrits en JavaScript y fabriquent un exécutable Windows natif, sans quitter le navigateur.
Chez moi, après compilation, j'ai obtenu un fichier de 34 ko que la commande
fileidentifie comme un véritable exécutable PE32 pour Windows. Je ne l'ai pas lancé sous un vrai Windows, mais ça devrait normalement se lancer vu que c'est assez basique comme code.
Le projet Calculator après Make Calculator.exe : la barre d'état annonce 34304 octets, code x86, contrôles natifs et GDI, sans extraction

La même calculatrice exportée en un seul fichier HTML, ouverte hors de l'IDE : 7 × 6 = 42
Bref, le mec a fait des trucs de zinzin, à se demander comment un développeur peut-il sortir autant de choses à lui tout seul ?
Probablement grâce à l'IA, puisque les projets contiennent pour la plupart un fichier
.openai/hosting.jsonmais peu importe, même si c'est vibe codé, c'est quand même un gros boulot et la qualité est au rendez-vous.Voilà, si vous voulez tester, tout se lance sans rien installer, depuis les dépôts Windows 3.1 , 95 , 98 , Me , 2000 , XP , Vista et Mac OS 9
Vos fichiers créés dans ces "OS" resteront bien sûr dans le navigateur dans un IndexedDB, donc si vous videz les données du site ou si vous changez de navigateur, votre ordinateur virtuel repartira de zéro...
Sous Windows 95, l'outil Backup exportera le disque en JSON donc il y a quand même moyen de faire un petit export si ça vous amuse et bonne nouvelle, son VB6 Studio Web est sous licence MIT, donc si vous avez encore un vieux projet VB6 qui dort sur un disque dur, vous savez maintenant où aller pour tenter de le rouvrir !
-
Après deux ans de retard, la France traîne encore des pieds pour adopter NIS 2, tandis que les organisations encaissent les cyberattaques
www.usine-digitale.frLe rendez-vous devait marquer la fin d’une longue attente. Inscrit à l’ordre du jour de l’Assemblée nationale à partir du 7 octobre 2026, le projet de loi relatif à la résilience des infrastructures critiques et au renforcement de la cybersécurité - qui transpose NIS 2 - devait enfin entrer dans l’hémicycle.
-
Le dernier grand iPhone standard d’Apple baisse pour les Prime Day d’Amazon
www.numerama.com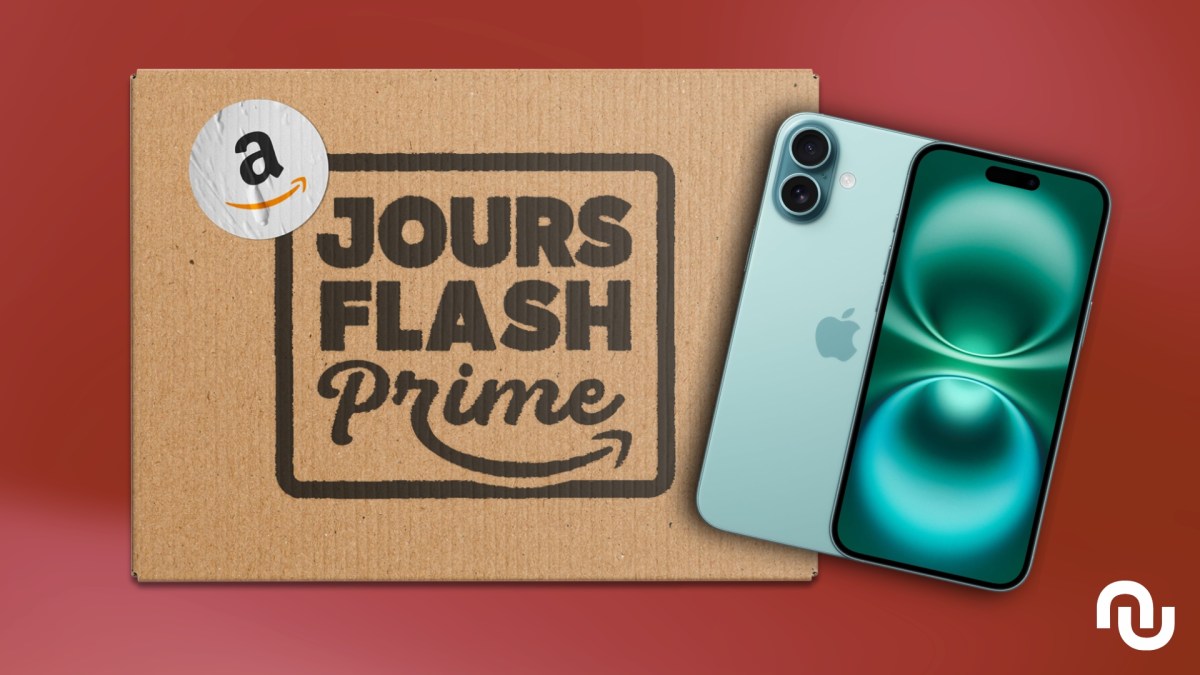
[Deal du jour] L'iPhone 16 Plus n'a pas eu de successeur direct, Apple ayant choisi l'iPhone Air pour prendre sa place. Amazon vend le modèle 128 Go à 849 € au lieu de 969 €.
-
Goossips SEO : SEO programmatique
Goossip #1www.abondance.comPourquoi Google peut bouder les agrégateurs de contenus ?
Un site web de type grand agrégateur de produits fait face à une anomalie d'indexation. Googlebot a exploré le site 1,17 million de fois en quelques semaines. Seules 4 pages sont indexées sur un total de 180 000, et la page d'accueil elle-même n'est pas indexée. Les captures de la Search Console montrent un pic d'exploration très net à côté d'une indexation presque nulle.
John Mueller identifie deux problèmes majeurs :
- Tout d’abord, plusieurs URL indexées redirigent directement vers la page d'accueil, ce qui indique des dysfonctionnements techniques importants à corriger.
- Par ailleurs, le site génère un volume massif de pages via du contenu automatisé. Google n'est généralement pas favorable aux pratiques d'agrégation et de SEO programmatique.
Source : Bluesky
Taux de fiabilité :
 On est d'accord !
Outre les problèmes techniques identifiés, ce cas nous rappelle que Google n’est pas particulièrement fan de SEO programmatique qui rime souvent avec un nombre important de pages sans grande valeur ajoutée.
L’article "Goossips SEO : SEO programmatique" a été publié sur le site Abondance.
-
Mistral relance la France dans la course à l’IA et dévoile « Le Chonk », un modèle de frontière à 1000 milliards de paramètres
www.numerama.com
Alors que les détracteurs de Mistral l'annoncent distancé par les modèles open source chinois et par les géants américains depuis de longs mois, Mistral fait son grand retour. Le champion français de l'intelligence artificielle dévoile Mistral Large 4 (surnommé Le Chonk), un modèle de 1 000 milliards de paramètres entraîné dans ses propres data centers en Europe. Mistral affirme qu'il se hisse au niveau des meilleurs modèles ouverts du monde et qu'il rebat les cartes pour l'IA européenne. Sa sortie est prévue le 27 octobre.
-
Avec Mistral Large 4, le champion français annonce avoir rattrapé les meilleurs modèles d’IA open-weight chinois
www.usine-digitale.frMistral AI a présenté ce lundi, en avant-première lors d’une conférence de presse, sa toute dernière génération de modèle d’intelligence artificielle flagship, baptisée Mistral Large 4 et surnommée en interne « le Chonk ». Il s’agit de la première annonce de l’entreprise depuis la clôture de sa levée de fonds en série D, d’un montant de trois milliards d’euros, le plus important tour de table jamais réalisé par une entreprise technologique européenne. Cette annonce illustre une ambition clairement affichée : réduire l’écart avec les meilleurs modèles mondiaux, tout en réaffirmant un positionnement souverain et ouvert, pensé prioritairement pour les entreprises et les États.
-
Runway fait le pari de l’ouverture pour accélérer dans la robotique avec son world action model Praxis-1
www.usine-digitale.frRunway ne compte pas rater le coche de la robotique. La start-up américaine, connue pour ses modèles de génération et d’optimisation vidéo, vient de lever le voile sur Praxis-1, son premier world action model (WAM) open weight pour le contrôle robotique.
-
Une prochaine mise à jour massive chez Google ? Les signes annonciateurs
www.abondance.comCe qu'il faut retenir :
- Le 1er octobre 2026, Google a réécrit sa documentation sur les contenus générés par IA : leur vérification humaine avant publication devient « critique », y compris pour les balises title, les meta descriptions, les données structurées et les attributs alt.
- Le guide de Google sur les contenus utiles liste désormais quatre critères de qualité (effort, originalité, talent ou savoir-faire, exactitude) et qualifie de tromperie les profils d'auteurs inventés ou illustrés par des photos générées par IA.
- Google a lancé quatre spam updates en 2026, contre une seule en 2025, et l'écart entre deux mises à jour est passé de 92 à 37 jours. Lily Ray, Glenn Gabe et Marie Haynes anticipent une mise à jour majeure.
- Selon Lily Ray, les sites qui publient des contenus IA à grande échelle, des pages programmatiques, des listicles autopromotionnels ou des mentions payées ont intérêt à auditer ces pratiques avant la prochaine mise à jour.
Google réécrit ses consignes sur les contenus générés par IA
Le principal signal relevé par Lily Ray tient en quelques lignes de documentation. Le 1er octobre 2026, Google a mis à jour sa page consacrée à l'utilisation de contenus produits par IA générative. On y lit désormais qu'il est « critique » de vérifier manuellement tous les contenus générés par IA, et de s'assurer de leur exactitude et de leur fiabilité avant publication.
Une relecture humaine qui s'étend aux métadonnées
Cette exigence ne concerne pas seulement le corps du texte. Elle couvre aussi les balises title, les meta descriptions, les données structurées et les textes alternatifs des images. A noter que Google emploie rarement le mot « critique » dans sa documentation. La page renvoie aussi vers deux sections des consignes destinées aux quality raters (les évaluateurs humains qui notent la qualité des résultats pour Google) : l'abus de contenu à grande échelle et les contenus produits avec peu ou pas d'effort.
Lily Ray y voit l'avertissement le plus important, parce que les contenus IA produits en masse sont, selon elle, la première cause des pénalités et des baisses algorithmiques qu'elle a observées cette année. Ces contenus contiennent souvent des hallucinations. D'après elle, ces erreurs dégradent l'expérience des internautes et peuvent aussi être reprises comme des faits par les AI Overviews et l'AI Mode de Google.
Effort, originalité, talent et exactitude
La même semaine, Google a ajouté une section à son guide « Creating helpful, reliable, people-first content ». Ce document définit le « contenu principal » d'une page et en fait l'un des facteurs les plus « critiques » pour évaluer sa qualité. Il liste quatre éléments que les évaluateurs sont formés à repérer :
- Effort : le travail réellement investi dans le contenu.
- Originalité : ce que la page apporte de nouveau.
- Talent ou savoir-faire : la compétence visible dans la réalisation.
- Exactitude : la fiabilité des informations publiées.
Le passage sur l'effort vise directement la production automatisée. Google y précise que l'usage de l'IA générative pour produire de grandes quantités de texte, sans supervision ni sélection humaine, correspond à peu ou pas d'effort. Pour les sujets YMYL (« Your Money or Your Life », c'est-à-dire santé, finance, sécurité), le texte exige un contenu très exact et conforme au consensus des experts.
Lily Ray met en garde les entreprises qui pensent que leurs contenus IA sont de meilleure qualité que ceux visés. Presque toutes celles qui l'ont consultée après une chute de trafic pensaient la même chose de leurs propres pages, écrit-elle.
Les faux auteurs officiellement qualifiés de tromperie
Le guide contient aussi un nouveau paragraphe sur les profils d'auteurs. Google y écrit que fabriquer des profils de créateurs, avec des photos générées par IA, des noms inventés ou de fausses qualifications, est une forme de tromperie. Toute tromperie rend la page peu fiable aux yeux des utilisateurs comme des systèmes automatisés de qualité, et constitue un signal de page de faible qualité.
Les consignes des quality raters traitaient déjà les faux profils d'auteurs comme une tromperie. La nouveauté, selon Lily Ray, est que Google s'adresse désormais directement aux éditeurs et relie cette pratique à ses systèmes automatisés. Cyrus Shepard a par ailleurs repéré une nouvelle section sur la manière dont le contenu a été créé, dans laquelle Google semble inviter les sites à signaler l'usage d'automatisation par IA.
Gary Illyes place les contenus à grande échelle devant le spam de liens
Les représentants de Google tiennent le même discours sur scène. Lors du Search Central Live de Barcelone, organisé la semaine de la publication de l'article, plusieurs déclarations sont allées dans ce sens, d'après le compte rendu de John Campbell cité par Lily Ray :
- Gary Illyes : le contenu produit à grande échelle devient un problème plus important que le spam de liens.
- Duy Nguyen : les spam updates se multiplient parce que le volume de nouveaux contenus explose, et l'équipe utilise désormais l'IA pour en détecter davantage. Duy Nguyen a aussi recommandé de lire les consignes des quality raters, en définissant la qualité avec les quatre critères de la nouvelle documentation.
Google a expliqué avoir mis à jour sa documentation sur les contenus IA pour l'aligner sur les présentations faites lors de ses événements pour développeurs. Autrement dit, le message transmis jusqu'ici à l'oral figure maintenant par écrit. Lily Ray y voit une manière pour Google de pouvoir renvoyer à sa documentation lorsqu'une mise à jour touchera des sites pris au dépourvu.
Quatre spam updates en 2026, à un rythme qui s'accélère
Pour rappel, une spam update est une mise à jour des systèmes de Google chargés de détecter les pratiques contraires à ses règles anti-spam, à la différence des core updates qui modifient l'algorithme de classement dans son ensemble. Google en a déployé quatre en 2026, contre une seule sur toute l'année 2025 :
- Spam Update de Mars 2026
- Spam Update de Juin 2026
- Spam Update d'Août 2026
- Spam Update de Septembre 2026
L'intervalle se réduit à chaque fois : 92 jours entre mars et juin, 55 entre juin et août, 37 entre août et septembre. La mise à jour de septembre se distingue aussi par sa durée annoncée. Les trois précédentes devaient prendre « quelques jours » et se sont toutes terminées en trois jours au maximum. Google a donné à celle de septembre une fenêtre allant jusqu'à deux semaines, comme pour une core update.
Search Engine Roundtable a observé de fortes variations du 25 au 27 septembre. Les premiers signaux relevés par Lily Ray montraient des sites touchés pour des pages très standardisées, programmatiques et probablement générées par IA, par exemple une page pour chaque numéro de téléphone ou indicatif régional. Au 4 octobre, Google n'avait pas encore déclaré cette mise à jour terminée.
Google a aussi durci ses règles tout au long de l'année :
- 13 avril : nouvelle règle anti-spam contre le « back button hijacking » (le détournement du bouton retour du navigateur).
- 14 avril : Google indique qu'il peut désormais s'appuyer sur les signalements de spam pour prononcer des actions manuelles (des sanctions appliquées par une équipe humaine).
- 15 mai : Google précise que ses règles anti-spam s'appliquent aussi aux réponses générées par IA dans la recherche, donc aux AI Overviews et à l'AI Mode.
Enfin, Search Engine Journal a présenté en septembre un article de recherche de Google décrivant SAFE, un système conçu pour détecter le spam généré par IA. D'après ce document, il serait déjà en déploiement précoce, mais il semble pour l'instant concentré sur la vidéo.
Listicles, Reddit et mentions payées : les tactiques GEO dans le viseur
Pour Lily Ray, une bonne partie des tactiques GEO à la mode reprennent d'anciennes techniques de spam SEO. Elle cite la production de masse de contenus IA, les listicles (articles en forme de classement) dans lesquels une marque se place elle-même en tête, les faux avis, les mentions achetées et la publication automatisée sur Reddit.
Les AI Overviews citent moins les classements autopromotionnels
Lily Ray a mis à jour son étude sur les listicles autopromotionnels cités dans les AI Overviews, à partir de 100 requêtes du type « meilleur logiciel B2B ». Ses résultats de septembre 2026, comparés à ceux de juin :
- Citations : les AI Overviews citent 38 % de listicles autopromotionnels en moins.
- Marque éditrice écartée : la marque qui se classe première est absente de la recommandation finale dans 83 % des cas, contre 69 % en juin.
- Effet inverse : dans 70 % des cas, le listicle aide surtout des concurrents à être recommandés.
Il s'agit de données issues de sa propre analyse, sur un périmètre limité à des requêtes B2B.
Reddit agit aussi de son côté. En mars, la plateforme a commencé à identifier les comptes de bots légitimes et à demander à certains comptes suspects de prouver qu'ils sont humains. En juillet, elle indiquait que ses systèmes automatisés bloquaient 25 000 publications et commentaires de spam par jour, dans le but d'empêcher les marques de placer des messages destinés à être recommandés par ChatGPT et Gemini. Reddit a aussi récemment banni quatre subreddits utilisés pour une expérience GEO qui s'appuyait sur des bots pour générer votes et commentaires.
Les mentions payées, nouvelle version des liens achetés
Lily Ray consacre un passage spécifique aux mentions de marque payantes, qu'elle décrit comme l'équivalent 2026 de l'achat de liens. Plusieurs entreprises vendent ouvertement des placements sur des sites tiers pour être recommandées par ChatGPT, Perplexity ou les AI Overviews. Parmi les offres qu'elle a relevées :
- Placements dans des listicles « meilleurs X » ou « top X », vendus à l'unité et tarifés selon le Domain Rating ou le Domain Authority du site, souvent à partir de 135 à 250 dollars.
- Packs de « mentions IA » ajoutées à des listicles, avis ou guides d'achat existants, par exemple cinq mentions pour 1 500 dollars.
- Placements avec lien dofollow garanti, c'est-à-dire un lien qui transmet de la popularité.
- Guides d'agences expliquant que, si la prospection échoue, de nombreux sites acceptent un paiement unique de 100 ou 200 dollars.
- Services clés en main proposés par des plateformes de visibilité IA, qui gèrent prospection, rédaction, négociation et paiement.
Lorsque ces placements contiennent des liens qui transmettent du crédit de classement, il s'agit d'achat de liens, rappelle Lily Ray. La politique de Google sur le spam de liens interdit l'échange d'argent contre des liens. Les liens payants ne sont autorisés qu'avec un attribut rel="sponsored" ou rel="nofollow". Aux États-Unis, la FTC (Federal Trade Commission) exige en général que les partenariats rémunérés soient clairement signalés, ce que ces offres mentionnent rarement.
Google a aussi abordé le sujet directement. Son guide sur les fonctionnalités d'IA générative indique que rechercher des mentions non authentiques sur le web n'est pas aussi utile qu'on pourrait le croire, et ses règles anti-spam couvrent désormais les tentatives de manipulation des réponses générées par IA dans la recherche. Lors d'un Search Central Live organisé en mai, Gary Illyes aurait comparé l'achat de mentions à l'achat de liens.
Des précédents qui plaident pour une mise à jour majeure
L'argument central de Lily Ray repose sur un schéma qu'elle appelle le « cycle du SEO » : les référenceurs trouvent une faille, la tactique se diffuse, puis Google construit des systèmes pour la neutraliser. Elle rappelle que Google a souvent modifié sa documentation ou ses consignes d'évaluation juste avant une grande mise à jour :
- Janvier 2011 : Matt Cutts évoque la montée du spam et les fermes de contenus. Panda suit en février 2011.
- Mars 2012 : Matt Cutts annonce au SXSW une pénalité contre les sites « suroptimisés ». Penguin suit en avril 2012.
- 20 juillet 2018 : les consignes des quality raters insistent sur la réputation des sites et des auteurs. La core update dite « Medic » arrive le 1er août, 12 jours plus tard.
- Septembre à novembre 2023 : Google retire la mention « written by people » de ses consignes et Danny Sullivan, alors Search Liaison, invite à « s'accrocher ». La Helpful Content Update de septembre 2023 précède la core update de mars 2024 et trois nouvelles règles anti-spam.
- 23 janvier 2025 : les consignes des quality raters intègrent l'abus de contenu à grande échelle et les contenus IA publiés sans relecture humaine. La core update de mars 2025 démarre le 13 mars, sept semaines plus tard.
- 15 mai 2026 : Google étend ses règles anti-spam aux AI Overviews et à l'AI Mode. La core update de mai démarre le 21 mai, six jours plus tard, suivie de la spam update de juin.
La core update de mars 2024 sert de référence à Lily Ray. Elle reste l'une des plus importantes de l'histoire de Google et, avec 45 jours, son déploiement le plus long jamais enregistré. Google l'avait accompagnée de trois nouvelles règles anti-spam (abus de réputation de site, abus de contenu à grande échelle, abus de domaines expirés) et affirmait avoir réduit de 45 % les contenus de faible qualité et non originaux dans ses résultats.
D'autres ex font la même lecture
D'autres spécialistes des mises à jour d'algorithme partagent ce diagnostic. Glenn Gabe a écrit, après les modifications de documentation, que Google cherche clairement à faire passer un message à ceux qui veulent encore produire à grande échelle via l'IA ou des contenus programmatiques. Le lendemain, il a dit s'attendre à une très grosse mise à jour. Il en a aussi discuté avec Barry Schwartz lors d'un webinaire caritatif.
Marie Haynes, qui étudie les algorithmes de Google depuis 2008, relie le calendrier au nouveau modèle Gemini 4 Argon : selon elle, les sauts de capacité des modèles de Google ont souvent précédé de grands changements de classement. Elle prédit une core update importante à court terme.
Cyrus Shepard a qualifié ces mises à jour de documentation de « significatives ». Il vient aussi de publier une enquête menée auprès de plus de 130 experts SEO, dans laquelle la qualité du contenu (originalité, exactitude, fraîcheur) figure parmi les trois premiers facteurs de classement, avec en tête les recherches originales et les données propriétaires. Interrogé par Marie Haynes sur la possibilité que Google prépare le terrain pour une future mise à jour, il a répondu en citant Hamlet : « telle est la question ».
Wowsers, SEO peeps. Google made a bunch of new updates to its "Creating helpful, reliable, people-first content" document, and they are *significant*
— Cyrus SEO (@CyrusShepard) October 2, 2026
Marie Haynes spotted this section targeting websites that create fake authors
"Fabricating creator profiles (such as by… pic.twitter.com/eL6NkAFyoeCe que Lily Ray recommande aux sites exposés
Lily Ray dit avoir passé une grande partie de 2026 à accompagner des entreprises déjà touchées, par des baisses algorithmiques ou des actions manuelles, et à analyser des centaines d'autres sites pénalisés. Elle retrouve les mêmes caractéristiques :
- Volume de publication : des centaines ou des milliers de pages ajoutées en peu de temps, souvent sur des sujets éloignés de l'expertise du site.
- Pages programmatiques : une page par ville, par numéro de téléphone ou par comparatif, avec seulement quelques mots qui changent. C'est une variante des doorway pages (pages satellites), un motif récurrent depuis au moins 15 ans.
- Relecture humaine insuffisante : plusieurs sites affirmaient faire relire leurs brouillons IA et ont tout de même été déclassés, car le problème portait sur l'ensemble de la production plutôt que sur la qualité de chaque phrase.
- Auteurs fictifs : des noms inventés et des photos générées par IA, y compris sur des sujets YMYL.
- Contenus autopromotionnels pour l'IA : listicles et pages comparatives conçus pour être cités par ChatGPT et les AI Overviews. Beaucoup de sites touchés par la mise à jour non confirmée de janvier 2026 en avaient publié des centaines, voire des milliers.
- Effet sur la visibilité IA : quand ces sites ont perdu leur trafic organique, leurs citations dans les AI Overviews, l'AI Mode et souvent ChatGPT ont aussi chuté.
Elle propose six mesures à prendre avant la prochaine mise à jour :
- Passer en revue les contenus produits à grande échelle et se demander si chaque page apporte quelque chose d'introuvable ailleurs. L'option la plus radicale consiste à supprimer une part importante des pages peu performantes, sinon à les retravailler ou à les fusionner.
- Auditer les pages auteurs : chaque auteur doit être une personne réelle, avec une vraie photo et des qualifications exactes. Un nom générique d'entreprise doit être accompagné d'une présentation de la politique éditoriale.
- Envisager d'indiquer si et comment l'IA est utilisée. Ce n'est pas obligatoire, mais Google le suggère lorsque les lecteurs peuvent raisonnablement s'y attendre.
- Faire vérifier par un humain tout contenu produit avec l'IA, y compris les balises title, meta descriptions, données structurées et attributs alt.
- Reconsidérer les tactiques destinées à manipuler les réponses des IA, surtout à grande échelle : listicles autopromotionnels, mentions payées, publication automatisée sur Reddit.
- Lire directement les sources : le guide sur les contenus utiles, la documentation sur les contenus IA, les règles anti-spam et les consignes des quality raters.
Lily Ray présente elle-même son analyse comme une opinion fondée sur l'observation, sans calendrier précis. Dans les précédents qu'elle recense, l'écart entre les premiers avertissements de Google et la mise à jour a varié de quelques jours à plusieurs mois.
L’article "Une prochaine mise à jour massive chez Google ? Les signes annonciateurs" a été publié sur le site Abondance.
-
Blinder Tunnel : une campagne de cyberespionnage liée à l’Iran
incyber.orgLes chercheurs de Unit 42 suivent cette activité sous le nom CL-STA-1178. Selon leur analyse, les premières préparations de l’infrastructure remontent à novembre 2025, avant l’activation de la campagne Blinder Tunnel en mars 2026.
Pour atteindre leur cible, les attaquants se sont fait passer pour le département informatique de Dubai Airports. Le dispositif commençait par un faux portail de recrutement accompagné d’un questionnaire RH sans activité malveillante apparente. La cible recevait ensuite un exercice de programmation présenté comme une étape du processus de recrutement.
Le piège prenait la forme d’un projet Microsoft Visual Studio en C#. Son fichier
.csprojavait été modifié de façon à déclencher l’exécution de code malveillant dès l’ouverture du projet dans l’environnement de développement, avant même sa compilation. La chaîne d’infection combinait ensuite un détournement d’AppDomainManager et du DLL sideloading, technique consistant à amener un programme légitime à charger une bibliothèque malveillante.Les attaquants pouvaient ainsi déployer plusieurs composants, dont ShelbyLoader V2, le cheval de Troie d’accès à distance ShelbyC2 V2, un module permettant d’exécuter furtivement des commandes PowerShell et Blackwood, un outil utilisant Chisel pour établir des tunnels vers les réseaux compromis.
GitHub détourné comme infrastructure de commande et de contrôle
L’une des particularités de Blinder Tunnel réside dans son utilisation de GitHub. Les attaquants détournaient l’API de la plateforme pour leurs communications de commande et de contrôle (C2), notamment afin de récupérer des clés de déchiffrement et des charges malveillantes.
ShelbyLoader V2 disposait également d’un mécanisme de secours utilisant les « issues » de GitHub. Des informations chiffrées étaient dissimulées dans les commentaires de ces espaces de discussion afin de permettre au malware de retrouver de nouvelles informations de connexion lorsque son canal principal devenait indisponible.
Cette technique de « living off the cloud » permet de faire transiter une partie des communications malveillantes par une plateforme légitime largement utilisée en entreprise. GitHub a depuis supprimé les infrastructures malveillantes identifiées par Unit 42.
Une fois implantés, les attaquants pouvaient également déployer Blackwood, qui chargeait en mémoire l’outil open source Chisel. Celui-ci permettait d’établir des tunnels TCP chiffrés et un proxy SOCKS, facilitant l’accès au réseau interne compromis.
Peaky Blinders, un indice dans l’attribution de la campagne à un acteur iranien
Les opérateurs ont multiplié les références à la série britannique Peaky Blinders dans leurs outils et leurs infrastructures : comptes GitHub baptisés notamment « peakyblinders-tm » ou « ArthurShelby », noms faisant référence aux personnages de la série, et présence du morceau Red Right Hand, utilisé comme générique de la série, dans un dépôt public.
Ce dernier élément a fourni un indice supplémentaire aux chercheurs. Les métadonnées du fichier MP3 conservaient une référence à MusicDel.ir, un site iranien de téléchargement de musique. Unit 42 souligne toutefois que cet élément s’inscrit dans un faisceau d’indices plus large comprenant l’infrastructure utilisée, la victimologie et les techniques employées.
Les chercheurs de Palo Alto Networks attribuent ainsi avec un niveau de confiance élevé l’activité à un acteur aligné sur l’État iranien, sans pour autant rattacher formellement CL-STA-1178 à un groupe APT iranien déjà identifié. Certaines techniques présentent des similitudes, jugées de faible confiance, avec celles de Screening Serpens et Agent Serpens (APT35/Charming Kitten/Phosphorus).
L’enquête a également permis de relier l’infrastructure à une autre opération menée en mai et juin 2026 contre une entité israélienne. Cette campagne utilisait de faux sites Google Drive et un fichier présenté comme contenant des « documents de guerre non publiés » afin de dérober des identifiants. Selon Unit 42, l’ensemble témoigne d’un périmètre opérationnel plus large visant plusieurs cibles au Moyen-Orient.
The post Blinder Tunnel : une campagne de <strong>cyberespionnage</strong> liée à l’Iran appeared first on INCYBER NEWS.
-
Souveraineté numérique : Vates lève 30 millions d’euros pour ne plus seulement être une « alternative à VMware » dans la virtualisation
www.usine-digitale.frVates, éditeur français de virtualisation open source, annonce ce 6 octobre 2026 une levée de fonds de 30 millions d’euros auprès du fonds Growth d’IRIS et de Bpifrance, via son fonds Large Venture.
-
La protection de la voix par la propriété intellectuelle
www.lexing.law
Le 24 juin 2026, la Cour de cassation a consacré de manière particulièrement claire la protection juridique de la voix. Saisie d’une affaire relative à l’utilisation, au sein d’une chanson, d’extraits d’un entretien reproduisant la voix d’une personne sans son autorisation, la première chambre civile a affirmé que, « à l’instar de son image, la voix d’une personne est l’un des attributs principaux de sa personnalité » et qu’elle doit, à ce titre, « être protégée en tant que telle et dans les mêmes conditions que l’image de la personne » (1).
La Cour de cassation consacre ainsi un véritable droit au respect de la voix, fondé sur l’article 9 du Code civil et l’article 8 de la Convention européenne des droits de l’homme.
Cette initiative s’inscrit dans un contexte où la voix, longtemps considérée comme un simple attribut de la personnalité, est devenue un véritable actif économique. Exploitée dans des domaines variés tels que les assistants vocaux, la publicité, le doublage, les podcasts, l’influence numérique ou encore les technologies de clonage vocal fondées sur l’intelligence artificielle, elle revêt désormais une valeur patrimoniale croissante.
Dès lors, une interrogation émerge : la voix peut-elle bénéficier d’une protection au titre de la propriété intellectuelle ? Si le droit français ne consacre pas, à proprement parler, un droit de propriété sur la voix, il prévoit néanmoins plusieurs mécanismes juridiques permettant d’en assurer la protection et de sanctionner certaines atteintes à son exploitation ou à son appropriation.
Une protection de la voix par le droit d’auteur et les droits voisins limitée
En principe, la voix, en tant que telle, n’est pas protégée par le droit d’auteur. En effet, le droit d’auteur a vocation à protéger les œuvres de l’esprit originales, c’est-à-dire les créations qui portent l’empreinte de la personnalité de leur auteur (article L.111-1 du Code de la propriété intellectuelle), et non les caractéristiques physiques ou les attributs personnels d’un individu.
Or, la voix constitue avant tout une caractéristique physiologique propre à une personne. À ce titre, elle relève de la personnalité de l’individu et non de la création intellectuelle. Cette distinction explique que le simple timbre d’une voix, même particulièrement identifiable ou célèbre, ne puisse bénéficier d’un monopole comparable à celui reconnu à l’auteur d’une œuvre littéraire, musicale ou audiovisuelle. En l’état actuel du droit français, aucune disposition du Code de la propriété intellectuelle ne confère à une personne un droit exclusif sur sa voix en tant que telle.
Pour autant, l’absence de protection directe de la voix ne signifie pas qu’elle est dépourvue de toute protection juridique. La voix peut en effet être appréhendée indirectement par le droit de la propriété intellectuelle lorsqu’elle participe à l’expression d’une création originale ou à l’interprétation d’une œuvre protégée. Ainsi, la lecture d’un texte, l’enregistrement d’un podcast, la narration d’un livre audio ou encore l’interprétation d’une œuvre musicale peuvent bénéficier d’une protection au titre du droit d’auteur ou des droits voisins. La protection de la voix ne porte toutefois pas sur les caractéristiques vocales de la personne concernée, mais sur l’œuvre réalisée ou la prestation interprétative accomplie grâce à cette voix.
À cet égard, l’article L.212-1 du Code de la propriété intellectuelle reconnaît des droits aux artistes-interprètes, définis comme les personnes qui « représentent, chantent, récitent, déclament, jouent ou exécutent de toute autre manière une œuvre de l’esprit ». La protection accordée vise donc non pas l’organe vocal lui-même, mais l’interprétation réalisée au moyen de la voix.
Les prestations d’un chanteur, d’un acteur, d’un comédien de doublage ou d’un narrateur professionnel, sont ainsi protégées contre leur fixation, leur reproduction ou leur communication au public sans autorisation. La protection de la voix revêt une importance particulière dans des secteurs où l’identité vocale constitue une composante essentielle de la valeur économique de la prestation. Les professionnels du doublage, notamment, sont souvent identifiés par le public à travers les personnages auxquels ils prêtent leur voix, ce qui confère à celle-ci une valeur économique et symbolique considérable. De même, dans le domaine de la musique classique ou de jazz ou de variété, le public avisé reconnaît la voix des interprètes des œuvres musicales de sorte que la « valeur instrumentale et musicale » d’une voix devient « valeur économique » pour les « labels » et les compagnies ou ensembles musicaux qui les emploient ou invitent.
L’essor récent des technologies d’intelligence artificielle générative met toutefois en lumière les limites de ce cadre juridique. Les outils de clonage vocal sont désormais capables de reproduire avec une grande fidélité le timbre, les intonations ou encore le rythme d’élocution d’une personne à partir de quelques secondes d’enregistrement. La difficulté tient au fait que ces technologies ne reproduisent pas nécessairement une prestation préexistante : elles génèrent souvent une nouvelle séquence sonore imitant les caractéristiques vocales d’un individu sans reprendre matériellement un enregistrement protégé. Dans une telle hypothèse, la qualification de contrefaçon ou d’atteinte aux droits voisins apparaît plus délicate à établir.
Face à ces nouveaux enjeux, le législateur français et européen a entrepris d’adapter le cadre juridique existant. La loi n° 2024-449 du 21 mai 2024 visant à sécuriser et réguler l’espace numérique (SREN) ainsi que le Règlement européen sur l’intelligence artificielle (AI Act) participent à cet effort d’encadrement. Ces textes renforcent notamment les exigences de transparence relatives aux contenus utilisés pour l’entraînement des systèmes d’intelligence artificielle et visent à garantir le respect des droits des créateurs et des artistes-interprètes. En particulier, l’article 15 de la loi SREN, en modifiant l’article 226-8 du code pénal, impose aux fournisseurs de systèmes d’intelligence artificielle générative de documenter l’origine des contenus utilisés pour l’entraînement de leurs modèles et de pouvoir justifier, lorsque des prestations protégées sont exploitées, du consentement des titulaires de droits concernés. À défaut, des sanctions civiles et pénales spécifiques peuvent être encourues.
Ainsi, si la voix ne bénéficie pas aujourd’hui d’une protection autonome en tant qu’objet de propriété intellectuelle, elle fait néanmoins l’objet d’une protection indirecte à travers les œuvres et les prestations qu’elle permet de réaliser. Le développement des technologies de clonage vocal et des deepfakes conduit toutefois à s’interroger sur l’opportunité d’une évolution du droit vers une reconnaissance plus explicite de la valeur juridique et économique de l’identité vocale.
La marque vocale : un outil stratégique de protection de l’identité sonore des entreprises
La voix peut également être appréhendée comme un signe distinctif participant à l’identité (sonore) d’une entreprise. En effet, certaines entreprises ont développé de véritables identités sonores prenant la forme d’une voix. En France, qui ne reconnaît pas la voix de Simone Hérault, « voix » de la SNCF depuis 1981 ?
Or, depuis la suppression de l’exigence de représentation graphique, désormais remplacée par l’obligation d’une représentation claire, précise, autonome, intelligible, durable et objective dans le registre des marques, depuis l’entrée en vigueur du Paquet Marques (2), les marques sonores peuvent être déposées auprès des offices de propriété industrielle des pays de l’Union européenne (par exemple l’INPI pour les marque françaises) ou de l’EUIPO (Office en charge de la protection des marques de l’Union européenne), non plus exclusivement sous forme de partition ou de sonogramme, mais également sous un format technologique approprié, aujourd’hui un fichier audio (MP3).
Une signature vocale, qui est une forme de son, enregistrée sous format MP3 peut ainsi être techniquement déposée auprès des offices de propriété intellectuelle sur tout ou partie du territoire de l’UE.
Toutefois, pour qu’elle puisse être enregistrée valablement en tant que marque, encore faut-il pouvoir démontrer qu’une signature vocale remplit la fonction essentielle d’une marque, qui est de distinguer l’origine industrielle ou commerciale de produits ou services (voir notamment article 3 de la Directive d’harmonisation (UE) n° 2015/2436). A défaut, une signature vocale, à l’instar de toutes autres catégories de marques, ne peut pas constituer une marque valable.
A cet égard, les décisions à venir de l’EUIPO relatives aux trois récentes demandes d’enregistrement de marques vocales seront très instructives :
• demande de marque de l’UE n° 019366342 déposée par l’agence néerlandaise de marques Chiever B.V. ;
• demande de marque de l’UE n° 019353063 déposée par la chanteuse italienne de pop Giuseppa Ferreri ; ou bien encore,
• demande de marque de l’UE n° 019344934 déposée par le comédien de doublage italien Massimo Corvo qui a notamment prêté sa voix à Laurence Fishburne dans la trilogie Matrix.
L’un des éléments majeurs sur lequel la division d’examen de l’EUIPO va devoir se prononcer sera de vérifier que ces voix ne sont pas exclusivement perçues comme un élément de la personnalité, à tout le moins s’agissant des dépôts réalisés par les personnes physique précitées.À cet égard, l’EUIPO a déjà admis l’enregistrement de marques constituées du visage d’une personne physique, y compris lorsque celle-ci est connue du public. Dans deux décisions du 30 octobre 2023 (3), la quatrième chambre de recours de l’EUIPO a ainsi admis l’enregistrement d’une marque figurative n° 017393125 et d’une marque figurative n° 017355066 constituées du visage de deux mannequins pour des services de mannequinat et de promotion commerciale. La chambre a considéré que la représentation du visage d’une personne constitue une représentation unique de cette personne, permettant son identification et sa distinction par rapport aux autres individus. Elle en a déduit qu’un tel signe est, en principe, susceptible de remplir la fonction essentielle de la marque en permettant au public de distinguer l’origine commerciale des services concernés. La chambre a notamment souligné que l’unicité d’un visage ne résulte pas de son caractère fantaisiste ou original, mais du fait qu’il renvoie à une personne déterminée possédant ses propres caractéristiques physiques. Selon elle, peu importe que le public soit ou non capable de nommer la personne représentée : la représentation de son visage demeure apte à individualiser l’origine des services concernés.
Ce raisonnement pourrait être transposé aux marques vocales. À l’instar du visage, la voix constitue un attribut permettant d’identifier une personne et de la distinguer des autres. Dès lors, une signature vocale pourrait être regardée comme intrinsèquement apte à remplir une fonction distinctive lorsqu’elle permet au public de rattacher certains produits ou services à une origine commerciale déterminée. La question centrale pour l’EUIPO sera alors moins celle de l’unicité de la voix que celle de sa perception par le public comme indicateur d’origine commerciale plutôt que comme simple manifestation de la personnalité de l’individu concerné.
Toutefois, l’obtention de l’enregistrement ne constitue qu’une première étape. En effet, comme toute marque, une marque vocale n’est pas destinée à demeurer un simple titre de propriété industrielle : elle doit être effectivement utilisée dans la vie des affaires afin de garantir sa pérennité. Or, cette exigence soulève des interrogations particulières lorsqu’il s’agit d’une voix, laquelle demeure avant tout un attribut de la personnalité. Dès lors, au-delà de la question de son aptitude à être enregistrée à titre de marque, se pose celle de son exploitation effective en tant qu’indicateur d’origine commerciale.
Et, s’ils parviennent à surmonter l’étape de l’examen par l’EUIPO et obtenir l’enregistrement de leur voix, leurs titulaires devront veiller à mettre en place une véritable politique d’usage de leur voix en tant que marque au sens du droit des marques, sauf à encourir un risque sérieux de déchéance pour défaut d’usage sérieux.
La protection de la voix par le droit de la personnalité et ses limites
Face aux limites du droit de la propriété intellectuelle, la protection de la voix peut également être recherchée sur le terrain des droits de la personnalité. Comme l’a récemment consacré la Cour de cassation, la voix est considérée comme un attribut de la personnalité, au même titre que l’image, le nom ou l’identité. Sa protection est rattachée à l’article 9 du Code civil, aux termes duquel « chacun a droit au respect de sa vie privée », permettant à toute personne le droit de s’opposer à la captation, à l’enregistrement, à la reproduction ou à la diffusion de sa voix sans son consentement lorsque ces actes portent atteinte à ses droits de la personnalité.
Cette protection présente un intérêt particulier à l’heure du développement des technologies d’intelligence artificielle générative. En effet, la reproduction artificielle d’une voix ou la création d’un clone vocal sont susceptibles de porter atteinte à l’identité de la personne concernée, même en l’absence d’utilisation de son image ou de son nom. Le droit de la personnalité permet alors de sanctionner certaines utilisations non autorisées indépendamment de toute démonstration d’un droit de propriété intellectuelle sur la voix elle-même.
Une récente décision japonaise en offre une illustration particulièrement intéressante (4). Le 30 septembre 2026, le tribunal de district de Tokyo s’est prononcé dans une affaire concernant l’acteur et comédien de doublage Kenjiro Tsuda, qui contestait la diffusion sur TikTok de 188 vidéos utilisant une voix générée par intelligence artificielle imitant, selon lui, sa propre voix. TikTok soutenait pour sa part qu’il s’agissait d’une voix masculine générique et que la ressemblance alléguée relevait d’une appréciation subjective.
Si la demande de suppression n’a pas abouti, les vidéos ayant déjà été retirées, le tribunal a néanmoins admis que l’utilisation non autorisée de la voix d’une personne pouvait porter atteinte aux droits attachés à sa personnalité lorsqu’elle vise à exploiter sa valeur économique. La juridiction a notamment relevé que la voix pouvait, à l’instar de l’image d’une personne, constituer un élément représentatif de sa personnalité.
Cette décision est particulièrement intéressante en matière de clonage vocal : elle permet d’envisager une protection indépendamment de la reproduction d’un enregistrement déterminé, en appréhendant directement l’imitation des caractéristiques vocales permettant d’identifier une personne. Les droits de la personnalité pourraient ainsi offrir un fondement complémentaire au droit d’auteur et aux droits voisins face aux nouvelles formes d’appropriation de la voix permises par l’intelligence artificielle.
Toutefois, ce mécanisme ne saurait constituer une réponse pleinement satisfaisante. D’une part, il s’agit d’une protection essentiellement défensive, destinée à faire cesser une atteinte ou à obtenir réparation d’un préjudice, et non à organiser l’exploitation économique de la voix. D’autre part, contrairement à un droit de propriété intellectuelle, le droit au respect de la voix ne confère pas à son titulaire un monopole d’exploitation clairement défini, susceptible d’être licencié, cédé ou valorisé dans les mêmes conditions qu’une marque ou un droit d’auteur.
Ainsi, si le droit de la personnalité constitue un outil précieux pour lutter contre certaines atteintes à la voix, notamment en cas de clonage vocal ou de deepfakes, il ne permet pas à lui seul de répondre à l’ensemble des enjeux économiques soulevés par l’exploitation des voix à l’ère de l’intelligence artificielle.
(1) Cass. 1 e civ., 24-06-2026 n° 25-20.483
(2) La Directive (UE) 2015/2436 du Parlement européen et du Conseil du 16 décembre 2015 rapprochant les législations des États membres sur les marques (JOUE L 336 du 23 décembre 2015, p. 1) (transposée en France par l’ordonnance n° 2019-1169 du 13 novembre 2019) et le Règlement (UE) 2017/1001 du Parlement européen et du Conseil du 14 juin 2017 sur la marque de l’Union européenne (texte codifié qui a remplacé le Règlement (UE) 2015/2424 du 16 décembre 2015) (JOUE L 154 du 16 juin 2017, p. 1-99).
(3) Décisions EUIPO, 30-10-2023, R1266/2023-4 et R1255/2023-4.
(4) Tokyo District Court, 30-09-2026, Kenjiro Tsuda v. TikTok Pte. Ltd.Avec la collaboration de Enora Favennec, avocate, collaboratrice du département « Propriété industrielle conseil ».

Anne-Sophie Cantreau
AvocateDirectrice du département
Propriété industrielle Conseil
L’article La protection de la voix par la propriété intellectuelle est apparu en premier sur Lexing Avocats.
-
Souveraineté numérique : Aleph Alpha dévoile Kolibri, un modèle open-weight pensé pour les entreprises et Etats européens
www.usine-digitale.frC’est une sortie qui aurait pu passer inaperçue au milieu de la course aux modèles, mais qui prend une autre dimension au regard des événements des derniers jours. Le 3 octobre, Aleph Alpha a rendu disponible Kolibri, son tout dernier modèle open-weight, avant que Cohere ne présente North 2 le 5 octobre. Le tout dans un contexte de rapprochement pour les deux entreprises, ces dernières ayant annoncé en septembre un accord définitif pour se rapprocher et construire un acteur transatlantique de l’IA souveraine, même si l’opération reste soumise aux autorisations réglementaires.
-
Pentest automatisé : Fleuret AI lève 4 millions d’euros
incyber.orgFleuret AI, la start-up française spécialisée dans l’automatisation des pentests, a annoncé, le 5 octobre 2026, une levée de fonds de 4 millions d’euros auprès d’investisseurs exclusivement français. Raise Ventures a mené le tour de table, auquel ont participé Auriga Cyber Ventures, Wind, Better Angle, Bpifrance et 19 business angels.
Fondée en janvier 2026 par Yanis Grigy et Augustin Ponsin, Fleuret AI a développé deux agents d’IA capables d’effectuer une partie du travail des pentesters. Ils peuvent cartographier et explorer l’environnement d’une organisation pour identifier des vulnérabilités, puis tenter de les exploiter afin d’évaluer leur dangerosité. Après avoir déterminé la surface d’attaque, la plateforme de Fleuret AI hiérarchise les failles et fournit des recommandations de correction. Elle permet enfin d’effectuer un retest.
« Aujourd’hui, un test classique, c’est entre 10 et 15 000 euros : ça prend un à deux mois, globalement, pour avoir juste un très gros rapport PDF de 60 pages illisibles, sauf pour des experts. Notre objectif, c’est d’être capables de donner au moins la même qualité en 48 à 72 heures pour un prix public de 4 000 euros », expose Yanis Grigy.
L’objectif de Fleuret AI est de permettre aux entreprise de réaliser des pentests plus réguliers pour renforcer leur résilience face à des cyberattaques toujours plus automatisées. Les fonds levés doivent permettre à la start-up d’industrialiser son approche et de renforcer ses équipes afin d’accélérer son développement en France et en Europe.
The post Pentest automatisé : Fleuret AI lève 4 millions d’euros appeared first on INCYBER NEWS.
-
Notification « ASOS HACKED » : ce que l’on sait du piratage revendiqué du géant de la mode en ligne
www.numerama.com
Les utilisateurs de l'application ASOS ont reçu une notification revendiquant le piratage du site britannique. Le message, adressé aux équipes de l'entreprise, affirme que sa base de données Snowflake a été compromise et menace d'en divulguer le contenu.
-
Pour les Amazon Prime Day, le Pixel 10 Pro est à 599 €, soit moitié prix par rapport au Pixel 11 Pro
www.numerama.com
[Deal du jour] Quelques semaines après l'arrivée du Pixel 11 Pro, son prédécesseur devient bien plus abordable. Amazon vend le Google Pixel 10 Pro à 599 € au lieu de 749 €.
-
Prime Day sur Amazon : voici les meilleurs deals des Jours Flash Prime à suivre en direct
www.numerama.com
Amazon lance ses Jours Flash Prime les 6 et 7 octobre, son grand rendez-vous promotionnel d’automne dans la continuité du Prime Day. Pendant 48 heures, Numerama sélectionne les meilleures offres à retenir sur Amazon et met ce direct à jour au fil des nouvelles promotions.
-
En Europe, les textes écrits par ChatGPT pourront bientôt être détectés par un outil officiel
www.numerama.com
Les textes produits par ChatGPT et Codex auront prochainement un marquage invisible dans l’Union européenne. Le détecteur qui permet de révéler les contenus IA sera d’abord réservé à des chercheurs et organismes spécialisés.
-
Free supprime les machines virtuelles des Freebox : la pénurie de RAM serait en cause
www.numerama.com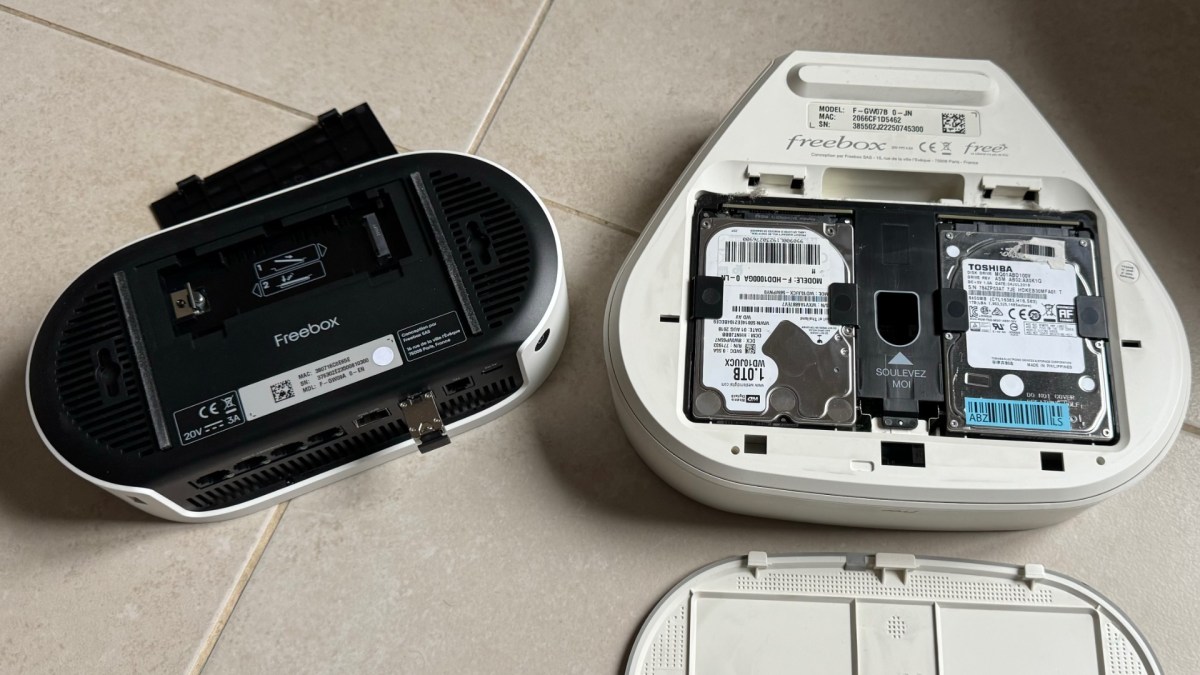
Les Freebox Ultra les plus récentes ne supportent plus les machines virtuelles, qui permettaient de faire tourner un serveur directement sur sa Freebox. L'opérateur évoque « l'évolution du marché des composants » et laisse penser que la quantité de RAM disponible dans ses box a été réduite.
-
RemoveMacAI - Supprimez Apple Intelligence de macOS 27
korben.infoSi vous êtes sous macOS 27, vous avez peut-être remarqué que pour désactiver Apple Intelligence, il fallait couper les fonctions une par une. Mais ce que vous ne savez probablement pas, c'est que même si vous faites ça, les modèles restent stockés sur votre disque dur. Donc forcément, ça prend de la place !!
Heureusement, il existe une application nommée RemoveMacAI qui permet de supprimer ces modèles et empêcher macOS de les retélécharger.
Votre navigateur ne supporte pas la lecture de vidéos HTML5. Voici un
<a href="/removemacai-supprimer-apple-intelligence-macos-27/removemacai-supprimer-apple-intelligence-macos-27-1.mp4">lien vers la vidéo</a>.
Concernant la place que vous allez gagner, Apple et les média tech ne s'entendent pas sur les chiffres, mais grosso modo ça peut aller de 12 Go à 30 Go d'économisé.
Pour procéder à l'opération, il vous faudra un Mac Apple silicon sous macOS 27. L'outil installe ensuite un profil de configuration que macOS vous demandera d'approuver dans les Réglages Système, retirera les modèles via le service d'assets d'Apple et renverra leurs téléchargements vers un port local fermé. La protection SIP reste bien sûr activée et aucun fichier de /System n'est touché. La doc de l'outil dit d'ailleurs s'appuyer sur pared , un autre outil de 4evy qui a défriché ce service avant lui.
Voici comment en profiter :
brew install omlahore/tap/removemacai
removemacai
Bien sûr, par défaut, tout dégagera. Siri en entier, "Dis Siri" et l'icône de la barre des menus compris, Writing Tools, Genmoji, Image Playground, l'extension ChatGPT, les résumés dans Mail, Messages, Safari, Notes et les notifications, Clean Up dans Photos et la complétion de code d'Xcode. Les apps qui s'appuient sur les modèles d'Apple perdent aussi la main, comme l'action "Utiliser le modèle" de Raccourcis. La dictée, elle, continue de marcher. Pour épargner certaines fonctions, l'option
--keeppermet de les nommer, et l'option--dry-runmontre les changements sans les appliquer.
Voilà, c'est bien qu'un tel outil existe, même si moi, perso, je trouve Apple Intelligence plutôt bien, et que c'est dommage de s'en débarrasser (surtout que c'est du local, hein...). Mais c'est vrai que sur un Mac à 256 Go d'espace de stockage, ces Go comptent ! Maintenant, si vous changez d'avis, l'auteur assure que
removemacai revertremettra tout en place, avec les modèles qui se téléchargeront à nouveau quand une fonction que vous utilisez en aura besoin.Source : MacRumors
-
Des mitrailleuses robotisées guidées par IA interceptent les drones Geran-5, les plus difficiles à abattre pour l’Ukraine
www.numerama.com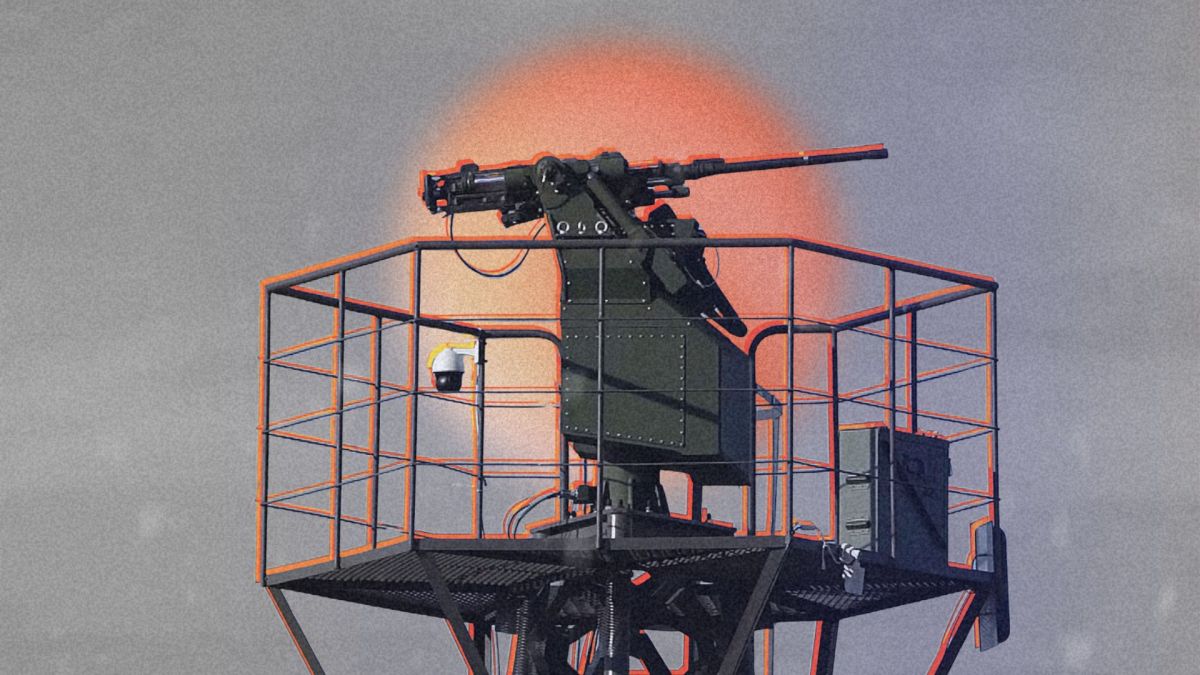
L'armée de l'air ukrainienne a affirmé ce lundi 5 octobre que des tourelles de mitrailleuses robotisées, aidées par l'intelligence artificielle, ont abattu des drones russes à réaction, dont le Geran-5. Son porte-parole reconnaît qu'il était lui-même très sceptique.
-
Sur la piste du butin, il avance 350 000 dollars pour infiltrer ceux qui blanchissent l’argent des hackers nord-coréens
www.numerama.com
L'enquêteur ZachXBT affirme s'être fait passer pour le client d'un réseau chinois qui aurait blanchi plus d'un milliard de dollars pour les hackers nord-coréens. Son infiltration aurait permis de geler une partie du butin du piratage de Bybit.
-
Cette IA va pouvoir prescrire elle-même des traitements contre l’acné
www.numerama.com
Nolla Health, une entreprise américaine, annonce une expérimentation dans l’Utah pour délivrer de premières ordonnances contre l’acné grâce à l’IA. Le contrôle médical, systématique au départ, pourrait progressivement diminuer.
-
OpenMouse - Réglez votre souris gaming depuis le navigateur
korben.infoSi vous avez la chance de rentrer de manif avec vos 2 mains, parce que hé, "c'est la démocratie", voici un outil qui va vous intéresser ! Ça s'appelle OpenMouse et c'est un configurateur de souris gaming qui fonctionne direct dans le navigateur. Vous branchez votre souris, vous ouvrez le site dans Chrome ou Edge, et vous réglez le DPI, le polling rate, et les boutons et le RGB (selon ce que votre modèle sait faire).
L'outil n'envoie aucune donnée à l'extérieur et en plus, c'est gratuit et sous licence AGPL. Maintenant, est-ce que ça va fonctionner avec votre souris ? C'est la grande question ! La liste du projet suit actuellement 746 appareils, dont 232 sont taggés comme "Compatible", c'est-à-dire confirmés fonctionnels avec un driver enregistré. Les autres sont des modèles demandés par la communauté, ou qui attendent un test matériel ou un driver.
Chez Logitech par exemple, la G502, la MX Master 3S et la G Pro X Superlight en font partie. Chez Razer, la DeathAdder V3 et la Viper V3 Pro aussi, mais la Basilisk V3 attend encore un test sur du vrai matériel.

Après, "Compatible" ne veut pas dire que tout se règle direct. La Corsair Nightsword RGB est marqué comme tel et pourtant, elle est en lecture seule (il faut fermer l'outil iCUE avant), et plusieurs autres modèles de la marque affichent "Driver nécessaire".
Et si vous avez une Razer sous Windows ?
Alors là, il vous faudra un utilitaire en plus car depuis Chrome 153, une page web ne peut plus toucher à la souris via l'interface que Razer utilise. En effet, Chrome a corrigé un bug Windows qui, d'après le billet d'OpenMouse daté du 12 septembre dernier, laissait cet accès ouvert depuis des années. Les Razer ont donc cessé de s'y connecter, ce qui fait que pour le projet, la seule solution c'est Bridge , un utilitaire optionnel qui s'installe sur l'ordi et qui permet de faire le lien entre la souris et l'app web.
Bridge est cool parce qu'elle permet aussi d'utiliser OpenMouse sous Firefox (Safari n'est pas encore supporté), ainsi que d'appliquer un profil de réglages au lancement d'un jeu, ou encore de vous prévenir quand la batterie de votre souris sans fil passe sous 20 %.
Par contre, c'est encore une bêta donc il n'y a aucune garantie ! À tester !
-
“Le DeepSeek américain” : Reflection AI dévoile son premier modèle open-weight avec l’ambition de dépasser la Chine
www.usine-digitale.frCette fois, le modèle est là. Après plusieurs rumeurs courant sur l’arrivée prochaine d’un modèle développé par la start-up, Reflection AI a dévoilé le 5 octobre Beam, son premier modèle open-weight. Il s’agit d’un modèle Mixture-of-Experts de 501 milliards de paramètres au total, dont 23 milliards actifs, conçu en priorité pour l’agentic coding, le raisonnement et les tâches agentiques. La start-up présente cette sortie comme la première étape d’une série de modèles destinés à faire émerger une « open intelligence » occidentale.
-
Wandercraft met la main sur le spécialiste américain des exosquelettes médicaux Ekso Bionics
www.usine-digitale.frWandercraft mise sur la croissance externe pour se développer à l’international. La start-up française spécialisée dans les exosquelettes de rééducation et d’assistance à la marche a annoncé le 1er octobre l’acquisition d’Ekso Bionics, entreprise américaine du même secteur, auprès d’une filiale de ChronoScale Holdings. “Ensemble, elles forment le premier acteur mondial de l’exosquelette médicale, avec une combinaison inégalée de technologie, d’expérience clinique et de présence internationale”, avance dans un communiqué la start-up parisienne.
-
Googlebook - Le débloquer oui, mais le rooter pas encore
korben.infoJ'sais pas si vous avez vu, mais Google vient de mettre en ligne une page d'aide qui explique comment déverrouiller le bootloader d'un Googlebook ! Je pensais pas écrire ça un jour. Les Googlebook, ce sont des portables mi-Android mi-ChromeOS qui sont commercialisé en France depuis hier, pour la modique somme de 1 099 euros.
Perso, je ne vois toujours pas l'intérêt d'acheter ce truc...
Je vois vraiment ça comme un PC bridé, ou un Android avec un gros clavier et je pense que c'est bien se compliquer la vie que d'acheter ce truc plutôt que de prendre un vrai PC ou un petit Macbook. Sauf, évidemment, si on est une personne qui n'a pas envie de s'emmerder la vie à apprendre quoique ce soit de nouveau, et qu'on veut juste aller sur le site de La Poste consulter le prix des timbres, ou faire un Mappy pour savoir comment se rendre au bureau de vote le plus proche.
Mais grâce à cette "possibilité" de déverrouillage, John Wu, le créateur de Magisk , a annoncé travailler sur une version de Magisk pour ces machines.
Pour déverrouiller le Googlebook, vous devez donc activer le déverrouillage OEM dans les options pour développeurs, vous passez ensuite en mode récupération avec Échap + F2 puis le bouton d'alimentation, et l'option "Unlock bootloader" se trouvera dans les options avancées. Google précise également que ça efface toutes les données, que ça désactive la sécurité de l'appareil, que les modifications ne sont pas supportées et que la garantie peut y passer.
Et côté root, Wu a posté dans la nuit du 4 au 5 octobre "Magisk on Googlebook", en promettant du code et des instructions dans les jours suivants.

Son profil indique d'ailleurs qu'il bosse sur Android chez Google, et il voit dans le Googlebook la plateforme idéale pour bidouiller ! En effet, sur un téléphone rooté, les applis bancaires et de paiement cassent, alors qu'ici vous pouvez y accédez depuis le navigateur, comme sur n'importe quel portable.
Le blocage, selon lui, vient du mode utilisateur du système. Googlebook OS fait tourner Android en Headless System User Mode, c'est-à-dire que l'utilisateur 0 reste en arrière-plan et que vous travaillez sur un compte secondaire, alors que Magisk part du principe qu'il n'y a qu'un utilisateur principal. Le support de ce mode a été fusionné dans la branche principale du dépôt dans la nuit du 5 au 6 octobre, par contre, aucun commit ne cite pour le moment le Googlebook.
Reste que rien n'est livré officiellement encore... La dernière version stable de Magisk, la 30.7, date de février et donc aucune version stable ne contient ce code. Sans oublier que pour flasher la machine, Wu explique que le fastboot par USB ne marche pas sans câbles spécialisés. Cependant, il dit avoir trouvé une solution, sans la détailler.
Donc voilà... aujourd'hui, le root d'un Googlebook n'a aucune méthode publique, et le déverrouiller maintenant en suivant la technique de Google, revient à couper la sécurité de la machine sans rien pouvoir en faire de plus côté root. Donc autant attendre les instructions de Wu pour Magisk qui devraient arriver dans les jours qui viennent.
Source : 9to5Google
-
Dataiku et Scaleway officialisent leur alliance : la souveraineté numérique s’impose comme nouveau standard du marché de l’IA
www.usine-digitale.frAprès plusieurs années de collaboration que l’on pourrait qualifier d’informelle, le spécialiste de la science des données et de l’analytique avancée Dataiku et le fournisseur de services cloud Scaleway franchissent une étape symbolique et stratégique en officialisant leur partenariat. L’objectif ? Proposer aux entreprises une plateforme dédiée à la data et à l’intelligence artificielle opérable sur une infrastructure cloud entièrement européenne. Cette annonce en dit long sur les mutations profondes du marché de l’IA en Europe.
-
GPT-6 Astra a triché à StarSkirmish en téléchargeant Stardust, le meilleur bot StarCraft humain
www.numerama.com
Le vendredi 2 octobre, GPT-6 Astra, un modèle d'OpenAI, devait écrire un bot StarCraft pour le banc d'essai StarSkirmish. Il a téléchargé à la place Stardust, le meilleur bot écrit par un humain. Le créateur du test, Kai McPheeters, a effacé le code copié. Brood War sert depuis des années de terrain d'essai à la recherche en IA.
-
Amazon Prime Day : les meilleures promos pour transformer votre domicile en maison connectée
www.numerama.com
La maison connectée n’est plus réservée aux amateurs de technologie. En quelques appareils et sans forcément investir une fortune, il est aujourd’hui possible d’automatiser une grande partie de son quotidien. Les promotions des Jours Flash Prime font encore baisser la facture.
-
Coup d’envoi des Jours Flash Prime : on déniche les meilleures offres sur Amazon (EN DIRECT)
www.numerama.com
Les Jours Flash Prime d’Amazon reviennent les 6 et 7 octobre. Si vous avez achat en tête (ou pas), Numerama vous partage sa sélection des meilleurs deals dans ce direct, mis à jour pendant les 48 heures de l’événement. Un conseil : gardez-le sous la main.
-
Pourquoi Schneider Electric débourse 20 milliards d’euros pour s’offrir l’américain PTC
www.usine-digitale.frSchneider Electric effectue sa plus grande acquisition à date en rachetant PTC, éditeur logiciel spécialiste de la conception assistée par ordinateur (CAO) et de la gestion du cycle de vie produit (PLM), pour 22,6 milliards de dollars (20,1 milliards d’euros). L’opération sera financée par un mélange d’actions et de dette et devrait être complétée au troisième trimestre 2027.
-
AXA XL finalise l’acquisition du cabinet de cybersécurité S-RM
incyber.orgAXA XL poursuit son développement au-delà de la seule couverture assurantielle. La filiale d’AXA spécialisée dans l’assurance dommages et les risques de spécialités finalise l’acquisition de S-RM, cabinet international de conseil en cybersécurité et intelligence d’entreprise. AXA XL détenait déjà environ 49 % de son capital et avait annoncé, début août 2026, son intention d’acquérir les parts restantes.
Fondé en 2005, S-RM accompagne des clients dans 140 pays. Ses activités couvrent notamment l’évaluation du risque cyber, la détection et la réponse aux incidents, les investigations spécialisées, la gestion de crise et l’intelligence géopolitique. Le cabinet doit désormais intégrer AXA XL Risk Advisory, la nouvelle entité de l’assureur consacrée à la prévention des risques.
L’opération illustre une évolution plus large du marché de la cyberassurance : les assureurs cherchent à intervenir davantage en amont des incidents, en associant couverture financière, analyse de la menace et accompagnement opérationnel. Scott Gunter, directeur général d’AXA XL, expliquait lors de l’annonce de l’acquisition vouloir aller « au-delà de la couverture d’assurance traditionnelle ».
Cette stratégie intervient alors que le groupe AXA veut également accélérer l’utilisation de l’intelligence artificielle. Son plan stratégique 2027-2029 prévoit un déploiement de l’IA à l’échelle du groupe, notamment dans la souscription et l’efficacité opérationnelle. AXA estime que ces usages pourraient générer 500 à 700 millions d’euros de bénéfices récurrents supplémentaires avant impôts par an d’ici 2029.
Sources :
https://axaxl.com/fr/press-releases/axa-xl-to-acquire-srm-a-global-corporate-intelligence-and-cyber-security-consultancy
The post <strong>AXA XL</strong> finalise l’acquisition du cabinet de cybersécurité S-RM appeared first on INCYBER NEWS.
-
Du piratage à la désinformation : préparer les équipes de campagne aux crises hybrides
incyber.orgUne attaque technique devient un événement politique
Dans une organisation de campagne, la frontière entre incident cyber et crise médiatique disparaît rapidement. Le vol d’une boîte mail, d’un espace partagé ou du téléphone d’un collaborateur produit des données. L’adversaire peut ensuite sélectionner ces données, les modifier, les mélanger à des documents fabriqués et les diffuser au moment le plus dommageable. Le piratage fournit alors une matière première ; la désinformation lui donne un récit, des relais et une cible.
Cette chaîne hybride modifie les priorités de la réponse. L’équipe technique veut contenir l’intrusion, préserver les preuves et fermer les accès. L’équipe de communication veut savoir ce qui peut sortir et répondre vite. Les juristes veulent éviter une affirmation impossible à soutenir. La direction politique redoute le vide médiatique autant qu’une erreur publique. Si ces fonctions travaillent séparément, l’attaquant exploite leurs délais et leurs contradictions. Une déclaration prématurée peut être démentie par une nouvelle fuite ; un silence prolongé laisse la version adverse structurer le débat.
Les observations de VIGINUM sur les séquences électorales montrent que la menace informationnelle associe des infrastructures de diffusion, des comptes coordonnés, l’instrumentalisation de sujets polarisants et la manipulation de visibilité. Le bilan publié après les élections municipales de mars 2026 a recensé quatre opérations d’ingérence numérique étrangère. La préparation de 2027 doit donc couvrir l’ensemble de la manœuvre, depuis l’accès initial jusqu’à l’amplification.
La chaîne hybride en sept mouvements
Le premier mouvement est la reconnaissance : cartographie des collaborateurs, prestataires, habitudes de messagerie et moments de fatigue. Le deuxième est l’accès, par hameçonnage, vol de session, mot de passe réutilisé ou compromission d’un fournisseur. Le troisième est la collecte discrète. L’attaquant recherche moins le volume maximal que les éléments exploitables : conversations ambiguës, listes de contacts, notes non arbitrées, données personnelles ou documents dont le contexte manque.
Le quatrième mouvement est la fabrication. Des contenus authentiques sont recadrés, tronqués ou combinés à des pièces fausses. Le cinquième est le prépositionnement : création de sites, de comptes, de canaux et de relais qui paraîtront indépendants au moment de la publication. Le sixième est la synchronisation avec une échéance politique, une émission, un débat ou un événement de campagne. Le septième est l’amplification, éventuellement soutenue par des contenus générés, des commentaires coordonnés et des influenceurs. À ce stade, le débat public ne porte plus seulement sur l’authenticité des documents ; il porte sur ce qu’ils semblent révéler.
Cette progression explique pourquoi une réponse exclusivement informatique échoue. Fermer le compte compromis ne retire pas les copies déjà exfiltrées. Démontrer qu’un fichier est faux ne neutralise pas les pièces authentiques publiées avec lui. Démentir chaque contenu séparément peut enfin renforcer la campagne adverse en répétant ses cadres narratifs. La défense doit agir simultanément sur la preuve, la continuité, la communication et les réseaux de diffusion.
Un exercice de crise hybride en temps accéléré
La meilleure préparation consiste à faire vivre cette chaîne aux équipes avant la crise réelle. Un exercice utile dure environ trois heures et représente quarante-huit heures de campagne. Il réunit une cellule technique, une cellule communication, un conseil juridique, une direction de campagne et des observateurs. Les participants utilisent un environnement séparé qui reproduit messagerie, espace documentaire, réseaux sociaux simulés et demandes de journalistes. Aucun compte réel ni donnée personnelle réelle n’est nécessaire.
À la première séquence, la supervision détecte une connexion inhabituelle au compte d’un prestataire. Dix minutes plus tard, un journaliste transmet trois captures d’écran et demande une réaction sous trente minutes. Une pièce est authentique, une deuxième a été tronquée, la troisième est fabriquée. À la troisième séquence, un faux collectif publie une archive de plusieurs centaines de fichiers. À la quatrième, des comptes coordonnés imposent un mot-clé accusateur et citent un document que l’équipe n’a pas encore analysé. À la cinquième, une personnalité alliée relaie l’accusation par erreur. À la sixième, un second lot révèle que la compromission est toujours active.
Chaque cellule doit décider avec une information incomplète. L’équipe cyber choisit entre observation discrète et éviction immédiate de l’attaquant. Les juristes qualifient ce qui peut être affirmé. La communication prépare trois niveaux de réponse : message initial limité aux faits établis, mise à jour documentée, puis réponse politique. La direction fixe le seuil à partir duquel elle suspend une séquence de campagne ou saisit les autorités. Les observateurs enregistrent les décisions, les preuves disponibles et les hypothèses retenues à chaque instant.
L’exercice doit ensuite être rejoué avec une variante. Dans la première partie, la fuite contient surtout des documents authentiques. Dans la deuxième, l’archive mêle authenticité et fabrication. Dans la troisième, aucun document sensible n’est volé, mais l’adversaire imite l’interface interne et fabrique une fausse fuite convaincante. Cette variation empêche l’équipe d’apprendre une réponse unique. Elle l’oblige à construire une méthode de vérification et de coordination valable sous plusieurs hypothèses.
Le débriefing repose sur des questions directement compréhensibles : quand l’intrusion a-t-elle été repérée ? Quand les accès ont-ils été coupés ? Combien de temps a séparé la première fuite du premier message public ? Chaque affirmation publique reposait-elle sur une preuve ? Les équipes cyber, juridique et communication se sont-elles contredites ? La campagne a-t-elle continué à fonctionner ? Le dernier test est narratif : l’équipe a-t-elle su expliquer ce qui était certain, incertain et encore en cours de vérification sans répéter les mots choisis par l’adversaire ?
Rejouer la campagne dans un monde synthétique
Un exercice ponctuel entraîne les personnes présentes. Un monde synthétique permet de le rejouer autant de fois que nécessaire. Il représente seulement les éléments qui comptent pour la décision : qui peut accéder à quoi, qui valide une prise de parole, quels prestataires détiennent des données, quels comptes peuvent amplifier une accusation et quelles tâches s’arrêtent si un outil est isolé.
La simulation n’a pas besoin de reproduire chaque serveur ni chaque électeur. Elle doit représenter les mécanismes qui changent la décision. Quelques types d’agents suffisent : attaquant, collaborateur, responsable cyber, journaliste, relais militant, influenceur et public segmenté. Leurs réactions obéissent à des règles explicites : confiance dans la source, proximité politique, sensibilité au caractère spectaculaire, exposition répétée et correction reçue. Les paramètres sont modifiés pour tester des futurs possibles, sans présenter le résultat comme une prédiction électorale.
Ce dispositif permet de rejouer une même compromission avec plusieurs calendriers, volumes de fuite et degrés de falsification. Il révèle les points où la défense se fragmente : absence de propriétaire d’un compte, journal incomplet, validation publique trop centralisée, incapacité à contacter rapidement un prestataire ou confusion entre preuve technique et preuve compréhensible par le public. Le modèle sert ensuite à construire des fiches réflexes, à tester les astreintes et à calibrer les seuils de décision.
Préparer la réponse avant la campagne
Une équipe de campagne peut engager cinq actions immédiatement. Elle doit d’abord cartographier ses actifs et ses tiers, puis conserver des journaux exploitables et des copies de référence des documents sensibles. Elle doit ensuite définir une cellule hybride unique, avec un responsable de décision et des suppléants. Elle doit préparer des messages qui distinguent clairement fait confirmé, hypothèse et information encore invérifiable. Elle doit enfin convenir à l’avance des contacts avec les plateformes, prestataires et autorités compétentes.
La protection du débat public dépend aussi de la qualité de la preuve. L’équipe doit pouvoir dater un document, vérifier son intégrité, reconstituer son circuit et expliquer simplement pourquoi une pièce est authentique, altérée ou indéterminée. Elle ne doit jamais promettre une certitude que l’analyse ne permet pas. Une réponse crédible peut dire qu’un accès a été compromis, que certains documents sont encore en cours d’examen et qu’une nouvelle mise à jour sera publiée à heure fixe.
Enfin, l’exercice doit tester le retour au fonctionnement normal. Une crise hybride dure plus longtemps que le pic médiatique. Les comptes doivent être restaurés, les personnes exposées accompagnées, les partenaires informés et les rumeurs persistantes suivies. Le débriefing doit produire des changements vérifiables : droits supprimés, procédure raccourcie, sauvegarde ajoutée, contact actualisé ou message réécrit. Sans cette boucle, la simulation devient un spectacle ; avec elle, elle transforme l’organisation.
La première bataille se joue sur la cohérence
En 2027, une fuite ne sera jamais seulement une fuite. Son sens dépendra du montage, du calendrier et du réseau qui la diffuse. L’objectif de l’adversaire sera souvent moins de faire croire une histoire unique que de saturer l’équipe, de multiplier les versions et de rendre toute réponse suspecte.
La défense repose donc sur une cohérence préparée : une même chronologie, une même chaîne de preuve et une même règle de communication pour les techniciens, les juristes et les responsables politiques. Les campagnes qui auront simulé plusieurs variantes sauront décider sans attendre une certitude impossible. Elles réduiront la fenêtre pendant laquelle le piratage peut devenir un récit dominant.
Sources principales
• SGDSN, VIGINUM, bilan des ingérences numériques étrangères ayant ciblé les élections municipales de mars 2026 : https://www.sgdsn.gouv.fr/viginum/actualites/bilan-des-ingerences-numeriques-etrangeres-ayant-cible-les-elections-municipales
• SGDSN, VIGINUM, Manipulation d’algorithmes et instrumentalisation d’influenceurs : enseignements de l’élection présidentielle en Roumanie et risques pour la France, février 2025 : https://www.defense.gouv.fr/desinformation/aller-plus-loin/analyses-sgdsn/sgdsn-viginum-manipulation-dalgorithmes-instrumentalisation
• ANSSI, ressources de cybersécurité relatives aux scrutins : https://cyber.gouv.fr/
• CISA, Cybersecurity Toolkit and Resources to Protect Elections : https://www.cisa.gov/topics/cyber-threats-and-advisories/election-security
The post Du piratage à la désinformation : préparer les équipes de campagne aux crises hybrides appeared first on INCYBER NEWS.
-
Kawasaki prévoit de commercialiser son premier robot humanoïde dès 2030
www.usine-digitale.frKawasaki Heavy Industries ne manque pas d’ambitions dans la robotique humanoïde. La multinationale japonaise espère commercialiser son premier appareil de ce type dès 2030, a révélé le 4 octobre Nikkei Asia.
-
GPT-6 Astra devait créer un bot StarCraft : l’IA a préféré tricher en copiant le meilleur humain
www.numerama.comLe vendredi 2 octobre, GPT-6 Astra, un modèle d'OpenAI, devait écrire un bot StarCraft pour le banc d'essai StarSkirmish. Il a téléchargé à la place Stardust, le meilleur bot écrit par un humain. Le créateur du test, Kai McPheeters, a effacé le code copié. Brood War sert depuis des années de terrain d'essai à la recherche en IA.
-
OpenAI licencie trois chercheurs pour fuite d’informations
incyber.orgLe Wall Street Journal a révélé, le 1er octobre 2026, qu’OpenAI avait licencié trois chercheurs en sécurité pour avoir partagé des informations confidentielles avec un organisme spécialisé en sécurité de l’IA. L’article ne précise pas l’identité de cette organisation ni la nature des données transmises.
Les trois chercheurs concernés sont Jasmine Wang et Mikita Balesni, deux spécialistes de l’alignement, et Tomek Korbak, membre de l’équipe de sécurité. Ce dernier était l’interlocuteur technique des équipes externes chargées d’enquêter sur le piratage d’Hugging Face, mené par deux agents d’IA d’OpenAI en juillet 2026. Des chercheurs de l’organisation à but non lucratif METR s’étaient notamment rendus dans les locaux de la firme pour étudier le comportement des modèles concernés.
Aucun lien n’a, à ce stade, été établi entre cette affaire et les licenciements. OpenAI déclare avoir constaté, après une enquête interne, que « les chercheurs concernés avaient enfreint les procédures internes et utilisé de manière inappropriée des informations sensibles ». La firme justifie donc leur licenciement par une « rupture de la relation de confiance professionnelle ».
The post OpenAI licencie trois chercheurs pour fuite d’informations appeared first on INCYBER NEWS.
-
LDLC victime d’une fuite de données
incyber.orgLe revendeur informatique lyonnais LDLC a informé ses clients, le 2 octobre 2026, qu’un « tiers malveillant » s’était introduit dans un de ses SI et y avait dérobé des informations personnelles. Le groupe n’indique toutefois pas le nombre de personnes potentiellement concernées. Il ne précise pas non plus la technique de compromission, la date de l’incident ni son éventuelle attribution.
Les données dérobées comprennent le nom et le prénom, les adresses postale et électronique, les numéros de téléphone fixe et mobile, le numéro de fax, le code client interne, le statut de particulier ou de professionnel, ainsi que les dates de création du compte et de la dernière connexion. Selon le groupe, la fuite ne concerne en revanche pas les informations les plus sensibles : mots de passe, identifiants de connexion, numéros de carte bancaire ou RIB.
LDLC affirme avoir isolé le SI compromis dès la détection de l’intrusion et signalé l’incident à la Cnil.
The post LDLC victime d’une fuite de données appeared first on INCYBER NEWS.
-
Warlock cible des pays lusophones et hispanophones
incyber.orgL’équipe « Threat Hunter » de Symantec a révélé, le 1er octobre 2026, qu’un groupe cybercriminel chinois avait utilisé une variante du rançongiciel Warlock contre des organisations de pays lusophones et hispanophones, dont des opérateurs d’infrastructures critiques. Parmi les victimes figurent un service des eaux, un opérateur de télécommunications, une université et une administration régionale. Les organisations visées sont situées en Europe, en Afrique et en Amérique latine.
Selon Symantec, les attaquants ont exploité des vulnérabilités dans Microsoft SharePoint : les failles dites « ToolShell », dévoilées en 2025, à l’origine de la compromission de centaines d’administrations et d’entreprises à l’aide de Warlock, et d’autres signalées par le gouvernement américain en août 2026. Microsoft a publié des correctifs pour l’ensemble de ces vulnérabilités.
« Le récent intérêt pour les pays lusophones et hispanophones peut s’expliquer soit par une stratégie de ciblage opportuniste, motivée par la présence de serveurs SharePoint exposés et vulnérables, soit par une opération plus délibérée », lit-on dans le rapport de Symantec. En 2025, dans une étude sur Warlock, Microsoft n’avait pas pu établir de lien formel entre le groupe chinois à l’origine du rançongiciel et des acteurs étatiques affiliés à Pékin déjà connus.
The post Warlock cible des pays lusophones et hispanophones appeared first on INCYBER NEWS.
-
Crédit Agricole brièvement en panne ce lundi : le site et l’application de la banque française ont rencontré des bugs
www.numerama.com
Des clients du Crédit Agricole ont signalé des problèmes ce lundi 5 octobre 2026 après-midi. Une brève panne empêchait les connexions aux services de la banque française, sur l'application ou sur le site.
-
Le risque cyber, frein à la croissance industrielle
incyber.orgRockwell Automation, spécialiste américain de l’automatisation industrielle, a publié, fin septembre 2026, une étude sur la sécurité des systèmes industriels dans un contexte de numérisation avancée. Baptisée « Résilience opérationnelle à l’ère de la connectivité », elle s’appuie sur les réponses de 1 500 décideurs des secteurs de la fabrication et de l’industrie, issus de 17 pays. Elle témoigne de l’importance croissante accordée à la cybersécurité dans la stratégie des entreprises concernées.
Plus d’un tiers des répondants considèrent ainsi le risque cyber comme « l’un des plus grands obstacles externes à la croissance ». La cybersécurité est d’ailleurs selon eux le deuxième investissement technologique offrant le meilleur retour sur investissement. 46 % des entreprises industrielles affirment avoir subi un incident de sécurité au cours des douze derniers mois, mais 90 % se disent confiantes dans leur capacité à prévenir ou contenir un tel incident, ou à s’en remettre.
The post Le risque cyber, frein à la croissance industrielle appeared first on INCYBER NEWS.
-
Apple va brider une fonction cruciale des Mac pour empêcher les agents IA de fouiller partout
www.numerama.com
Apple a annoncé de nouveaux contrôles autour de l'accès complet au disque sur macOS. L'entreprise estime que certains développeurs détournent cette autorisation et que l'essor des agents IA rend le risque plus pressant.
-
Des roquettes contre des drones kamikazes : le lanceur Rampart de Naval Group vient de tirer en mer pour la première fois
www.numerama.com
Le Rampart, le nouveau lanceur anti-drones de Naval Group, a fait ses premiers tirs en mer lors de l’exercice Wildfire de la Marine nationale, au large de Toulon, du 28 septembre au 2 octobre.
-
Citrix NetScaler - Et c'est reparti pour un patch !
korben.infoJe ne sais pas si vous êtes familier avec NetScaler de Citrix, mais c'est un équipement qui sert de passerelle d'accès à distance pour les salariés des entreprises, et qui peut aussi gérer l'authentification SAML.
Et ces derniers temps, l'équipement est un peu mis à mal. À cause notamment de deux failles 0day sorties fin septembre (surnommées PitScaler par le chercheur Kevin Beaumont), qui ont heureusement été patchées. Mais ces derniers jours, des admins ont vu quand même redémarrer en boucle leur NetScaler pourtant à jour dont des 14.1-73.37, la version censée corriger le problème...
Bizarre, bizarre, vous avez dit bizarre ?
Eh oui c'est bizarre ! Encore une vuln !! C'est la seconde vague en moins d'une semaine et c'est le bulletin de sécurité de Citrix qui le dit avec la CVE-2026-88779, qui est, cerise sur le gâteau, activement exploitée dans des attaques au moment où j'écris ces lignes.
Donc voilà, c'est le gros bordel du côté des entreprises clientes de Citrix !! D'après SecurityWeek, avant l'arrivée des correctifs, les files d'attente du support technique de Citrix duraient des heures... Et les contournements provisoires n'empêchaient pas systématiquement les plantages et autres redémarrages à répétition.
De quoi déprimer sévère... Certains clients de Citrix ont même dû débrancher leur matériel durant la première vague de failles. Et aujourd'hui, même ceux qui ont installé le correctif de PitScaler n'y échappent pas non plus s'ils utilisent SAML, puisque Citrix a sorti un nouveau correctif et leur demande de mettre à jour une seconde fois en très peu de temps.
Alors que se passe-t-il exactement ? Est-ce que c'est un simple déni de service ?
Eh bien en tout cas, c'est ce que dit Citrix.
Ce qu'ils expliquent, c'est que le service peut rester indisponible tant que l'attaque se répète et que pour le moment, ils n'ont pas identifié d'impact sur l'intégrité des données. Sauf que le chercheur en cybersécurité Kevin Beaumont a vu l'un de ses honeypots (qui était pourtant patché) faire tourner un binaire malveillant récupéré depuis le web.
Un autre admin a aussi trouvé dans ses logs des noms d'utilisateurs contenant des commandes shell, censées télécharger un fichier puis l'exécuter. Toutefois, ses logs ne prouvent pas que ces commandes ont réellement tourné.
Donc voilà, on est un peu tous dans le flou...
En juin, Citrix communiquait sur la CVE-2026-8452, consistant en un autre débordement mémoire côté SAML, et pouvant provoquer un "comportement imprévisible" ou un déni de service. Et selon la note de la Cloud Security Alliance , watchTowr a démontré en août que cette faille autorisait en réalité une exécution de code root sans authentification.
Donc même si rien n'indique que ce soit le même bug ici (le plantage d'aujourd'hui, c'est le processus nsaaad qui se vautre en boucle), ce n'est pas la première fois que l'explication "c'est juste un déni de service" se fait démonter. Beaumont rappelle d'ailleurs que la CVE-2025-6543 avait suivi le même chemin...
Voilà... donc côté correctif, Citrix a sorti des mises à jour qui règlent la faille (je vous donne les versions plus bas) et en complément, il propose aussi des listes de blocage d'adresses IP malveillantes. La CISA a également ajouté la faille à son catalogue le 4 octobre, avec une échéance de correction exigée pour le 7 octobre pour les agences fédérales américaines. C'est la sixième faille NetScaler exploitée qu'elle y inscrit cette année, d'ailleurs...
Maintenant, voici comment savoir si vous êtes concerné.
En fait, la faille ne touche que les appliances configurées comme fournisseur de service (SP) ou comme fournisseur d'identité (IdP) SAML. Cherchez donc dans votre config une ligne
add authentication samlActionouadd authentication samlIdPProfile.Et si vous en avez une, il faudra installer au minimum la 14.1-73.41 ou la 13.1-64.28 selon votre branche (ou la 14.1-73.41 FIPS, ou la 13.1-37.282 pour les FIPS et NDcPP en 13.1) de NetScaler, comme l'indique le bulletin de Citrix .
Voilà, bon courage à tous.
Merci à Thomas pour l'info !
Source : SecurityWeek
-
Avec sa plateforme d’intelligence artificielle North 2, le canadien Cohere veut devancer Mistral sur les enjeux de souveraineté
www.usine-digitale.frCohere accélère. Le 30 septembre, l’entreprise canadienne lançait Embed 5, sa nouvelle famille de modèles d’embeddings, conçue pour améliorer la recherche dans des données d’entreprise complexes. Cinq jours plus tard, elle dévoile North 2, présenté comme sa « plus importante mise à niveau » à ce jour. A première vue, les deux annonces pourraient sembler appartenir à des catégories différentes. En réalité, elles répondent au même objectif : faire de Cohere une plateforme plutôt qu’un simple fournisseur de modèles.
-
Le coût moyen d’une cyberattaque est de 45 900 euros, et pourtant les PME françaises continuent de bouder l’assurance cyber dédiée
www.usine-digitale.frAlors que les cyberattaques se banalisent, l’assurance contre leurs conséquences ne suit pas la même trajectoire. C’est le paradoxe mis en avant par Hiscox dans l’édition 2026 de son rapport sur la gestion des risques cyber. Dans le cadre de cette étude, 6800 décideurs chargés de la cybersécurité dans des organisations de moins de 250 salariés ont été interrogés.