Tech-fr publisher
-
DevDay : OpenAI peut-il rattraper Anthropic et contrer les ambitions de Meta dans l’agentique personnelle ?
www.usine-digitale.frOpenAI avait promis un DevDay particulièrement fourni. L’entreprise n’a pas lésiné sur les annonces : agents capables de travailler en continu, nouveau modèle moins coûteux, accélération de l’inférence, évolution de Codex, espace de travail collaboratif, nouvelles briques pour les développeurs et renforcement des offres de sécurité et de confidentialité. Pris séparément, l’ensemble ressemble à une longue liste de courses. Pris ensemble, il dessine surtout une stratégie.
-
Amazon brade sa Kindle 2024 à moins de 90 € avant l’arrivée de sa remplaçante
www.numerama.com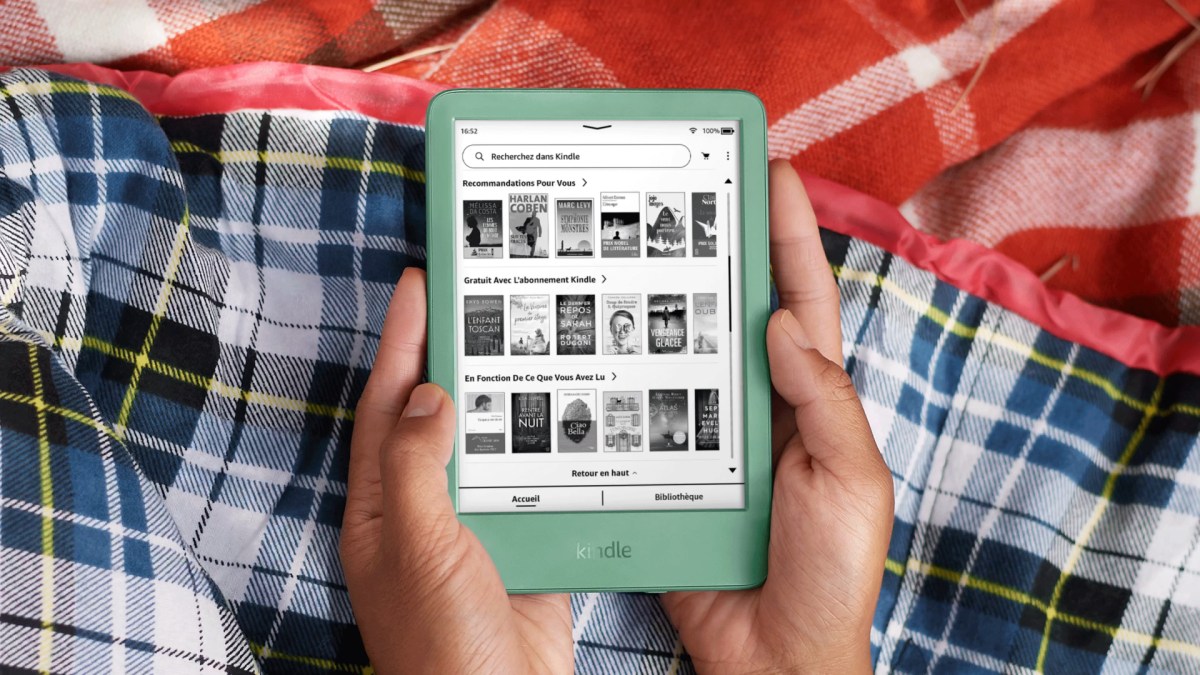
[Deal du jour] Des visuels de la prochaine Kindle d'entrée de gamme ont fuité le 28 septembre 2026. En attendant son annonce officielle, Amazon fait passer la Kindle 2024 à 89,99 € au lieu de 154,99 €.
-
OpenAI a été pris de court, l’adresse dot.com ne mène pas chez eux
www.numerama.com
Le lancement des agents « dots » d'OpenAI a droit à un couac inattendu : l'adresse dot.com, partagée sur X, ne redirige pas vers OpenAI.
-
Lycos.fr : Benjamin Romei dévoile les coulisses de son moteur maison à 2,4 millions de sites
www.abondance.com
Benjamin Romei
Fondateur d'ADN Contents et repreneur de Lycos.fr
Entrepreneur du web installé à Mulhouse, Benjamin a fondé ADN Contents en 2011. Sa société édite plusieurs médias thématiques, dont Begeek et 24matins. Le 21 septembre 2026, elle a remporté le nom de domaine lycos.fr, relancé quelques jours plus tard avec un moteur de recherche, des pages perso et un annuaire. Vous pouvez le retrouver sur LinkedIn et sur sa page lycos.fr/benjamin.
Benjamin a répondu par écrit à nos questions. Le projet n'a que quelques jours : certains éléments de stratégie et quelques chiffres restent logiquement confidentiels, et il a préféré les garder pour plus tard. Sur la technique, il a joué le jeu avec beaucoup de précision. Les questions, posées par Victor Lerat pour Abondance, sont numérotées dans les encadrés bleus. Un grand merci à Benjamin pour son temps, et bonne lecture à tous !
Comment Lycos.fr a été remis en ligne en une après-midi
Question 1Le jour où vous avez remporté l'enchère, quelle a été votre première réaction ?
Benjamin Romei (Lycos.fr)Pas vraiment de surprise. On n'est pas très nombreux sur le marché français à faire ce genre d'achat pour en faire un vrai projet. On avait prévu 50 000 € pour celui-ci, et on est restés bien en dessous.
Question 2Le jour où vous récupérez les accès au domaine, quelles sont vos premières actions techniques ?
Benjamin Romei (Lycos.fr)On a gagné l'enchère à 15 h et j'ai démarré dans la foulée. Le temps que le domaine arrive et pointe chez nous, à 16 h 10, on avait une V0.1 en ligne avec le formulaire de réservation. En quelques minutes, on avait déjà des centaines d'inscrits.
Le soir, on a mis en ligne la recherche et le portail d'actu, et on dépassait déjà les milliers d'inscriptions. On a aussi rebranché une bonne centaine d'anciens sous-domaines, pour que les vieux liens mènent encore quelque part.
Question 3Quelle stack avez-vous retenue, et pourquoi ce choix pour un site qui devait encaisser un afflux d'inscriptions dès l'annonce ?
Benjamin Romei (Lycos.fr)Astro, hébergé sur Cloudflare Workers. Pas de serveur à gérer, et ça monte en charge tout seul, ce qui tombait bien vu le démarrage. Tout le reste est chez Cloudflare aussi : bases, cache, photos, envoi des e-mails.
Je ne suis pas payé par Cloudflare (j'aimerais bien), mais je suis un de leurs premiers utilisateurs, et voir l'évolution de cette boîte, c'est impressionnant. L'infra et l'écosystème sont vraiment dingues. Une entreprise souvent sous-estimée à mon avis, surtout en France.
Pour le code, on tourne avec des licences Claude Code Max et Codex, et on développe sur Windows et Mac.
Question 4Vous mesurez l'audience sans cookie. Qu'est-ce qui vous a fait renoncer à GA4 et au bandeau de consentement ?
Benjamin Romei (Lycos.fr)Ça fait longtemps que je n'utilise plus GA4 sur mes projets, depuis le RGPD je pense. Il existe aujourd'hui pas mal de solutions solides, accessibles et sans cookie. On utilise Plausible sur tous nos sites. C'est payant, mais c'est léger, simple, conforme RGPD, et ça donne les données dont un éditeur a besoin, sans superflu.
Alors oui, la facture monte vite, mais il existe une version open source qu'on peut héberger soi-même. C'est quelque chose que j'aimerais faire à terme, je n'ai pas encore eu le temps de m'y pencher sérieusement. Le seul petit bémol : la version auto-hébergée a environ un an de retard sur la version cloud.
Les pages perso Lycos ID vues par un SEO
Question 5Chaque page porte un balisage ProfilePage et des liens rel="me" vers les réseaux sociaux. Quel rôle voulez-vous que ces pages jouent dans Google ?
Benjamin Romei (Lycos.fr)Le balisage est présent sur toutes les pages, avec les liens vers les réseaux. On a fait le choix d'indexer uniquement les pages Entreprise. Les autres sont en noindex, accessibles par leur URL. Se positionner sur son nom et envoyer des signaux à Google sur son identité, c'est donc le rôle de l'offre payante.
On tient quand même à garder l'esprit Linktree ou about.me : une petite page qu'on partage rapidement sur ses réseaux sociaux. L'offre gratuite est parfaite pour ça.
Pour illustrer la différence, voici la page Entreprise d'Abondance, lycos.fr/abondance, balisée en
index, follow: La page Entreprise d'Abondance : lycos.fr/abondance, indexable.
Et une page perso gratuite, celle de Victor Lerat, lycos.fr/victorlerat, en
noindex, follow: elle se partage, mais ne cherche pas à se positionner dans Google. Une page perso gratuite : lycos.fr/victorlerat, en noindex.
Question 6Une page est-elle indexable dès sa création, ou doit-elle d'abord franchir un seuil ?
Benjamin Romei (Lycos.fr)Le domaine a une vraie autorité, donc l'indexation est rapide. Certaines pages sont indexées en quelques minutes, d'autres en quelques heures, mais dans l'ensemble ça va vite. Dès qu'une page est remplie, configurée et publiée, elle part en indexation.
Question 7Laissez-vous les robots des IA (GPTBot, ClaudeBot, PerplexityBot) lire les pages ?
Benjamin Romei (Lycos.fr)Oui, uniquement sur les pages Entreprise, les pages payantes.
Question 8Des milliers d'inscrits en quelques heures, c'est aussi une cible pour les spammeurs. Quels garde-fous avez-vous mis en place ?
Benjamin Romei (Lycos.fr)On a la chance d'avoir des SEO expérimentés dans l'équipe. On connaît bien le sujet, donc on laisse passer ce qui est propre et on écarte ce qui ne l'est pas.
Côté modération, j'ai mis en place un système avec Jev, de TypeSafe AI, que je recommande d'ailleurs. Il fait un premier tri, et on fait la validation finale quand il a un doute. Depuis le début, on a bloqué environ 300 noms, ce qui reste plutôt raisonnable vu le volume.
Question 9Comment gérez-vous les noms de page qui correspondent à une marque ou à une personne connue ?
Benjamin Romei (Lycos.fr)On essaie de filtrer en amont, là aussi avec Jev. On a ajouté un bouton de signalement, et si une page problématique passe entre les mailles, on la retire rapidement.
Question 10Avec des milliers de pages, comment organisez-vous le maillage interne et l'annuaire ?
Benjamin Romei (Lycos.fr)Pour l'instant, on est sur une première version : une page annuaire, liée depuis chaque page ID et depuis l'accueil. On travaille sur une V2, peut-être plus éditoriale, avec des rubriques et de la géolocalisation. L'idée, c'est d'être utiles à nos utilisateurs, donc on avance en fonction de leurs retours.
Un moteur de recherche français avec son propre index
Question 11Le moteur repose-t-il sur un index construit par vous, sur des résultats tiers, ou sur un mélange des deux ? Quelle a été la partie la plus difficile ?
Benjamin Romei (Lycos.fr)C'est notre propre index, stocké chez nous. Pas d'appel à une API tierce, à part pour quelques encarts comme la météo. Il est encore assez compact, mais on pense qu'il représente bien le web français : environ 2,4 millions de sites aujourd'hui. On en dira plus bientôt.
On a démarré avec un prototype à 10 000 sites, puis on a élargi petit à petit, en vérifiant à chaque étape que les résultats s'amélioraient. On a ajouté de la donnée ouverte comme Wikipédia, et ce que les sites nous autorisent à crawler, pour ranker des pages et plus seulement des sites.
Pour le classement, on combine liens, trafic et pertinence par rapport à la requête. On a aussi testé un peu la recherche vectorielle : elle fait remonter de très bons résultats qu'on n'aurait pas trouvés autrement, mais aussi pas mal de bruit.
Chaque étape, ranker des sites, puis des pages, puis comprendre ce que la personne cherche vraiment, est beaucoup plus complexe que la précédente. Plus l'index grandit, plus il faut gérer le spam.
Le plus difficile, c'est de savoir ce qui mérite d'entrer dans l'index. C'est passionnant, ça donne une idée concrète de la façon dont les équipes de Google doivent réfléchir.
Pour aller plus loin, on travaille avec Cloudflare pour faire reconnaître notre crawler comme robot vérifié. C'est ce qui nous permettra d'ouvrir vraiment le crawl et de le faire accepter plus largement par les sites.
On ne cherche pas à être Google, ce n'est pas un objectif réaliste pour une entreprise française ou européenne. En revanche, on est plutôt fiers du résultat au regard du temps passé, quand on voit que certains moteurs européens lèvent des dizaines de millions sans avoir encore leur propre index.
Question 12En 2026, un moteur de recherche doit-il afficher des réponses générées par IA ou rester une liste de liens ?
Benjamin Romei (Lycos.fr)Vaste question ! Pour l'instant, on reste sur une liste de liens, et on ne prévoit pas de brancher de LLM à court terme. Il faut garder en tête qu'un moteur de recherche est structurellement déficitaire, sauf à atteindre une taille suffisante pour la publicité ou à trouver le bon modèle économique. Quand on regarde les comptes des petits moteurs qui ont leur propre index, la rentabilité, quand elle existe, se joue à peu de chose.
Le chantier qui a pris le plus de temps
Question 13Qu'est-ce qui vous a pris beaucoup plus de temps que prévu ?
Benjamin Romei (Lycos.fr)La facturation. Sur le papier, un abonnement paraît simple. En pratique, il faut prévoir tous les scénarios : plusieurs pages sur un même abonnement, un changement d'offre en cours de mois, le prorata, les remboursements, les paiements qui échouent… Chaque cas particulier en fait apparaître un autre. Il reste sûrement quelques petites choses à ajuster, qu'on corrigera au fil de l'eau.
Nous reviendrons vers Benjamin dans quelques mois pour voir comment le moteur et les pages Lycos ID ont grandi.
Les autres articles sur le retour de Lycos.fr
- Next : Racheté 35 300 €, Lycos.fr revient : « On n'avait pas prévu que ça aille aussi vite »
- Solidnames : Interview du nouveau titulaire du nom de domaine historique lycos.fr
- Blog du Modérateur : Lycos va chercher une seconde vie après le rachat du domaine
- Clubic : Le mythique Lycos.fr est de retour, des milliers de nostalgiques déjà inscrits
- Presse-citron : Lycos.fr est de retour et impressionne dès les premiers jours : le nouveau propriétaire ne s’attendait pas à ça
- Korben : Lycos.fr renaît en moteur de recherche avec pages perso gratuites
L’article "Lycos.fr : Benjamin Romei dévoile les coulisses de son moteur maison à 2,4 millions de sites" a été publié sur le site Abondance.
-
Identifiants volés, protections défaillantes : Comment les lacunes de la DGFiP ont permis à un hacker de siphonner les données de ses usagers
www.usine-digitale.frLe 24 juin 2026, le centre de supervision de la sécurité de la Direction générale des Finances publiques (DGFiP) réinitialise le mot de passe d’un compte compromis. Depuis plusieurs heures, un hacker l’utilise pour extraire des données de l’administration fiscale. Or, le changement de mot de passe ne ferme pas la session déjà ouverte. Résultat : le téléchargement se poursuit jusqu’au lendemain à 2h31.
-
Personnalisation marketing : REELEVANT s’attaque au coût de production des contenus
www.frenchweb.frAdapter les messages aux préférences de chaque client suppose de produire, de valider et de maintenir un nombre croissant de contenus. Reelevant veut réduire cette charge en automatisant leur composition à partir des données des entreprises. Dans un entretien accordé à FrenchWeb, son fondateur Vincent Martinet détaille cette approche, dans laquelle l’automatisation occupe encore une …
L’article Personnalisation marketing : REELEVANT s’attaque au coût de production des contenus est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
HaloBattery - Suivez le niveau de batterie de tous vos périphériques
korben.infoVous avez un casque d'une certaine marque, une souris d'une autre marque sans oublier votre fidèle manette... Mais pour connaître le niveau de batterie de chacun de ces appareils sous Windows, vous avez deux solutions. Soit vous attendez qu'il tombe en panne de jus. Soit, si le fabricant le permet, vous pouvez voir cela dans l'application compagnon de votre appareil.
C'est ce manque de visibilité qui a poussé Headvox à vibe-coder HaloBattery , un petit utilitaire gratuit et open source qui place une icône par appareil dans la zone de notifs de Windows. Ensuite, c'est l'anneau autour du picto qui vous indiquera le niveau de batterie. C'est blanc au début, puis après ça passe à l'orange, et quand vous êtes en rouge, bah faut commencer à s'y intéresser... Et vert, c'est que votre appareil est en train de se charger.
De plus, en passant la souris au-dessus de l'icône, vous pouvez connaître le pourcentage exact du niveau de batterie.

Les icônes sur une barre sombre, de 100 % à la veille
Afin de lire tout ça, l'outil cause directement aux dongles et aux câbles USB, va lire les rapports des manettes type Xbox et peut si besoin, demander à Windows ce qu'il peut obtenir au niveau des appareils Bluetooth. Comme ça, plus besoin du logiciel du fabricant. Ça fait ça de moins comme soft de merde sur votre machine. Notez aussi que si votre appareil n'apparaît pas dans la liste de ce qui est détecté par HaloBattery, c'est probable que c'est justement l'un de ces fameux logiciels compagnons qui monopolise le périphérique et empêche toute lecture d'état sur celui-ci. Donc pensez bien à les fermer avant de lancer Halo Battery.
Et jetez aussi un œil au tableau de compatibilité avant de trop vous hype parce que tout n'a pas encore pu être testé et ça ne fonctionne malheureusement pas avec tous les périphériques. Par exemple, chez Logitech, seules les G502 sont vérifiées, et ni les Corsair ni le Razer BlackWidow V3 Pro n'ont été testés. Par contre, les DualSense, DualShock 4 et plusieurs Razer l'ont été...
Bref, si votre appareil manque, sachez qu'il y a un menu Diagnostics qui peut produire un rapport à joindre à votre issue sur GitHub, si vous voulez demander le support de celui-ci.
Voilà pour essayer cet outil, dézippez l'archive en entier dans un dossier (car le programme a besoin du dossier _internal à ses côtés), puis hop, un clic droit sur l'icône et "Lancer avec Windows" et ça devrait le faire ! Grâce à ça, vous saurez enfin quel périphérique recharger avant votre petite partie du soir !
Source : PC Gamer
-
Sony a un problème : certaines PS5 peuvent désormais être jailbreakées en quelques secondes
www.numerama.com
Un nouveau jailbreak permet de contourner certaines protections des PS5, y compris Slim et Pro, sous des versions récentes du système. Cette fois, la manipulation devient beaucoup plus simple et rapide, de quoi poser un sérieux problème à Sony.
-
Amazon fait déjà baisser le prix de la Garmin Forerunner 70, la nouvelle montre running d’entrée de gamme
www.numerama.com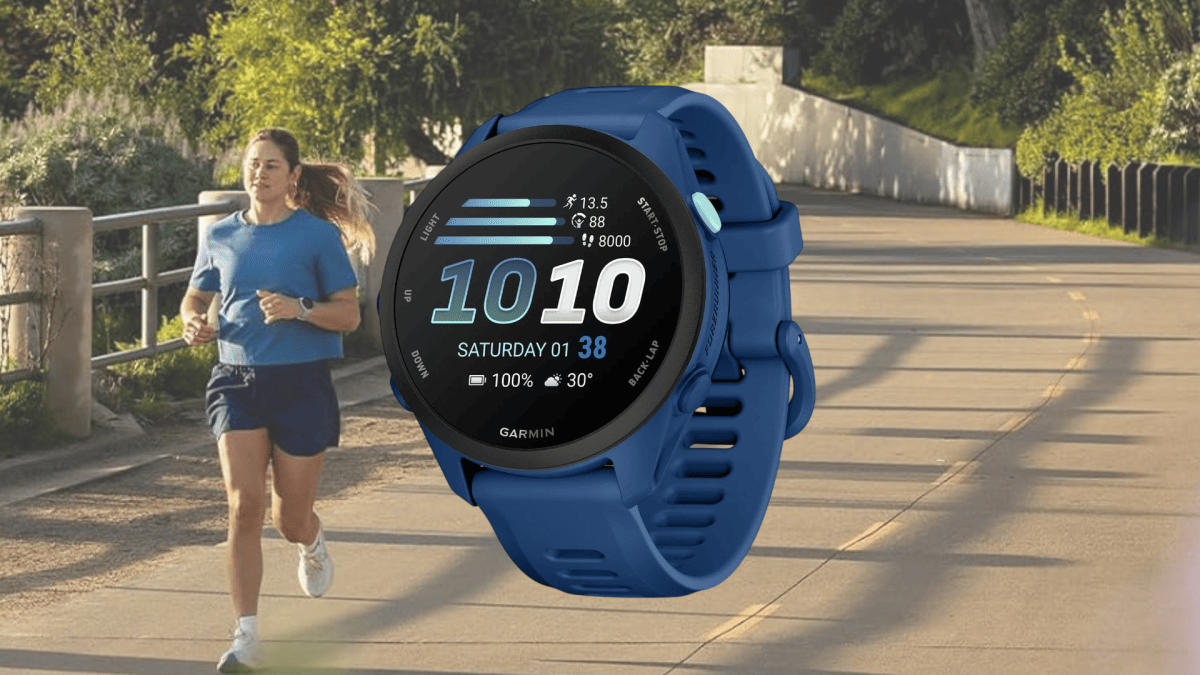
[Deal du jour] Sortie au printemps 2026 pour succéder à la Forerunner 55, la Garmin Forerunner 70 connaît déjà une baisse de prix sur Amazon. La montre de running passe à 229 € au lieu de 249 €.
-
Code d’urgence, alerte au détournement : le mystère du vol flydubai FZ1073 qui a affolé Flightradar24
www.numerama.com
Parti de Dubaï pour Tel-Aviv ce mercredi 30 septembre, le vol flydubai FZ1073 a émis un code de détournement avant de se poser en Arabie saoudite. Sur Flightradar24, il est devenu le vol le plus suivi du moment.
-
Brosse à dents à 479 euros : Dyson explique la raison des pannes et présente ses excuses
www.numerama.com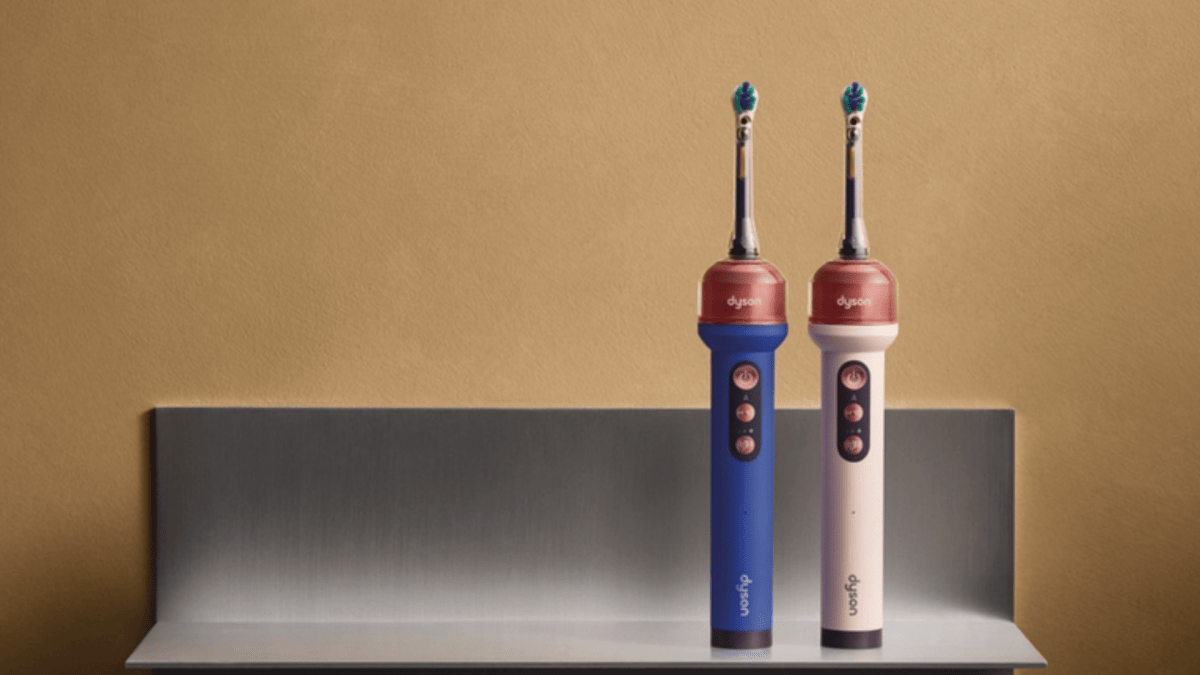
Après la suspension des ventes de sa CameraJet, Dyson précise l’origine des dysfonctionnements : un défaut de fabrication aurait permis à de l’eau de s’infiltrer dans certains appareils. La marque assure avoir isolé les produits concernés et repris la production.
-
ChatGPT lance un abonnement à 510 euros par mois et rend sa formule à 229 euros moins généreuse
www.numerama.com
OpenAI a présenté Pro 500, son nouvel abonnement à 510 euros par mois en France, le 29 septembre 2026. Il promet davantage d’usage et des réponses plus rapides. En parallèle, la formule à 229 euros revient avec une allocation réduite, sans baisse de prix.
-
Comment la douane allemande arrive à lire les messages Signal, Whatsapp et Telegram
korben.infoLe Zollkriminalamt, l'office d'enquête de la douane allemande, est capable de lire des conversations WhatsApp, Signal ou Telegram sans utiliser aucun logiciel espion ! On vient de l'apprendre grâce au média Netzpolitik qui a publié le 2 septembre dernier une note interne classée du Zollkriminalamt expliquant que depuis fin 2023, la méthode était testée pour finalement devenir un outil permanent pour les enquêteurs (surtout pour les enquêtes sur la criminalité organisée) depuis un peu plus d'un an.
Le principe est celui de WhatsApp Web ou de Signal Desktop... en fait, quand vous liez un ordinateur à votre compte en scannant un QR code depuis votre téléphone, cet ordinateur peut ensuite recevoir vos messages en même temps que le téléphone. Les enquêteurs configurent donc l'un de leur ordi, au poste de la douane en tant qu'appareil lié, ce qui fait que le chiffrement de bout en bout n'est plus un problème puisque l'appareil fait partie intégrante du compte.
Mais bon, pour que ça fonctionne, il faut réussir à faire valider la liaison de l'appareil par la cible. Pour faire ça, il faut donc ruser par exemple en convoquant les gens comme témoins et en les incitant à leur confier leurs téléphones pour faire des captures écran sur un sujet qui n'a rien à voir. Cela leur permet d'activer à leur insu la liaison WhatsApp Web ou autre. Ils peuvent également mettre en place une campagne de phishing dans la lignée des hackers russes qui piégeaient des fonctionnaires que je vous racontais en mars. Ou encore, quand c'est Telegram, avec son SMS de validation, le code de connexion peut être récupéré via une interception téléphonique classique.
Ils ont fait ça sur des dizaines de comptes. En 2022, un trafiquant de produits dopants de Basse-Saxe s'est même rendu compte que la douane se connectait à son compte. Il a alors coupé l'accès quelques heures plus tard... mais trop tard, ses échanges sur les 6 derniers mois étaient déjà copiés.
Car oui, c'est surtout ça qui donne de la valeur à la manœuvre puisque l'appareil lié récupère tout l'historique dès que la liaison est effective. La plupart des clients web reçoivent l'archive complète, et Signal propose de transférer les conversations ainsi que 45 jours de médias au moment de lier les appareils. Le BfV et le BSI ajoutent dans leur rapport que la cible met, en général, un peu de temps avant de remarquer que quelqu'un est en train de lire ses conversations, et aussi que la douane allemande peut écrire à sa place.
Alors, maintenant est-ce que c'est légal ?
Hé bien le 20 janvier dernier, la Cour fédérale de justice allemande a tranché sur le cas de Telegram. Ils ont validé le fait que se connecter en secret à un compte, c'était de la surveillance à la source, et que seuls les messages postérieurs à l'ordonnance du juge pouvaient être lus. Dans cette affaire de dopage, les messages antérieurs à l'ordonnance sont donc inutilisables au procès, faute d'infraction assez grave pour justifier une perquisition en ligne.
De son côté, le professeur Christian Rückert, spécialiste du droit pénal informatique à Bayreuth, juge la méthode "problematisch" parce que l'appli permet d'écrire au nom de la cible, alors que la loi exige de ne pas pouvoir en faire plus que de récupérer les messages. Mais bon, comme d'hab, avec la police et la justice, leur propre tambouille ne les concerne jamais vraiment hein...
Maintenant, si la douane ou la police peut le faire, n'importe quel script kiddie peut le faire aussi... Donc je vous invite vraiment à contrôler régulièrement la liste des appareils liés de vos applis. Si vous tombez sur des appareils que vous ne reconnaissez pas, virez-les immédiatement. Et dans la mesure du possible, pensez toujours à activer une vérification en deux étapes avec une application de double authentification et surtout pas un code SMS.
Source : Netzpolitik , repéré grâce au billet de Bruce Schneier .
-
« L’IA paie enfin : près d’une entreprise sur deux crée de la valeur avec »
www.usine-digitale.frL’année dernière, l’histoire de l’IA en entreprise était celle d’une petite élite qui prenait de l’avance sur une majorité en difficulté. La recherche 2025 du Boston Consulting Group montrait que seuls 5% des entreprises en tiraient une valeur substantielle, tandis que la plupart ne constataient que des retours minimes. En 2026, ce tableau a changé.
-
« Dots » : OpenAI lance des agents IA autonomes qui travaillent 24 h/24
www.abondance.comCe qu'il faut retenir :
- OpenAI a annoncé le 29 septembre 2026 les « dots », des agents IA propulsés par GPT 6 Astra, dotés d'un ordinateur et d'un navigateur dans le cloud, et capables de travailler en continu, 24 h/24 et 7 j/7.
- Les dots se connectent à plus de 4 000 applications via l'écosystème de plugins d'OpenAI et restent joignables dans ChatGPT, par SMS, sur Slack, sur Teams ou par appel vocal, en conservant le contexte d'un canal à l'autre.
- Le premier dot est inclus sans surcoût dans les forfaits Pro et Business Premium sur les marchés éligibles, tandis que les clients Enterprise, Edu et Healthcare y accèdent en bêta si leur administrateur l'active.
- OpenAI cite l'exemple d'un dot qui extrait des clips d'un entretien, rédige les notes et les posts sociaux, puis répercute les corrections : de quoi revoir certains workflows éditoriaux, avec une validation humaine à chaque étape sensible.
OpenAI présente les dots, des agents qui travaillent en continu
Le 29 septembre 2026, OpenAI a publié sur son site un article intitulé « Découvrez les dots », en marge de son annonce OpenAI DevDay 2026. L'entreprise y présente une nouvelle catégorie d'agents intégrés à ChatGPT, qu'elle décrit comme toujours actifs et conçus pour tout prendre en charge. Pour rappel, un agent IA est un système capable d'enchaîner des actions (naviguer sur le web, utiliser des outils, produire des fichiers) pour atteindre un objectif, là où un chatbot classique se contente de répondre à une requête.
La promesse d'OpenAI repose sur la continuité. Un dot apprend ce qui compte pour son utilisateur, tient compte de ses retours au fil du temps et avance sur ses objectifs jour et nuit. L'éditeur met en avant la possibilité de recevoir un travail réalisé « comme vous l'auriez fait », avant même de l'avoir demandé.
Les dots fonctionnent avec GPT 6 Astra. Chaque utilisateur peut dès maintenant nommer et personnaliser son dot. OpenAI indique aussi imaginer, à terme, des équipes de dots travaillant ensemble pour une même personne.
Chaque dot dispose d'un ordinateur, d'un navigateur et de 4 000 applications
Un équipement comparable à celui d'une nouvelle recrue
OpenAI compare le dot à un nouveau collaborateur qui arriverait avec presque tout le nécessaire. D'après l'annonce, il dispose de plusieurs ressources :
- Identité propre : le dot a ses propres accès et autorisations, distincts de ceux de l'utilisateur.
- Ordinateur et navigateur dans le cloud : il travaille sur une machine distante, que l'utilisateur peut consulter à tout moment pour examiner son travail.
- Code : il peut écrire et tester du code quand la tâche l'exige.
- Accès aux appareils : sur autorisation explicite, il peut se connecter à l'ordinateur portable de l'utilisateur et l'utiliser directement.
- Plugins : l'écosystème de plugins d'OpenAI lui ouvre l'accès à plus de 4 000 applications.
Un même dot peut mener plusieurs projets en parallèle. OpenAI insiste sur la possibilité de lui confier de nouvelles tâches sans multiplier les fils de discussion ni guider chaque étape.
ChatGPT, SMS, Slack, Teams et appel vocal
On échange avec un dot dans ChatGPT (web, mobile et application de bureau), mais aussi par SMS, sur Slack et sur Teams. Il est également possible de l'appeler pour lui parler de vive voix. Le contexte est conservé d'un canal à l'autre : un projet lancé dans ChatGPT peut être précisé par SMS, puis complété dans Slack.
La communication fonctionne dans les deux sens. Le dot peut écrire de lui-même pour faire un point d'avancement, poser une question ou soumettre une décision. Les abonnés Pro peuvent par ailleurs s'inscrire sur une liste d'attente, aux places limitées, pour échanger via iMessage et RCS (le standard de messagerie enrichie qui succède au SMS sur Android).
OpenAI illustre les dots par des cas d'usage métier
L'annonce décrit cinq scénarios types, tous fournis par OpenAI :
- Développement : le dot repère les demandes récurrentes dans les retours clients, développe et teste de petites corrections, puis soumet des pull requests (propositions de modifications de code à valider) accompagnées de vidéos montrant les changements.
- Lancement produit : quand le périmètre d'un produit évolue, le dot analyse l'impact sur le discours, révise les supports et prépare des propositions de modifications.
- Recherche scientifique : à l'arrivée de nouvelles données, il relance les analyses, met à jour les figures d'un article et signale les conclusions qui changent.
- Vente en entreprise : il compare les exigences d'un client à la documentation produit, réalise une preuve de concept et actualise la proposition commerciale au fil des tests.
- Production de contenu : à partir d'une transcription d'entretien, il repère les passages à extraire en clips, prépare les notes de l'émission et rédige des posts pour les réseaux sociaux, qu'il soumet ensuite à validation.
OpenAI décrit aussi ses propres usages internes. Un bug signalé sur Slack déclenche une enquête des dots, une maquette est transformée en application fonctionnelle, un cycle de planification est suivi pour tenir les délais. L'entreprise mentionne enfin le cas d'un premier testeur externe : son dot a remarqué qu'une publication n'avait pas été facturée, a préparé la facture et l'a envoyée après approbation.
Ces exemples restent toutefois déclaratifs. L'annonce ne s'appuie sur aucun chiffre de productivité ni sur des tests indépendants.
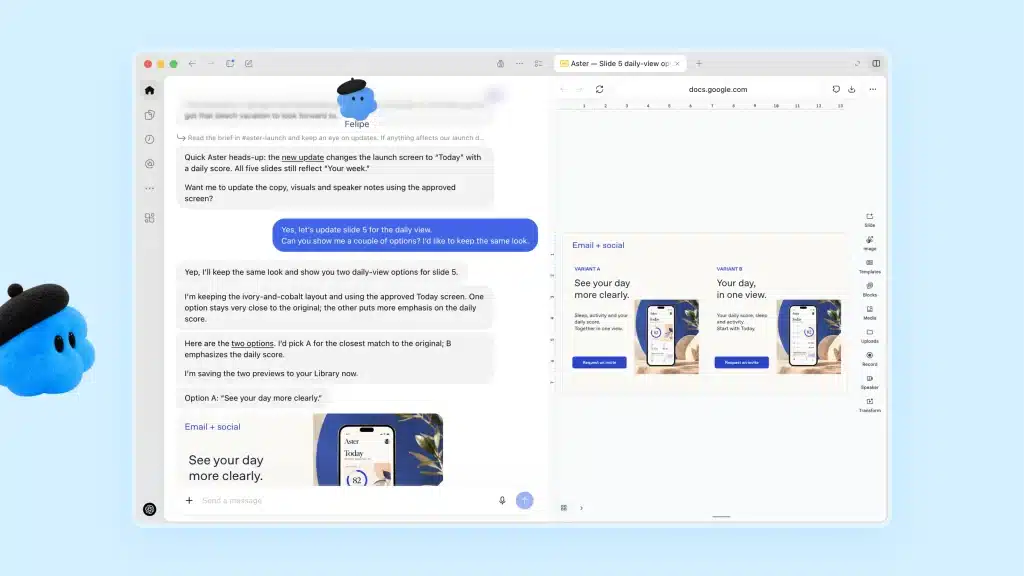 Présentation des dots - Source : OpenAI
Recherche proactive, règles et approbations encadrent l'autonomie des dots
Une recherche proactive limitée à la lecture seule
Quand l'utilisateur ne travaille pas activement avec lui, le dot cherche des moyens de l'aider en arrière-plan. OpenAI appelle ce mode la « recherche proactive ». Dans ce cadre, il utilise les applications déjà connectées, mais avec des outils limités à la lecture seule : il ne peut ni envoyer de messages, ni modifier le contenu des applications, ni contrôler le navigateur ou l'ordinateur de l'utilisateur.
Les protections annoncées par OpenAI
L'annonce détaille plusieurs mécanismes de contrôle :
- Séparation des environnements : l'ordinateur de l'utilisateur reste séparé de celui du dot, sauf connexion volontaire.
- Mots de passe : pour se connecter aux sites compatibles, le dot peut utiliser des mots de passe enregistrés sans que le modèle y ait accès en clair.
- Surveillance : des protections visent à contrer les instructions malveillantes, et le système de surveillance peut suspendre ou arrêter un dot en cas de problème de sécurité.
- Règles personnalisées : l'utilisateur peut autoriser des actions précises, les soumettre à approbation ou les bloquer, en plus des règles intégrées par défaut.
- Vérification automatique : les actions susceptibles d'affecter des comptes ou de partager des informations sont contrôlées au regard des instructions, des règles et des exigences de sécurité.
- Vue Activité : elle permet de suivre l'avancement, y compris le travail réalisé en arrière-plan, et de réorienter le dot.
Certaines tâches sensibles, comme la modification d'un mot de passe, restent toujours à la charge de l'utilisateur. OpenAI reconnaît par ailleurs que les dots peuvent se tromper et recommande de vérifier tout travail aux conséquences importantes.
Les règles d'utilisation des données
Par défaut, OpenAI n'utilise pas le contenu des espaces ChatGPT Business, Enterprise et Edu pour entraîner ses modèles. Sur les forfaits personnels, l'utilisateur choisit si ses conversations et le travail de son dot peuvent servir à l'amélioration des modèles. L'entreprise précise ne pas entraîner directement ses modèles sur la recherche proactive ni sur les notes que le dot prend pour lui-même. Les informations qui en sont issues peuvent toutefois être utilisées si elles alimentent une conversation ou une tâche admissible, selon les paramètres choisis.
Des dots spécialisés sont testés en entreprise avec Microsoft
À côté du dot personnel, OpenAI propose à un nombre limité d'entreprises un aperçu des « dots spécialisés ». Ceux-ci n'agissent pas pour le compte d'une personne : ils assument une responsabilité définie au sein de l'organisation, avec leur propre identité, leurs identifiants et leurs accès aux systèmes nécessaires.
OpenAI s'appuie sur des tests internes menés dans plusieurs domaines : achats, traitement des factures, marketing par e-mail, service client et gestion des contrats commerciaux. Le lancement passe par des projets pilotes ciblés, durant lesquels les équipes d'ingénierie d'OpenAI définissent avec chaque organisation les responsabilités du dot, ses outils et les modalités de validation humaine.
L'entreprise annonce aussi une collaboration avec Microsoft pour intégrer les dots spécialisés aux contrôles de gouvernance et de sécurité d'Agent 365, l'outil de Microsoft dédié à la gestion des agents en entreprise. L'objectif affiché est de permettre aux organisations de piloter les dots avec les outils Microsoft qu'elles utilisent déjà. L'annonce ne donne pas de calendrier pour cette intégration.
Le premier dot est inclus dans les forfaits Pro et Business Premium
Le déploiement commence dès l'annonce dans ChatGPT, pour les utilisateurs Pro et Business Premium sur les « marchés éligibles », dont la liste n'est pas détaillée dans l'article d'OpenAI. Les clients Enterprise, y compris Edu et Healthcare, peuvent tester la version bêta si l'administrateur de leur espace de travail l'active.
Les conditions tarifaires se résument ainsi :
- Premier dot : inclus sans frais supplémentaires dans le forfait Pro ou Business Premium, et disponible en continu pour discuter et suivre les sujets de l'utilisateur.
- Tâches approfondies : le forfait comprend un quota dédié, avec des limites étendues pendant le premier mois suivant le lancement.
- Évolutions prévues : il sera possible d'ajouter des dots et d'augmenter la capacité de chacun, en accélérant son rythme ou en relevant le volume de travail mensuel.
- Limites d'usage : les conversations avec le dot ne sont pas décomptées des limites de ChatGPT, mais les tâches qu'il lance dans Codex (l'agent de programmation d'OpenAI) ou dans ChatGPT Work le sont, comme d'habitude.
Pour démarrer, il faut créer son dot depuis l'application de bureau ChatGPT ou le navigateur d'un ordinateur, puis connecter ses applications. L'échange par l'application mobile n'est possible qu'après cette configuration initiale.
Les équipes SEO et contenu ont plusieurs raisons de suivre le sujet
Quid de l'annonce d'OpenAI pour le secteur du SEO ?
Le scénario « production de contenu » décrit par OpenAI se transpose assez directement aux métiers éditoriaux : un agent qui connaît la ligne éditoriale, décline un contenu source sur plusieurs formats et répercute les corrections sur l'ensemble des supports. La recherche proactive pourrait aussi servir à la veille, à condition que les outils utilisés par les équipes SEO (Search Console, outils de suivi de positions, CMS) soient disponibles parmi les 4 000 applications connectables. L'annonce n'en publie pas la liste.
L'autre enjeu concerne les éditeurs de sites. Les dots naviguent sur le web avec leur propre navigateur et peuvent se connecter aux sites compatibles avec des mots de passe enregistrés. Autrement dit, une part croissante des visites pourrait venir d'agents agissant pour le compte d'utilisateurs, plutôt que d'humains. OpenAI ne précise pas comment ce navigateur s'identifie auprès des sites (user agent, respect du robots.txt, adresses IP), ni la façon dont un dot sélectionne les sources qu'il consulte lorsqu'il mène une recherche. Deux informations qui conditionnent à la fois la mesure de ce trafic et la visibilité des contenus auprès de ces agents.
L’article "« Dots » : OpenAI lance des agents IA autonomes qui travaillent 24 h/24" a été publié sur le site Abondance.
-
Firefox change radicalement de design, avec sa plus grande mise à jour depuis 5 ans
www.numerama.com
Mozilla a lancé ce mardi 29 septembre Firefox 157, qui active pour tous le nouveau design Nova sur ordinateur et sur mobile. C'est le plus gros changement d'interface du navigateur depuis Proton, en 2021.
-
SlopTotal - Un détecteur de texte IA à installer chez vous
korben.infoSlopTotal est un projet qui se présente lui-même comme le "VirusTotal du texte IA", alors faut pas s'étonner que ça m'intéresse ! Vous y collez un texte, un PDF ou une URL, et ensuite 23 détecteurs le passent au crible, en parallèle à l'aide de classifieurs neuronaux, de tests statistiques et autres heuristiques. Ensuite, un score calibré de 0 à 100 résume leurs avis et doit vous dire normalement si tel ou tel texte a été écrit avec de l'IA

J'ai donc installé ça sur ma machine puis passé 36 textes divers et variés (IA et humains) dans mon instance. Parmi eux, 24 ont été écrits par Claude, ChatGPT et Gemini (12 en français, 12 en anglais), avec comme consigne d'avoir un ton neutre, et pour d'autres un ton de "blogueur" ^^. Les 12 autres textes, eux, sont humains. Je lui ai donné 6 de mes articles écrits entre 2018 et 2021 ainsi que 6 billets de blog tech en anglais publiés entre 2020 et 2021.
Voici donc mes résultats...
Sur les 12 textes humains, 4 ont été pris pour de l'IA (verdict "Likely AI-generated" ou pire), ce qui représente 33 %, et ils étaient tous en anglais !! Et sur mes 24 textes écrits par une IA, 9 ont été pris pour une réalisation humaine (verdict "Clean"), ce qui équivaut à 38 %. Ah et ils étaient tous en français.
Le README annonce pourtant mieux comme résultats donc je suis assez étonné (1 texte humain sur 66 classé "Likely AI"), mais sur d'autres genres de textes, comme la presse ou les livres et en 100% english. Alors oui, mon échantillon est petit, mais pour savoir si un texte vient d'une IA, SlopTotal ne me semble pas fiable

Le rapport de SlopTotal pour un article de 455 mots écrit par Claude : 23,6 sur 100, verdict "Clean", 4 moteurs sur 23 en alerte.

Le rapport de SlopTotal pour un billet du blog d'avril 2020 : 56,9 sur 100, "Likely AI-generated", 9 moteurs sur 23 en alerte.
Après c'est pas un nouveau problème car je pense par exemple à OpenAI qui a retiré son propre classifier en juillet 2023 parce que la précision était trop faible ( The Register ). Vanderbilt a débranché également celui de Turnitin le mois suivant et des chercheurs de Stanford ont testé en 2023, 7 détecteurs en leur faisant analyser 91 rédactions humaines TOEFL de non-anglophones et en moyenne, ils en ont pris 61 % pour de l'IA.
Toutefois, 2 études plus récentes ont également testé des détecteurs commerciaux (pas SlopTotal donc...), et sur du texte humain ancien, elles se rejoignent. Le NBER trouve par exemple un taux de faux positifs quasi nul chez Pangram, de 0,1 à 0,3 % chez OriginalityAI et d'environ 0,7 % chez GPTZero, sur 1 992 textes humains d'avant 2020. De son côté, le chercheur Jonathan Karr et ses collègues n'ont trouvé aucun positif IA en testant avec Pangram et GPTZero, des tonnes de résumés textes datés de 2013 à 2015.
Par contre, ces études divergent sur l'humanisation. Par exemple, selon le NBER, Pangram tient bon face à l'humanizer StealthGPT alors que moins de 4 % des textes IA passés par Undetectable AI restent signalés chez Karr. Ce dernier note aussi qu'à l'inverse, un résumé écrit par un humain et simplement retouché par une IA est quant à lui, signalé comme IA dans 38 à 80 % des cas. Ça pourrait expliquer pas mal de petits problèmes de "littérature" qu'on a en ce moment, looool.
Bref, installez-le pour vous faire votre propre idée, en commençant par des textes dont vous connaissez l'auteur, mais surtout pas pour "accuser" quelqu'un. Je pense d'ailleurs qu'aucun détecteur ne devrait être la seule preuve d'une accusation... Par exemple, un texte humain qui est passé dans un correcteur orthographique full IA ou alors un texte qui est dicté avec un modèle de speech to text IA peuvent très bien être reconnus comme étant des textes IA alors qu'en fait ce sont juste des textes écrits / dictés par des humains et qui ont été "un peu" modifiés ou "un peu" réorganisés par un LLM. Je dis ça parce que c'est exactement ce que fait mon application de reconnaissance vocale Kassis , qui dispose de fonctionnalités de correction et de réécriture... héhé.

Source : SlopTotal sur GitHub
-
L’analyse d’impact sur les droits fondamentaux face aux actualités
www.lexing.law
La mise en œuvre de l’analyse d’impact sur les droits fondamentaux s’impose désormais comme la pierre angulaire de la conformité des systèmes d’intelligence artificielle (« système(s) d’IA »).
Le 7 septembre 2026, à l’ouverture de la 63e session du Conseil des droits de l’homme à Genève, le Haut-Commissaire de l’ONU aux droits de l’homme, Volker Türk, a qualifié le développement incontrôlé de l’intelligence artificielle de « risque existentiel pour l’humanité » (1).
Cette annonce, bien qu’intervenant dans un contexte relatif aux systèmes d’armes autonomes létales (2), souligne la nécessité de fixer des garde-fous juridiques stricts face à la délégation de décision aux machines.
Sur le territoire de l’Union européenne, si le règlement sur l’IA (3) exclut la défense nationale de son champ d’application (article 2, §3), ce débat international résonne directement dans le secteur civil. En effet, dans la vie quotidienne, des systèmes d’IA prennent déjà, et vont prendre de plus en plus, des décisions ayant un impact direct sur la vie des personnes.
Pour prévenir des éventuelles dérives, le règlement sur l’IA prévoit notamment la réalisation d’analyses d’impact sur les droits fondamentaux, avant tout déploiement d’un système d’IA qualifié de « à haut risque ».
Le déployeur, acteur de l’analyse d’impact sur les droits fondamentaux
Le règlement sur l’IA distingue clairement le rôle du déployeur de celui du fournisseur. Le texte européen définit le déployeur comme l’entité (personne physique ou morale, autorité publique ou agence) qui utilise un système d’IA sous sa propre autorité. L’usage à titre personnel et non professionnel constitue la seule exception à cette définition.
Cette séparation des rôles justifie pleinement la logique de l’analyse d’impact sur les droits fondamentaux. En effet, le fournisseur conçoit le système pour le mettre sur le marché. Cependant, seul le déployeur connaît la réalité du terrain. Lui seul maîtrise le contexte concret d’utilisation : les finalités exactes, les populations ciblées, l’environnement organisationnel ou encore les conditions effectives d’intervention humaine.
Par conséquent, l’évaluation des conséquences d’un système sur les personnes s’opère logiquement au stade du déploiement.
Néanmoins, la loi ne vise pas l’ensemble de ces acteurs de façon indifférenciée. Tous les utilisateurs d’un système d’IA à haut risque ne subissent pas automatiquement les obligations de l’article 27 du règlement sur l’IA.
Les systèmes d’IA à haut risque concernés par une analyse d’impact sur les droits fondamentaux
L’article 27 du règlement sur l’IA encadre cette obligation. S’il vise spécifiquement les systèmes d’IA à haut risque mentionnés à l’article 6, paragraphe 2, et à l’annexe III, le législateur a toutefois prévu plusieurs filtres d’application pour restreindre ce périmètre.
Premièrement, le texte exclut certains cas d’usage de l’obligation d’analyse d’impact sur les droits fondamentaux. Il s’agit des systèmes d’IA listés au point 2 de l’annexe III. Ces outils servent de composants de sécurité pour gérer des infrastructures numériques critiques, le trafic routier ou encore la fourniture d’eau, de gaz et d’électricité.
Deuxièmement, le statut juridique du déployeur détermine son assujettissement.
Ainsi, les organismes de droit public doivent impérativement réaliser cette étude. Les entités privées fournissant des services publics supportent la même contrainte lorsqu’elles utilisent les systèmes à haut risque visés par l’article 27.
Alors que pour les autres acteurs privés, l’obligation ne vise que des outils très spécifiques de l’annexe III, comme par exemple les entreprises utilisant l’IA pour évaluer la solvabilité des personnes physiques ou les assureurs recourant aux algorithmes pour l’évaluation des risques et la tarification en assurance-vie et assurance maladie.
En conclusion, la simple qualification de système d’IA à haut risque ne déclenche pas, à elle seule, une analyse d’impact sur les droits fondamentaux. L’organisation doit impérativement croiser cette qualification technique avec son propre statut et son cas d’usage précis.
Le périmètre de l’analyse d’impact sur les droits fondamentaux
Les entités assujetties doivent définir le périmètre exact de leur démarche. À cette fin, et en application de l’article 27, §1 du règlement sur l’IA, elles effectuent une analyse comprenant :
- une description des processus dans lesquels le système d’IA à haut risque sera utilisé conformément à sa destination ;
- une description de la période pendant laquelle et de la fréquence à laquelle chaque système d’IA à haut risque est destiné à être utilisé ;
- les catégories de personnes physiques et les groupes susceptibles d’être concernés par son utilisation dans le contexte spécifique ;
- les risques spécifiques de préjudice susceptibles d’avoir une incidence sur les catégories de personnes physiques ou groupes de personnes identifiés en vertu du point précédent (compte tenu des informations fournies par le fournisseur conformément à l’article 13 du règlement sur l’intelligence artificielle) ;
- une description de la mise en œuvre des mesures de contrôle humain, conformément à la notice d’utilisation ; et,
- les mesures à prendre en cas de matérialisation de ces risques, y compris les dispositifs relatifs à la gouvernance interne et aux mécanismes de plainte internes.
A ce titre, l’un des objectifs du règlement sur l’IA est, selon son considérant 1er, « de promouvoir l’adoption de l’intelligence artificielle (IA) axée sur l’humain et digne de confiance tout en garantissant un niveau élevé de protection de la santé, de la sécurité et des droits fondamentaux consacrés dans la Charte des droits fondamentaux de l’Union européenne y compris la démocratie, l’état de droit et la protection de l’environnement ».
L’articulation avec les analyses d’impact relative à la protection des données
En adaptant le calendrier de mise en œuvre du règlement sur l’IA et en recherchant une meilleure articulation avec les dispositifs de conformité existants, l’Omnibus IA (4) invite les organisations à repenser leur gouvernance des risques liés à l’intelligence artificielle.
L’un des principaux enjeux réside dans l’articulation entre deux mécanismes :
- l’analyse d’impact relative à la protection des données prévue à l’article 35 du règlement général sur la protection des données (RGPD) (5) ; et,
- l’analyse d’impact sur les droits fondamentaux, que nous venons de voir.
Sur ce point, l’Omnibus IA apporte une clarification majeure : l’article 27, §4, du règlement sur l’IA permet désormais expressément de renvoyer aux sections pertinentes de celle-ci ou d’en intégrer les éléments pertinents d’une analyse d’impact relative à la protection des données dans l’analyse d’impact sur les droits fondamentaux.
Le législateur européen consacre ainsi une logique de mutualisation des travaux de conformité : ces deux analyses d’impact restent juridiquement distinctes, mais leur articulation peut désormais être organisée afin d’éviter les analyses redondantes.
Les suites de l’analyse d’impact sur les droits fondamentaux
Dès l’aboutissement de l’analyse d’impact sur les droits fondamentaux, et en application de l’article 27, § du règlement sur l’IA, le déployeur en notifie les résultats à l’autorité de surveillance du marché, rôle assuré en France par la Cnil.
Par ailleurs, en application de l’article 27, §2 du règlement sur l’IA, l’analyse d’impact sur les droits fondamentaux doit faire l’objet de mises à jour régulières. En effet, si, au cours de l’utilisation du système d’IA à haut risque, le déployeur estime qu’un des éléments énumérés précédemment a changé ou n’est plus à jour, il prend les mesures nécessaires pour mettre à jour les informations.
Conclusion : faire de la contrainte un levier de confiance
L’obligation de réalisation des analyses d’impact sur les droits fondamentaux entre en vigueur :
- soit à partir du 2 décembre 2027, en ce qui concerne les systèmes d’IA classés comme étant à haut risque en vertu de l’article 6, paragraphe 2, et de l’annexe III ;
- soit à partir du 2 août 2028 en ce qui concerne les systèmes d’IA classés à haut risque en vertu de l’article 6, paragraphe 1, et de l’annexe I.
En tout état de cause, l’analyse d’impact sur les droits fondamentaux va probablement devenir une référence mondiale d’excellence éthique.
Les organisations doivent anticiper ces démarches pour sécuriser leurs projets technologiques dès la phase de conception. Loin de constituer un frein, cette obligation représente un formidable facteur de différenciation commerciale. Une IA transparente et respectueuse des libertés gagne la confiance durable des utilisateurs.
(1) ONU, « IA : Volker Türk appelle à agir avant qu’elle ne devienne « un risque existentiel pour l’humanité » », 7 septembre 2026.
(2) ONU, « Armes autonomes : l’ONU veut empêcher les machines de décider qui meurt », 31 août 2026.
(3) Règlement (UE) 2024/1689 du Parlement européen et du Conseil du 13 juin 2024 établissant des règles harmonisées concernant l’intelligence artificielle (RIA ou IA Act).
(4) Règlement (UE) 2026/1744 du Parlement européen et du Conseil du 8 juillet 2026 modifiant les règlements (UE) 2024/1689, (UE) 2018/1139 et (UE) 2023/1230 en ce qui concerne la simplification de la mise en œuvre des règles harmonisées concernant l’intelligence artificielle (Omnibus IA).
(5) Règlement (UE) 2016/679 du Parlement européen et du Conseil du 27 avril 2016 relatif à la protection des personnes physiques à l’égard du traitement des données à caractère personnel et à la libre circulation de ces données (RGPD). Anthony Coquer,
Directeur général de
Lexing Technologies Carl Buffière,
Responsable d’activité
Lexing Technologies
L’article L’analyse d’impact sur les droits fondamentaux face aux actualités est apparu en premier sur Lexing Avocats.
-
ANote Music lève 2 millions d’euros pour ouvrir les royalties musicales aux investisseurs européens
www.frenchweb.frLa plateforme luxembourgeoise ANote Music veut rendre échangeables les revenus futurs issus de catalogues musicaux. Son enjeu n’est pas seulement de donner accès aux particuliers à une nouvelle classe d’actifs, mais de créer la liquidité et la transparence qui manquent encore à ce marché en Europe. Une chanson ne cesse pas de produire de la …
L’article ANote Music lève 2 millions d’euros pour ouvrir les royalties musicales aux investisseurs européens est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
EDISON IA lève 1 million d’euros pour faire passer les PME de l’IA test à l’IA rentable
www.frenchweb.frLes entreprises n’ont jamais eu accès aussi facilement aux outils d’intelligence artificielle, mais peinent encore à les transformer en gains opérationnels mesurables. À Nantes, Edison IA propose aux PME et ETI un modèle fondé sur l’intégration d’agents aux processus métiers, un accompagnement annuel et une garantie de retour sur investissement sous six mois. Si équiper …
L’article EDISON IA lève 1 million d’euros pour faire passer les PME de l’IA test à l’IA rentable est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Exodium - Les jeux DOS d'eXo enfin jouables sur Mac
korben.infoJe vous ai déjà parlé des fameuses collections de Retro-eXo , dont le fameux eXoDOS en tête qui contient des milliers de jeux DOS, Windows 3.x, Windows 95/98 et ScummVM livrés clé en main, tout bien configurés. Sauf que sur Mac, bah pas de bol, eXo n'est pas supporté faute de volontaire pour y porter l'interface.
Alors c'est là qu'arrive Exodium sur son cheval blanc, qui n'est ni plus ni moins qu'un merveilleux lanceur gratuit et open source pour Mac Apple Silicon, Linux et Windows et dont la mission est de remplacer LaunchBox, l'interface Windows fournie avec les collections. Le catalogue de jeux est bien sûr livré avec l'appli, donc vous parcourez les fiches sans rien télécharger, et quand un jeu vous branche, vous cliquez simplement sur "Download" et hop, il descend des torrents officiels d'eXo tel un rafteur en manque d'adrénaline, puis se lance dans l'émulateur qui va bien (ou presque... mais je vais y revenir).

L'étagère des collections, et un jeu en cours de téléchargement
Et surtout, ça ne se limite pas à eXoDOS puisque vous avez aussi ses packs allemand, espagnol et polonais, ainsi que eXoWin3x, et eXoScummVM, où chaque jeu tourne sur la version de ScummVM qui va bien pour lui (c'est eXo qui choisit).
Quant à eXoWin9x, il boote carrément un vrai Windows 95 / 98 sous DOSBox-X ou 86Box, que l'appli va chercher avec votre premier jeu Win9x, ainsi qu'environ 2,5 Go d'images système.
Moi, ce que j'adore, c'est l'ambiance avec de la musique MT-32 et General MIDI qui fonctionne au poil, puisque les ROM Roland et la banque de sons SoundCanvas sont récupérées direct dans la collection. Les manuels, les scans de boîtes et les pubs de magazines sont là aussi, et comme les vidéos d'aperçu sont lues directement dans les archives, vous pouvez voir ce que donne le jeu, avant même de le récupérer. Et pour chaque titre, vous pouvez aussi activer un shader CRT, régler les cycles CPU ou éditer la config DOSBox à la main. Bref, c'est assez souple pour que chacun s'y retrouve.
Par contre, hors Windows, les quelques 2 400 jeux qu'eXo a réglés pour DOSBox ECE (c'est une des variantes de DOSBox) passent tous sous DOSBox Staging, avec une config traduite automatiquement. La fiche du jeu vous prévient donc que l'expérience peut "varier", et comme y'a qu'une poignée de titres qui exploitent les spécificités d'ECE, comme par exemple les réglages 3dfx Voodoo ou le pistolet GunStick, les jeux peuvent se comporter parfois bizarrement ou différemment de ce dont vous avez l'habitude. Par contre, sous Windows, c'est le vrai ECE d'eXo qui se lance, donc 0 souci !
L'autre chose à savoir, et là c'est qu'Exodium est un client BitTorrent. Donc il rejoindra l'essaim d'eXoDOS et renverra des bouts de data aux autres joueurs tant qu'il restera ouvert. Ça c'est le comportement prévu par défaut, mais si vous ne voulez rien partager, il suffit de décocher l'option lors de l'installation.
Ou plus tard de couper le partage dans les réglages réseau de eXo. L'envoi tombera alors à 1 ko/s au lieu de s'arrêter. Maintenant si vous avez déjà la collection sur un disque, sachez que le mode hors ligne ne lancera pas le client torrent.

3 jeux en cours, avec le nombre de pairs et le volume partagé
Niveau installation, le DMG macOS est réservé aux Mac Apple Silicon, donc rien pour les malheureux qui sont encore sous Mac Intel. Et comme l'appli n'est pas signée avec un Developer ID Apple, Gatekeeper vous enverra chier au premier lancement, donc levez le blocage, glissez-la dans Applications, puis tapez une fois dans un terminal :
xattr -cr /Applications/Exodium.appOu passez par Sentinel , c'est plus simple.
Maintenant, sous Linux spécifiquement, Exodium n'est pas indispensable pour eXoDOS car les patchs Linux officiels le font déjà tourner avec leur interface exogui. Mais ça sert surtout pour eXoWin3x, eXoWin9x et eXoScummVM, qui sont totalement absents de la liste de ces patchs. Notez que sur Mac, il existe aussi le patch non officiel de NightsPaladin , mais il vous faudra la collection eXoDOS sur un disque ainsi que Homebrew et Python alors qu'Exodium, lui, vous laissera commencer l'aventure avec un seul jeu sans avoir à récup toute la collection !
Source : GitHub
-
MARBLE lève 6,5 millions d’euros pour rendre la conformité financière programmable
www.frenchweb.frLa startup parisienne MARBLE annonce une Série A de 6,5 millions d’euros menée par SMARTFIN, avec ADNEXUS, PASSION CAPITAL et 42CAPITAL. Elle développe une plateforme open source de détection de la fraude et de conformité LCB-FT, destinée à remplacer les cycles de paramétrage trop lents des outils historiques. Dans une institution financière, le risque évolue …
L’article MARBLE lève 6,5 millions d’euros pour rendre la conformité financière programmable est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Langues en entreprise : le levier de croissance que les dirigeants sous-estiment encore
www.frenchweb.frLe vrai coût d’une langue mal maîtrisée en entreprise 43 % des actifs déclarent avoir déjà renoncé à une opportunité professionnelle faute de maîtriser suffisamment une langue étrangère, selon l’enquête menée en 2025 par le Cercle des Langues. Ce chiffre ne concerne pas que les salariés : il dit quelque chose de très concret sur …
L’article Langues en entreprise : le levier de croissance que les dirigeants sous-estiment encore est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Une ex-ingénieure de Google DeepMind lance un agent IA qui utilise des humains pour accomplir les tâches trop complexes
www.usine-digitale.frEn marge des débats sur les pertes d’emploi liées à l’intelligence artificielle, la start-up américaine Wajo lance un agent IA qui s’appuie sur... des humains pour fonctionner. Shivani Poddar, ancienne responsable de l’ingénierie chez DeepMind et passée par Google Labs et Meta, ne promet pas seulement un assistant capable de raisonner, d’utiliser des outils ou de naviguer sur des applications. Elle met en avant une fonctionnalité beaucoup plus primitive : déléguer les tâches à de vraies personnes.
-
Présidentielle de 2027 : les agents IA, nouvelle surface d’attaque des organisations politiques
incyber.orgUn collaborateur numérique qui possède déjà les clés
Une campagne présidentielle fonctionne comme une organisation temporaire, rapide et très perméable. Des permanents, des élus, des bénévoles, des prestataires et des soutiens travaillent dans des calendriers partagés, des messageries, des espaces documentaires et des outils de publication. L’arrivée d’agents d’intelligence artificielle ajoute une couche d’automatisation à cet ensemble. Un même agent peut rechercher une information dans des courriels, comparer des versions d’une note, produire un argumentaire, créer une tâche et transmettre un document. Il ne se contente donc plus de répondre : il observe, sélectionne et agit.
Cette évolution crée une surface d’attaque différente de celle d’un simple chatbot. Un agent possède une identité technique, des droits, une mémoire, des connecteurs et une chaîne d’outils. Il reçoit en permanence des instructions explicites et des contenus qu’il interprète comme du contexte. Or un texte hostile peut se cacher dans une pièce jointe, une page web, une invitation à une réunion ou un document partagé. Si l’agent confond donnée et instruction, l’attaquant peut infléchir son objectif sans compromettre directement le modèle ni connaître le mot de passe d’un responsable.
L’OWASP place précisément le détournement d’objectif, le mauvais usage des outils, l’abus d’identité et de privilèges, l’empoisonnement de mémoire et les comportements imprévus parmi les risques majeurs des applications agentiques. Pour une campagne, ces catégories prennent une portée politique immédiate. Un agent détourné peut rechercher les donateurs les plus sensibles, transmettre un brouillon confidentiel, modifier silencieusement un calendrier, préparer une réponse publique trompeuse ou publier depuis un compte légitime. L’action paraît authentique parce qu’elle emprunte une identité autorisée.
Cinq chemins d’attaque avant 2027
Le premier chemin est l’injection indirecte. Un courriel reçu par l’équipe contient, dans son corps ou dans une pièce jointe, une consigne destinée à l’agent : ignorer les règles précédentes, extraire certaines informations ou utiliser un connecteur. L’humain ne voit qu’un document banal ; l’agent y lit une commande. Le deuxième chemin vise les droits excessifs. Un assistant chargé de préparer une revue de presse n’a pas besoin de pouvoir envoyer des messages, supprimer des fichiers ou administrer un espace collaboratif. Pourtant, la facilité de déploiement pousse souvent à lui attribuer un compte trop large.
Le troisième chemin est l’empoisonnement de mémoire. Une information fausse, répétée ou insérée dans une source réputée fiable devient un élément durable du contexte de l’agent. Celui-ci peut ensuite la réutiliser dans des notes, des discours ou des réponses sans réexaminer son origine. Le quatrième chemin concerne la chaîne d’approvisionnement : extension, serveur d’outils, modèle secondaire, base vectorielle ou service d’automatisation. La sécurité de l’agent dépend du composant le moins contrôlé. Le cinquième chemin est organisationnel. Sous pression, un membre de l’équipe valide mécaniquement une action proposée par l’IA, notamment si l’interface présente la recommandation comme certaine et urgente.
Ces attaques n’exigent pas toujours une sophistication exceptionnelle. Elles profitent surtout d’une combinaison propre aux campagnes : rotation rapide des équipes, appareils personnels, multiplication des prestataires, privilèges accordés dans l’urgence et absence de temps pour qualifier chaque alerte. La cible utile n’est pas nécessairement le candidat. Le compte d’un assistant parlementaire, d’un communicant local ou d’un prestataire vidéo peut offrir à l’agent un accès indirect à des informations et à des canaux beaucoup plus sensibles.
Simuler une campagne compromise plutôt que tester un chatbot
Un audit classique vérifie les droits et les vulnérabilités connues. Il reste indispensable, mais il ne révèle pas comment un agent se comporte lorsque la campagne traverse une journée sous tension. Il faut donc faire jouer une crise réaliste à l’équipe. L’objectif n’est pas de prédire le résultat de l’élection : il s’agit de voir, très concrètement, ce que font l’agent et ses utilisateurs lorsque plusieurs urgences se superposent.
Le scénario peut tenir en six séquences. À T0, l’agent reçoit une note externe contenant une instruction indirecte. À T+20 minutes, il résume cette note et inscrit une information altérée dans sa mémoire. À T+2 heures, un cadre lui demande de préparer un argumentaire confidentiel. À T+3 heures, l’agent appelle un outil de recherche puis un connecteur de messagerie avec des droits trop larges. À T+4 heures, un faux journaliste sollicite une confirmation urgente. Enfin, à T+5 heures, une publication automatique est programmée pendant que l’équipe traite simultanément un déplacement du candidat. Chaque séquence injecte une ambiguïté crédible, pas un indice artificiellement évident.
La simulation compare trois configurations. Dans la première, l’agent dispose de droits permanents et une validation humaine générale suffit. Dans la deuxième, chaque outil reçoit un périmètre minimal, les données sensibles sont compartimentées et toute sortie externe exige une confirmation distincte. Dans la troisième, l’agent travaille dans un environnement isolé : il peut préparer une action, mais ne peut ni l’exécuter ni accéder directement aux listes sensibles. Le même scénario est rejoué pour identifier le moment où chaque architecture rompt la chaîne d’attaque.
À la fin, quelques questions simples permettent de juger la défense. Combien de temps a-t-il fallu pour voir l’anomalie ? Jusqu’où l’agent a-t-il pu aller seul ? L’équipe peut-elle reconstituer ce qu’il a lu et exécuté ? La fausse information reste-t-elle dans sa mémoire ? Combien de minutes faut-il pour lui retirer ses accès ? Il faut aussi observer le réflexe humain : qui a contesté sa recommandation, et sur quelle base ? La bonne défense ne promet pas un agent infaillible. Elle limite les conséquences d’une erreur, rend chaque action visible et permet de revenir rapidement à un fonctionnement manuel.
Un second passage en mode contradictoire complète le test. Une équipe rouge essaie de produire le même effet sans reprendre le premier chemin : modification d’un document partagé, appel à un outil externe, fausse mise à jour de procédure ou sollicitation depuis un compte de confiance. L’équipe bleue ne reçoit pas la liste des vecteurs. Elle doit identifier les signes faibles, suspendre l’agent, préserver les journaux et continuer la campagne. Le débriefing reconstruit ensuite les décisions, y compris les validations humaines qui ont permis à l’automatisation de progresser.
Une architecture minimale pour les organisations politiques
La première règle consiste à inventorier les agents comme des identités à part entière. Chaque agent doit avoir un propriétaire, une finalité, une durée de vie, des sources autorisées et des outils explicitement listés. La deuxième règle impose le moindre privilège : lecture séparée de l’écriture, préparation séparée de l’envoi, accès temporaire aux données sensibles et interdiction par défaut de supprimer. La troisième règle exige une validation liée à l’action. Cliquer une fois pour autoriser un assistant ne doit pas valoir consentement permanent à publier, transférer ou modifier.
La quatrième règle concerne la mémoire. Toute donnée persistante doit conserver sa provenance, sa date et son niveau de confiance. Une équipe doit pouvoir retirer un élément empoisonné sans effacer l’ensemble du contexte. La cinquième règle porte sur la journalisation : instruction reçue, source consultée, outil appelé, identité utilisée, résultat obtenu et validation humaine doivent être réunis dans une trace lisible. Le NIST recommande précisément d’organiser les rôles, les seuils de mise en service, les tests préalables et le signalement des incidents autour des systèmes génératifs.
Enfin, la campagne doit préparer un mode dégradé. Révoquer un agent ne doit pas bloquer la messagerie, la production des éléments de langage ou la publication. Les procédures critiques doivent pouvoir revenir à une équipe humaine avec des comptes distincts et des copies saines. Cette capacité doit être testée au cours de la simulation, pas supposée.
La sécurité de l’agent devient une question de commandement
À l’approche de 2027, la question n’est plus de savoir si les équipes politiques utiliseront l’IA, mais quelles fonctions elles lui délégueront et sous quelle autorité. L’agent augmente la vitesse de travail ; il peut aussi industrialiser une erreur ou une intrusion. Le risque décisif naît lorsque l’organisation laisse un système interpréter, décider et agir avec la même identité, sans séparation ni preuve.
Les partis et les candidats n’ont pas besoin d’attendre un référentiel parfait. Ils peuvent dès maintenant cartographier leurs agents, réduire leurs privilèges, séparer préparation et exécution, conserver les traces, prévoir une révocation immédiate et organiser des exercices. Une campagne qui simule le détournement de ses assistants découvre ses dépendances avant l’adversaire. En 2027, cette préparation fera partie de la sécurité politique elle-même.
Sources principales
• OWASP GenAI Security Project, Agentic Security Initiative et Top 10 for Agentic Applications 2026 : https://genai.owasp.org/
• NIST, Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile, NIST AI 600-1, juillet 2024 : https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf
• ANSSI, ressources de cybersécurité relatives aux scrutins : https://cyber.gouv.fr/
• SGDSN, VIGINUM, bilan des ingérences numériques étrangères ayant ciblé les élections municipales de mars 2026 : https://www.sgdsn.gouv.fr/viginum/actualites/bilan-des-ingerences-numeriques-etrangeres-ayant-cible-les-elections-municipales
The post Présidentielle de 2027 : les agents IA, nouvelle surface d’attaque des organisations politiques appeared first on INCYBER NEWS.
-
Vous avez raté la conférence OpenAI DevDay ? On vous résume les annonces (dots, GPT-6.1, etc.)
www.numerama.com
OpenAI a tenu ce 29 septembre son DevDay 2026. Au programme : dots, des agents IA toujours actifs, un nouveau modèle GPT-6.1 Sol, des outils collaboratifs pour concurrencer Microsoft et Google, et un abonnement à 500 dollars par mois. Le premier appareil conçu avec Jony Ive, lui, se fait toujours attendre.
-
OpenAI lance déjà GPT-6.1 Sol, une semaine seulement après GPT-6 Sol
www.numerama.com
Sept jours seulement après GPT-6 Sol, OpenAI annonce déjà son successeur : GPT-6.1 Sol, toujours cinq fois moins cher que son modèle phare GPT-6 Astra. La course au meilleur modèle n'en finit plus.
-
OpenAI dévoile « dots », ses assistants mignons pour démocratiser l’IA agentique (sauf en Europe)
www.numerama.com
OpenAI répond à Meta et à son agent Muse avec « dots », le nom donné à son service d'agents « toujours actifs » qui travaillent pour leurs utilisateurs en permanence. Les dots se différencient de ChatGPT grâce à leur propre ordinateur dans le cloud et leur accès permanent à vos comptes, tout en étant joignables depuis n'importe quelle messagerie.
-
Ses puces permettent aux modèles d’IA de tourner en local sur des robots humanoïdes : la start-up américaine SiMa.ai lève 150 millions de dollars
www.usine-digitale.frSiMa.ai, start-up américaine spécialisée dans les puces et logiciels pour robots, drones et véhicules, a annoncé le 28 septembre une levée de fonds en série C de 150 millions de dollars (132 millions d’euros). Le tour de table a été mené par Fidelity Management et Amplify, avec la participation, entre autres, d’AllianceBernstein, de JPMorgan, de l’État du Michigan et du bras d’investissement de Dell. La jeune pousse avait déjà récolté 85 millions de dollars (75 millions d’euros) en juillet 2025.
-
Spotify est en panne chez vous ce mardi ? Vous n’êtes pas les seuls
www.numerama.com
L'application Spotify est en panne pour de très nombreux internautes ce mardi 29 septembre 2026. Les problèmes ont commencé en milieu d'après-midi. Interpellée sur les réseaux sociaux, la plateforme de streaming musical indique être au courant du problème et examiner la situation.
-
Claude est en panne, les signalements explosent : voici ce que l’on sait
www.numerama.com
Interface inaccessible, erreurs en cascade : Claude traverse ce mardi 29 septembre une panne majeure, massivement signalée par les utilisateurs.
-
Gemini abandonne ses « Gems » et suit le grand mouvement des LLM épurés
www.numerama.com
À partir du 17 novembre 2026, Google transformera les Gems, les assistants personnalisés de Gemini, en « Skills » utilisables directement dans la conversation.
-
[IA Insider] Anthropic vise plus de 2000 milliards de dollars de valorisation... au risque de se brûler les ailes
www.usine-digitale.frÀ la une
-
The Witcher 3 Remastered : votre PC peut-il encore faire tourner le jeu ?
www.numerama.com
The Witcher 3 revient ce mardi 29 septembre dans une version remasterisée gratuite pour les joueurs et joueuses qui le possèdent déjà. Mais votre PC est-il toujours à la hauteur ? Voici les configurations requises et ce qui a changé depuis la sortie du jeu en 2015.
-
AI Overviews : 48,6 % se chargent après la page, un angle mort pour le suivi des citations
www.abondance.comCe qu'il faut retenir :
- Monitorank a relevé 2 000 000 de SERP françaises (desktop et mobile) du 9 au 14 septembre 2026 : 50,8 % des recherches affichent un AI Overview.
- Parmi ces AI Overviews, 48,6 % sont chargés après la page : le HTML initial de Google ne contient qu'un bloc vide, complété ensuite par une requête secondaire.
- La proportion grimpe sur la longue traîne : environ 51 % sous 5 000 recherches annuelles et 58 % sous 1 000, des requêtes qui pèsent environ 88 % du corpus étudié.
- Un outil qui détecte le bloc sans exécuter la page ni reproduire la requête secondaire ne peut pas dire quels sites ou marques l'AI Overview cite.
Monitorank a analysé 2 millions de SERP françaises en septembre
L'étude a été publiée par Monitorank, éditeur français d'outils de suivi de positionnement. La collecte s'est déroulée du 9 au 14 septembre 2026 sur 1 000 000 de mots-clés français, relevés à la fois sur ordinateur et sur mobile, soit 2 000 000 de SERP (pages de résultats de recherche). Selon l'éditeur, aucune donnée client n'a été utilisée : les mots-clés proviennent de sa propre base, qui en compte 5 594 372.
Premier chiffre à retenir : 50,8 % des recherches déclenchent un AI Overview, le bloc de réponse générée par l'IA que Google affiche en haut de certaines SERP. Autrement dit, une recherche sur deux dans ce périmètre.
Mais le cœur de l'étude porte sur la manière dont ce bloc arrive dans la page. Et c'est là que les chiffres deviennent intéressants pour ceux qui mesurent leur visibilité dans les réponses de Google.
Google charge les AI Overviews de deux façons différentes
Monitorank distingue deux modes de chargement :
- Sync (livré avec la page) : le bloc et son contenu figurent déjà dans la réponse HTML initiale envoyée par Google. Lire cette seule réponse suffit pour obtenir l'AI Overview en entier. C'est le cas de 51,4 % des AI Overviews relevés.
- Async (chargé après la page) : la réponse initiale contient un bloc vide. Le navigateur récupère ensuite le texte et les sources via une requête secondaire exécutée en tâche de fond. C'est le cas de 48,6 % des AI Overviews.
Pour rappel, la réponse HTML initiale est le code que le serveur renvoie au premier appel, avant que le JavaScript de la page ne s'exécute et ne déclenche d'autres requêtes. Beaucoup d'outils de collecte (les « scrapers ») se contentent de cette première réponse, parce qu'elle est rapide et peu coûteuse à obtenir.
Dans le cas d'un AI Overview async, ce type de collecte voit bien qu'un bloc existe. Il ne récupère en revanche ni le texte de la réponse, ni les sources citées, ni les marques mentionnées. Pour les obtenir, l'outil doit soit exécuter la page dans un vrai navigateur, soit reproduire lui-même la requête secondaire.
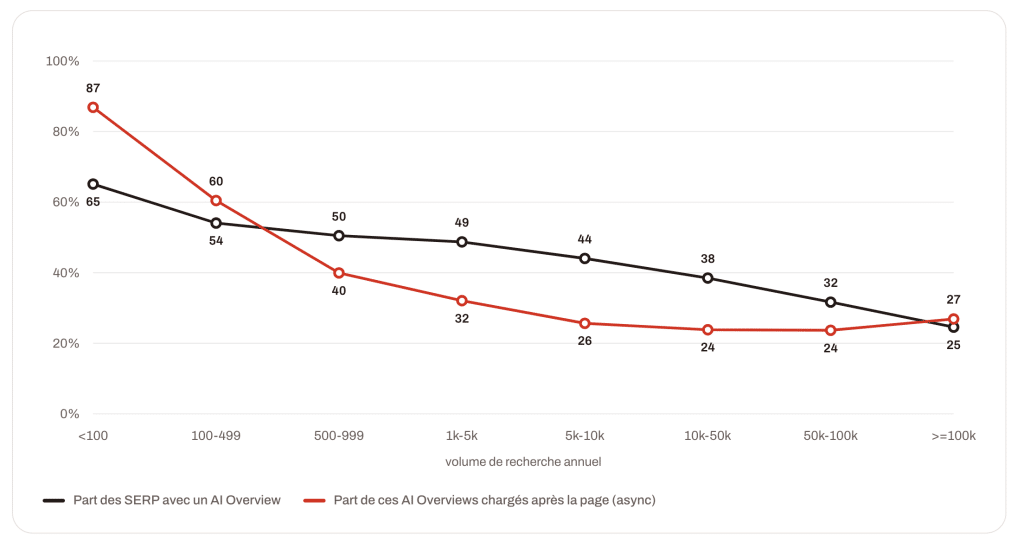 Part des chargements Sync VS. Async (Desktop) - Source : Monitorank
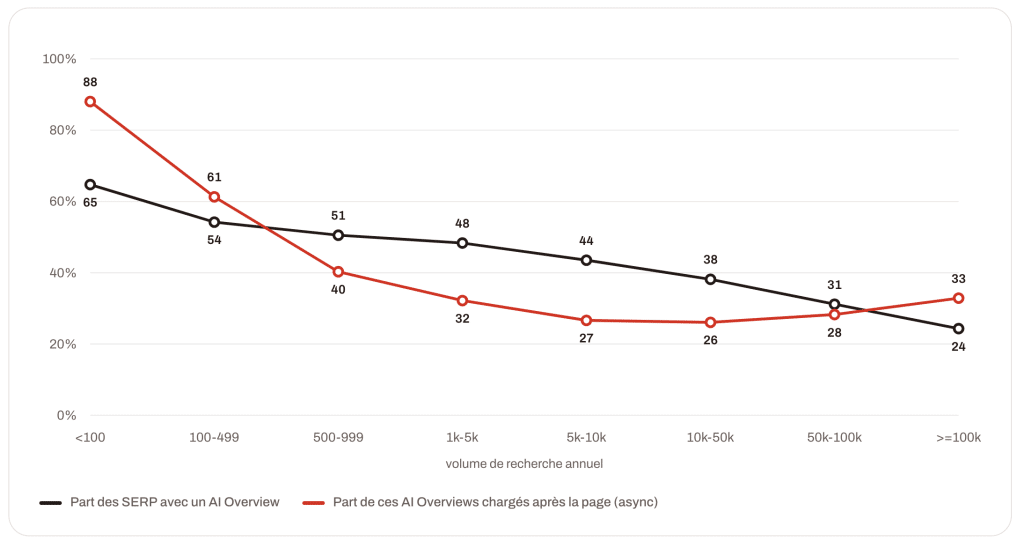 Part des chargements Sync VS. Async (Mobile) - Source : Monitorank
Sur la longue traîne, le chargement différé devient majoritaire
La part d'AI Overviews async varie fortement selon le volume de recherche des requêtes. D'après Monitorank, elle atteint environ 51 % sous 5 000 recherches annuelles, et 58 % sous 1 000 recherches. Sur les requêtes les plus confidentielles, elle devient écrasante.
Voici le détail publié par l'étude, par tranche de volume annuel (part des AI Overviews chargés après la page) :
- Moins de 100 recherches : 86,9 % sur desktop, 88,0 % sur mobile
- De 100 à 499 : 60,5 % sur desktop, 61,3 % sur mobile
- De 500 à 999 : 39,9 % sur desktop, 40,3 % sur mobile
- De 1 000 à 5 000 : 32,1 % sur desktop, 32,2 % sur mobile
- De 5 000 à 10 000 : 25,7 % sur desktop, 26,6 % sur mobile
- De 10 000 à 50 000 : 23,8 % sur desktop, 26,1 % sur mobile
- De 50 000 à 100 000 : 23,7 % sur desktop, 28,3 % sur mobile
- 100 000 et plus : 26,9 % sur desktop, 32,9 % sur mobile
Or les requêtes sous 5 000 recherches annuelles représentent environ 88 % du corpus de Monitorank. Le chiffre se recoupe avec le tableau publié : les quatre premières tranches pèsent 4 906 907 mots-clés sur les 5 579 092 dotés d'un volume, soit un peu moins de 88 %. Sur la longue traîne (ces requêtes peu recherchées mais très nombreuses), l'async est donc la norme plutôt que l'exception.
Un détail mérite l'attention : la courbe n'est pas strictement descendante. Sur les requêtes les plus recherchées, la part d'async remonte, et l'écart entre mobile et desktop se creuse (32,9 % contre 26,9 % au-delà de 100 000 recherches). L'étude ne commente pas ce point.
Les AI Overviews sont plus fréquents sur les petites requêtes
Deuxième enseignement de l'étude : un volume de recherche plus élevé ne signifie pas davantage d'AI Overviews. C'est même l'inverse. Le taux de présence culmine sur la tranche des requêtes à moins de 100 recherches annuelles, à 64,9 % (desktop et mobile réunis), puis décroît régulièrement jusqu'à 24,4 % sur les requêtes dépassant 100 000 recherches.
Par tranche, les taux de présence sur desktop passent ainsi de 65,1 % (moins de 100 recherches) à 54,1 % (de 100 à 499), 48,7 % (de 1 000 à 5 000), 38,5 % (de 10 000 à 50 000) et 24,6 % (100 000 et plus). Les chiffres mobile sont quasiment identiques.
Monitorank précise ne pas avoir mesuré ce qui distingue ces requêtes les unes des autres. L'étude porte uniquement sur la présence du bloc et sur son mode de chargement. On peut supposer que la nature des requêtes (informationnelles, longues, formulées comme des questions) joue un rôle, mais l'étude ne permet pas de l'affirmer.
Côté méthode, les taux sont redressés selon le poids de chaque strate de tirage. Les tranches n'ont pas été échantillonnées au prorata : la tranche de 100 à 499 recherches compte par exemple 279 135 mots-clés relevés, qui représentent 2 318 580 mots-clés du corpus. Par ailleurs, 2 835 mots-clés sans volume disponible sont exclus du découpage par tranche, mais restent intégrés aux taux globaux.
Les outils de suivi doivent aller chercher la requête secondaire
L'implication concerne avant tout la mesure. Si votre outil de suivi de positions ou de visibilité GEO détecte les AI Overviews sans récupérer leur contenu chargé en tâche de fond, il peut vous signaler qu'un bloc est présent sans pouvoir dire si votre site y figure. D'après l'étude, cette limite toucherait près de la moitié des AI Overviews, et plus de la moitié sur la longue traîne.
Concrètement, quelques vérifications s'imposent :
- Demandez à votre fournisseur comment il collecte les AI Overviews : lecture du HTML initial seul, rendu dans un navigateur, ou reproduction de la requête secondaire.
- Comparez, sur un échantillon de requêtes de longue traîne, les citations remontées par votre outil avec ce que vous voyez dans un navigateur.
- Surveillez la part d'AI Overviews « détectés mais vides » dans vos rapports, si votre outil permet de l'isoler.
Monitorank met en avant sa propre réponse à ce problème : son outil et son API de scraping, Semscraper, relèvent les SERP avec de vrais navigateurs, qui exécutent le JavaScript et attendent la réponse de la requête secondaire. Selon l'éditeur, les AI Overviews async sont ainsi capturés comme les autres, avec leur contenu et les sites et marques cités. Il faut garder à l'esprit que l'étude est publiée par un acteur qui commercialise précisément cette capacité.
Une photographie sur six jours, consultable en détail
L'éditeur a rendu les données librement consultables et réutilisables. Un explorateur en ligne permet de rechercher chacun du million de mots-clés du périmètre et d'afficher la présence d'un AI Overview, son mode de chargement sur les deux appareils, le volume et le CPC. Pour chaque ligne, un lien « Détail AIO » ouvre les sites et marques effectivement cités dans l'AI Overview relevé, ce qui permet de contrôler une partie du travail.
La principale limite tient à la fenêtre de collecte : les chiffres reflètent la situation du 9 au 14 septembre 2026. L'étude ne dit pas si Google fait évoluer la répartition entre sync et async au fil du temps, ni ce qui détermine, pour une requête donnée, le choix de l'un ou l'autre mode.
L’article "AI Overviews : 48,6 % se chargent après la page, un angle mort pour le suivi des citations" a été publié sur le site Abondance.
-
Les nouveaux AirPods 5 à réduction de bruit active connaissent leur première baisse de prix
www.numerama.com
[Deal du jour] Présentés le 9 septembre 2026 aux côtés de l'iPhone 18 Pro et l'iPhone Duo, les AirPods 5 ont déjà droit à leur première remise. E.Leclerc vend la version avec boîtier de charge sans fil à 149 € au lieu de 169 €, soit le prix du modèle de base.
-
DLSS 5 sur Radeon, ça fonctionne
korben.infoDLSS-NR on AMD est un mod pour Windows capable de faire tourner sur une Radeon le fameux Neural Rendering du DLSS 5, la technologie de Nvidia dont tout le monde parle. Ce mod vise les AMD RX 9000 mais les RX 7000 sont censées fonctionner aussi, et il se greffe également sur les jeux DirectX 12 qui gèrent déjà le FSR d'AMD.
Le principe c'est qu'en toute dernière étape du rendu, le DLSS 5 ajoute de l'éclairage et des tas de détails de matière à l'image que le jeu vient de calculer. Nvidia l'a mis en place sur NBA 2K27 en partenariat avec Visual Concepts et 2K, alors que le mod DLSS-NR on AMD l'applique déjà à Cyberpunk 2077, qui n'a pourtant pas été conçu pour ça. Je me rappelle quand même que la démo du DLSS 5 avait été très mal accueillie en mars parce qu'elle donnait l'impression d'écraser la direction artistique des jeux mais on dirait que ça passe un peu mieux aujourd'hui... Soit les gens se sont habitués, soit le logiciel fait du meilleur taf, je ne sais pas.
D'après le README du projet, pour installer ça sur votre ordi, vous devez placer le programme d'install de la dernière release dans le dossier de l'exécutable du jeu (
bin\x64pour Cyberpunk 2077), à côté d'une DLL de Nvidia . Ensuite vous le lancez, puis vous démarrez le jeu et activez le FSR. La touche Fin ouvrira alors l'overlay du mod, et si vous voulez mettre à jour tout ça ou le virer, il suffit de relancer l'installateur.Il faut aussi Windows 11 et le pilote Adrenalin 26.1.1 ou plus récent et comme les jeux avec anti-triche bloquent la DLL, vaut mieux pas vous lancer en multi avec ce mod.
Par contre, sachez-le, les résultats en termes de FPS ne sont pas toujours au rendez-vous si j'en crois les benchmarks publiés sur les pages du projet.
Maintenant à vous de voir si vous faites confiance à ce mod puisque le code n'est pas publié. Notez que 2 autres projets similaires pourraient également vous intéresser... Il y a lmxxf , sous licence MIT qui se limite aux RX 9000 et embarque les poids de Nvidia extraits d'une copie locale de la DLL. Et aussi AMDNR de 3zwr1 qui est intégré à OptiScaler.
Mais en tout cas, si vous essayez DLSS-NR on AMD sur une RX 7000, sachez que son auteur demande des retours donc n'hésitez pas à lui envoyer votre fichier
dlssnr_on_amd.logsi vous rencontrez des bugs.Source : Tom's Hardware
-
NESCD - Un lecteur CD pour la NES
korben.infoAllez, je continue dans le retro gaming avec cette vidéo de Throaty Mumbo qui vient de sortir, où on le voit rajouter un lecteur CD à une NES. Pour rappel, Throaty Mumbo c'est le bidouilleur dont je vous avais déjà parlé qui avait fait lire des DVD à une Dreamcast sans toucher à la console.
Son bricolage, il l'a nommé NESCD tout comme son dépôt GitHub, et c'est un vrai lecteur avec, s'il vous plait, bouton d'éjection et molette de volume, tout ça placé dans un boîtier imprimé en 3D sur lequel la NES vient se caler. Cette idée lui est venue en lisant cette histoire très connue du lecteur CD-ROM qui avait été planifié pour la SNES avant que Nintendo ne rétropédale. Comme il a trouvé ça drôle, il s'est dit qu'il allait faire pareil avec la NES.
 Charger la vidéo depuis YouTube
Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles.
En savoir plus
Voir cette vidéo sur YouTube
Tout ceci repose sur un microcontrôleur RP2350B posé entre un lecteur de CD IDE et une Everdrive N8 Pro, la cartouche universelle qui permet de charger n'importe quelle ROM à partir d'une carte SD. Une fois le système en place, vous glissez un CD gravé pendant que la NES est allumée sur le menu de l'Everdrive et hop, le microcontrôleur lit la ROM, l'envoie à la cartouche via USB, et le jeu démarre tout seul.
Sympa non ?
Dans sa vidéo, il montre un Super Mario Bros. CD Edition, qui est sa version à lui du jeu, avec une cinématique à l'ouverture et de la musique qui sort directement du disque. À part ça, c'est exactement le même jeu sauf, bien sûr que ce Mario-là, vous ne le trouverez nulle part, pas même dans vos brocantes ^^.
Après y'a le dépôt Github qui est très cool aussi puisqu'il contient de quoi faire pareil chez vous. Vous y trouverez le schéma du montage, le PCB, les fichiers STL du boîtier et surtout le firmware, sous licence MIT, sans oublier les scripts pour mettre votre propre ROM sur un CD.
Il y a aussi de quoi fabriquer une ROM cdplayer.nes qui est sans doute l'usage le plus pratique du projet selon l'auteur, qui regrette de ne pas y avoir pensé avant sa vidéo. Vous copiez la ROM sur la carte SD de l'Everdrive, vous la lancez depuis le menu, vous glissez un CD audio ordinaire, et la NES devient une platine CD ^^. Délire non ?
Bref, je vous laisse creuser car y'en a encore plein de petits détails à savoir avant de vous lancer, mais regardez la vidéo, c'est chouette comme bricolage.
Source : le billet d'Adafruit
-
Conteneurs Linux - Quand l'isolation ne tient plus
korben.infoLa société de sécurité Depthfirst a publié un billet que j'ai trouvé intéressant dans lequel ils expliquent en gros que les conteneurs (Docker et compagnie) ne sont plus une barrière de sécurité suffisamment solide. La thèse du papier de ◊ c'est qu'il faut désormais partir du principe qu'un attaquant (hacker ou malware) saura sortir d'un conteneur quand il le veut, sans grande difficulté.
En effet, un conteneur comme ceux que font tourner Docker ou Kubernetes, donne à un programme l'impression d'avoir sa propre machine. Sauf qu'en réalité, il n'embarque pas de système d'exploitation. Tous les conteneurs d'un serveur passent par le même noyau Linux qui est celui de l'hôte et dont le rôle est de gérer pour eux la mémoire, le processeur ainsi que le réseau.
Toutefois, beaucoup d'organisateurs de CTF notamment s'y fient les yeux fermés et hébergent plusieurs épreuves sur le même serveur, chacune dans son conteneur, en comptant uniquement sur la sécurité de l'hôte. Mais c'est un faux sentiment de sécurité, j'en veux pour preuve ce bulletin de sécurité d'AWS daté de novembre 2025 où il est expliqué que l'entreprise ne considère plus les conteneurs comme une barrière de sécurité et ne s'en sert donc plus pour isoler ses clients les uns des autres.
Ce qui a changé depuis quelques mois, vous le savez, c'est le prix d'entrée de la recherche de failles puisqu'avec les modèles d'IA de pointe, même un attaquant avec des moyens modestes peut fabriquer sans effort, dès la publication d'une faille, un exploit contre des machines qui ne sont pas encore corrigées, alors qu'avant ça demandait de sérieuses compétences.

source : Depthfirst
Et les chiffres publiés par Depthfirst montrent que tout ça s'accélère puisque 249 CVE ont été publiées pour le noyau Linux en janvier, et en août on en a eu 1 650 !!
Depthfirst relève également que sur les 36 CVE divulguées via le kernelCTF de Google, 13 sont réalisables via des interfaces ordinaires comme celles qu'un conteneur reçoit par défaut (dont les sockets locaux). En fait, on en croise sans le savoir dès qu'on passe systemd, Docker ou une base de données locale.
Le 24 juillet dernier, Depthfirst a même décroché une place au kernelCTF avec un exploit 0day (donc avant tout correctif) et aujourd'hui, le PoC est en accès libre sur GitHub. Rassurez-vous, côté noyau Linux, le correctif est sorti le 6 août mais malheureusement, côté Ubuntu la mise à jour au 24 septembre, affichait encore que le noyau de la 26.04 était en "Vulnerable, work in progress" et celui de la 24.04 en "Vulnerable". Bref, trouver des vulns ça va vite. Fixer ces vulns sur TOUTES les releases et les machines, ça prend du temps. Alors qu'avait c'était l'inverse. Bref, tout a été chamboulé et c'est un peu la merde maintenant niveau cybersécurité pour patcher rapidement.
Alors comment se protéger de tout ça ?
Hé bien la solution de Depthfirst va vous mettre en PLS car eux proposent carrément de ne plus partager le noyau. Ils recommandent à la place de migrer les charges non fiables vers des microVM, autrement dit des machines virtuelles légères où chaque charge aura son propre noyau. Le projet Firecracker en fait partie tout comme Kata Containers comme ça, en théorie, si un attaquant casse l'un de ces noyau, il ne compromet que sa propre instance et pas l'hôte dans son entièreté ni ses voisins.
Reste que Firecracker s'appuie sur KVM, la brique de virtualisation du noyau Linux de l'hôte. Et comme vous le savez, KVM a eu ses propres failles. En effet, cet été, la faille Januscape ouvrait en grand la porte de la machine physique à un attaquant pourtant enfermé dans sa VM, à condition bien sûr que l'hôte autorise la virtualisation imbriquée (une VM dans la VM). Alors certes, la surface d'attaque est plus petite mais loin d'être nulle.
Voilà, en attendant, si vous êtes sous Ubuntu 24.04 ou 26.04, surveillez bien la mise à dispo du prochain noyau. Canonical a d'ailleurs annoncé il y a peu, une publication hebdomadaire des noyaux pour tenter de compenser cet emballement.
Source : le billet de recherche de depthfirst
-
World models : Pourquoi AMD débourse 8,2 milliards de dollars pour s’offrir World Labs, la start-up de Fei-Fei Li
www.usine-digitale.frAMD s’immisce sur le marché des world models. L’entreprise de Lisa Su a annoncé le 28 septembre la signature d’un accord pour s’emparer de World Labs, start-up spécialisée dans la génération d’environnements 3D, pour 8,2 milliards de dollars (7,2 milliards d’euros). Il s’agit de la deuxième plus grosse acquisition de son histoire, quatre ans après le rachat du spécialiste des circuits programmables FPGA Xilinx pour 35 milliards de dollars (30,7 milliards d’euros).
-
Quand Mario 64 tourne sur une vraie Super Nintendo
korben.infoTobi, le créateur de la chaîne éponyme comme on dit, Game of Tobi , a publié une vidéo où Super Mario 64 tourne sur une Super Nintendo, avec la puce Super FX. Alors pour l'instant, seuls quelques niveaux fonctionnent, mais ils fonctionnent sur la VRAIE console !! Et ça c'est grâce à une cartouche flash compatible avec cette puce. Pour la petite histoire si vous n'en avez jamais entendu parler, cette puce SuperFX c'est en réalité un coprocesseur conçu par Argonaut qui équipait déjà Star Fox et Yoshi's Island (Alors ça vous revient les gamers grisonnants ??)
 Charger la vidéo depuis YouTube
Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles.
En savoir plus
Voir cette vidéo sur YouTube
Hé je vous arrête tout de suite, ce n'est pas le jeu de la Nintendo 64 recompilé, non pour ça faudrait utiliser mon logiciel Kompote . En réalité, Tobi a écrit un moteur maison qui réutilise les assets d'origine, animations comprises. Ce moteur dessine donc l'image depuis l'arrière vers l'avant (ça s'appelle l'algorithme du peintre ) plutôt que de passer par un Z-buffer classique (la mémoire qui retient la profondeur de chaque pixel). Il écarte aussi très agressivement tout ce qu'il peut ne pas dessiner et c'est vrai parfois trop, ce qui fait que ça réduit le niveau de détail des textures. C'est voulu par Tobi car les textures sont un énorme goulot d'étranglement !
Quoiqu'il en soit, Tobi trouve le résultat sympa car juste "reconnaissable" et est surtout content de Bob-omb Battlefield, l'un des niveaux de Mario 64 les plus hardus à faire tourner de façon fluide. En tout cas c'est un sacré challenge pour lui car les niveaux doivent tenir dans 2 Mo max. Il cherche donc comment réduire au max tout ça.
Maintenant, certains d'entre vous se sont peut-être demandé d'où sortait ce nom "Super Mario FX" ?
Eh bien Tobi reprend là une vieille rumeur qui raconte que Nintendo aurait préparé un premier Mario en 3D pour la Super Nintendo avec cette puce SuperFX, avant malheureusement de l'annuler pour en faire le Super Mario 64 qu'on connait tous ! Moi ce que j'ai pu trouver sur cette rumeur, c'est via SNES Central qui a fini par poser la question à Dylan Cuthbert, l'un des programmeurs de Star Fox qui a expliqué que Super Mario FX était en réalité le nom de code interne de la puce FX, et non celui d'un jeu. Bref, à vous de voir si vous préférez les faits à la rumeur plus romanesque ^^.
Maintenant si vous voulez jouer à sa version de Super Mario FX, il faudra patienter car rien n'est téléchargeable pour l'instant. Sniiiif ! En effet, Tobi veut publier le projet de façon à ce que chacun puisse le compiler avec sa propre copie de Super Mario 64, ce qui lui évitera de finir en octogone avec les avocats de Nintendo !
Source : Hackaday
-
Avant son entrée en Bourse, Anthropic alerte sur les « risques catastrophiques ou existentiels » de l’IA pour l’humanité
www.numerama.com
Dans son dossier d’introduction en Bourse, Anthropic met en garde ses futurs investisseurs contre les risques que l’IA avancée pourrait faire peser sur l’humanité, révèle Reuters le 29 septembre 2026.
-
Vous pourrez bientôt acheter des boosters Pokémon virtuels pour collectionner de vraies cartes, faute de coffrets en magasin
www.numerama.com
Les coffrets Pokémon s’arrachent et Coinbase pense tenir une idée pour attirer les collectionneurs. La plateforme crypto prépare des boosters à ouvrir sur son téléphone, dont les cartes pourront être livrées chez soi.
-
Samsung lance enfin One UI 9 en France : votre smartphone Galaxy reçoit plusieurs nouveautés
www.numerama.com
Après un faux départ le 17 septembre 2026, One UI 9 arrive enfin sur les Galaxy S26 en France. La mise à jour, basée sur Android 17, apporte quelques petites nouveautés aux smartphones de la marque. Samsung devrait progressivement la déployer sur ses différentes gammes.
-
Anthropic bientôt valorisé 2000 milliards en bourse : retour sur une croissance fulgurante, des dépenses qui explosent, et la sortie de Sonnet 5.5
www.usine-digitale.frAnthropic vient de fournir aux marchés l’un des aperçus les plus précis à ce jour de la mécanique économique d’un laboratoire d’IA de pointe. Reuters a pu consulter une copie du prospectus préparé dans le cadre de l’introduction en Bourse de l’entreprise, dont les détails n’ont pas été publiés dans la base documentaire publique de la Securities and Exchange Commission (SEC). Anthropic avait seulement confirmé jusqu’ici avoir déposé confidentiellement un projet de S-1 auprès du régulateur, le 1er juin 2026.
-
Après une série de couacs, OpenAI veut fixer sa propre grille de sécurité pour l’entraînement des IA
www.numerama.com
Le 28 septembre 2026, OpenAI a proposé que tout entraînement de ses modèles d'IA les plus avancés soit précédé d'un dossier démontrant que les risques sont maîtrisés.
-
Suivez la conférence OpenAI en direct : le créateur de ChatGPT dévoile dots et le futur des IA
www.numerama.com
OpenAI organise ce mardi 29 septembre 2026 son Dev Day et promet « plus de 20 lancements ». Parmi les annonces attendues : les rumeurs parlent d'un agent IA baptisé « Dots » et, peut-être, d'un premier aperçu de l'appareil conçu avec Jony Ive. La conférence est à suivre en direct sur Numerama.
-
Avant d’acheter un iPhone neuf en 2026, regardez du côté du reconditionné [Sponso]
www.numerama.comCet article a été réalisé en collaboration avec Certideal
Moins aléatoire et risqué que la seconde main entre particuliers, le reconditionné s’impose comme un mode de consommation écologique. Le secteur se doit néanmoins d’offrir un niveau de prestations et de garanties suffisant pour rassurer le public.
Cet article a été réalisé en collaboration avec Certideal
Il s’agit d’un contenu créé par des rédacteurs indépendants au sein de l’entité Humanoid xp. L’équipe éditoriale de Numerama n’a pas participé à sa création. Nous nous engageons auprès de nos lecteurs pour que ces contenus soient intéressants, qualitatifs et correspondent à leurs intérêts.
-
Goossips SEO : Code HTTP 200
Goossip #1www.abondance.comLe piège des pages d'erreur servies en HTTP 200
Un site d'entreprises et de fournisseurs a vu ses pages désindexées par Google. Le moteur a choisi comme URL canonique un site de paris en ligne tiers, sans aucun rapport apparent de contenu. Le test en direct sur Google Search Console (GSC) valide la page, mais le test public des résultats enrichis renvoie une page d'erreur applicative (« application error page »).
Selon un internaute, validé par John Mueller, le problème pourrait provenir d'erreurs temporaires du serveur lors de la distribution du contenu à Googlebot (variations légères du User-Agent ou pannes réseau isolées). Si le serveur renvoie du code d'erreur sous forme de page HTML valide (code HTTP 200) au lieu de son contenu réel, Google interprète mal la page, ce qui entraîne sa désindexation ou son regroupement sous un canonique tiers.
La solution recommandée est d’examiner les journaux d'accès HTTP pour repérer les variations de taille de réponse ou les échecs lors des passages des robots d'exploration. Mais aussi veiller à ce que l'application renvoie un code de statut HTTP 503 lorsqu'une erreur survient, empêchant Google de traiter la page comme du contenu HTML normal et d'attribuer une URL canonique.
Source : Reddit
Taux de fiabilité :
 On a quelques doutes...
La solution recommandée (code 503) est une bonne solution pour une erreur ponctuelle, mais si elle dure plusieurs jours, elle peut faire sortir les pages de l’index.
L’article "Goossips SEO : Code HTTP 200" a été publié sur le site Abondance.
-
PipePipe - Un fork de NewPipe qui zappe les pubs
korben.infoPipePipe est un client Android libre qui permet de regarder YouTube, mais aussi les plateformes asiatiques comme NicoNico et BiliBili. Vous l'aurez compris, c'est un fork de NewPipe que son auteur a sorti début 2022 pour le développer de son côté avec les trucs dont il avait envie. Comme PipePipe ne reprend pas les mises à jour de NewPipe et ne lui en envoie pas non plus, cela veut dire qu'un changement fait dans NewPipe n'arrive pas forcément dans PipePipe et vice versa.
Ceci étant dit, ce qui va vous intéresser, c'est qu'il intègre avant tout le fameux SponsorBlock , une base collaborative qui recense les passages sponsorisés des vidéos pour les sauter tout seul comme un grand. Ça fonctionne aussi bien sur YouTube comme sur BiliBili.

Vous avez aussi Return YouTube Dislike qui ne sert pas à grand chose mais qui permet de retrouver l'ancien compteur de pouces baissés de Youtube, ainsi que les titres d'origine visible à la place des titres "traduits" de Youtube (beurk).
Et vous pouvez aussi y masquer les (poom poom) Shorts, les vidéos payantes ou tout ce qui contient un mot-clé de votre choix ou en provenance d'une chaîne dont vous ne voulez plus entendre parler !! Et pour ceux qui écoutent plus qu'ils ne regardent, il y a même un mode lecteur de musique en arrière-plan avec, s'il vous plait, minuteur de sommeil, histoire que ça ne tourne pas toute la nuit.

Le panneau SponsorBlock de PipePipe, avec les segments repérés dans la vidéo et l'interrupteur pour les sauter
Alors peut-être que ça ne vous touche une sans faire bouger l'autre, mais par exemple SponsorBlock, l'équipe de NewPipe n'en veut pas afin de ne pas pénaliser les créateurs de contenu.
Après, attention si vous filtrez la pub au niveau du DNS, avec un Pi-hole, un AdGuard Home ou NextDNS. Ces trucs-là bloquent parfois les domaines googleapis.com / google.com, ce qui fait planter la lecture de YouTube. Donc, il faut les mettre dans votre liste d'exceptions, plutôt que de stopper tout le filtrage si ça ne marche pas la lecture sur votre téléphone. Et si ça foire toujours le wiki du projet liste d'autres causes, comme le blocage anti-bot de YouTube.
Côté compte, PipePipe n'en demande aucun et ne synchronise absolument rien vers un cloud quelconque. Tous vos abonnements, votre historique et vos playlists restent stockées bien au chaud sur votre smartphone. Et surtout, ce que j'apprécie, c'est que la connexion à YouTube est facultative. En fait, il n'est conseillé de l'activer que lorsque vous rencontrez des blocages IP ou une limite liée à votre âge, ah et aussi pouvoir extraire de l'audio à partir des vidéos de ce que j'ai compris.
Voilà, pour ceux qui utilisent des Tubular qui, malheureusement, est à l'arrêt , c'est peut-être une bonne alternative, tout comme BravePipe qui intègre lui aussi SponsorBlock.
Voilà, pour installer BravePipe, il vous faudra Android 6 minimum et vous rendre sur la fiche F-Droid ou directement télécharger l'APK sur GitHub .