Tech-fr publisher
-
L’IA peut-elle analyser des données de santé sans déplacer les dossiers des patients ? L’Estonie veut le vérifier avec la plateforme d’Owkin
www.usine-digitale.frL’Estonie cherche à tirer parti de ses données de santé pour la recherche biomédicale avec l’aide d’Owkin. La start-up française et Metrosert, l’organisme public estonien de recherche appliquée, annoncent ce 29 septembre une collaboration autour de la plateforme d’IA « K Pro ».
-
PS5 - Streamer sur Discord sans carte d'acquisition
korben.infoHier, le bidouilleur Yash Garg a publié sur son blog une astuce incroyable permettant de diffuser le contenu de sa PS5 sur Discord sans avoir besoin de carte d'acquisition. Son astuce c'est tout simplement de faire croire à sa console que son Mac EST le serveur de Twitch qui doit recevoir la vidéo et comme j'ai trouvé ça cool, je vous explique.
Le point de départ en fait, c'est que Yash diffuse souvent ses parties à des potos sur Discord. Pourtant, cette bonne vieille PS5 ne sait pas partager le stream de ses jeux aussi facilement. Elle peut juste diffuser par défaut vers YouTube et Twitch, à condition d'y être connecté via une option prévue pour ça par Sony. Cela veut dire que pour streamer vers Discord, sa seule vraie option c'est donc la carte d'acquisition, mais celles qui marchent bien coûtent un rein et notre ami ne voulait pas investir.
Il s'est donc mis à utiliser Remote Play qui permet de jouer à la PS5 depuis un Mac. Grâce à ça, la console se connecte à son MacBook et il partage l'écran du Mac sur Discord. Sauf que cela exige de brancher la manette et les écouteurs sur le Mac, et en plus, parfois ça lag de fou au niveau des commandes. Sans parler de la qualité de l'image, qui est choisie par la console, sans possibilité de réglage par l'utilisateur. Pas cool.
Alors, il a imaginé une solution qui je pense va vous intéresser si vous voulez streamer vos parties de PS5 ailleurs que sur Twitch et Youtube. En fait, comme la PS5 ne connaît pas par cœur l'adresse de Twitch, elle la demande aux serveurs DNS à chacune des diffusions. Du coup, celui qui contrôle ce DNS contrôle où se dirige le flux. Yash a donc monté sur son Mac un petit serveur DNS maison qui renvoie tout simplement l'adresse IP du Mac à la place de celle de Twitch.

Il a ensuite paramétré son routeur (un GL.iNet sous OpenWrt) pour forcer l'utilisation de ce DNS pour sa console, sans rien modifier sur la PS5. Cette dernière pousse alors son flux en 1080p à 60 fps vers le Mac, qui le lit, tout ça avec moins d'une seconde de délai avant de le diffuser sur Discord. L'ami Yash s'en sert chaque jour depuis quelques semaines et pour le moment, il n'a pas rencontré le moindre souci.
Par contre, ça ne passe pas avec YouTube car la console envoie bien sa vidéo au Mac, mais vérifie également régulièrement auprès de YouTube que le direct est bien en cours de diffusion. Et comme rien n'arrive, bah elle coupe tout simplement la diffusion au bout d'une minute.
Voilà, si ça vous intéresse, il a fait un article complet où il détaille tout, du DNS au routeur, avec le code de sa petite application qu'il a écrite et qui se loge dans la barre de menu de son Mac. Voilà, si ça vous tente, c'est par ici.
-
Avec Mistral AI, SCALEWAY et Diabolocom, la MAIF organise son modèle opérationnel de l’IA
www.frenchweb.frLa MAIF ne présente pas seulement trois nouveaux partenariats technologiques. La mutuelle met en place une organisation destinée à faire entrer l’intelligence artificielle dans ses processus métier, sans abandonner la maîtrise de ses données, de ses règles et de ses compétences. Son cas donne des repères utiles à toute entreprise qui cherche à passer des …
L’article Avec Mistral AI, SCALEWAY et Diabolocom, la MAIF organise son modèle opérationnel de l’IA est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
ALIBABA étend son cloud en Europe
www.frenchweb.frAlibaba Cloud prévoit d’ouvrir des régions en Finlande et aux Pays-Bas et de renforcer sa présence en France et en Allemagne. Derrière ces annonces, le groupe chinois construit une offre qui associe centres de données, puces et modèles d’intelligence artificielle. À Hangzhou, lors de sa conférence Apsara, Alibaba a ajouté trois nouvelles régions à sa …
L’article ALIBABA étend son cloud en Europe est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Meta tente de reconquérir les entreprises avec son Enterprise Platform pour l’IA, mais saura-t-il gagner leur confiance ?
www.usine-digitale.frCe lundi 28 septembre, Mark Zuckerberg a officialisé ce qui ressemblait encore, quelques jours plus tôt, à une série de produits dispersés. Annoncé sur le réseau social X, Meta Enterprise Platform doit devenir un nouveau « major pillar » de la firme et permettre de proposer aux entreprises ses modèles, ses agents et ses outils. Le portefeuille cité est révélateur : Muse, l’agent personnel lancé début septembre, Meta Business Agent pour les interactions avec les clients, mais aussi Muse API et Muse Code pour les développeurs.
-
« Google a complètement perdu la tête » : il cherche un mème NBA, l’IA le console d’une rupture imaginaire
www.numerama.com
En cherchant de vieux tweets sur un mème NBA, un blogueur s'est vu proposer du réconfort par l'AI Overview de Google. Son récit, très partagé sur Hacker News, relance le débat autour de ce qu'on attend encore d'un moteur de recherche.
-
Robotique : Avec son world model Flux 3 Action, l’allemand Black Forest Labs revendique des performances supérieures à Cosmos 3 Nano de Nvidia
www.usine-digitale.frLes start-up spécialisées dans le développement de modèles pour la robotique “next-gen” sont rares en Europe, mais Black Forest Labs entend bien tirer son épingle du jeu. La jeune pousse basée à Fribourg-en-Brisgau (Allemagne) a présenté le 23 septembre Flux 3 Action, un “world action model” (WAM) à poids ouverts doté de 7 milliards de paramètres.
-
Test de FC 27 : un open world désastreux, des bugs dans tous les sens et de rares améliorations
www.numerama.com
Fidèle à sa réputation de jeu qui ne change presque rien d'une année sur l'autre, EA Sports FC 27 donne une immense impression de déjà-vu tout en améliorant enfin certains modes délaissés comme le mode carrière. Mais l'héritier de FIFA incarne aussi ce qu'il y a de pire dans l'industrie du jeu vidéo : des bugs inadmissibles pour un jeu vendu comme finalisé, des nouveautés seulement pensées pour vendre des crédits et un open world, The Grounds, qui a tout d'une parodie de jeu vidéo (ou d'un remake du PlayStation Home de la PS3). J'y ai joué plus de 10 heures.
-
Face à l’irresponsabilité d’Anthropic et d’OpenAI, Nvidia veut mettre les agents IA sous surveillance jusque dans les puces
www.usine-digitale.frLes agents IA ne posent pas seulement un problème de fiabilité de leurs réponses. À mesure qu’ils obtiennent des accès à des fichiers, des bases de données, des API ou des outils capables d’exécuter du code, une autre question devient centrale : que se passe-t-il lorsqu’un agent sort du cadre qui lui a été fixé ? Nvidia apporte une réponse très matérielle à ce problème avec sa nouvelle Open Agent Safety Platform, annoncée le 28 septembre. L’idée : ne plus demander à l’agent de respecter les règles, mais placer des contrôles en dehors de lui pour l’empêcher de les contourner.
-
Google brade son Pixel 10 sur sa boutique maintenant que le Pixel 11 a pris le relais
www.numerama.com
[Deal du jour] Le Pixel 11 est en vente depuis le 20 août, et Google écoule les stocks de la génération précédente. Sur son store, le Pixel 10 passe à 579,20 € avec le code anniversaire de Google, valable jusqu'au 28 septembre.
-
Spécialiste de la gestion et du paiement des factures fournisseurs, LIBEO rejoint SHINE (CEGID)
www.frenchweb.frSHINE acquiert LIBEO, spécialiste français de la gestion et du paiement des factures fournisseurs, pour un montant non communiqué. La fintech, qui annonce accompagner près de 3 000 PME et cabinets d’expertise comptable, rejoint le groupe CEGID avec l’ensemble de ses équipes. Rentable depuis 2025 selon ses déclarations, elle entend s’appuyer sur ce rapprochement pour …
L’article Spécialiste de la gestion et du paiement des factures fournisseurs, LIBEO rejoint SHINE (CEGID) est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
À peine sorti sur PS5, Marvel’s Wolverine se lance déjà sur PC mais le plus difficile reste à faire
www.numerama.com
Les progrès dans l'émulation PS5 sont fulgurants. Ce lundi 28 septembre, une démonstration montre Marvel's Wolverine, sorti le 15 septembre sur la console de Sony, se lancer déjà sur PC.
-
GRANEET lève 7 millions d’euros pour faire de la facture électronique le point d’entrée de l’ERP de chantier
www.frenchweb.frGraneet annonce une levée de 7 millions d’euros pour accélérer son ERP destiné aux PME du bâtiment. Depuis le 1er septembre 2026, toutes les entreprises doivent être capables de recevoir des factures électroniques ; les PME devront, à leur tour, les émettre à partir de septembre 2027. La startup veut faire de cette contrainte réglementaire …
L’article GRANEET lève 7 millions d’euros pour faire de la facture électronique le point d’entrée de l’ERP de chantier est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Espagne : la compagnie ferroviaire Renfe piratée
incyber.orgLa compagnie ferroviaire publique espagnole Renfe a confirmé, le 25 septembre 2026, avoir été victime d’un « incident de sécurité » ayant conduit à une fuite de données. Selon l’entreprise, les attaquants ont compromis les serveurs du gestionnaire d’infrastructures ferroviaires public Adif afin d’atteindre les SI de Renfe.
Les pirates n’auraient eu accès qu’à « des informations limitées sur les utilisateurs, principalement des noms et des adresses mail », lit-on dans le communiqué de la compagnie. « Aucun élément ne permet d’établir que des données bancaires ou financières, des informations relatives aux moyens de paiement, des documents d’identité ou d’autres informations particulièrement sensibles ont été consultées », a précisé la Renfe.
Selon les médias espagnols, les attaquants se seraient emparés de 500 Go de données. D’après une « source proche de l’enquête » citée par El Mundo, ils se seraient appuyés sur une IA générative pour compromettre les serveurs d’Adif. Le quotidien affirme qu’il s’agirait de la première « cyberattaque par IA » visant une entreprise publique espagnole.
The post Espagne : la compagnie ferroviaire Renfe piratée appeared first on INCYBER NEWS.
-
Pays de Galles : les SI d’une force de police compromis
incyber.orgLa police de Dyfed-Powys, au Pays de Galles, a déclaré, le 25 septembre 2026, qu’une cyberattaque avait perturbé certains de ses systèmes non liés aux urgences et pourrait avoir compromis des données sur son personnel. Les forces de l’ordre ont détecté l’intrusion début septembre 2026 et n’ont trouvé aucune preuve qu’elle ait touché des informations concernant les usagers.
La police de Dyfed-Powys couvre le sud-ouest du Pays de Galles et compte plus de 2 000 agents et personnels civils. Tarian, l’unité régionale de lutte contre le crime organisé, enquête sur l’incident avec le soutien de spécialistes en cybersécurité. La police n’a pas précisé comment l’incident s’était produit ni quelles données du personnel pourraient être concernées. Aucun groupe cybercriminel n’a publiquement revendiqué ce piratage.
The post Pays de Galles : les SI d’une force de police compromis appeared first on INCYBER NEWS.
-
Des Nord-Coréens piratent la plateforme crypto Bitget
incyber.orgGracy Chen, PDG de la plateforme singapourienne de cryptomonnaies Bitget, a attribué, le 25 septembre 2026, à des groupes nord-coréens le vol de l’équivalent de 387 millions de dollars (340 millions d’euros), confirmé par l’entreprise la veille. Une « faille de sécurité » aurait permis aux pirates d’accéder au backend des services de gestion des portefeuilles de cryptomonnaies. En retraçant le parcours des fonds dérobés, des chercheurs indépendants ont relié le vol au groupe Lazarus, affilié à la Corée du Nord.
Dès la découverte de l’incident, Bitget a suspendu les retraits. L’entreprise collabore avec les sociétés de cybersécurité Mandiant et SlowMist pour rétablir ses services. « Nous avons alerté les autorités compétentes et coopérons pleinement avec elles à l’échelle mondiale », a déclaré Gracy Chen.
La PDG de Bitget a également précisé que l’entreprise disposait d’un fonds de protection des utilisateurs doté de plus de 464 millions de dollars (528 millions d’euros), qui servira à couvrir les pertes. Selon elle, plusieurs plateformes ont déjà bloqué une partie des avoirs associés aux portefeuilles des pirates. Bitget a par ailleurs mis en place un programme de primes de récupération : les plateformes recevront 5 % des fonds qu’elles auront volontairement gelés, puis 5 % supplémentaires s’ils sont récupérés.
The post Des Nord-Coréens piratent la plateforme crypto Bitget appeared first on INCYBER NEWS.
-
L’UE compte désormais plus de 700 000 robots industriels en service, la France troisième en matière d’installations annuelles
www.usine-digitale.fr712 000 : c’est le nombre de robots industriels en service dans les 27 États membres de l’UE en 2025, selon l’étude annuelle World Robotics de l’International Federation of Robotics (IFR) publiée ce 24 septembre. L’organisme, qui représente plus de 3000 acteurs du secteur basés dans 30 pays différents, définit comme robot industriel un “manipulateur multifonctionnel, reprogrammable et contrôlé automatiquement, sur trois axes ou plus, qui peut être fixé sur place ou sur une plateforme mobile pour des applications d’automatisation en milieu industriel”.
-
Pourquoi Anthropic s’engage à acheter pour 11,6 milliards de dollars de services cloud à Akamai sur sept ans
www.usine-digitale.frAnthropic vient de signer un contrat hors norme avec Akamai. Le spécialiste de l’infrastructure cloud annonce un engagement contractuel de 11,6 milliards de dollars sur sept ans avec le créateur de Claude. L’objectif : répondre à la croissance des besoins d’Anthropic en matière de calcul CPU, en s’appuyant sur l’infrastructure distribuée et les logiciels d’Akamai Cloud.
-
Docaposte renforce son offre de cloud souverain avec l’hébergeur allemand Ionos, en parallèle de son engagement dans Numspot
www.usine-digitale.frSofteam, la filiale de conseil et de services numériques de Docaposte (filiale numérique de La Poste), vient d’annoncer la signature d’un partenariat avec l’hébergeur allemand Ionos pour proposer une nouvelle offre de « cloud hybride souverain ».
-
ArseneLupin - Le JEV Like d'Ibou qui décide au lieu de bavarder
korben.infoJev, je ne l'ai jamais utilisé mais Kev, en revanche, je l'ai branché dans mon outil de sélection de sujets de veille pour qu'il me dise notamment si un sujet correspond à ce qui me plaît ou pas. C'est en cours de test, donc je ne vais pas vous livrer de conclusion hâtive sur si ça fonctionne bien ou pas, mais si je vous en parle, c'est parce que Sylvain Peyronnet, le papa du moteur de recherche français Ibou , publie à son tour 3 modèles de la même famille, baptisés ArseneLupin, conçu également pour faire du décisionnel
Pour ceux qui ne suivent pas l'actualité IA, le nouveau truc à la mode en ce moment, c'est Jev, un modèle maison de TypeSafe qui est le premier de ce qu'ils appellent les modèles System One. Au lieu de générer du texte qu'il faut ensuite parser, ce reçoit un état (un texte, un ticket, un objet JSON) et des questions typées : oui ou non (
noul), un choix parmi plusieurs options (choice) ou une note sur une échelle (score). Et il renvoie pour chacun de ces choix, des probabilités que votre code peut ensuite exploiter directement pour trier, faire du routage ou prendre des décisions. Par exemple, avec ça, on peut faire de la qualification de tickets de bug ou de l'anti-spam, ce genre de choses.Alors forcément, suite à ça, des clones ouverts ont débarqué. Le premier que j'ai découvert, c'est Kev , de Jared Palmer, qui s'appuie sur Qwen3.5 et Qwen3.8, soit 0,8 à 27 milliards de paramètres, et laya qui part d'un encodeur ModernBERT-large pour 421 millions de paramètres au total.
Perso, avec Kev dans mon outil de veille, Pour le moment, j'ai un peu de mal à voir si c'est mieux qu'une décision prise par un Qwen 3.6 classique qui génère une réponse textuelle mais Kev a été entraîné sur des textes de 384 tokens au max, et les articles qui tombent dans ma veille dépassent largement ce gabarit...
ArseneLupin, c'est donc la version d'Ibou, annoncée par Sylvain la semaine dernière. Sa v1.1 repose donc sur Qwen3.5-4B, la mini sur Qwen3.5-0.8B et ArseneLupinstral sur Ministral 8B. Les poids sont sous licence Apache 2.0 et le code pour s'en servir et l'intégrer est fourni, mais pas le code d'entraînement ni les données.
C'est encore jeune, donc il n'y a pas eu de benchmark indépendant, mais Ibou en a fait et voici ce qu'ils obtiennent avec une classification d'intentions de recherche en dix catégories. Avec la 1.1, ils obtiennent 50,7 % de bonnes réponses, contre 39,7 % pour la mini et 43,9 % pour Jev 1.13.
Bref, ce sont leurs mesures, mais si elles sont justes, ça veut dire qu'Arsène Lupin est plus efficace que Jev.
Installer ArseneLupin v1.1
Alors pour ce tuto, j'ai pris la v1.1 qui est la plus "balèze".
À la fin de cette section, vous aurez donc un serveur local qui crache du JSON accessible sur le port 8000. Il vous faut Python 3.11 ou une version plus récente et une 10aine de Go libre puisque le modèle complet pèse 9,3 Go en bfloat16.
J'exclus au téléchargement le dossier
gguf, qui contient la version 8 bits de 4,5 Go destinée à llama.cpp. Pour démarrer, il faut donc créer un environnement virtuel, puis récupèrer le modèle, et installe le code de service avec la version de transformers qui va bien, c'est à dire la 5.17.0 :python3 -m venv lupin && source lupin/bin/activate pip install -U huggingface_hub hf download IBOU-SEARCH/ArseneLupin-v1.1 --local-dir arsenelupin-v1.1 --exclude "gguf/*" cd arsenelupin-v1.1 pip install ./code "transformers==5.17.0"Par défaut, le fichier
serve.yamlenvoie le modèle sur une carte NVIDIA (cuda:0). Sur un Mac, il faudra donc le basculer sur le GPU d'Apple (mps), et sur une machine sans GPU, ce seracpu. Je pense que je ne vous apprends rien, vous avez l'habitude,Ensuite, on lance le serveur. Notez juste que sous Linux, le
seds'écrit sans les deux apostrophes après le-i. :sed -i '' 's/cuda:0/mps/' serve.yaml python -m arsenelupin serve --config serve.yaml --calibration calibration/default.json --port 8000
Le serveur ArseneLupin v1.1 à l'écoute sur le port 8000, poids chargés
Au bout de quelques secondes, le serveur écoutera sur
127.0.0.1:8000. Quant à la version GGUF, vous pouvez, si vous voulez, le faire tourner dans un llama.cpp ou équivalent à condition d'en avoir un assez récent qui connait l'archi de Qwen3.5.Poser vos premières questions
Pour tester, je me suis inspiré de mon outil de veille. On donne au modèle le titre et le résumé d'un sujet et on lui demande si ça parle d'un outil qu'on peut installer, dans quelle rubrique il faut le ranger et à quel point ça pourrait intéresser des gens comme vous, c'est à dire des lecteurs technophiles / bidouilleurs.
Placez donc ça dans un fichier nommé
veille.json, dans le dossier du modèle :{ "state": { "titre": "ArseneLupin, trois modèles de décision publiés par Ibou", "resume": "Le moteur de recherche français Ibou publie sur Hugging Face trois modèles qui répondent par oui ou non, par un choix ou par une note, avec des probabilités. Les poids sont sous licence Apache 2.0 et le code de service est fourni." }, "questions": { "installable": {"type": "noul", "instructions": "Le texte présente-t-il un outil que le lecteur peut installer lui-même ?"}, "rubrique": {"type": "choice", "instructions": "Dans quelle rubrique ranger ce sujet ?", "criteria": {"ia": "Intelligence artificielle et modèles de langage", "dev": "Outils pour développeurs et infrastructure", "securite": "Sécurité informatique, failles et vie privée", "materiel": "Matériel, gadgets et bricolage électronique"}}, "interet": {"type": "score", "instructions": "Ce sujet intéressera-t-il un lecteur technophile qui aime tester des outils ?", "criteria": ["Pas du tout", "Un peu", "Beaucoup"]} } }Puis dans un second terminal ouvert dans le même dossier, tapez la ligne de commande curl suivante pour lancer l'évaluation avec ArseneLupin.
curl -s http://127.0.0.1:8000/v1/systemone -H 'Content-Type: application/json' -d @veille.json | python3 -m json.tool
La réponse à la requête de veille : "ia" à 0,72, un oui/non hésitant à 0,53 et un score de 1,47
Comme vous pouvez le voir, pas une ligne de texte généré, chaque question revient avec ses probabilités. On voit donc que la rubrique "ia" l'emporte à 0,72, loin devant "dev" à 0,19, et le niveau "Beaucoup" ressort à 0,59 pour l'intérêt, ce qui donne un score moyen de 1,47 sur une échelle qui va de 0 à 2. Par contre, pour savoir si c'est un outil installable, le modèle hésite quand même un peu avec un timide 0,53 de probabilité pour le oui.
Il renvoie quand même une indication qui est plutôt importante à savoir là décision :
"decision": true, car aucun seuil n'est appliqué côté serveur (c'est ce que dit le"decision_status": "unthresholded"). C'est donc à votre code de décider qu'en dessous de 0,7, par exemple, la décision revient à un humain plutôt que de partir dans la base de données automatiquement. Sur mon Mac Studio M4 Max, la requête a pris entre 2,4 et 2,8 secondes pour ces huit options.J'ai fait un 2ème essai avec un commentaire de spam bien grossier : "Super article !!! Pour gagner 500 € par jour depuis chez vous, cliquez vite sur mon profil, places limitées." La v1.1 le classe en spam à 0,86 et lui colle un ton positif à 0,78, ce qui est vrai au premier degré. Et la version mini du modèle répond deux fois plus vite, en 0,8 seconde, mais descend à 0,76 sur le spam et hésite sur le ton... À voir donc si ça suffit pour vous d'utiliser le modèle mini ou pas, selon vos besoins.
Comment ArseneLupin prend ses décisions
Le code livré avec le modèle se lit facilement et la mécanique est plutôt simple à capter. En fait chaque option devient une question oui/non posée au Qwen affiné, du genre "ce candidat décrit-il la bonne réponse ?".
Ainsi, 4 catégories pour classer un contenu se résume en 4 questions sur le même texte accompagnée d'une petite tête de lecture (2 561 paramètres sur la v1.1) qui transforme le dernier état caché du modèle en score. Un softmax répartit ensuite ces scores en probabilités, et la
confidencen'est rien d'autre que la plus forte d'entre elles...Pour que ça reste rapide malgré toutes ces passes, le serveur lit une seule fois le texte commun aux options, puis calcule toutes les options simultanément.
En fait avec ArseneLupin, on reproduit le principe de Jev mais avec un LLM ouvert (Qwen) en ne lui faisant produire qu'un seul token, limité aux choix proposés. Ce qu'apporte Ibou, c'est donc un modèle LLM ultra affiné (Autant qu'un bon Saint Nectaire) pour ce type d'exercice de prise de décision.
Reste ensuite la confiance à accorder à ces probabilités. Dans le dossier calibration, vous verrez des températures ajustées selon les trois workflows d'exemple fournis par Ibou, et il y a également, dans le fichier default.json, une calibration par défaut. C'est celle-là qu'on a utilisée dans notre exemple, mais vous pouvez aussi régler vous-même votre propre température ajustée selon vos usages.
Maintenant, avant de lui confier quoi que ce soit, posez-vous un peu et donnez-lui une cinquantaine d'exemples que vous avez déjà classés à la main. Comme ça, vous pourrez comparer ArsèneLupin et le LLM que vous utilisez d'habitude pour savoir qui est le plus fiable. N'hésitez pas à y mettre aussi des textes plus ou moins longs parce que le serveur accepte jusqu'à 32 768 tokens par option. Ça tombe bien parce que ça me gênait un peu dans mon intégration avec Kev sur mon outil de veille. Donc je pense que je vais rapidement basculer sur ArsèneLupin pour ma veille en remplacement de Kev.
Et si vous venez de Jev, attention, la requête a la même forme mais pas la réponse !! Pour une question oui/non, Jev renvoie un champ
noullà où ArseneLupin renvoie unp_yes, et pour une note, ArseneLupin range ses probabilités dans une liste quand Jev utilise un dictionnaire.Cela veut dire qu'un client écrit pour l'API de TypeSafe ne lira pas du tout le résultat de ArseneLupin tel quel, donc prévoyez une petite couche de conversion avant de mettre les deux en concurrence sur vos data.
-
À ce prix sur Amazon, l’iPhone 17 Pro est le pire ennemi de l’iPhone 18 Pro
www.numerama.com
[Deal du jour] L'iPhone 18 Pro est sorti avec un prix d'entrée en hausse, et son prédécesseur en profite. Sur Amazon, l'iPhone 17 Pro tombe à 1 189 € au lieu de 1 329 €.
-
Paperasse - Des skills IA pour votre compta et vos impôts
korben.infoJ'adore la France, mais même si la vie y est difficile. Pourquoi ? Simplement à cause de l'administratif et de la paperasse. En tant que phobique administratif, c'est vraiment ce qui me fait regarder de près l'expatriation, loool.
Tenir la compta d'une petite société, remplir sa déclaration d'impôts, estimer les frais de notaire d'un appart... Bref, la fucking paperasse a de quoi déclencher de sévère crises de phobie administrative chez tout le monde. Alors pour nous aider, mon nouveau héro du jour, Romain Simon, a créé " Paperasse ", des skills pour agents IA que Claude Code, Codex, Cursor ou Mistral Vibe peuvent consulter pour endosser le rôle d'expert-comptable, de contrôleur fiscal, de commissaire aux comptes, de fiscaliste, de notaire ou encore de syndic de copro.

Son dépôt contient également des scripts vérifiés pour tout ce qui est calculs importants. En effet, ce sont des choses qu'on ne veut surtout pas confier à un LLM. Je pense au calcul de l'impôt sur les sociétés, aux amortissements, à la TVA, ou encore sortir un fichier des écritures comptables, un bilan ou une facture. Le projet Paperasse contient aussi des connecteurs pour vos transactions Qonto et vos paiements Stripe.
Voilà, donc si, comme moi, vous êtes en détresse émotionnelle dès que vous recevez un courrier de l'administration française, je vous invite à installer ce projet en donnant tout simplement ce prompt à votre agent IA préféré :
Installe tous les skills du repo github https://github.com/romainsimon/paperasse
Lance ensuite le setup pour la gestion de toute ma paperasse
L'agent clonera alors le dépôt et lancera un setup qui vous demandera le nom de votre société, votre régime de TVA et vos comptes bancaires. Pour mes tests, j'ai donc inventé une SASU, Brioche & Octets, avec un relevé bancaire de huit lignes bidon, et j'ai lancé Claude Code dessus avec le skill comptable, dans un environnement vierge.
En 6 minutes, il a immobilisé l'ordinateur portable au lieu de le passer en charge, traité l'abonnement logiciel facturé depuis l'Irlande en deux scénarios faute de facture pour trancher, et rangé le retrait au distributeur en compte d'attente, en rappelant qu'un compte courant débiteur est interdit au président d'une SASU.
Côté factures, le script de validation a refusé ma première tentative, à laquelle il manquait le SIREN du client et le numéro de TVA intracommunautaire de ma boîte. Une fois corrigée, le générateur m'a sorti un PDF qui embarque son fichier XML Factur-X.

La facture de ma fausse SASU, une fois le SIREN du client et mon numéro de TVA ajoutés
L'agent fiscaliste, quant à lui, ce sera plus à même de vous aider si vous êtes un particulier. Je lui ai soumis un couple pacsé imaginaire avec un enfant, 65 000 € de salaires et 2 000 € de dividendes, en lui demandant si l'option pour le barème battait le PFU. Il a lancé son script Python sur les deux cas et conclu que oui, de 124 €, parce qu'avec un taux marginal de 11 %, l'abattement de 40 % et la CSG déductible font descendre l'impôt sur ces dividendes sous les 12,8 % du PFU. J'ai refait le calcul à la main, ça tombe juste.

Le fiscaliste compare PFU et option barème pour un couple pacsé imaginaire
Par contre, tout ça repose sur des barèmes qu'il faut tenir à jour, et c'est là que ça coince. En effet, ces mises à jour reposent sur les issues acceptées ou non sur le projet GitHub. Par exemple, y'en a une qui est ouverte depuis fin août qui montre que le skill "notaire" calcule encore les émoluments de vente avec le tarif de 2016 alors que ça a changé depuis le 1er janvier 2021, et malheureusement, que les évaluations automatiques du projet valident ces calculs faux. Le correctif a bien été proposé, comme d'autres mais aucun n'a été fusionnée depuis le 11 juillet.
Donc voilà, c'est un super projet, mais il faudrait encore que ça suive un petit peu derrière donc utilisez-le mais en prenant soin de bien vérifier quand même les montants / tarifs / règles sont à jour.
Reste maintenant la question de vos données... En effet, vos PDF et tout ce qui concerne vos données vont partir chez le service IA que vous utilisez. Donc ça, il faut en avoir conscience même si je sais que derrière, en général, les comptables mettent tout sur des drives mal sécurisés, et que prochainement la facturation électronique va faire leaker ça dans tous les sens.
Mais bon, quoi qu'il en soit, tout ceci ne remplacera jamais un expert-comptable, donc voilà, amusez-vous, testez-le, dégrossissez vos questions avec ça, faites des simulations...etc mais ne lui faites pas 100 % confiance.
Source : GitHub
-
Muse, l’agent IA de Meta, est accusé d’avoir invité un inconnu chez son utilisateur
www.numerama.com
Un créateur de contenus affirme que Muse, l'agent IA de Meta, a pris l'initiative de vendre un clavier en son nom en acceptant un prix très bas et en invitant l'acheteur à un rendez-vous à son adresse… sans jamais le consulter. Un responsable de Meta met en doute sa version, mais les polémiques autour de Muse s'accumulent.
-
OpenAI suspend l’entraînement de ses IA les plus avancées après un accès non autorisé à Internet
www.numerama.com
OpenAI a suspendu l'entraînement et l'évaluation de ses modèles les plus avancés, après qu'un agent a contourné le 20 septembre 2026 ses restrictions d'accès à Internet. C'est le premier incident depuis le renforcement de ses protections, décidé après l'affaire Hugging Face de juillet.
-
ai-PULSE, Teratec, UAV Show : cinq rendez-vous tech à suivre en octobre, et notre agenda en France
www.frenchweb.frIA, commerce, drones, calcul intensif et spatial : en octobre, FRENCHWEB.FR retient cinq rendez-vous pour la pertinence de leur programme, l’expertise des intervenants annoncés et la possibilité d’échanger avec ceux qui mettent ces technologies en œuvre. Dans un calendrier encombré, les conférences historiques captent souvent l’attention, de nouveaux rendez-vous méritent pourtant le détour. Au-delà de …
L’article ai-PULSE, Teratec, UAV Show : cinq rendez-vous tech à suivre en octobre, et notre agenda en France est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Votre vieux Nokia 6300 sait maintenant parler à Claude
korben.infoJ'sais pas si vous êtes de la team Dumbphone , mais quand Emir Karşıyakalı tape une recherche Google sur son vieux Nokia 6300 de 2007, il se fait gentiment envoyer chier vers une mise à jour de son browser. Alors, parce qu'il en avait marre de vivre 2026 comme s'il était resté bloqué en 2007, il a codé Claude S40 , un client Claude non officiel pour les Nokia Series 40 qui font tourner du Java.
Et le plus fou c'est que non seulement, c'est vibe codé mais qu'en plus, ça marche du feu de dieu :
Votre navigateur ne supporte pas la lecture de vidéos HTML5. Voici un
<a href="/claude-s40-nokia-6300/claude-s40-nokia-6300-1.mp4">lien vers la vidéo</a>.
Vous tapez votre question au clavier et la réponse s'affiche sur ce tout petit écran. Pour la météo ou l'actu, Claude fait sa recherche web côté serveur sans passer par le navigateur du Nokia. Il est même capable d'inscrire un rendez-vous pour vous dans l'agenda du téléphone.
Évidemment, le téléphone ne cause pas directement à l'API d'Anthropic. En fait, tout passe par un petit serveur écrit en Go, qui est proposé sous la forme d'une image Docker que vous devez héberger vous-même. Et c'est ce serveur qui conserve la clé API d'Anthropic, qui va donc découper les réponses que lui renvoie Claude pour les envoyer au téléphone qui ne lit pas plus de 8 Ko à la fois. Et ce serveur conserve les conversations durant 30 jours max.

Et c'est là que ce vieux Nokia rend la tâche difficile car il ne discute qu'en TLS 1.0 (Les boomers appellent ça "le petit cadenas"), n'envoie pas de SNI (le nom du site demandé) et ses certificats racines datent des années 90 et 2000 donc, autant dire que niveau dates de péremptions, c'est comme visiter la cave à conserves d'un survivaliste...
Le serveur est donc capable de discuter en HTTPS avec le web et de faire suivre la data chiffrée en HTTPS entre lui-même et le Nokia, grâce à un certificat auto-signé, dont la racine a été installée sur le téléphone.

Le code de Claude S40 est bien sûr libre, sous licence MIT, et côté hébergement, il suffit de mettre ça sur un petit VPS à quelques euros par mois et vous êtes tranquille. Ensuite, le reste se facture aux messages puisque chaque question, comme chaque recherche web, passe par votre clé API Claude... Donc, n'oubliez pas de mettre une petite limite de dépense dans votre console Anthropic, histoire de ne pas cramer votre compte en banque.

Par contre, l'appli n'a pour le moment été testée que sur le Nokia 6300 (RM-217) et il lui faut une carte SIM avec les données mobiles activées évidemment. Or le 6300 ne fait QUE du GSM, GPRS et EDGE , et Orange coupe progressivement sa 2G . En effet, depuis mars, 44 départements vont la perdre à partir du 6 octobre, et toute la métropole, hors zones blanches, sera sans 2G dès le 20 octobre 2026. Donc si vous êtes chez Orange, faut pas traîner pour tester car après, ça ne fonctionnera plus !! Sniiiif.
Mais rassurez-vous, Emir ne compte pas s'arrêter là puisqu'il est en train de reverser le firmware du téléphone pour contourner la couche Java et ensuite pouvoir lui faire faire ce qu'il veut. Voilà, si vous avez encore un 6300 dans un tiroir, c'est donc le bon moment de le ressortir, avant de passer à un dumbphone compatible 4G .
Source : Emir sur X
-
Des lasers anti-drones seront bientôt installés à Cap Canaveral, après une intrusion à 2,5 km du pas de tir lunaire
www.numerama.com
L'US Space Force va installer un laser anti-drones à Cap Canaveral, la base de Floride d'où décollent les fusées de SpaceX, United Launch Alliance ou Blue Origin. Le modèle et la date de mise en service n'ont pas été communiqués.
-
Fingerprinting audio : Alibaba rattrapé par un casque Bluetooth
incyber.orgÀ mesure que les navigateurs restreignent les cookies tiers, les acteurs du commerce en ligne et de l’analyse d’audience se reportent sur des méthodes d’identification sans dépôt de fichier persistant sur la machine des utilisateurs. Cette technique porte un nom : le fingerprinting, ou empreinte numérique. Elle consiste à reconstituer un identifiant unique à partir des caractéristiques techniques d’un terminal.
Un casque Bluetooth à l’origine de la découverte
Le 20 août 2026, l’auteur du blog laserphile (1), connu sous le pseudonyme “mc-tech”, décrit un comportement anormal de son casque Bluetooth multipoint. L’appareil cesse de rendre la main à son téléphone dès qu’un onglet AliExpress est ouvert sur son ordinateur. La mise en sourdine ne change rien, aucun média ne se lit sur la page.
L’inspection du navigateur révèle deux scripts d’Alibaba Web Security Center, collina.js et fireyejs.js (2). Ces derniers ouvrent chacun un contexte audio après quelques secondes d’inactivité. « La page d’accueil d’AliExpress crée silencieusement deux graphes WebAudio en fonctionnement, issus de scripts de sécurité Alibaba fortement obfusqués », écrit mc-tech. Ce traitement maintient la sortie sonore du système occupé, ce qui explique la nuisance matérielle constatée par le blogueur.
Le dispositif s’articule autour de l’API WebAudio (interface de synthèse sonore intégrée aux navigateurs). Un oscillateur produit un signal en dents de scie, la chaîne de traitement le déforme, un analyseur relève ensuite le résultat. Le volume demeure réglé à zéro et rien ne sort des haut-parleurs.
Du signal audio à l’empreinte du navigateur
Selon la configuration matérielle et logicielle, le traitement de ce signal peut produire de légères variations. Les calculs en virgule flottante dépendent notamment du processeur, du système d’exploitation et de certaines caractéristiques de l’environnement logiciel. Ces différences peuvent ainsi contribuer à une empreinte technique, sans nécessairement permettre, à elles seules, d’identifier une machine de manière unique.
Les mêmes scripts relèvent par ailleurs les capacités WebGL (interface d’affichage graphique en trois dimensions), la résolution d’écran, le nombre de cœurs et le comportement WebRTC (protocole de communication audio et vidéo en temps réel entre navigateurs). Ils recourent surtout au canvas, une image invisible que le navigateur dessine à la demande du site, dont le rendu varie selon la carte graphique et les polices disponibles.
Normalisation chez Firefox, randomisation chez Brave
Pour contrer le fingerprinting, Firefox pratique la normalisation. Depuis sa version 118, parue en septembre 2023, le navigateur renvoie à tous ses utilisateurs la même valeur, quel que soit le matériel installé. Tom Ritter, ingénieur chez Mozilla, a mesuré la variation résiduelle (3) : « 99,24 % des utilisateurs relèvent de l’une des trois valeurs possibles », détaille-t-il. Les trois valeurs correspondent à des familles de processeurs, à savoir les puces x86 et x64 dépourvues d’instruction de multiplication-addition fusionnée, les x64 qui en disposent, puis les architectures ARM. « Le fingerprinting WebAudio est presque inutile », conclut l’ingénieur. Pris isolément, ce signal permet donc surtout de classer l’internaute dans une catégorie matérielle, plutôt que de le reconnaître individuellement.
Le navigateur Brave (navigateur open source qui bloque par défaut les traceurs publicitaires) retient la stratégie inverse, celle de la randomisation. Ajoutant un bruit léger aux valeurs renvoyées, différent d’un site à l’autre puis d’une session à la suivante, il empêche tout rapprochement entre deux visites. Safari applique un principe voisin depuis sa version 17, également parue en 2023. Quant à Chrome, il occupe une position intermédiaire. Son code de traitement sonore délivre depuis plusieurs années un résultat quasi constant, sans que Google en ait fait un argument de protection. Le procédé observé chez AliExpress se heurte donc à Blink, Gecko et WebKit, les trois moteurs de rendu qui équipent la quasi-totalité du parc actuel de navigateurs.
L’identification repose sur un faisceau de signaux
La faiblesse d’un marqueur isolé ne suffit toutefois pas à neutraliser le fingerprinting. Son efficacité repose précisément sur l’agrégation de nombreux paramètres techniques : le résultat WebAudio peut être combiné au canvas, à WebGL, aux polices, à la résolution d’écran ou encore aux caractéristiques du navigateur. L’identification ne dépend donc pas d’une empreinte sonore unique, mais d’un faisceau de signaux collectés simultanément.
Une étude de l’University College London et de l’université de Californie à Riverside (4), présentée à la conférence WWW 2025, a recensé ces scripts sur 3 000 sites du classement CrUX (Chrome User Experience Report). Les chercheurs y dénombrent 629 occurrences pour le canvas, où le script fait tracer une ligne de texte, un dégradé ou un émoji avant d’en relever les pixels. L’audio arrive au deuxième rang avec 215 occurrences, devant le WebRTC et l’énumération des polices installées.
Un identifiant que l’internaute ne peut ni voir ni effacer
La différence du fingerprinting avec le cookie tient au contrôle laissé à l’internaute. Un traceur classique figure dans les réglages, se supprime et se refuse par une bannière de consentement. A l’inverse, une prise d’empreinte se recalcule à chaque visite, sans fichier à effacer ni case à décocher, ce que la CNIL souligne (5) dans sa définition du procédé.
Cette invisibilité explique aussi l’attention des autorités de protection des données. Même sans déposer de cookie, le site exploite des informations issues du terminal ou de son environnement technique afin de distinguer l’utilisateur ou son équipement.
Google a levé en février 2025 l’interdiction du fingerprinting pour ses annonceurs, décision que l’Information Commissioner’s Office britannique (6) a qualifiée d’irresponsable. Le Comité européen de la protection des données (European Data Protection Board) range quant à lui la pratique dans le champ de l’article 5(3) de la directive ePrivacy (7), ce qui la soumet au consentement.
L’épisode AliExpress montre surtout les limites d’une lecture du fingerprinting fondée sur un seul signal. Pris isolément, WebAudio fournit aujourd’hui une information relativement pauvre sur les navigateurs les mieux protégés. Agrégé au canvas, à WebGL, aux polices, à la résolution d’écran ou aux caractéristiques du terminal, il contribue en revanche à une empreinte beaucoup plus discriminante.
Cette collecte reste difficile à percevoir et à maîtriser pour l’internaute : là où le cookie laisse une trace identifiable dans le navigateur, l’empreinte se reconstitue à partir de caractéristiques techniques souvent invisibles. Le casque Bluetooth de mc-tech aura ainsi rendu perceptible, presque par accident, un traitement conçu pour rester silencieux, au moment même où les navigateurs renforcent leurs protections et où les régulateurs encadrent plus strictement ces pratiques.
Sources :
1 – Blog laserphile
2 – fireyejs.js
3 – webaudio fingerprinting on alibaba
4 – étude de l’University College London et de l’université de Californie à Riverside
5 – Définition fingerprinting de la CNIL
6- Notre réponse au changement de politique de Google concernant le fingerprinting
7 – Article 5(3) de la directive ePrivacy,The post <strong>Fingerprinting audio</strong> : Alibaba rattrapé par un casque Bluetooth appeared first on INCYBER NEWS.
-
Sur-optimisation GEO : ces réflexes SEO qui desservent votre visibilité dans les réponses IA
www.abondance.comLe bourrage de mots-clés ne trompe plus personne, humain ou machine
Miser sur la densité de mot-clé a longtemps été un réflexe SEO de base. Il s’agissait de répéter le terme cible à intervalle régulier afin de signaler la pertinence thématique à l'algorithme. Une méthode qui a fait son temps, et qui est encore moins pertinente aujourd’hui. En effet, les modèles de langage ne fonctionnent pas sur ce principe. Ils analysent la sémantique, les entités nommées et les intentions de recherche, et non pas la fréquence brute d'un mot dans un texte.
Un contenu qui répète artificiellement une expression cible aura donc tendance à créer un signal inverse à celui recherché. Souvent répétitif, le texte apparaît peu naturel, ressemblant davantage à un exercice d'optimisation qu'à une réponse rédigée pour un lecteur. Du fait de sa nature « mécanique », ce type de contenu est plus difficile à reformuler proprement, donc moins susceptible d’être repris dans une réponse générée par IA.
Simple à énoncer, la bascule à opérer demande toutefois une certaine rigueur. Il faut écrire pour répondre à une question précise, en puisant dans le champ lexical propre au sujet, sans chercher à atteindre un certain score de densité de mots-clés. C'est précisément ce que vise le format AI-First
 de Getfluence : produire et publier des contenus GEO pensés pour le langage naturel dès leur conception, et non pas retouchés après coup pour « faire naturel ». Rédigés par les équipes internes, ces articles sont construits pour répondre aux questions que se posent réellement les utilisateurs des IA, avec une mention de marque intégrée de manière contextualisée.
La longueur n'est plus un signal de qualité en soi
Le SEO classique a longtemps valorisé les contenus longs, sur l'hypothèse qu'un article exhaustif couvre plus d'intentions de recherche et retient davantage l'attention des lecteurs. Cette logique n’est pas vraiment transposable au GEO. Un moteur génératif ne cherche pas la page la plus complète sur un sujet, mais plutôt le passage le plus précis pour répondre à la question posée.
Un article de 3 000 mots dont l'information utile tient en trois paragraphes ne bénéficie d’aucun avantage particulier dans les moteurs IA. Au contraire, il risque même d’être pénalisé de manière indirecte. En effet, plus l’information utile est diluée dans la page, moins le modèle a de chances de l’isoler et de la reprendre comme source.
Attention : cela ne signifie pas qu’il faille forcément sortir la paire de ciseaux pour tout raccourcir, mais que chaque paragraphe doit trouver sa justification. Sur une même requête, un contenu court et précis peut donc mieux performer qu’un contenu long et dilué.
Le netlinking en volume sans pertinence thématique perd de sa valeur
Dans le SEO traditionnel, accumuler des backlinks est un signal d'autorité, même quand les sources ne sont pas parfaitement alignées sur le plan thématique. En GEO, la logique est différente. En effet, les modèles génératifs sélectionnent leurs sources dans le but de construire une réponse à une question précise. Une source qui ne répond pas à vos requêtes cibles a donc peu de chances d’entrer dans la sélection, quel que soit le nombre de liens qui pointent vers elle.
Cette exigence de pertinence thématique change la façon d'aborder une campagne de netlinking. L'enjeu n’est pas lié au volume de liens obtenus, mais à la capacité du média source à être lui-même consulté par les modèles sur les sujets qui concernent la marque. Autrement dit : un lien issu d’un média généraliste sans lien avec votre secteur pèse moins qu'une mention sur un média spécialisé, régulièrement cité par l'IA sur vos thématiques.
Décliner ses pages pour couvrir des variantes de mots-clés brouille la source
Multiplier les pages dans le but de couvrir chaque variante sémantique d'un mot-clé (singulier, pluriel, synonymes, formulations régionales) était une pratique SEO courante, pensée pour maximiser la couverture de requêtes. En GEO, cette stratégie se retourne contre son objectif initial.
Pour rappel, un modèle génératif cherche avant tout des sources fiables et uniques. Face à plusieurs pages quasi identiques traitant le même sujet sous des angles de mots-clés différents, il n'a aucune raison de privilégier l'une plutôt que l'autre, et peut tout simplement ignorer l'ensemble par manque de clarté sur la source de référence. En somme, la duplication de contenus, même déguisée en déclinaison sémantique, dilue l'autorité au lieu de la renforcer.
La logique à privilégier est celle du contenu pilier, c’est-à-dire une page de référence exhaustive et claire sur un sujet, plutôt que plusieurs pages concurrentes entre elles portant sur des variantes de la même requête.
Une structure Hn ne remplace pas une hiérarchie de sens
Respecter la hiérarchie H1, H2, H3 fait partie des fondamentaux du SEO, qui reste utile en GEO. Le problème survient quand cette structure est purement formelle, lorsque les titres sont basés sur des mots-clés, sans réelle logique de progression de l'information.
En effet, les moteurs génératifs n'extraient pas de balises, ils extraient des « blocs de sens ». Un H2 qui ne correspond à aucune unité d'information cohérente, ou une succession de titres qui ne participent pas à une réponse progressive, peuvent nuire à l’extraction. À l'inverse, une structure où chaque titre correspond bien à une question ou une sous-idée clairement délimitée aide le modèle à isoler le passage le plus pertinent, et donc à le citer plus facilement.
De nouveaux réflexes à adopter à l’heure du GEO
Ces cinq pratiques SEO à corriger renvoient toutes à une même logique : les modèles génératifs cherchent la réponse la plus utile, pas le contenu « le plus optimisé », dans le sens classique du terme.
Cette exigence se traduit par des critères précis :
- Un sourcing vérifiable et daté,
- Un langage naturel et conversationnel plutôt que mécanique,
- Des données structurées qui décrivent réellement le contenu,
- Une présence sur des médias qui font déjà autorité dans leur secteur,
- Une valeur informative qui justifie la lecture.
Corriger ces automatismes est un changement de stratégie avant d'être un changement d'outils. Les marques et professionnels qui commencent dès maintenant à produire pour la réponse plutôt que pour le classement prennent une longueur d'avance, sur un terrain où la plupart de leurs concurrents appliquent encore, sans le savoir, des réflexes qui les desservent !
Le SEO classique devient-il inutile avec le GEO ?
Non. Les fondamentaux du SEO (structure claire, contenu utile, autorité du domaine) restent la base. Ce sont surtout les techniques d’optimisation mécanique, comme la densité de mot-clé ou le netlinking en volume, qui perdent de leur efficacité face aux moteurs génératifs.
Faut-il raccourcir ses articles pour être cité par les IA ?
Pas forcément. Un article long peut être cité s’il est bien découpé et que chaque section répond à une question précise. Ce qui pénalise un contenu, c’est l’information diluée, pas la longueur en elle-même.
Sur quels médias publier pour gagner en visibilité dans les réponses IA ?
En priorité sur des médias spécialisés dans votre secteur et déjà cités par les moteurs IA sur vos thématiques. Pour les identifier, utilisez un outil de visibilité IA. La plateforme Getfluence repère les médias susceptibles d’être cités par ChatGPT, Perplexity ou Gemini, et vous permet d’y publier un contenu AI-First
, rédigé dans un format pensé pour être compris et repris par les moteurs de recherche IA.L’article "Sur-optimisation GEO : ces réflexes SEO qui desservent votre visibilité dans les réponses IA" a été publié sur le site Abondance.
-
Vulnérabilités non corrigées : le régime de sanctions du CRA
www.lexing.law
Le règlement (UE) 2024/2847 relatif à la cyber-résilience (CRA) (1) ne se limite pas à fixer des exigences essentielles de sécurité au moment de la mise sur le marché. Il institue un régime de responsabilité continue portant sur le traitement des vulnérabilités pendant toute la période d’assistance du produit (art. 13, § 8).
Le défaut de correction d’une vulnérabilité constitue ainsi l’un des manquements les plus sévèrement sanctionnés par le texte, avec des amendes administratives pouvant atteindre 15 millions d’euros ou 2,5 % du chiffre d’affaires annuel mondial (art. 64, § 2).
La gestion des vulnérabilités, obligation de fond du CRA
L’annexe I, partie II, du CRA impose au fabricant de recenser et documenter les vulnérabilités des produits, de les gérer et de les corriger sans retard, notamment par des mises à jour de sécurité, de soumettre le produit à des tests réguliers et de mettre en œuvre une politique de divulgation coordonnée des vulnérabilités. Ces obligations sont précisées à l’article 13, qui impose au fabricant de fixer une période d’assistance d’au moins cinq ans (art. 13, § 8) et de garantir la disponibilité des mises à jour de sécurité pendant dix ans au minimum après leur émission, ou pendant le reste de la période d’assistance si celle-ci est plus longue (art. 13, § 9).
Ce régime ne concerne pas le seul fabricant au sens strict.
L’importateur doit vérifier, avant la mise sur le marché, que les procédures d’évaluation de la conformité ont été menées à bien et que le fabricant a respecté ses obligations (art. 19) ; il doit informer sans retard injustifié le fabricant de toute vulnérabilité dont il prend connaissance, et les autorités de surveillance du marché si le risque de cybersécurité est important (art. 19, § 5).
Le distributeur est soumis à une obligation de diligence équivalente (art. 20, § 4).
Enfin, l’importateur ou le distributeur qui met un produit sur le marché sous son propre nom, ou qui lui apporte une modification substantielle, est réputé fabricant et se trouve directement soumis aux articles 13 et 14 (art. 21 et 22). La qualification d’opérateur économique, retenue de manière fonctionnelle par le CRA, conditionne ainsi l’étendue exacte de la responsabilité pesant sur chaque acteur de la chaîne d’approvisionnement.
L’obligation de notification et le calendrier d’application anticipée du CRA
L’article 14 du CRA impose au fabricant qui prend connaissance d’une vulnérabilité activement exploitée de la notifier à l’ENISA, par l’intermédiaire de la plateforme unique de signalement instituée à l’article 16. L’ENISA a annoncé dans un communiqué de presse du 11 septembre 2026 (2) que la plateforme (3) était opérationnelle.
Cette notification s’effectue en trois temps :
• une alerte précoce dans les 24 heures suivant la connaissance de la vulnérabilité (art. 14, § 2, a),
• une notification détaillée dans les 72 heures (art. 14, § 2, b),
• puis un rapport final dans les 14 jours suivant la mise à disposition d’une mesure corrective (art. 14, § 2, c).Un régime symétrique s’applique aux incidents graves ayant des répercussions sur la sécurité du produit (art. 14, § 3 et 4).
Cette obligation de signalement entretient un lien direct avec le défaut de correction des vulnérabilités : à défaut de correctif disponible dans les délais, le fabricant reste néanmoins tenu de notifier la vulnérabilité et d’informer les utilisateurs des mesures d’atténuation disponibles (art. 14, § 8). Le manquement à cette obligation de notification s’ajoute alors, sur le plan des sanctions, au manquement de fond tenant à l’absence de correction.Il convient à cet égard de souligner le calendrier d’application différencié du CRA, fixé par l’article 71. Si le règlement s’applique de manière générale à compter du 11 décembre 2027, l’article 14 relatif à la notification des vulnérabilités et incidents est entré en application depuis le 11 septembre 2026, tandis que le chapitre IV relatif à la notification des organismes d’évaluation de la conformité s’applique depuis le 11 juin 2026 (art. 71, § 2).
Le régime de sanctions du Chapitre VII du CRA
Le chapitre VII du CRA (art. 63 à 65) organise le dispositif répressif applicable en cas de manquement.
L’article 64 structure les sanctions financières selon la gravité du manquement :
• le non-respect des exigences essentielles de cybersécurité énoncées à l’annexe I et des obligations prévues aux articles 13 et 14 (soit précisément la gestion des vulnérabilités et leur notification) est passible d’une amende pouvant atteindre 15 000 000 euros ou 2,5 % du chiffre d’affaires annuel mondial total de l’exercice précédent, le montant le plus élevé étant retenu (art. 64, § 2) ;
• le non-respect d’obligations procédurales telles que celles relatives aux mandataires, importateurs et distributeurs (art. 18 à 23), à la déclaration UE de conformité (art. 28), au marquage CE (art. 30, § 1 à 4), à la documentation technique (art. 31, § 1 à 4) ou aux procédures d’évaluation de la conformité (art. 32, § 1 à 3) expose à une amende pouvant atteindre 10 000 000 euros ou 2 % du chiffre d’affaires mondial (art. 64, § 3) ;
• la fourniture d’informations inexactes, incomplètes ou trompeuses aux organismes notifiés et aux autorités de surveillance du marché est sanctionnée jusqu’à 5 000 000 euros ou 1 % du chiffre d’affaires mondial (art. 64, § 4).Le défaut de correction d’une vulnérabilité relève ainsi structurellement du palier le plus élevé, dès lors qu’il caractérise un manquement à l’annexe I, partie II, combiné le cas échéant à une violation de l’obligation de notification de l’article 14.
L’article 64, § 5, impose de tenir compte, pour la fixation du montant, de la nature, de la gravité et de la durée de l’infraction, de l’existence de sanctions antérieures pour un manquement similaire, ainsi que de la taille de l’entreprise, en particulier pour les microentreprises et les PME, y compris les jeunes entreprises.
L’article 64, § 10, écarte l’application des amendes administratives dans deux hypothèses :
• d’une part, pour les fabricants qualifiés de microentreprises ou petites entreprises en cas de simple dépassement du délai de notification de 24 heures prévu à l’article 14, § 2, a), ou § 4, a) ;
• d’autre part, pour toute violation du règlement commise par un intendant de logiciels ouverts au sens de l’article 3, point 14.Les amendes administratives peuvent s’ajouter, en application de l’article 64, § 9, à toute autre mesure corrective ou restrictive prononcée par l’autorité de surveillance du marché pour le même manquement, notamment les mesures de retrait ou de rappel prévues aux articles 54 et 58, ou les mesures adoptées à l’échelle de l’Union en application de l’article 55. Un défaut de correction de vulnérabilité peut ainsi donner lieu, simultanément, à une amende, à une mise en demeure de mise en conformité et à un retrait du produit du marché.
La possibilité d’une action de groupe
L’article 65 du CRA renvoie enfin à la directive (UE) 2020/1828 (4), rendant possibles des actions représentatives intentées par des associations qualifiées lorsque le manquement porte atteinte aux intérêts collectifs des consommateurs, hypothèse pertinente en cas d’exposition prolongée des utilisateurs à une vulnérabilité connue et non corrigée.
Cette directive a été transposée par la loi n° 2025-391 du 30 avril 2025 portant diverses dispositions d’adaptation au droit de l’Union européenne (5) qui permet d’exercer une action de groupe « pour le compte de plusieurs personnes physiques ou morales, placées dans une situation similaire, résultant d’un même manquement ou d’un manquement de même nature à ses obligations légales ou contractuelles commis par une personne agissant dans l’exercice ou à l’occasion de son activité professionnelle, par une personne morale de droit public ou par un organisme de droit privé chargé de la gestion d’un service public. »
Une telle action peut permettre d’obtenir la cessation du manquement et/ou la réparation des préjudices.
Portée pratique du CRA pour l’ensemble des opérateurs économiques
Ce régime de sanctions ne vise pas le seul fabricant originel. Tout importateur ou distributeur requalifié en fabricant au sens des articles 21 et 22 (mise sur le marché sous marque propre, modification substantielle du produit) se trouve exposé au même palier de sanction de 15 millions d’euros ou 2,5 % du chiffre d’affaires dès lors qu’il ne respecte pas les obligations de gestion des vulnérabilités désormais applicables à sa charge.
Compte tenu de l’entrée en application de l’obligation de notification depuis le 11 septembre 2026, les opérateurs économiques ont intérêt à structurer leur processus de gestion des vulnérabilités et leur politique de divulgation coordonnée requise par l’annexe I, partie II, point 5. L’anticipation de la documentation technique exigée par l’annexe VII, incluant la justification des périodes d’assistance retenues (art. 13, § 8, dernier alinéa), constitue à cet égard un élément déterminant pour démontrer, en cas de contrôle, la diligence de l’opérateur économique dans le traitement des vulnérabilités de ses produits.
Notes de bas de page :
(1) Règlement (UE) 2024/2847 du Parlement européen et du Conseil du 23 octobre 2024 (consolidé) concernant des exigences de cybersécurité horizontales pour les produits comportant des éléments numériques (règlement sur la cyberrésilience)
(2) La plateforme de déclaration unique des ARC est lancée Communiqué de presse du 11 septembre 2026
(3) ENISA, CRA single reporting plateform
(4) Directive (UE) 2020/1828 du Parlement européen et du Conseil du 25 novembre 2020 relative aux actions représentatives visant à protéger les intérêts collectifs des consommateurs
(5) Loi n° 2025-391 du 30 avril 2025 portant diverses dispositions d’adaptation au droit de l’Union européenne en matière économique, financière, environnementale, énergétique, de transport, de santé et de circulation des personnes Katharina Berbett
Avocate, Directrice du département Informatique contentieux complexe Mathilde Pennès-Lavoye
Avocate, collaboratrice du département Informatique contentieux complexe
L’article Vulnérabilités non corrigées : le régime de sanctions du CRA est apparu en premier sur Lexing Avocats.
-
YouTube, Facebook, Wikipedia, Forbes : ChatGPT cite beaucoup moins ces domaines
www.abondance.comCe qu'il faut retenir :
- Selon David Konitzny (Peec AI), YouTube a perdu 91 % de sa part des citations de ChatGPT par rapport à août, dans une analyse publiée sur LinkedIn le 25 septembre 2026.
- D'autres domaines majeurs reculent fortement sur la même période : facebook.com (−88,1 %), wikipedia.org (−78,4 %) et forbes.com (−71,7 %), d'après les mêmes données de suivi.
- La baisse ne s'explique pas par une simple dilution : en volume absolu, indexé sur juillet, ChatGPT cite effectivement YouTube beaucoup moins souvent qu'en août.
- Ces domaines peuvent toujours être récupérés par ChatGPT pendant sa recherche : les professionnels doivent distinguer, dans leur suivi, les sources consultées des sources réellement citées.
YouTube a perdu 91 % de sa part de citations dans ChatGPT
L'alerte vient de David Konitzny, GEO Researcher chez Peec AI, un outil de suivi de la visibilité des marques dans les moteurs de réponse IA. Dans une publication LinkedIn du 25 septembre 2026, il indique que YouTube a perdu 91 % de sa part des citations de ChatGPT par rapport au mois d'août.
Pour rappel, la « part de citations » mesure la proportion des sources citées par ChatGPT (les liens affichés à l'appui d'une réponse) qui proviennent d'un domaine donné. Le GEO (Generative Engine Optimization) désigne l'ensemble des pratiques visant à améliorer la présence d'une marque ou d'un contenu dans ces réponses générées.
Le chercheur résume la tendance d'une formule : ChatGPT « est en train de se lasser de YouTube ». Il ne précise pas les dates exactes des périodes comparées, ni les marchés ou langues couverts.
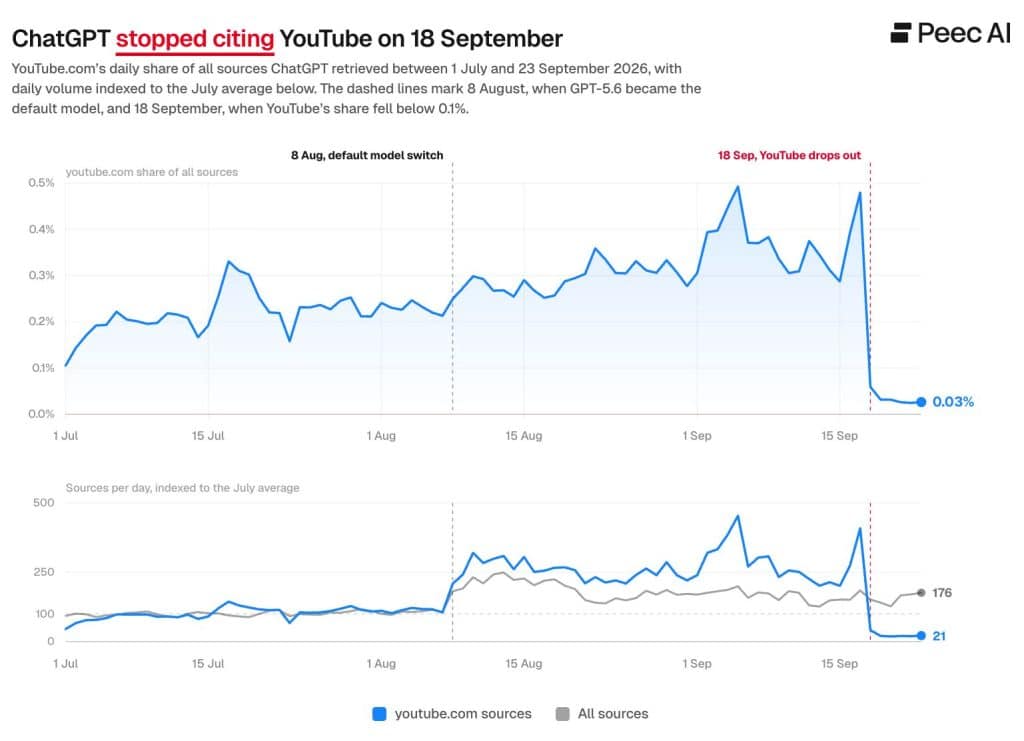 Chute de YouTube dans ChatGPT - Source : compte de David Konitzny sur LinkedIn
Facebook, Wikipedia et Forbes reculent aussi fortement
YouTube n'est pas un cas isolé. D'après les mêmes données, plusieurs domaines très présents dans les réponses de ChatGPT enregistrent des baisses comparables :
- facebook.com : −88,1 %
- wikipedia.org : −78,4 %
- forbes.com : −71,7 %
La liste mêle des plateformes sociales, une encyclopédie collaborative et un média économique. Le mouvement ne se limite donc pas aux réseaux sociaux ou aux contenus générés par les utilisateurs. David Konitzny ne précise pas si ces pourcentages portent, comme pour YouTube, sur la part de citations, ni quels domaines ont profité de ce recul.
La baisse se retrouve aussi en volume absolu
Une chute de part de citations peut être trompeuse. Si ChatGPT se met à citer beaucoup plus de sources par réponse, un domaine perd mécaniquement de la part, même si son nombre de citations reste stable. David Konitzny dit s'être posé la question.
Pour la trancher, il a indexé le volume réel de citations de YouTube en prenant juillet comme base de référence. Selon lui, la baisse y est aussi nettement visible. Autrement dit, YouTube n'est pas seulement noyé dans un pool de sources plus large : ChatGPT le cite concrètement beaucoup moins souvent qu'en août.
Côté méthodologie, le chercheur indique que l'analyse repose sur des centaines de milliers de prompts, de marque et hors marque (requêtes qui mentionnent ou non un nom de marque), suivis de façon constante dans le temps. Ces données restent déclaratives : la méthodologie détaillée et les chiffres bruts n'ont pas été publiés. Il invite d'ailleurs les lecteurs à vérifier dans leurs propres outils de suivi le nombre absolu de citations issues de ces domaines sur les derniers jours.
Un domaine peut être récupéré sans être cité
David Konitzny insiste sur une nuance qu'il résume par « Retrieved ≠ Cited ». Lorsqu'il effectue une recherche web, ChatGPT récupère d'abord un ensemble de pages (phase de récupération, ou retrieval), qu'il analyse et utilise pour construire sa réponse. Seule une partie de ces pages apparaît ensuite parmi les sources citées.
Selon le chercheur, rien n'indique que YouTube, Facebook, Wikipedia ou Forbes ont disparu de cette phase de récupération. Ils peuvent toujours être consultés et exploités pendant la recherche. Ce que montrent les données est plus spécifique : ces domaines figurent beaucoup moins souvent dans les sources finalement citées.
Pour les marques, la conséquence est concrète. Un contenu YouTube peut continuer à nourrir une réponse de ChatGPT sans générer de lien visible, donc sans trafic ni attribution mesurable.
Un nouvel épisode après la chute des citations sociales d'août
Ce mouvement s'inscrit dans une série de changements brutaux observés ces dernières semaines. Selon une analyse de Petra Labs relayée par Storyboard18, la part de Reddit dans les citations de ChatGPT a reculé d'environ 81 % autour du 14 août, et YouTube avait alors enregistré la plus forte baisse, à 88 %, devant Reddit et TikTok (72 %). Petra Labs notait que ce recul ne s'accompagnait pas d'une baisse comparable de la visibilité des marques dans les réponses, les citations semblant s'être déplacées vers les sites des entreprises et les plateformes d'avis.
Promptwatch, un autre outil de suivi, a mesuré un mouvement similaire sur Reddit. Sa part des sources citées par ChatGPT serait passée de 3,83 % entre le 18 juillet et le 7 août à 0,52 % sur la période du 14 au 17 août, soit une baisse relative de 86,4 %. OpenAI n'a pas confirmé officiellement la cause de ces changements.
Les chiffres de David Konitzny posent une question de chronologie. D'après des données Meltwater rapportées par Digiday le 23 septembre, YouTube était la plateforme la plus citée en août 2026 sur huit produits IA, dont ChatGPT. La baisse mesurée par Peec AI pourrait donc correspondre à une nouvelle vague, postérieure à celle de la mi-août, ou prolonger la même tendance selon la période de référence retenue.
Reste la question que David Konitzny laisse lui-même ouverte à la fin de sa publication : pourquoi ? Ni Peec AI ni OpenAI n'ont avancé d'explication à ce stade.
À noter : Peec AI est un éditeur d'outil GEO, les données ne sont pas auditées de façon indépendante.
L’article "YouTube, Facebook, Wikipedia, Forbes : ChatGPT cite beaucoup moins ces domaines" a été publié sur le site Abondance.
-
« Les data centers seront la première source de revenus de Qualcomm d’ici 2033 »
www.usine-digitale.frQualcomm est déterminé à s’accaparer une part du marché des data centers, qui explose en ce moment pour répondre aux besoins de l’intelligence artificielle générative. Il a annoncé en juin qu’il vise des revenus annuels supérieurs à 15 milliards de dollars pour cette activité d’ici à 2029.
-
« On ne confierait pas à un modèle de langage le pilotage d’un avion ». C’est tout l’enjeu de l’après-LLM, selon Arlequin AI
www.numerama.com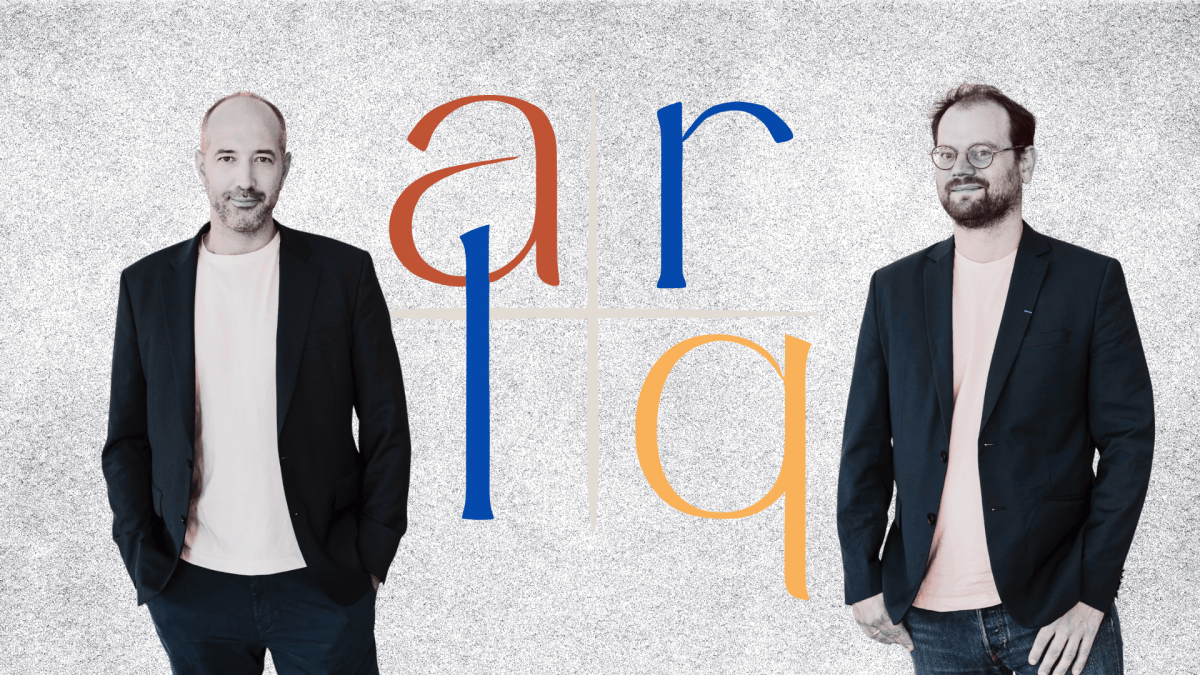
Après une levée de fonds de 28 millions d'euros en série A, la start-up française Arlequin AI sort progressivement de sa phase de discrétion. Son architecture, fondée sur des réseaux de neurones topologiques, vise des secteurs où une erreur coûte cher : sécurité, défense, finance. Rencontre avec ses deux fondateurs.
-
Amazon brade l’écran OLED incurvé LG UltraGear de 39 pouces à moins de 700 €
www.numerama.com
[Deal du jour] Le LG UltraGear 39GS95QE, un écran de jeu OLED ultralarge et incurvé de 39 pouces, voit son prix fondre sur Amazon. Il passe à 699,99 € au lieu de 1 499 € à sa sortie.
-
Votre abonnement Amazon Prime peut aussi faire baisser votre facture d’électricité de 120 €
www.numerama.com
EDF rembourse 120 euros aux membres Amazon Prime qui souscrivent chez elle un contrat d'électricité en offre de marché, depuis ce mardi 22 septembre et jusqu'au lundi 28 septembre 2026. L'opération est limitée à 10 000 remises.
-
Pour aider son fils dyslexique, ce père a créé un jeu gratuit qui apprend à taper au clavier
www.numerama.com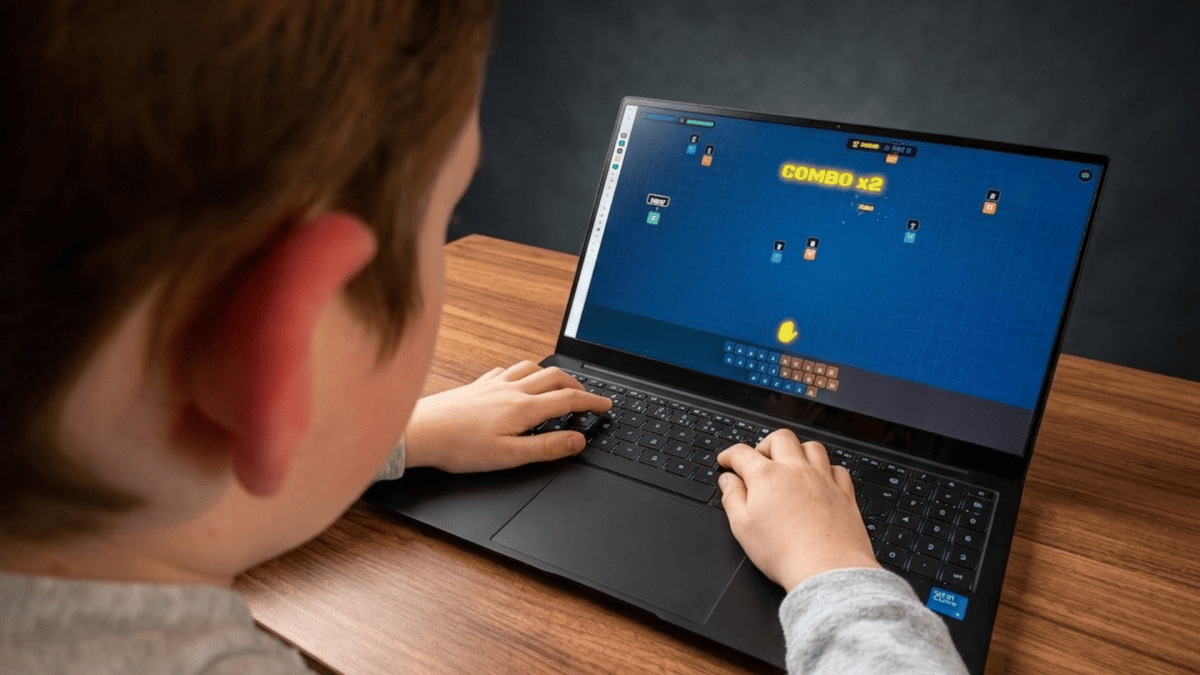
Des lettres à détruire, des boss à affronter et un clavier à apprivoiser : avec Fort-Dactylo, Nicolas Drolo veut rendre l’apprentissage de la frappe plus ludique. Un jeu gratuit conçu avec son fils, à partir de ses difficultés à l’école.
-
Google ajoute la propriété creator aux données structurées vidéo
www.abondance.comDamien constate aussi que Google Discover affiche de plus en plus de vidéos hébergées par les éditeurs, avec un bouton de lecture et leur durée. Google confirme qu'elles peuvent y apparaître et que ce balisage l'aide à les trouver. Autant mettre toutes les chances de votre côté pour apparaître dans les blocs vidéo de Google comme dans le flux Discover.
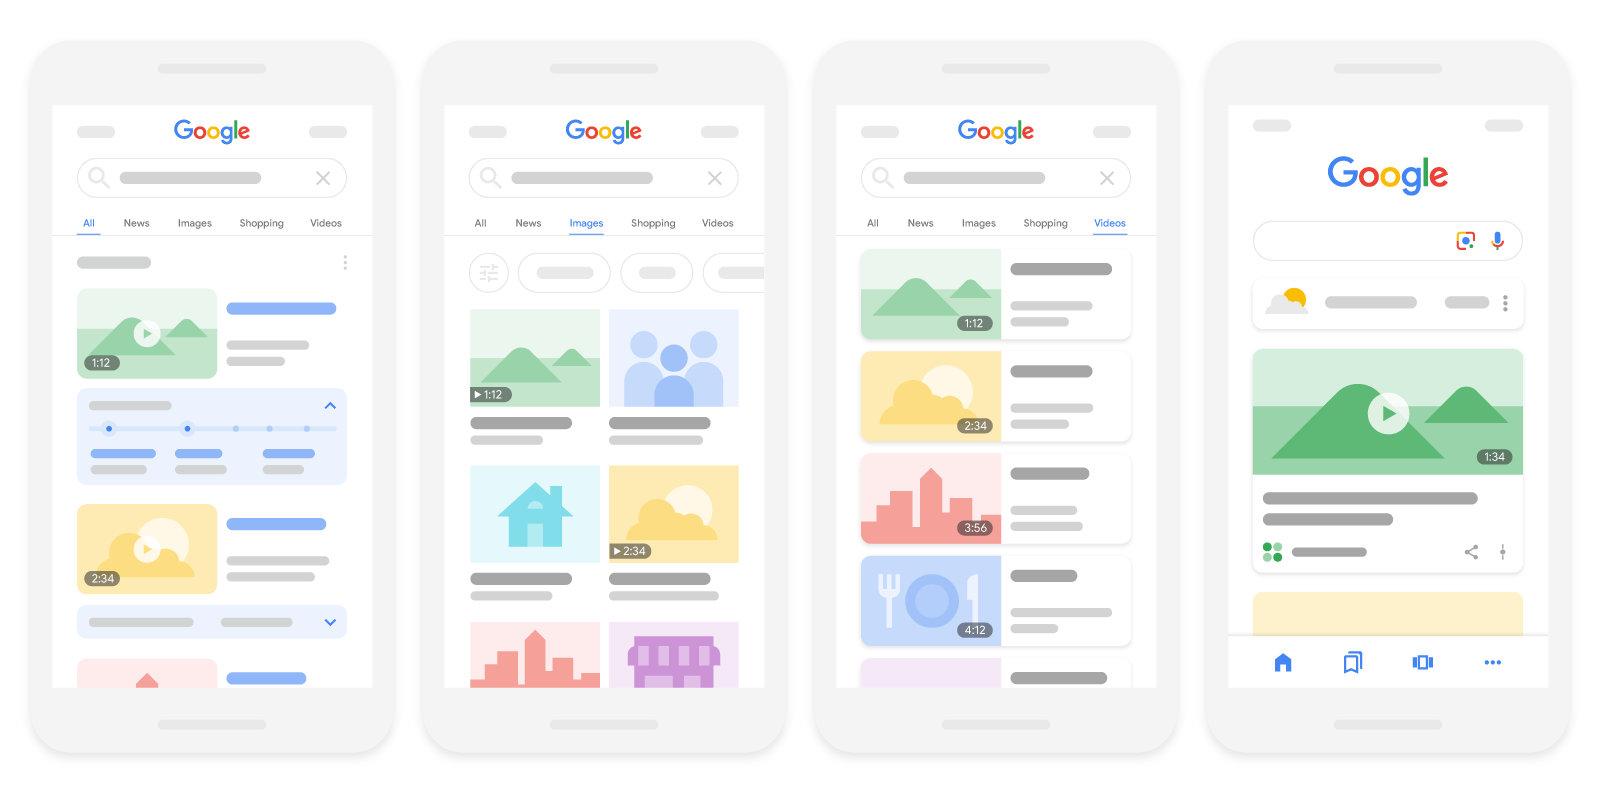 Une vidéo peut apparaître dans les résultats, Google Images, l'onglet Vidéos et Discover. Source : Google Search Central.
Seules trois propriétés sont obligatoires :
name,thumbnailUrletuploadDate. Google recommande d'y ajoutercontentUrl(ouembedUrlà défaut),description,durationet désormaiscreator. Voici un exemple :<script type="application/ld+json"> { "@context": "https://schema.org", "@type": "VideoObject", "name": "Titre unique de votre vidéo", "description": "Résumé unique de votre vidéo", "thumbnailUrl": "https://www.example.com/miniature.jpg", "uploadDate": "2026-09-24T10:00:00+02:00", "duration": "PT4M12S", "contentUrl": "https://www.example.com/videos/ma-video.mp4", "creator": { "@type": "Organization", "name": "Nom de votre marque", "url": "https://www.example.com" } } </script>La page qui héberge la vidéo doit elle-même être indexée (bonnes pratiques SEO pour les vidéos). Contrôlez ensuite votre code avec le test des résultats enrichis.
L’article "Google ajoute la propriété creator aux données structurées vidéo" a été publié sur le site Abondance.
-
Google SAFE : un détecteur de spam IA conçu pour les chaînes YouTube
www.abondance.comCe qu'il faut retenir :
- SAFE est décrit dans un papier de recherche de trois pages, signé par sept auteurs de Google et rattaché à la conférence IEEE TPS 2026.
- Les schémas du papier montrent des données issues de chaînes YouTube. Le texte ne parle jamais de sites web ni de classement.
- Le papier évoque des « premiers résultats de déploiement » sans publier un seul chiffre.
- Aucun élément ne relie SAFE aux Spam Updates d'août et de septembre 2026.
- La doctrine de Google sur les contenus IA reste stable : il juge la valeur d'un contenu pour l'internaute, quelle que soit la façon dont il a été produit.
Un outil d'enquête confié à des agents IA
Le papier s'intitule The Synthetic Gap: Automating Forensic Investigation of "AI Slop" with the Scaled Abuse Forensics Examiner (SAFE). Ses auteurs partent d'un constat : des réseaux de comptes publient en masse des contenus générés par IA, tous légèrement différents, qui échappent ainsi aux filtres anti-doublons. Les enquêtes manuelles ne suivent plus le rythme.
SAFE confie donc l'enquête à quatre agents IA :
- L'agent principal reçoit un groupe de chaînes suspectes, confie l'analyse aux trois autres, puis tranche : réseau coordonné ou activité normale.
- L'agent « contenu » cherche les traces de production automatisée, comme un même script repris d'une chaîne à l'autre. Il repère aussi les contenus qui respectent la lettre des règles tout en trahissant leur esprit.
- L'agent « comportement » relève les signes d'automatisation : même version de système, mises en ligne dans la même fenêtre de cinq secondes, publications en rafale.
- L'agent « relations » cartographie les liens entre les chaînes, pour traiter le réseau entier plutôt que des comptes isolés.
SAFE analyse des chaînes YouTube
Les schémas du papier lèvent le doute sur la plateforme visée : la figure 1 montre des bases de données intitulées « YT Channel signals » et « YT Channel Connections », alimentées par les métadonnées des chaînes et des vidéos. Dans la figure 2, l'agent chargé du contenu dispose d'un « Video Analyzer ». Les trois pages ne mentionnent jamais les sites web, le classement dans les résultats ni SpamBrain, le système anti-spam de Google Search.
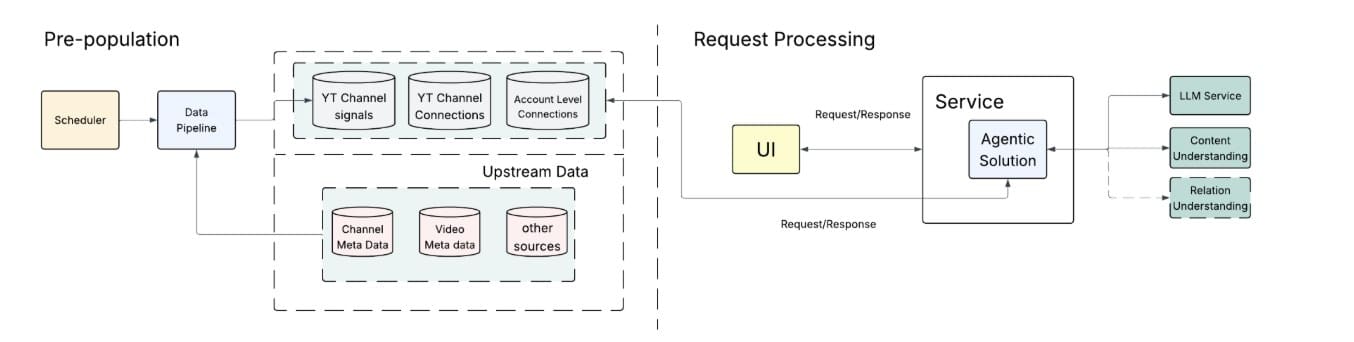 Figure 1 du papier SAFE : les données viennent des chaînes YouTube (« YT Channel ») et des métadonnées des vidéos. Source : Google Research.
SAFE prolonge un premier papier de la même équipe, daté de mai, avec un auteur en commun, consacré à un système baptisé S-CTS. Son résumé le présente comme conçu pour les « online video platforms ».
Ces travaux rejoignent un chantier public de YouTube, qui a précisé le 15 juillet 2025 que les contenus répétitifs ou produits en masse (« inauthentic content ») ne sont pas monétisables (règles du Programme Partenaire YouTube).
Un déploiement annoncé sans aucun chiffre
Le titre de Search Engine Journal affirme que Google « a déployé » SAFE. Cette affirmation repose sur une seule phrase du résumé : « Early deployment results indicate that SAFE significantly accelerates the identification of novel synthetic threats ». La partie consacrée à l'évaluation annonce ensuite quatre indicateurs au futur, sans aucune valeur chiffrée. Search Engine Journal note d'ailleurs que le papier ne partage pas les résultats de ses tests.
Le papier S-CTS, lui, publie des résultats obtenus sur six mois : l'examen d'un groupe de comptes prend 32 % de temps en moins qu'avec des analystes seuls, et celui des contenus 50 % de temps en moins. Les gains se mesurent en temps d'enquête pour les équipes de modération.
Aucun lien établi avec les Spam Updates de 2026
Google a lancé quatre Spam Updates depuis janvier : en mars, en juin, du 18 au 21 août, puis le 24 septembre, pour un déploiement qui peut durer jusqu'à deux semaines. L'annonce de septembre indique seulement que la mise à jour s'applique à toutes les langues et à tous les pays, sans un mot sur l'IA.
Le papier SAFE date de fin mai et précède bien les mises à jour d'août et de septembre citées par Glenn Gabe. Cette chronologie ne suffit pas à établir un lien, et Search Engine Journal reste prudent lorsqu'il écrit que SAFE « may be a part of Google's Spam Update ».
La position de Google sur les contenus IA reste inchangée
Depuis février 2023, Google explique qu'il récompense les contenus de qualité « however it is produced » (Search Central). Ses règles contre l'abus de contenu à grande échelle, dont la page a été mise à jour le 28 août 2026, visent la production massive de pages sans valeur pour l'internaute, « no matter how it's created » (règles de Google contre le spam). L'usage de l'IA générative pour créer de nombreuses pages sans valeur ajoutée figure parmi les exemples cités, au même titre que la reprise automatique de contenus d'autres sites.
Les études qui mesurent la part de contenus IA dans les résultats reposent sur des détecteurs d'IA plus ou moins fiables, je préfère donc ne pas m'appuyer sur leurs chiffres.
Pourquoi ce papier mérite tout de même votre attention
Je peux me tromper, mais je ne pense pas que SAFE examine vos pages. Le papier montre en revanche comment les équipes de Google abordent les contenus générés en masse : elles étudient un réseau de comptes dans son ensemble, à partir de son comportement et des liens entre ses membres, plutôt que chaque contenu isolément. Rien n'indique que Google Search procède de la même façon.
Pour un site web, le cadre à surveiller reste celui des règles anti-spam de Google Search. J'arrivais à la même conclusion dans Google punit-il les sites qui utilisent l'IA ? : Google s'en prend aux abus et au spam, c'est-à-dire aux pages produites en série qui n'apportent rien à l'internaute, quel que soit l'outil utilisé pour les écrire.
L’article "Google SAFE : un détecteur de spam IA conçu pour les chaînes YouTube" a été publié sur le site Abondance.
-
Amazon déstocke sa liseuse Kindle Scribe de 2024 avec l’arrivée de la nouvelle génération
www.numerama.com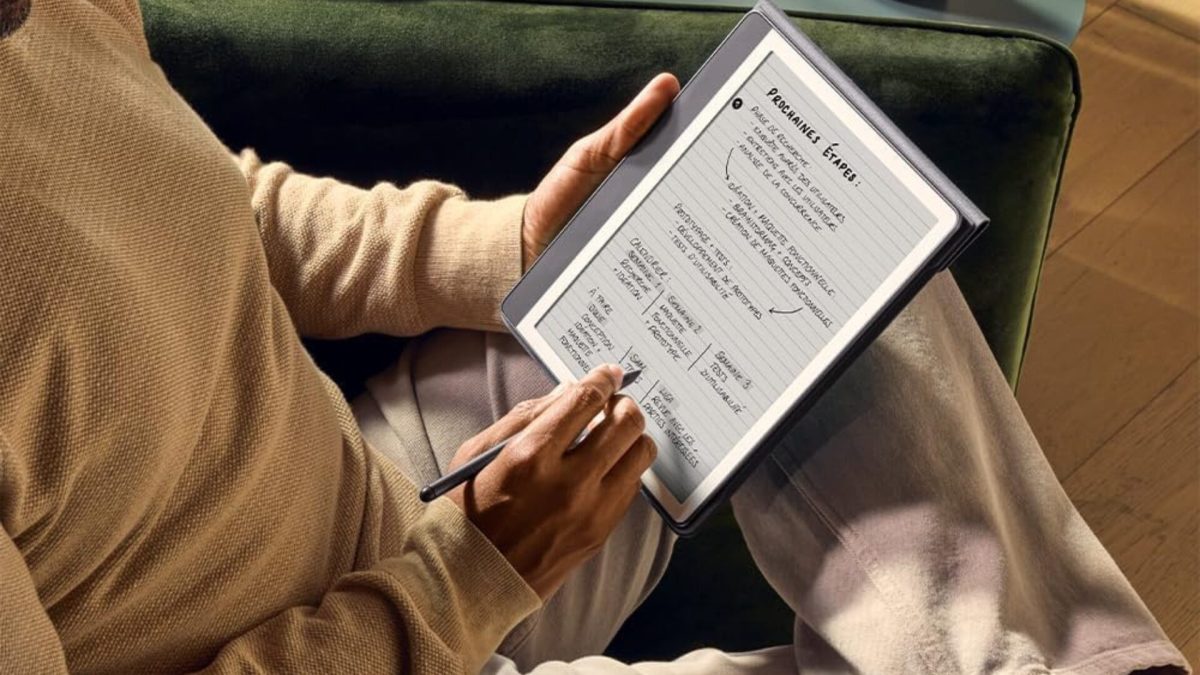
[Deal du jour] Depuis le mois de juin, Amazon vend en France une toute nouvelle gamme de Kindle Scribe. Le modèle de 2024 en profite pour descendre à 259,99 € au lieu de 479,99 €, stylet Premium compris.
-
Optimus, le robot Tesla : entre pièces défectueuses et salariés qui refusent de former leur remplaçant
www.numerama.com
Poussé par un Elon Musk prêt à tout pour transformer son constructeur automobile en empire de la robotique, Tesla fait face à la fronde de ses salariés. Entre pièces défectueuses et salariés qui refusent de former leur remplaçant, c'est un casse-tête.
-
Ce purificateur change de couleur selon la qualité de l’air que vous respirez, et son prix baisse déjà
www.numerama.com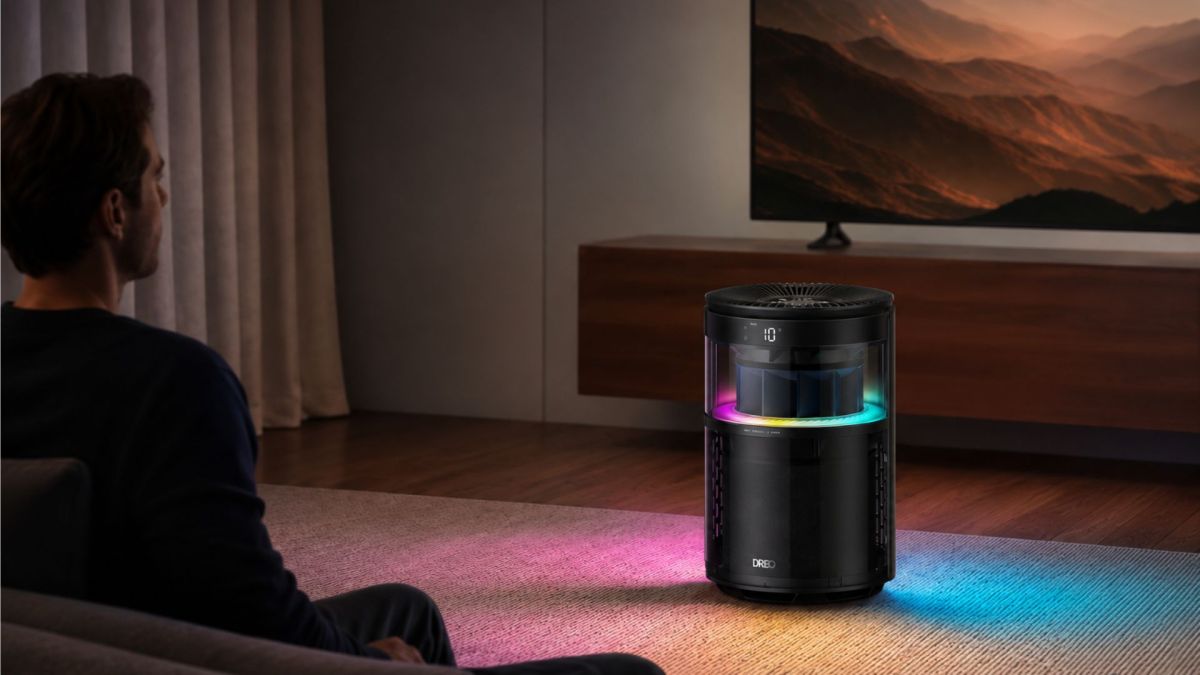
[Deal du jour] Trois semaines après sa présentation à l’IFA de Berlin, le purificateur d’air connecté Dreo 530S est déjà en promotion. Amazon le propose à 114,99 € au lieu de 139,99 €.
-
Meta VR, succès de Muse et Googlebook – le récap’ tech de la semaine
www.numerama.com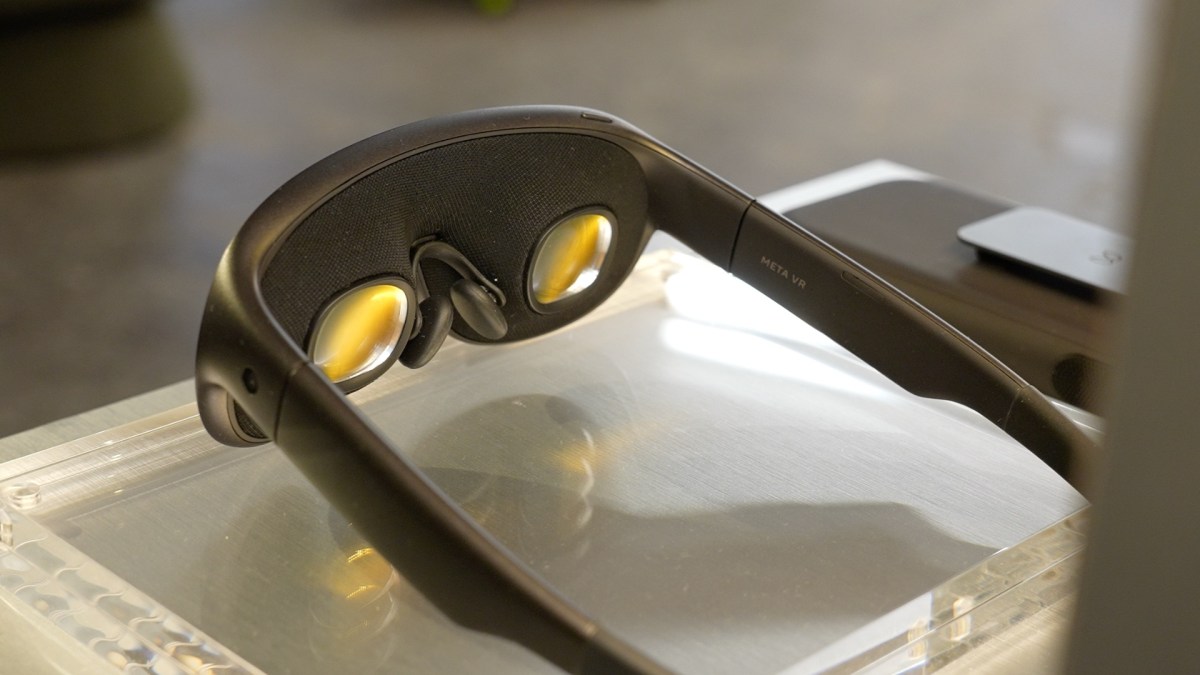
Cette semaine, Meta a organisé sa grande conférence Meta Connect. L'entreprise de Mark Zuckerberg a dévoilé des lunettes de réalité virtuelles, des nouvelles lunettes Ray-Ban et des nouveautés pour son intelligence artificielle Muse, dont un petit objet pour lui parler sans sortir son téléphone. De son côté, Google a lancé sa réponse aux PC et aux Mac : les Googlebook, qui fusionnent Android et ChromeOS.
-
Arrivé en bout de course, inadapté face aux drones : l’Australie dit adieu à l’hélicoptère Tigre
www.numerama.com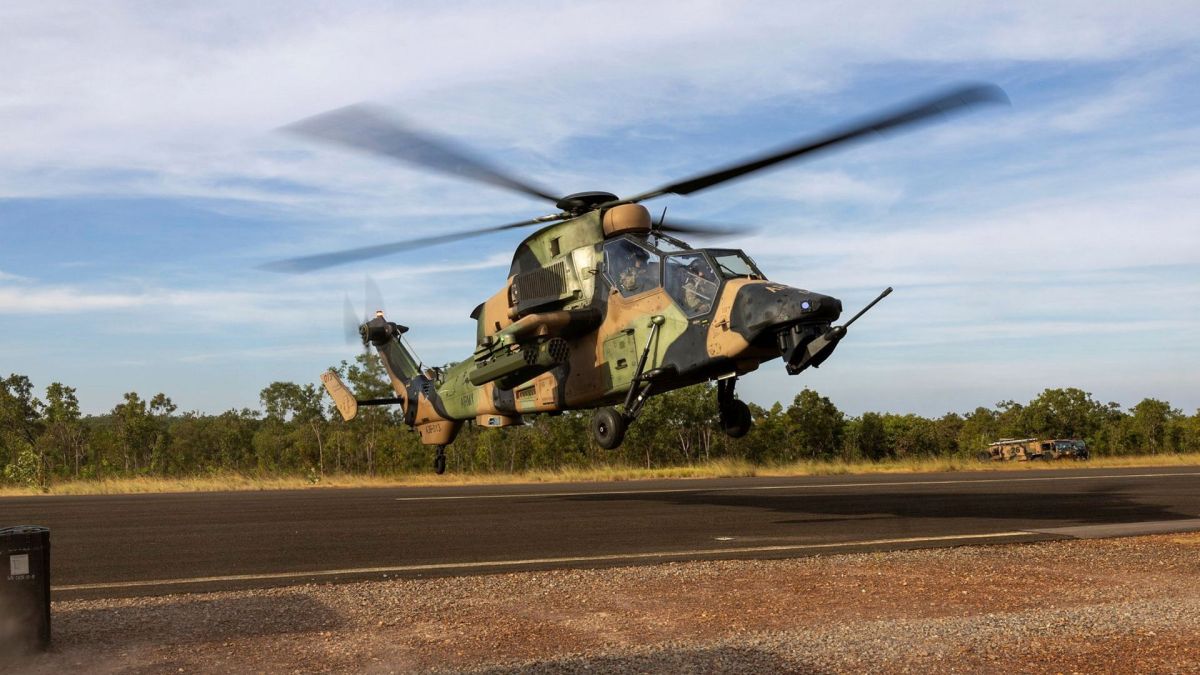
L'armée australienne a annoncé la fin des vols de ses 22 hélicoptères de combat Tigre, conçus par Airbus, qui seront remplacés par l'Apache de Boeing.
-
Des robots humanoïdes pour pallier le manque de personnel dans l’armée ? Le Japon y songe
www.usine-digitale.frLes militaires japonais pourraient bientôt réaliser leurs missions aux côtés de machines d’acier et d’aluminium. Le pays du Soleil levant va étudier l’utilisation de robots humanoïdes à des fins de défense, a rapporté le 23 septembre Japan Today citant des sources gouvernementales et du Parti libéral-démocrate actuellement au pouvoir.
-
Sécurité économique : l’État présente sa doctrine et détaille les garde-fous imposés aux investisseurs étrangers dans la tech
www.usine-digitale.frLa protection des entreprises françaises considérées comme stratégiques ne s’arrête pas à leur capital. Lorsqu’un investisseur étranger entre au capital d’une société exerçant une activité sensible, l’Etat peut imposer des contraintes sur son organisation, sa propriété intellectuelle ou encore ses systèmes d’information.
-
Couverture 5G en France : presque tout le monde capte, mais la moitié du territoire est encore à l’écart
www.numerama.com
Le déploiement de la 5G a fortement progressé au cours de ces six dernières années. Presque la totalité de la population capte désormais l'ultra haut débit mobile, mais la couverture du territoire est encore très perfectible. Surtout, de grosses disparités entre les territoires demeurent.
-
HighLife, Biolevate, Wealthcome : près de 189 millions d’euros levés dans la French Tech cette semaine
www.frenchweb.frDu 19 au 25 septembre, 14 opérations françaises totalisent près de 189 M€. La santé concentre les plus gros montants, tandis que les logiciels métier et les infrastructures IA attirent les capitaux lorsqu’ils sont déjà branchés sur des opérations critiques. Près de 189 millions d’euros en une semaine, le chiffre pourrait laisser croire à un …
L’article HighLife, Biolevate, Wealthcome : près de 189 millions d’euros levés dans la French Tech cette semaine est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Le nouveau Microsoft Copilot s’attaque à Claude et ChatGPT (en utilisant Claude et ChatGPT)
www.numerama.com
Microsoft annonce une refonte de son application Copilot autour de trois onglets : Home, Code et Autopilot (ex-Scout). L'entreprise rêve d'inventer le Microsoft Office de l'intelligence artificielle en proposant un hub aux utilisateurs de Windows. Son principal problème est que, pour l'instant, elle dépend encore massivement des modèles d'Anthropic, OpenAI ou SpaceXAI.
-
30 km déminés en deux nuits : comment les drones terrestres se sont imposés dans la contre-offensive ukrainienne
www.numerama.com
Déminage, largage derrière les lignes russes, logistique… les robots terrestres sont au cœur de la contre-offensive menée dans le nord de la région de Donetsk.
-
“L’un des frameworks de manipulation robotique open source les plus utilisés” : Pourquoi Qualcomm met la main sur l’américain PickNik
www.usine-digitale.frQualcomm s’introduit un peu plus dans la robotique, et pas uniquement sur la partie matérielle. L’entreprise américaine de semi-conducteurs a annoncé le 23 septembre la signature d’un accord pour l’acquisition de PickNik, société de logiciels de robotique basée dans le Colorado. “Le logiciel est le lien essentiel qui transforme un matériel performant en robots performants”, a déclaré dans un communiqué Nakul Duggal, General Manager de l’automobile et la robotique chez Qualcomm.