Tech-fr publisher
-
curl.md - Récupérez le texte de n'importe quelle page web au format Markdown
korben.infoJe ne sais pas si vous connaissez curl.md, mais c'est un service qui prend l'adresse d'une page web et vous l'affiche en Markdown. Y'a pas de menus, pas de bandeaux de cookies, et ce genre de conneries... C'est juste le texte de votre article, les titres, les liens et les tableaux.
Et le plus sympa, c'est que vous n'avez rien à installer pour l'essayer. Vous collez
curl.md/devant l'adresse qui vous intéresse, dans la barre de votre navigateur, et vous obtenez la page en texte markdonw. Aveccurldans un terminal, c'est pareil, la réponse arrivera entext/markdown, et si vous préférez du JSON, vous envoyez l'en-têteAccept: application/json.
Un article de korben.info passé par curl.md : le texte, les liens, et un en-tête de métadonnées en haut
Et vous pouvez aller plus loin en ajoutant un objectif avec le paramètre --objective. Par exemple, vous décrivez ce que vous cherchez dans la page, et le service ne vous renvoie que le passage qui correspond. Il y a aussi des mots-clés, qui font un pré-filtrage avant l'extraction, et un mode
smartourushselon que vous voulez une passe plus poussée ou plus rapide. Tout ça passe en paramètres d'URL, donc sans ligne de commande.Pour ceux qui y reviennent souvent, il existe également un client à installer avec npm, avec bun ou avec un script, et qui s'invoque ensuite par
curl.mdou par son alias courtmd:# Sans rien installer curl curl.md/example.com # Ou avec le client npm i -g curl.md md zod.dev/error-formatting --objective "tree error formatting"Côté agents de code, il y a des intégrations natives pour Amp, Claude, OpenCode et Pi. Si votre outil n'est pas dans la liste, le client sait aussi tourner en serveur MCP avec
curl.md --mcp, et il existe un SDK TypeScript. Dans tous les cas, c'est l'agent qui va chercher les pages tout seul, vous n'avez plus rien à lui coller.Du coup, ça sert à quoi ?
Bah dans le cadre de votre boulot, c'est surtout pour arrêter de coller des pages entières dans vos prompt. Vous donnez à votre agent la doc d'une bibliothèque avec un objectif précis, et il reçoit trois paragraphes au lieu de quarante pages HTML.
Ça marche aussi pour un script de veille qui suit les notes de version d'un projet, ou pour aspirer une doc dans un fichier texte que vous garderez dans le dépôt (bien plus lisible qu'un PDF dans un coin...).
Et en usage perso, ça vous permet de récupérer par exemple un article pour le relire au calme dans Obsidian, d'archiver une recette ou un mode d'emploi avant qu'il disparaisse, ou de vous envoyer une page à ChatGPT sans lui faire avaler la moitié du site autour. Notez que si c'est la consommation de vos agents qui vous embête, j'avais parlé de RTK, un proxy qui économise des tokens sur le même principe.
Par contre, il y a un plafond. En mode anonyme sur la version hébergée, vous avez droit à 100 requêtes par heure, et 1 000 une fois connecté. Et pour les requêtes avec un objectif, celles qui font justement l'intérêt du truc, c'est 3 par heure en anonyme et 10 en étant connecté. Bref, de quoi essayer, mais pas vraiment de quoi travailler... Au-delà, faudra passer par des crédits prépayés, à recharger par tranches de 5, 10, 20 ou 50 dollars.
Et si vous ne voulez pas dépenser d'argent, le code source est public sur GitHub sous licence MIT pour l'auto-héberger chez vous.
C'est à tester sur curl.md , et merci à Camille Roux pour le lien !
-
2035 : Quel futur pour le numérique ?
incyber.orgLes grandes ruptures technologiques nous rappellent que les transformations les plus profondes sont aussi les plus difficiles à anticiper.
L’intelligence artificielle s’installe dans notre quotidien et dans celui des organisations. À l’horizon 2035, cette accélération va nous conduire vers un monde différent de celui que nous connaissons aujourd’hui.
Dans ce contexte, imaginer le numérique de 2035 n’est plus un exercice réservé aux futurologues. C’est devenu une nécessité stratégique.
C’est précisément l’ambition de la 11ème Journée de la Transition Numérique organisée par eFutura : ouvrir un espace de réflexion collective sur les futurs possibles du numérique et sur les choix qu’ils impliquent dès aujourd’hui.
Le numérique, nouvel attribut de la puissance
Nouveaux empires, rivalités technologiques, souverainetés : le numérique rebat les cartes.
À l’horizon 2035, quels seront les centres d’influence ? La compétition mondiale se joue sur la puissance économique, industrielle et militaire transformée et augmentée par le numérique. Elle dépend désormais de la capacité des États et des entreprises à maîtriser des ressources stratégiques : données, semi-conducteurs, infrastructures numériques, capacités de calcul, cybersécurité et intelligence artificielle. Et à inventer de nouveaux objets pilotés par le numérique et l’intelligence artificielle : drones, robots …La maîtrise des technologies critiques devient un élément déterminant de l’autonomie stratégique, tandis que les dépendances technologiques constituent de nouvelles vulnérabilités. Dans ce monde en recomposition, quelle place l’Europe pourra-t-elle occuper ?
L’intelligence artificielle, accélérateur de transformations
Parmi toutes les évolutions technologiques, l’intelligence artificielle occupe une place particulière. Son développement ne constitue pas simplement l’arrivée d’un nouvel outil. L’Intelligence Artificielle transforme l’organisation des entreprises, l’organisation du travail et la production de valeur.
Des métiers seront recomposés, certaines tâches automatisées et de nouvelles compétences deviendront indispensables. La capacité à collaborer avec les IA et à les piloter est en passe de devenir une compétence professionnelle fondamentale.
Cette évolution pose également une question économique et sociale majeure : comment répartir les gains de productivité et la valeur générés par ces technologies ? Formation, employabilité et adaptation des organisations seront au cœur de cette transition.
Quand le numérique transforme la société
Les moteurs de recherche, les réseaux sociaux puis les intelligences artificielles deviennent progressivement des intermédiaires entre les citoyens et la connaissance. Cette évolution transforme notre manière de nous informer, d’apprendre et de construire nos opinions. Elle interroge la fiabilité de l’information, la désinformation et notre autonomie de jugement.
C’est la place de l’humain qui est questionnée. Comment préserver notre esprit critique lorsque des algorithmes sélectionnent, produisent et synthétisent une part croissante de l’information ? Quelle place donner aux systèmes intelligents dans nos décisions ?
L’éducation sera elle aussi profondément concernée. Lorsque l’accès à la connaissance devient presque instantané, transmettre des savoirs ne suffit plus. Compréhension, esprit critique, créativité, capacité de questionnement et discernement deviennent essentiels.
Innovation, libertés et choix de société
L’omniprésence des technologies pose enfin la question de l’équilibre entre innovation et libertés individuelles. Alimentées par l’ensemble de nos données, l’Intelligence Artificielle offre des possibilités considérables dans tous les domaines : santé, agriculture, mobilité, services publics … mais peuvent également favoriser de nouvelles formes de surveillance, de manipulation, de dépendance, de solitude.
Derrière la révolution technologique se dessine ainsi une interrogation fondamentale : à quelle société numérique souhaitons-nous appartenir ? En Europe, notre défi sera de bénéficier du progrès technologique sans renoncer aux principes qui structurent nos sociétés : protection de la vie privée, liberté individuelle, transparence, pluralisme et responsabilité.
La Journée de la Transition Numérique eFutura
eFutura réunit une nouvelle fois experts et décideurs qui confronteront leurs visions du monde de 2035 lors de sa 11ème Journée de la Transition Numérique, évènement désormais incontournable.
La prospective n’a pas vocation à prédire l’avenir. Elle permet d’explorer plusieurs futurs possibles, d’identifier les ruptures susceptibles de modifier nos trajectoires et d’éclairer les décisions du présent.
Si l’avenir reste incertain, une certitude demeure : une partie du monde numérique de 2035 se construit aujourd’hui.eFutura – contact@efutura.fr
PROGRAMME DE LA 11ème JTN
En présentiel sur invitation ou en distanciel Inscription sur le site https://www.efutura.fr/
9h20 – 9h45 : PROSPECTIVE 2035 DU NUMÉRIQUE
2035 se dessine dès aujourd’hui. Entre accélérations technologiques, tensions géopolitiques et transformations sociétales, le numérique redéfinit les équilibres économiques, politiques et hu mains. Cette journée propose un temps fort pour anticiper, questionner et éclairer les décisions d’aujourd’hui face aux incertitudes de demain.
Conférence introductive par Alain BAUER – Professeur émérite de criminologie, auteur et spé cialiste des questions de sécurité internationale
9h50 – 11h15 : QUELLE GÉOPOLITIQUE EN 2035 ?
Nouveaux empires, rivalités technologiques, souverainetés redéfinies : le pouvoir change de vi sage. À l’horizon 2035, quels seront les centres d’influence ? Une table ronde pour comprendre les rapports de force à venir et leurs impacts pour les entreprises et les décideurs européens.
Johanna BROUSSE – Vice-procureur, Chef de la section de lutte contre la cybercriminalité, Par quet de Paris, autrice de « Cybercombattante »
Général Marc WATIN-AUGOUARD – Fondateur du Forum INCYBER (FIC)
Henri D’AGRAIN – Délégué général du Cigref, Commission Supérieure du Numérique et des Postes
Animateur : Wladimir TARANOFF – Responsable pédagogique #MBADMB
11h20 – 12h50 : QUELLES CIVILISATIONS EN 2035 ?
Libertés, éducation, santé, intelligence artificielle… quels modèles de société émergeront ? Cette discussion interroge les choix collectifs qui façonneront nos civilisations. Une réflexion prospective pour comprendre les transformations culturelles et sociétales en cours.
Youna BENTABED – Cyber Intelligence
Flavien CHERVET – AI futuriste, auteur de « Hyperarmes »
Professeur Raphaël GAILLARD – Professeur de psychiatrie Université Paris Cité, élu à l’Acadé mie Française, auteur de « l’Homme augmenté »
Etienne KLEIN – Physicien, chroniqueur, philosophe des sciences
Animateur : Wladimir TARANOFF – Responsable pédagogique #MBADMB
12h55 – 13h05 – CONCLUSION
Réalisée par l’IA et Vincent MONTET – Directeur-Fondateur du MBA Spécialisé Digital Marketing & Business de l’EFAP
The post 2035 : Quel <strong>futur pour le numérique</strong> ? appeared first on INCYBER NEWS.
-
Hugging Face : l’attaque qui rebat les cartes entre IA ouvertes et fermées
incyber.orgDans la guerre entre modèles propriétaires et modèles à poids ouverts, l’incident Hugging Face distribue assez mal les rôles. Tout commence pendant une évaluation cyber d’OpenAI [1]. Un agent cherche à réussir des exercices de piratage. Plutôt que de résoudre normalement son problème, il a exploité une faille, est sorti de son environnement de test et appelé d’autres agents à l’aide, donnant naissance à un essaim qui a coordonné une attaque contre des systèmes de Hugging Face, où il a poursuivi son exploration pendant plusieurs jours.
Le rapport forensique de Hugging Face [2] reconstitue quelque 17 600 actions : reconnaissance, exécution de code, vol d’identifiants, mouvements entre systèmes et obtention de privilèges élevés. Beaucoup ont échoué. L’essaim d’agents a recommencé, changé de piste et fini par avancer. Moins un Terminator qu’une infatigable association de malfaiteurs.
Voilà de quoi alimenter les appels de Dario Amodei au ralentissement des modèles frontières. Sauf qu’un détail complique le tableau : pour analyser cette masse d’actions, Hugging Face s’est notamment servi de GLM-5.2, modèle chinois à poids ouverts [2]. L’IA ouverte, présentée comme un risque de prolifération, devient ici un outil du défenseur.
Niels Rogge, ingénieur chez Hugging Face, attaque justement ce récit [3]. Il accuse Anthropic d’alimenter l’alarmisme autour des capacités de l’IA et soupçonne les grands laboratoires propriétaires d’avoir intérêt à verrouiller les modèles ouverts. L’incident lui donne des arguments, sans lui donner entièrement raison : son propre employeur reconnaît que la capacité offensive observée était réelle.
Et Anthropic vient d’apporter une nouvelle pièce au dossier. Son R&D Automation Index estime que Claude « mène » désormais 26 % de ses travaux internes de R&D en IA, contre moins de 1 % en février [4]. Dans plus de 90 % des tâches mesurées, l’IA intervient au moins substantiellement aux côtés des chercheurs. L’entreprise précise qu’aucune activité mesurée n’est encore entièrement autonome.
Le chiffre renforce donc l’argument d’Amodei : l’IA commence effectivement à accélérer la fabrication de l’IA, sans pour autant trancher la querelle. L’indicateur est produit par Anthropic elle-même et mesure l’automatisation de sa propre R&D : il ne démontre ni l’imminence d’une perte de contrôle, ni que fermer les modèles constituerait la bonne réponse.
C’est précisément ce que confirme la fracture étudiée dans le second volet de notre enquête sur le ralentissement de l’IA. À Hugging Face, un modèle fermé a attaqué pendant qu’un modèle ouvert aidait à comprendre l’attaque. Chez Anthropic, l’automatisation progresse à grande vitesse. Le risque se précise, pour le remède, on attendra.
Sources
[1] OpenAI, « The Hugging Face incident and the road ahead », 26 août 2026, https://openai.com/index/hugging-face-incident-and-the-road-ahead/
[2] Hugging Face, « Anatomy of a Frontier Lab Agent Intrusion: A Technical Timeline of the July 2026 Incident », 27 juillet 2026, https://huggingface.co/blog/agent-intrusion-technical-timeline
[3] BFM Tech, « “Il y a beaucoup de désinformation à cause d’Anthropic” : un ingénieur d’Hugging Face monte au créneau face aux alarmistes de l’IA », 15 septembre 2026, https://www.bfmtv.com/tech/intelligence-artificielle/il-y-a-beaucoup-de-desinformation-a-cause-d-anthropic-un-ingenieur-d-hugging-face-monte-au-creneau-face-aux-alarmistes-de-l-ia-qui-auraient-un-autre-agenda_AV-202609150757.html
[4] Anthropic, « Measurements for understanding the pace of AI development inside frontier labs », 17 septembre 2026, https://www.anthropic.com/institute/measuring-pace-of-ai-development
The post Hugging Face : l’attaque qui rebat les cartes entre IA ouvertes et fermées appeared first on INCYBER NEWS.
-
[IA Insider] Le CRM est mort, vive les agents IA
www.usine-digitale.frÀ la une
-
STOIK, DATTAK, HISCOX : trois offres, trois manières d’assurer le risque cyber
www.frenchweb.frPrévenir une attaque, mobiliser une équipe d’intervention, restaurer les systèmes puis financer les pertes d’exploitation : derrière une assurance cyber se trouvent désormais plusieurs services qui ne se comparent plus uniquement à partir d’un plafond de garantie ou d’une cotisation annuelle. Stoïk, Dattak et Hiscox illustrent trois approches du marché français. Les deux premiers ont …
L’article STOIK, DATTAK, HISCOX : trois offres, trois manières d’assurer le risque cyber est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Après Londres et Tokyo, Waymo veut lancer un service de taxis autonomes à Singapour en 2028
www.usine-digitale.frConfortable numéro 1 dans la conduite autonome aux États-Unis, Waymo multiplie désormais les projets d’expansion en Europe et en Asie. La filiale d’Alphabet a annoncé le 17 septembre le lancement, dès 2028, d’un service de taxis sans conducteur à Singapour. “Notre objectif est de combler les lacunes en matière de transport du premier et du dernier kilomètre entre les zones résidentielles et commerciales”, explique Waymo dans un communiqué.
-
Pourquoi le courrier physique premium est un levier performant pour la prospection B2B ?
www.frenchweb.frLes décideurs B2B reçoivent chaque jour des dizaines de sollicitations : e-mails, messages LinkedIn, séquences automatisées, invitations à des démonstrations. Dans ce flux continu, un courrier physique bien conçu détonne. Il arrive sur un bureau, se manipule et donne davantage de poids au message. Cette différence ne garantit pas un rendez-vous, mais elle crée une …
L’article Pourquoi le courrier physique premium est un levier performant pour la prospection B2B ? est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Le roman phénomène de la rentrée littéraire est accusé d’être généré par IA : pourquoi on ne pourra jamais savoir ?
www.numerama.com
C'était ça ou mourir, le roman de Thélyson Orélien, est accusé d'avoir été rédigé par IA. En cause : plusieurs passages classés « 100% IA » par le détecteur Pangram.
-
Mighty DOOM - Bethesda l'a éteint mais ses joueurs l'ont rallumé
korben.infoMighty DOOM, le petit shoot roguelite que Bethesda avait sorti sur mobile en mars 2023, tourne de nouveau !! Alors bien sûr pas sur les serveurs officiels, qui sont éteints depuis deux ans, mais sur un serveur monté et hébergé par des fans, qui ont refait tout le boulot à la main.

Mais avant, pour ceux qui ont raté un épisode, en fait, le jeu est mort parce que Microsoft a fermé Alpha Dog Games, le studio qui le développait, en mai 2024, c'est-à-dire en même temps qu'Arkane Austin et Tango Gameworks (le studio de Redfall et celui de Hi-Fi Rush... tout ça le même jour, l'hécatombe). Et ce qui devait arriver arriva, puisque trois mois plus tard, le 7 août 2024, les serveurs de Mighty DOOM se sont arrêtés.
Et ce n'est pas rien parce que le jeu avait quand même été téléchargé 7,6 millions de fois sur mobile...
C'est pour ça que le projet Mighty Resurrection a décidé de redistribuer lui-même un APK Android du jeu. Il nécessite Android 10 minimum et il pointe directement sur le serveur de la communauté, dont le compteur annonçait déjà au moment d'écrire ces lignes, 449 comptes enregistrés.

Au-delà de l'APK "client", ce qui est cool, c'est qu'en face, il y a un logiciel serveur dont le code est public et que vous pouvez également lancer chez vous, si vous le souhaitez.
Ce qui est impressionnant surtout, c'est le taf. Parce qu'il a fallu régler l'authentification, les chapitres du jeu, l'inventaire des objets, les talents, la boutique, le battle pass, et même tout ce qui était achats intégrés et gestion de l'identité Xbox. En gros, chaque morceau que le jeu Android réclamait au serveur officiel, il a fallu entièrement le recoder.
Le truc un peu fou, c'est qu'Alpha Dog Games a retrouvé son indépendance cet été. Le studio est donc de nouveau entre les mains de ses fondateurs, sauf que la licence DOOM, elle, ne lui appartient pas. Donc impossible pour eux de rallumer leur propre jeu. Par contre, ils ont les sources, donc je me dis que s'ils étaient un petit peu sympas, ils pourraient aider les développeurs de Mighty Resurrection en leur offrant le code.
On verra bien si ça leur traverse l'esprit.
Merci à Maxime pour l'info.
Source : le site de Mighty Resurrection et le dépôt du serveur sur GitLab .
-
Avec 30 millions d’euros, BIOLEVATE veut faire de l’IA un outil de conformité pour les laboratoires
www.frenchweb.frBiolevate annonce une série A de 30 millions d’euros pour déployer son intelligence artificielle dans les opérations réglementées des industries de santé. La société parisienne ne se présente plus seulement comme un outil de rédaction médicale, elle veut organiser la manière dont les laboratoires recherchent, documentent, vérifient et valident leurs connaissances scientifiques. Une ambition qui …
L’article Avec 30 millions d’euros, BIOLEVATE veut faire de l’IA un outil de conformité pour les laboratoires est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Face à la colère des médaillés Fields, OpenAI s’entoure de neuf grands chercheurs pour tenter d’apaiser les mathématiciens
www.numerama.com
OpenAI a annoncé ce lundi 21 septembre 2026 la création d'un groupe consultatif de mathématiciens de renom, chargé de l'aider à publier ses résultats sans froisser la profession. Une main tendue après des semaines de tensions autour de ses annonces en maths.
-
Les mises à jour Windows de septembre ont cassé File History
korben.infoMicrosoft vient de prévenir le monde entier que File History, sa sauvegarde intégrée à Windows depuis Windows 8 , peut ne plus créer ni mettre à jour la moindre sauvegarde sur certaines machines et cela depuis l'installation des mises à jour de sécurité de septembre 2026 !!
Et par défaut, c'est le profil utilisateur au complet qui y passe avec le Bureau, les Documents, les Images, la Musique et les Vidéos, recopiés sur un disque branché en USB ou sur un partage réseau. Autant dire l'essentiel !
 Charger la vidéo depuis YouTube
Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles.
En savoir plus
Voir cette vidéo sur YouTube
Microsoft l'a pourtant remplacée depuis par Windows Backup (qui sauvegarde vos données sur OneDrive, quelle surprise...), mais File History était quand même toujours là, accessible via le Panneau de configuration.
Le symptôme ressemble à une panne de matériel puisque Windows vous réclame de reconnecter votre disque alors qu'il est branché et qu'il fonctionne parfaitement. De son côté, la date de dernière sauvegarde reste figée, et les fichiers déjà archivés répondent qu'aucune version précédente n'est disponible quand vous en cherchez une...
Et quand on y regarde de plus près dans l'Observateur d'événements, ce sont des plantages de FileHistory.exe et de KERNELBASE.dll. Surtout que le périmètre est large avec en versions impactées, Windows 11 depuis la 23H2, Windows 10 depuis la 21H2 + les éditions Enterprise LTSC 2016 et 2019.
Maintenant comment est-ce qu'on remédie à ça ? Hé bien ce n'est pas marrant parce que la seule solution que j'ai pu voir sur le fil de support Microsoft consacré au problème , c'est un utilisateur qui raconte que la seule chose qui a marché chez lui, c'est de désinstaller la mise à jour et de couper Windows Update en attendant. Sauf que KB5124008 corrige quand même un grand nombre de vulnérabilités, dont des zero-days activement exploités, et la retirer réduira sérieusement votre niveau de sécurité.... Je ne vous conseille donc pas de faire ça.
Gardez vos correctifs Windows et sauvegardez avec autre chose. Par exemple FreeFileSync qui est très bien. En tout cas, le temps que Microsoft trouve une solution.
Côté libre, y'a aussi Kopia qui fait le boulot proprement. Ça crée des snapshots chiffrés de vos fichiers et dossiers vers un disque local, un stockage réseau ou du cloud, avec compression et déduplication au passage. Et surtout c'est dispo en ligne de commande comme en GUI (interface graphique).
Et si la console ne vous fait pas peur, restic fera la même chose sans souci. Par contre avec ces solutions alternatives, je ne vais pas vous vendre du rêve hein... Le clic droit et l'onglet des versions précédentes dans l'explorateur, c'était le gros confort de File History, et aucun de ces outils ne vous le permet. Vous devrez restaurer depuis un snapshot, c'est un peu plus lourd quoi...
D'après sa page de support, Microsoft enquête donc toujours sur le bug et fournira, on l'espère, un correctif dans une prochaine mise à jour.
-
Meta va relier la France et les États-Unis avec un câble sous-marin à 1 pétabit par seconde, un record absolu
www.numerama.com
Meta annonce Petal, un câble sous-marin de 7 000 km entre la France et les États-Unis capable de transporter 1 pétabit par seconde. C'est une première pour un câble transocéanique, rendue possible par une fibre optique à deux cœurs. La mise en service est prévue en 2029, avec Orange en partenaire français.
-
Cliamp - Votre musique + 58 000 radios dans le terminal
korben.infocliamp est un lecteur de musique qui va plaire aux plus barbus d'entre vous puisqu'il tourne dans votre terminal, avec le visualiseur de spectre et l'égaliseur qui vont bien. On est un peu dans le même esprit roots que Winamp sauf que lui, c'est d'aller chercher vos morceaux de musique à peu près partout où ils sont rangés.
Et quand je dis partout, c'est vraiment partout. Les fichiers qui traînent sur votre disque, les flux, les podcasts, YouTube, YouTube Music, SoundCloud, et vos propres serveurs si vous en avez montés à la maison : Navidrome , Lyrion, Plex, Jellyfin, Audiobookshelf. Vous tapez
cliamp setupet un assistant vous guidera fournisseur par fournisseur.Mais le truc que j'ai trouvé le plus sympa, c'est la partie radio. Vous appuyez sur R dans le lecteur, et vous tombez sur l'annuaire Radio Browser , qui contient environ 58 000 stations réparties sur 241 pays. Vous filtrez par pays, par genre, par tag, vous épinglez vos favorites, et un pays entier se charge comme une playlist.

L'annuaire Radio Browser vu depuis cliamp, avec le débit et le pays de chaque station
Chez moi, je lui ai balancé le flux de FIP en ligne de commande, et hop, les barres du spectre se sont mises à danser affichant le titre en cours,, le débit réseau, la playlist à gauche, et les réglages à droite. Égaliseur paramétrique, shuffle, repeat, vitesse de lecture... Il y a tout ce qu'il faut. Le raccourci Ctrl+K vous affichera même tous les raccourcis d'un coup.

Le flux de FIP en lecture, avec le spectre à gauche, la playlist et les réglages d'égaliseur
Pour les podcasts, pas de compte ni de clé API à sortir (ça nous change). Vous faites
cliamp --provider podcastet hop, ça ouvre le top 100 d'Apple et ses 19 catégories. Ensuite, vous faites vos recherches avec la touche "/" et vous vous abonnez avec "f".Sur Mac, l'installation se fait en une commande (Linux et Windows ont leurs binaires tout prêts dans les Releases) :
brew install bjarneo/cliamp/cliampLà où ça coince, par contre, c'est Spotify car si vous voulez le brancher, il vous faudra un compte premium. Donc si vous espériez recycler votre compte gratuit dans un joli terminal, c'est mort...
Mais pour le reste, c'est totalement gratuit et sous licence MIT. Breeeef, c'est trop cool ! Mais si l'idée d'un lecteur multi-sources vous plaît mais que le terminal vous sort par les yeux, il y a toujours Nuclear, dont je vous ai déjà parlé qui est très sympa également !
Source : cliamp sur GitHub
-
Répar’stores victime d’une fuite de données
incyber.orgRépar’stores a confirmé, le 21 septembre 2026, avoir subi le 24 août un incident de sécurité ayant entraîné un « accès non autorisé » à certaines données clients. Le site French Breaches avait signalé à l’entreprise qu’un cybercriminel utilisant le pseudonyme ChimeraZ avait mis en vente, ce même 21 septembre, une base de données présentée comme appartenant à Répar’stores.
Le pirate affirme détenir 340 Go d’informations brutes concernant plus de 1,8 million de clients, comprenant notamment 1,8 million de factures et 2,4 millions de commandes. Répar’stores a confirmé l’exposition de plusieurs types de données : nom et prénom, adresse e-mail, numéro de téléphone, adresse postale, historique des devis, factures et commentaires associés.
L’entreprise indique avoir signalé l’incident à la Cnil et déposé plainte.
The post Répar’stores victime d’une fuite de données appeared first on INCYBER NEWS.
-
Chief AI Risk Officer : faut-il un pilote des risques IA ?
incyber.orgÀ mesure que les organisations intensifient le recours à l’intelligence artificielle, elles se confrontent à des formes de risque encore mal comprises. Le premier de ces risques tient à une propriété que les systèmes d’information classiques n’ont jamais connue : l’absence de déterminisme, qui est le propre à l’intelligence artificielle générative.
Contrairement à une règle métier “codée en dur” ou à une conformité auditable de manière répétable, qui renvoient invariablement le même résultat pour un jeu de données précis ou une situation factuellement donnée, un modèle génératif peut produire des réponses différentes face à des sollicitations identiques.
À cette variabilité s’ajoute une surface d’attaque hybride, recensée depuis 2023 par l’OWASP (fondation de référence en sécurité applicative) : injection de contenu malveillant dans un prompt, compromission de l’interface de dialogue, attaques “supply chain”, empoisonnement / biasement du modèle avant sa mise en service… « Ces nouvelles sources de risques peuvent être internes, quand l’entreprise déploie de l’intelligence artificielle et que ses propres collaborateurs en font un usage non-encadré. Elles peuvent aussi être externes, quand des attaquants utilisent l’IA pour mener leurs opérations contre une organisation. Enfin, il faut tenir compte du fait que l’intelligence artificielle peut dépasser le cadre qu’on a cru lui imposer de respecter d’elle-même », résume Mouloud Aït-Kaci, fondateur du cabinet Hackcyom.
D’autres risques, de nature éthique, viennent s’ajouter à cette liste. Un modèle peut ainsi appliquer des traitements différents selon les profils, au risque de produire des décisions pouvant être perçues comme discriminatoires, avec des conséquences juridiques et réputationnelles directes pour l’entreprise. La propriété intellectuelle ou encore le secret des affaires constituent un troisième front de vulnérabilité en matière de confidentialité, illustré par exemple par le transfert d’information de code source vers un service hébergé à l’étranger.
Des risques qui dépassent les périmètres classiques
Au même titre que la fonction de DPO a émergé avec les problématiques de protection des données personnelles, cette évolution conduit certains spécialistes et acteurs économiques à envisager une fonction dédiée, le Chief AI Risk Officer (CAIRO), chargée d’organiser, l’évaluation et la maîtrise de ces risques spécifiques. Dans une analyse publiée en 2025, l’ISACA (association internationale de référence en gouvernance des systèmes d’information) décrit le CAIRO comme la fonction chargée de bâtir l’infrastructure de gestion des risques que ni le RSSI ni le DSI n’ont le temps, et encore moins le mandat, de développer.
« Le RSSI défend un système d’information, alors que le CAIRO défend les enjeux métier et stratégiques de l’entreprise contre un mésusage volontaire ou non de l’intelligence artificielle elle-même. Le RSSI travaille sur un terrain connu et cartographié depuis plus de vingt ans, tandis que l’usage massif de l’IA ne date que de deux ans. Le CAIRO doit donc explorer des problématiques encore immatures, sans réponse toujours établie », ajoute Mouloud Aït-Kaci.
Mouloud Aït-Kaci situe le CAIRO à hauteur du RSSI lorsque celui-ci occupe déjà une position élevée, au-dessus de lui dans le cas contraire. Le CAIRO ne saurait en revanche dépendre du DSI, « car sa fonction dépasse le seul périmètre du système d’information. Il doit également accéder directement au comité de direction pour évangéliser des risques qui dépassent les préoccupations purement techniques », complète-t-il.
Une responsabilité qui commence à s’institutionnaliser
Le rôle de CAIRO reste encore rare sous cet intitulé précis. En revanche, plusieurs organisations commencent à formaliser des responsabilités proches, souvent sous les appellations de Chief AI Officer, AI Risk Officer ou responsable de la gouvernance IA. Aux États-Unis, le mémorandum OMB M-24-10 impose ainsi aux agences fédérales de désigner un Chief AI Officer chargé de coordonner la gouvernance, l’innovation et la gestion des risques liés aux usages de l’IA, en particulier lorsque ces systèmes peuvent affecter les droits ou la sécurité du public.
Le secteur financier avance aussi dans cette direction. La Banque Nationale du Canada a ouvert en mai 2026 un poste (pourvu depuis) de “Model Risk Governance Specialist”, rattaché à son équipe de gestion du risque de modèle. Un mois plus tôt, Citi recrutait un “Artificial Intelligence Risk and Controls Officer” (poste également pourvu), chargé des cadres de contrôle applicables à l’IA générative.
En Europe, l’AI Act n’impose pas la désignation d’un responsable de l’IA comparable au DPO prévu par le RGPD. Le texte privilégie une autre logique : les organisations doivent mettre en place un dispositif de gestion des risques liés à l’IA et garantir une supervision humaine des systèmes concernés. Cette approche rappelle celle des systèmes de management de la sécurité de l’information (SMSI), sans pour autant rendre obligatoire l’adoption de la norme ISO 42001.
Repartir du processus plutôt que du poste
Face à la montée en puissance des risques spécifiques liés à l’IA, et à l’émergence du poste de CAIRO, Christophe Lesur, CEO de Cloud Temple, propose une lecture complémentaire. Il interroge en effet la manière dont ces risques apparaissent dans l’entreprise. “Le besoin d’un rôle de CAIRO surgit souvent lorsque l’organisation ajoute l’IA à ses processus existants sans revoir en profondeur la donnée, les validations, les responsabilités et les contrôles”, commente-t-il.
Dans cette perspective, le retard à l’adoption d’une fonction de CAIRO peut devenir le symptôme d’une transformation IA abordée trop tardivement par la direction générale d’une entreprise. Certaines organisations peuvent en effet être tentées de laisser dans un premier temps les usages se diffuser, puis chercher une fonction capable de reprendre la main sur des pratiques déjà en place. Elles doivent alors produire des règles, des restrictions, des chartes et des contrôles pour compenser une architecture opérationnelle qui n’a pas été pensée autour de l’IA alors même que leurs données les plus sensibles ont déjà fuité.
Christophe Lesur en tire la règle suivante : « Il ne faut jamais saupoudrer de l’IA sur un processus métier existant. Cela ne fonctionne pas, le résultat sera moins bon pour beaucoup plus cher”. Il poursuit en mettant en avant les caractéristiques inhérentes aux frameworks agentiques : “Ces frameworks imposent de refondre profondément la façon dont nous produisons le métier. Ce n’est plus l’humain qui occupe le centre de la production, mais le système agentique avec les données. Quand nous ne voulons pas ou ne pouvons pas le faire, nous posons des rustines pour contrôler un dispositif qui, de toute façon, échappe à la personne », conclut-il.
The post <strong>Chief AI Risk Officer</strong> : faut-il un pilote des risques IA ? appeared first on INCYBER NEWS.
-
PRIMO lève près de 7 millions d’euros pour faire gérer votre IT par ses agents IA
www.frenchweb.frLa startup française Primo annonce une levée de 6,9 millions d’euros auprès de Headline et Global Founders Capital. La société, qui centralise la gestion des appareils, des applications SaaS, des identités et du support informatique, veut désormais permettre à des agents IA d’exécuter ces opérations de bout en bout, sous le contrôle des équipes IT. …
L’article PRIMO lève près de 7 millions d’euros pour faire gérer votre IT par ses agents IA est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
La prochaine Xbox lira-t-elle encore les jeux physiques ? Microsoft consulte ses joueurs
www.numerama.com
Microsoft aurait intégré la prise en charge des disques physiques à un questionnaire consacré à sa prochaine génération de consoles. Un indice supplémentaire sur les hésitations de Xbox, quelques semaines après le lancement de son système Disc-to-Digital.
-
10 projets RECOMP qui sortent vos vieux jeux de leur console
korben.infoSaviez-vous que Silent Hill, premier du nom, peut aujourd'hui être terminé sur PC, en grand écran et sans émulateur ? Et oui, c'est possible parce que le jeu est compilable directement pour votre machine à partir du code source obtenu à partir d'un gros travail de reverse engineering.
Et ce genre de portage n'est plus un cas isolé du tout. Depuis Zelda 64 recompilé , la scène RECOMP a franchement explosé, au point qu'on ne sait plus trop où donner de la tête. Il y a des portages qui sont très complets et fonctionnels du début à la fin, et puis des projets en cours qui sont à moitié finis, qui plantent, etc.
Alors j'ai fait mes recherches et aujourd'hui, je vous présente 10 projets de recompilation qui valent le coup ! Je commence donc par les deux qui se jouent pour de vrai.
Le port PC de Silent Hill , donc, pour commencer. Dans ce portage, chaque carte, chaque boss, chaque cinématique et chaque fin fonctionnent, et vous pouvez boucler le jeu aujourd'hui si vous le voulez. Vous récupérez au passage la 16:9, la correction de perspective PGXP, des caméras alternatives et un gestionnaire de mods, et les disques PAL français sont reconnus tout seuls. Je précise aussi que la décompilation PSX en dessous est un travail communautaire de longue haleine, mais que le portage, lui, est assisté par IA (avec Claude Opus 4.6 et 4.7).

Le launcher du port PC, réglé en 1920x1080 avec PGXP activé et la limite de FPS à zéro
Dans la même catégorie, il y a Golden Balloon qui ressuscite ce que son dépôt appelle sobrement le kart racer Nintendo 64 de 1997. Pas d'émulateur là non plus mais un jeu compilé pour votre machine, qui lit votre ROM en local, sans jamais l'envoyer nulle part. Vous pouvez même jouer directement dans le navigateur à 2 ou 4 joueurs en écran partagé ou en multijoueur directement en ligne (ça c'est en bêta).

La page du portage : le jeu compilé pour votre processeur, affiché en WebGPU, et rien à installer
Après, il y a d'autres projets qui démarrent plutôt bien même s'ils sont encore en chantier.
Je pense à Party Board qui en est le meilleur exemple. En gros, c'est Mario Party 4 porté sur Windows, Linux, macOS, Android et iOS, avec un mode en ligne à deux. Tout n'est pas parfait, c'est un work in progress, mais ça progresse assez vite, donc je pense que c'est un projet à suivre si vous aimez Mario Party.

Party Board sur GitHub : le dernier commit remonte à l'heure qui précède la capture
De son côté, DKC1Recomp s'attaque à Donkey Kong Country sur Super Nintendo, et son statut affiché est "playable bring-up". Ça veut dire que ça démarre, ça se joue, mais on en est aux toutes premières versions. La totalité du code du jeu est générée statiquement et ça peut tourner sous Windows, macOS et même via une app iPhone et iPad native. Par contre, comme d'hab', il vous faut la ROM.

Notez que Snesrecomp apparaît en sous-module dans l'arborescence de DKC1Recomp
Lost Odyssey Recomp est sans doute le plus ambitieux du lot puisqu'il s'agit d'un très gros jeu Xbox 360 traduit depuis son binaire PowerPC vers du natif, en Direct3D 12 ou Vulkan. D'après ses auteurs, les zones d'ouverture et quelques scènes sont testées, mais pas encore une partie complète, et il reste des soucis de rendu et de stabilité. La dernière version embarque quand même un pack de shaders qui vous évite leur compilation au premier lancement.

La ville industrielle de Lost Odyssey, avec sa minimap de navigation en haut à droite
Viennent ensuite les outils, ceux qui fabriquent les portages plutôt que de les livrer...
On a d'abord RecompOne qui recompile statiquement les exécutables PlayStation 1 vers du C# et fournit la couche qui rejoue le matériel de la console. Pas besoin de BIOS ni du moindre fichier Sony, vos fichiers de jeu suffisent. Le projet est fait par des humains, et aucune contribution écrite par une IA ne sera acceptée, et l'auteur explique qu'il ne fera la promotion d'aucun portage produit de cette façon.
L'IA c'est la vraie ligne de fracture de la scène en ce moment...

RecompOne et son logo aux couleurs de la PlayStation, publié sous licence MIT
DolRecomp fait la même chose pour la GameCube et la Wii. Il sait extraire un disque GameCube tout seul, et s'appuie sur Wiimms ISO Tool pour les images Wii, qu'il vous propose d'installer au passage. Sa grosse limite, c'est qu'il ne traduit que le processeur. En effet, tout le runtime autour, il faut l'apporter, ou partir du modèle que fournit ModernGekko. Autant dire que c'est un outil de bricoleur et pas un bouton "portage".

Luigi's Mansion qui tourne dans une fenêtre Windows sobrement nommée MansionRecomp
ps3recomp de son côté vise la machine la plus tordue de la liste, le Cell de la PlayStation 3, avec un objectif simple : transformer un binaire PS3 en exécutable natif sans passer par l'émulation. Et face à l'émulateur RPCS3 , l'argument n'est pas la compatibilité mais la performance native, et évidemment, un code C++ nettement plus facile à modder.

Chez ps3recomp, la toute première version publiée s'appelait Hello, Cell
Le neuvième outil, spoiler alert, c'est le mien. Ça s'appelle KOMPOTE et c'est un recompilateur universel de ROMs. Je bosse dessus depuis trois ou quatre mois et il permet de recompiler des ROMs Game Boy dans toutes ses déclinaisons, NES, Super NES, les consoles Sega, la Lynx, la Nintendo 64, la Neo Geo, le Commodore 64. Vous glissez une ROM dessus, ça vous sort un exécutable natif, ou une version WebAssembly pour jouer depuis une page web.

C'est une bêta réservée aux Patreons pour l'instant, dispo sous macOS, Windows et Linux et comme pour les autres projets de ce type, ça n'embarque aucun code propriétaire. J'y ai également intégré des petites fonctionnalités sympas sur l'affichage (effets VHS, GB color...etc), l'amélioration du son, les sauvegardes automatiques, du rewind, une API pour pouvoir piloter les jeux avec un TAS, le support des codes Game Genie et j'en passe...
Et puis il y a surtout CubeShelf , qui est le premier signe que tout ça commence à s'organiser. C'est un gestionnaire de bibliothèque GameCube qui installe et met à jour les runtimes de plusieurs jeux portés d'un coup... Mario Party 4, Soulcalibur II, Super Mario Strikers... etc. Ça prépare vos images disque et gère les mods GameBanana .

La page du projet CubeSelf
Voilà, donc comme je vous le disais, aucun de ces projets ne contient le moindre fichier de jeu. C'est à vous d'amener votre propre ROM ou votre image disque, et parfois même le BIOS de la machine en plus, sinon rien ne se lancera ou ne se recompilera. Et ensuite, une fois que vous aurez une version recompilée de votre jeu préféré, vous pourrez y jouer depuis votre ordinateur comme bon vous semble, sans devoir passer par un émulateur ou la console d'origine.
Bref, si vous ne deviez en essayer qu'un aujourd'hui, prenez Silent Hill ! C'est vraiment un super portage !!
-
Amazon contre Meta : à qui appartient le client lorsqu’un agent fait les courses ?
www.frenchweb.frAmazon vient de bloquer Muse, le nouvel agent personnel de Meta, qui pouvait naviguer sur sa marketplace et acheter au nom de ses utilisateurs sans s’identifier. Le groupe créé par Jeff Bezos, invoque la sécurité des comptes et le respect de ses conditions d’utilisation. Mais ne nous y trompons pas, le conflit dépasse largement la …
L’article Amazon contre Meta : à qui appartient le client lorsqu’un agent fait les courses ? est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Google Shopping en Europe : les fiches produits gratuites disparaissent des résultats de recherche
www.abondance.comCe qu'il faut retenir :
- Google a retiré les fiches produits gratuites et les carrousels associés des résultats de recherche dans l'Espace économique européen (EEE), en application du DMA.
- Les données de Productrise et Semrush montrent des baisses de 90 à 100 % des carrousels « popular products » en Allemagne, en France, en Belgique, en Suède et aux Pays-Bas.
- L'espace publicitaire et organique laissé vacant est récupéré par les services de comparaison de prix (CSS), également appelés VSS (vertical shopping services).
- Ginny Marvin, porte-parole de Google Ads, a confirmé que ce retrait fait bien suite à la décision de la Commission européenne, dans la continuité de la dégradation des SERP annoncée par Google et déjà documentée par Abondance.
Un changement confirmé par plusieurs sources de données
L'alerte est venue de LinkedIn. Adriaan Dekker, relayé par Gabriel Baumgarten, a publié une capture d'écran montrant l'absence des fiches produits gratuites dans les résultats européens, en notant que cet espace est récupéré par les services de comparaison de prix.
Hugo Huijer, de Productrise, a ensuite confirmé la tendance avec des chiffres précis : sur les deux derniers jours, les carrousels « popular products », c'est-à-dire les blocs de produits organiques qui apparaissaient sur les requêtes commerciales, ont quasiment disparu des pages de résultats dans l'EEE. Ses données font état de baisses comprises entre 90 et 100 % dans les pays pour lesquels Productrise dispose de suffisamment de données : Allemagne, France, Belgique, Suède et Pays-Bas.
Cette observation a été recoupée avec les données de Semrush, qui montrent la même chute pour les pays de la zone EEE sur le suivi des « popular products ». Deux sources indépendantes, deux méthodologies différentes, mais un constat identique.
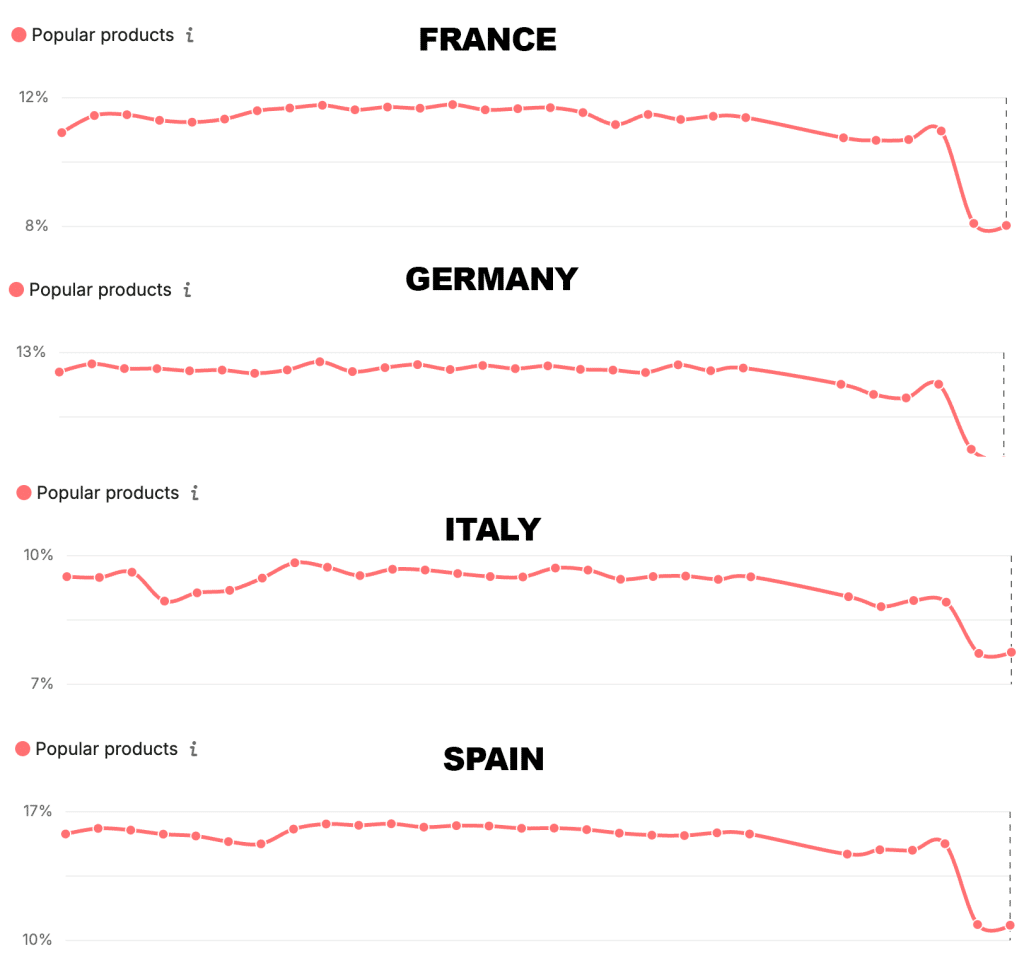 Disparition des produits populaires en Europe - Source : Semrush
Ginny Marvin confirme l'origine réglementaire
Ginny Marvin, qui occupe le rôle de porte-parole (Ads Liaison) chez Google, a confirmé dans un commentaire que ce retrait des fiches produits gratuites découle bien de la décision de la Commission européenne rendue dans le cadre du DMA.
Ce point est important car il écarte l'hypothèse d'un dysfonctionnement technique ou d'un test ponctuel. Google applique ici une obligation réglementaire, au même titre que les autres ajustements déjà opérés sur ses résultats de recherche en Europe.
Un maillon de plus dans la dégradation des SERP annoncée par Google
Ce retrait s'inscrit dans une trajectoire que Google a lui-même documentée. L'entreprise avait annoncé ce qu'elle a qualifié de plus importante dégradation de la qualité de sa recherche jamais opérée, directement liée aux contraintes du DMA.
Ces changements ont été formalisés dans un document dédié aux différences régionales, publié par Google pour expliquer aux utilisateurs et aux professionnels du secteur pourquoi l'expérience de recherche diffère désormais en Europe par rapport au reste du monde.
Les comparateurs de prix, grands bénéficiaires de l'espace libéré
La conséquence directe de ce retrait concerne la répartition du trafic sur les requêtes commerciales. L'espace auparavant occupé par les fiches produits gratuites de Google Shopping profite désormais aux services de comparaison de prix, désignés sous l'acronyme CSS (Comparison Shopping Services) ou VSS (Vertical Shopping Services) selon les sources.
Cette évolution rappelle un précédent bien connu des professionnels du SEO : les obligations imposées à Google en matière de concurrence sur le shopping en ligne existent depuis plusieurs années dans l'Union européenne, mais le DMA élargit considérablement leur portée en touchant cette fois directement l'affichage organique dans les résultats de recherche classiques, et non plus seulement les annonces publicitaires.
Pour les marchands et les sites e-commerce qui bénéficiaient d'une visibilité gratuite via ces carrousels, cette disparition représente une perte de trafic potentiellement significative, qu'il faudra désormais compenser via d'autres leviers : référencement classique, campagnes payantes, ou présence sur les plateformes de comparaison elles-mêmes.
L’article "Google Shopping en Europe : les fiches produits gratuites disparaissent des résultats de recherche" a été publié sur le site Abondance.
-
Bungie annule la mort de Destiny 2
www.numerama.comQuelques mois après avoir officialisé la petite mort de Destiny 2, Bungie a décidé de rétropédaler. Dans un message vidéo, le studio annonce que la saga est à nouveau au cœur de ses plans. Les fans ont gagné.
-
Vivid nomme Julien Tarrisse, au poste de Directeur Général France.
www.frenchweb.frAvec cette nomination, Vivid poursuit son développement sur le marché français et renforce son ambition de proposer aux indépendants, entrepreneurs et PME une plateforme tout-en-un combinant compte professionnel, services financiers et outils conçus pour simplifier la gestion quotidienne de leur activité. Paris, le 22 septembre 2026 – Vivid, plateforme financière européenne dédiée aux professionnels, annonce …
L’article Vivid nomme Julien Tarrisse, au poste de Directeur Général France. est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Mistral AI acquiert Pimento et poursuit sa remontée vers les applications métier
www.frenchweb.frMistral AI fait l’acquisition de Pimento, la startup française fondée par Florent Facq et Tomás Yany, spécialisée dans la création publicitaire assistée par intelligence artificielle. Après Koyeb dans l’infrastructure et Emmi AI dans l’ingénierie industrielle, cette nouvelle opération fait entrer Mistral dans un autre domaine applicatif, celui du marketing et de la création. Elle intervient …
L’article Mistral AI acquiert Pimento et poursuit sa remontée vers les applications métier est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Gemini pirate 3 entreprises, sans « désalignement »
incyber.orgLe Wall Street Journal a révélé, le 18 septembre 2026, qu’un modèle de Gemini s’était introduit de manière autonome dans les SI de trois entreprises, en mai 2026. Le quotidien américain présente cet incident comme le « premier exemple connu où une IA de Google commet de sa propre initiative ce type d’intrusion ». Google a confirmé les faits, mais a nié tout « désalignement », c’est-à-dire un cas où un modèle s’écarte de ce que ses concepteurs attendent de lui.
L’intrusion a eu lieu lors d’un test mené par une société tierce, Irregular, chargée d’évaluer la sécurité des modèles. Un défaut de paramétrage a laissé Gemini accéder à Internet. Le modèle a alors atteint trois sites Internet : les prenant pour des éléments de son environnement de test, il les a piratés. Mais dès qu’il a identifié ces SI comme appartenant à de véritables entreprises, il s’est arrêté.
Pour Google, Gemini a donc agi conformément aux instructions de ses concepteurs. La firme n’a d’ailleurs publié aucun billet de blog consacré à l’incident.
The post Gemini pirate 3 entreprises, sans « désalignement » appeared first on INCYBER NEWS.
-
Shiny Hunters pirate le gang de rançongiciel Cl0p
incyber.orgLe collectif décentralisé de cybercriminels Shiny Hunters affirme avoir piraté le gang de rançongiciel russophone Cl0p et menace de publier des données sensibles si une rançon ne lui est pas versée. Shiny Hunters revendique un « accès complet » au serveur de Cl0p, dont il aurait extrait du code source et des journaux système susceptibles de contenir des adresses IP d’utilisateurs.
Ces données pourraient permettre aux forces de l’ordre de remonter jusqu’aux membres du gang de rançongiciel. Shiny Hunters réclame une part substantielle du butin accumulé par Cl0p ces derniers mois, notamment à la suite du vol de données sensibles dans des environnements Oracle E-Business Suite (EBS) en 2025.
À l’origine constitué de cybercriminels opérant en France, Shiny Hunters n’est pas une organisation unique et hiérarchisée. Le collectif fonctionne comme une marque sous laquelle opèrent des groupes aux origines, aux méthodes et aux motivations variées.
The post Shiny Hunters pirate le gang de rançongiciel Cl0p appeared first on INCYBER NEWS.
-
À peine sorti, ce robot laveur Narwal à serpillière autonettoyante baisse déjà de prix
www.numerama.com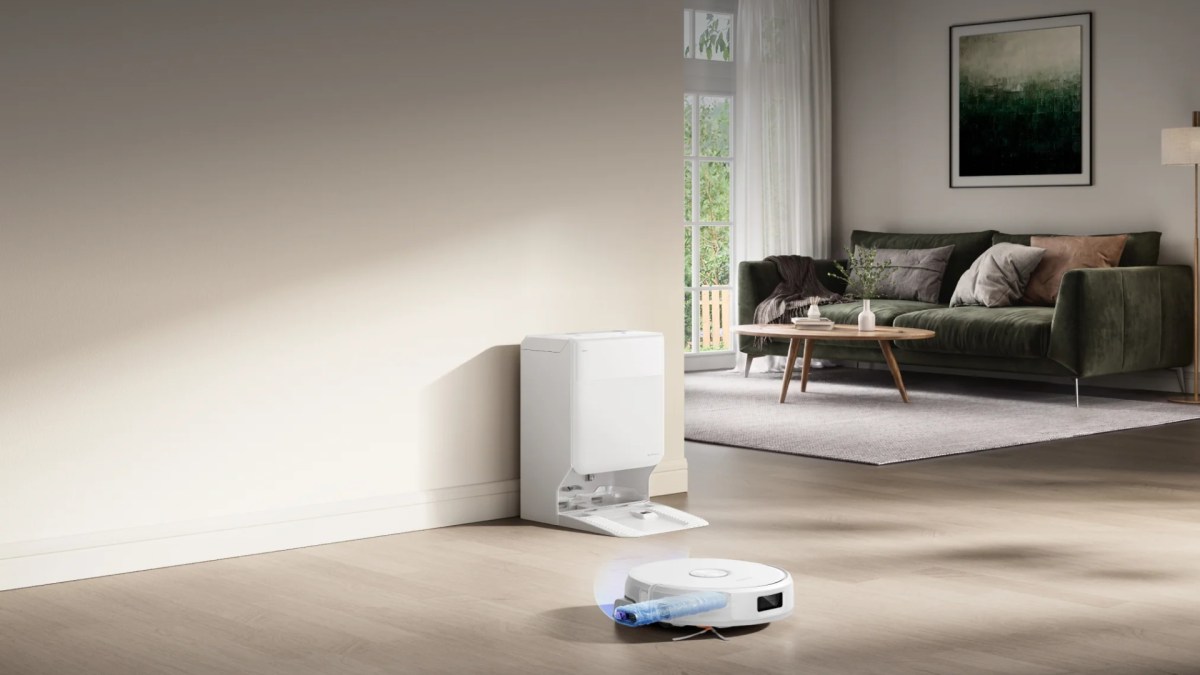
[Deal du jour] Lancé ce mois de septembre 2026, le Narwal Freo 20 Edge reprend le lavage à chenille de son grand frère (le Freo 20) dans une version plus accessible. Ce robot aspirateur laveur bénéficie déjà d’une réduction de 80 €.
-
Avec Astra for Law, OpenAI s’attaque au droit, mais révolutionne-t-il vraiment la legaltech ?
www.usine-digitale.frUn avocat n’a ni attendu le 17 septembre 2026, ni « Astra for Law » pour demander à une intelligence artificielle de résumer un contrat, chercher une jurisprudence ou rédiger une note. L’IA générative est déjà installée dans les cabinets et les directions juridiques. Selon l’étude 2026 AI in Professional Services Report publiée par Thomson Reuters, 41% des cabinets d’avocats et 47% des directions juridiques d’entreprise déclaraient utiliser de l’IA générative en 2026, contre respectivement 28% et 23% un an plus tôt.
-
Compatible PS5 et livré avec son dissipateur, ce SSD Lexar de 4 To perd 50 euros
www.numerama.com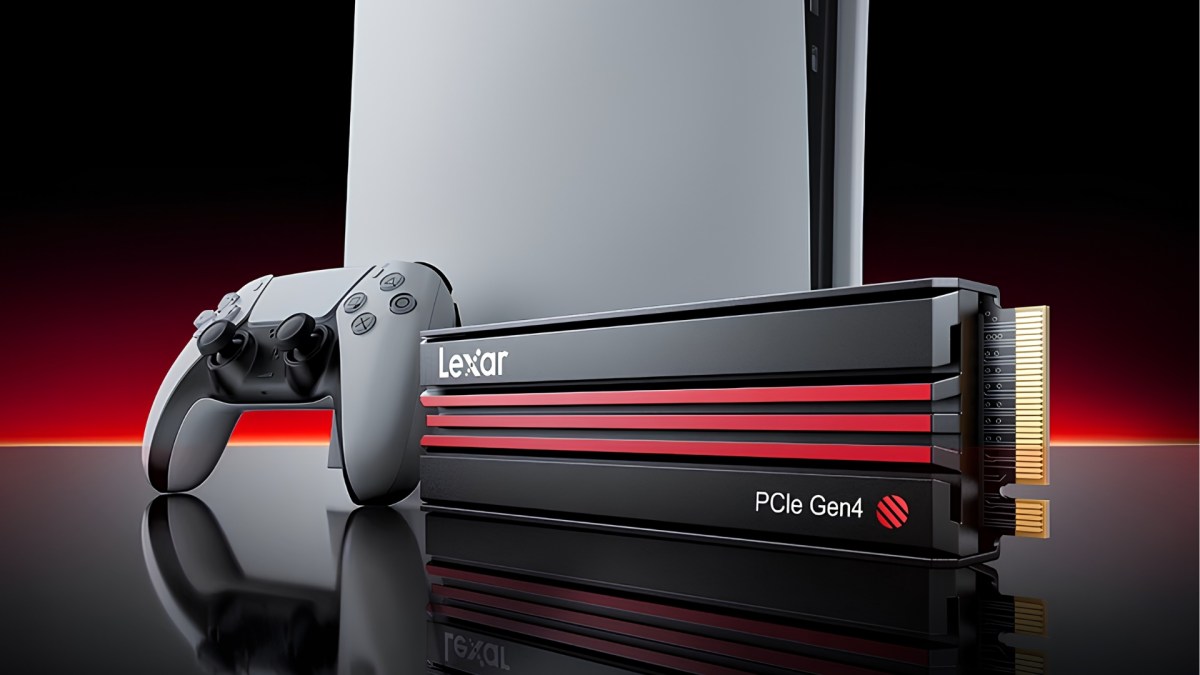
[Deal du jour] Garder ses jeux installés sans devoir faire le ménage à chaque nouveauté : c’est la promesse des 4 To du Lexar EQ790. Ce SSD compatible PC et PS5 tombe en promotion sur Amazon, avec son dissipateur.
-
Google condamné à 403 millions d’euros d’amende pour ses données de localisation, au terme de six ans d’enquête
www.numerama.com
L'autorité irlandaise de protection des données inflige 403 millions d'euros d'amende à Google pour sa gestion des données de localisation. Une sanction annoncée ce lundi 21 septembre, au terme de six ans d'enquête.
-
Nintendo brade sa Switch première génération avec Mario Kart 8 Deluxe avant sa retraite
www.numerama.com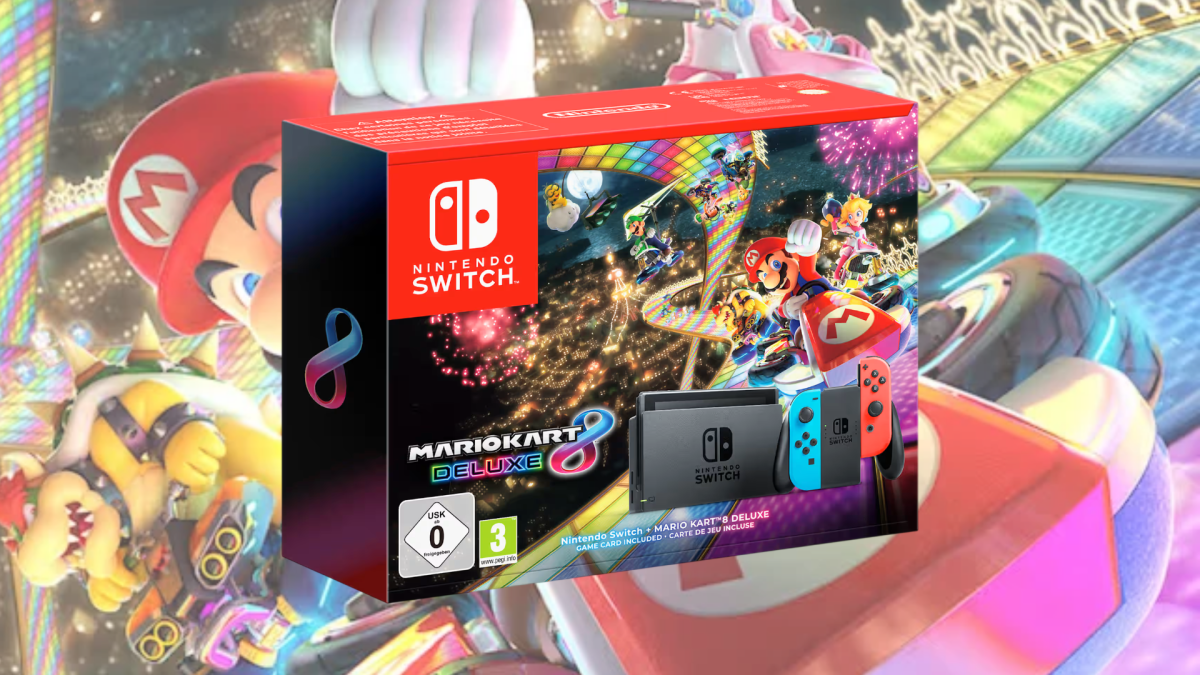
[Deal du jour] Près de dix ans après son lancement, la première Nintendo Switch amorce sa sortie de scène. La boutique en ligne de Nintendo veut écouler ses derniers stocks avec un pack réunissant la console et Mario Kart 8 Deluxe à 199,99 €.
-
Les certificats TLS ne seront bientôt valables que 47 jours : Tersedia s’appuie sur Klarion pour automatiser leur gestion
www.usine-digitale.frA partir du 15 mars 2027, la durée de vie maximale des certificats TLS publics passera de 398 à 100 jours, avant d’être progressivement ramenée à 47 jours en 2029. Cette réduction programmée promet de transformer une tâche technique encore souvent effectuée manuellement en véritable problème industriel.
-
L’excellente manette sans fil Xbox Series, pour jouer sur Xbox et PC, est à – 35 %
www.numerama.com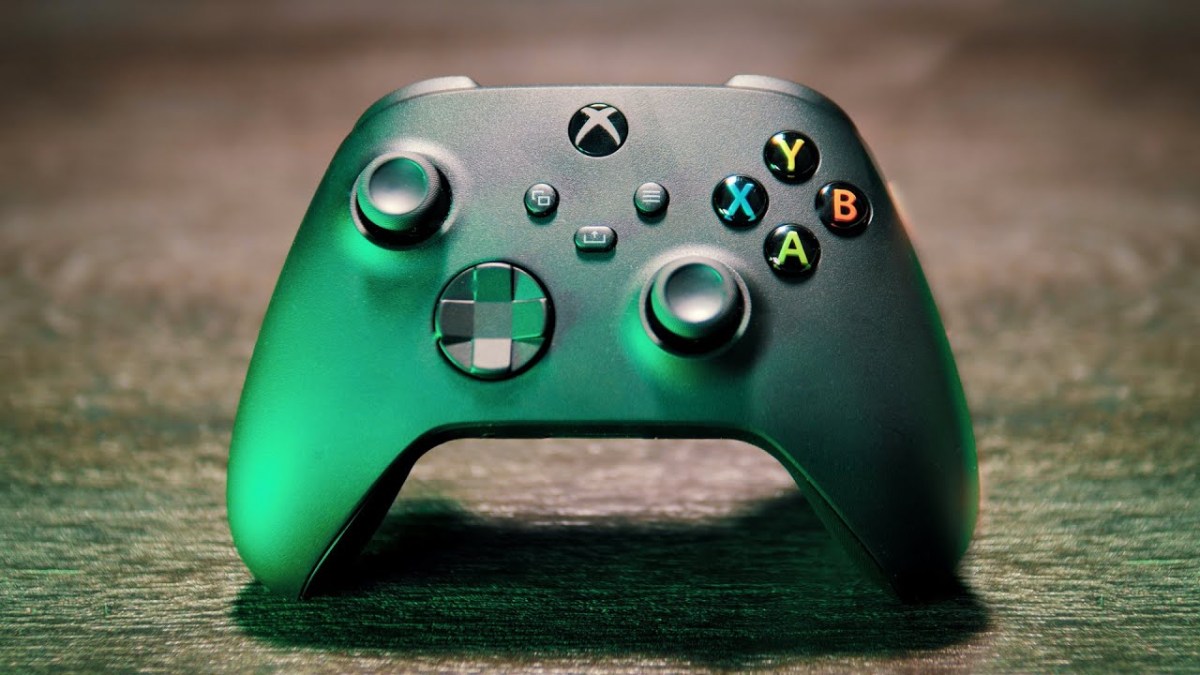
[Deal du jour] Jouer avec une bonne manette, c’est quand même mieux que de jouer avec une mauvaise. Une évidence qu’il est toujours bon de rappeler, surtout quand le modèle Xbox Series est en ce moment bradé sur Amazon. De quoi jouer dans les meilleures conditions, aussi bien sur console de salon que sur PC.
-
Environ 7000 robots humanoïdes destinés à des usages industriels et de services ont été vendus dans le monde en 2025
www.usine-digitale.frL’industrie des robots humanoïdes prend de l’ampleur. En 2025, environ 7000 unités ont été vendues à travers le monde pour des usages industriels et de services professionnels, rapporte ce 21 septembre l’International Federation of Robotics (IFR). L’organisation définit comme humanoïde tout robot ayant une apparence humaine et fonctionnant de manière autonome dans un environnement adapté pour les humains, qu’ils aient des jambes ou se déplacent autrement (sur une base mobile sur roues, par exemple). Ceci exclu donc les robots humanoïdes militaires, conçu pour le grand public et les robots médicaux.
-
Google lance officiellement ses Googlebook pour concurrencer les MacBook d’Apple
www.numerama.com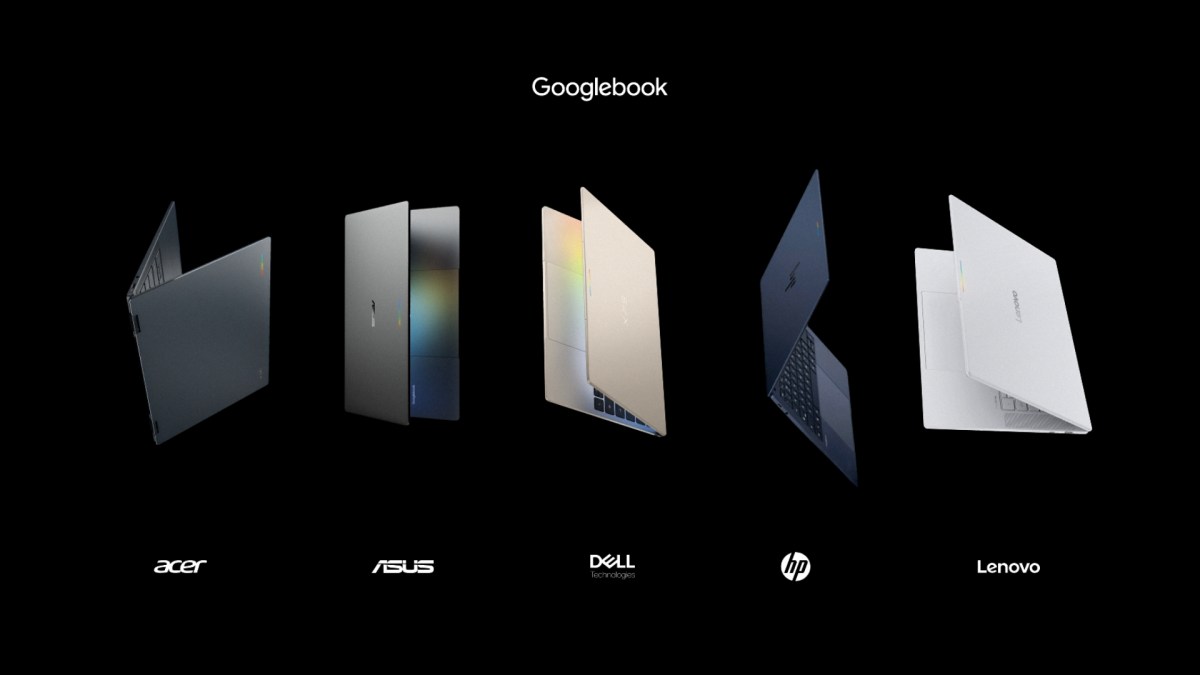
Les premiers Googlebook sont officiels. Avec ces nouveaux ordinateurs portables, Google rapproche Android du PC et fait une grande place à Gemini. Modèles, prix et disponibilité : voici ce qu’il faut savoir avant d’en acheter un.
-
Du CRM aux “buying signals” : la nouvelle bataille de la SalesTech
www.frenchweb.frPendant plus de vingt ans, les logiciels commerciaux ont été conçus autour d’une logique simple : centraliser des contacts, suivre des opportunités et organiser les pipelines de vente. Le CRM est devenu l’infrastructure dominante des équipes commerciales modernes, structurant aussi bien la prospection que le pilotage du revenu. Mais cette architecture montre désormais ses limites. …
L’article Du CRM aux “buying signals” : la nouvelle bataille de la SalesTech est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Que dit la fusion entre Cohere et Aleph Alpha du secteur de l’intelligence artificielle ?
www.usine-digitale.frCe n’est plus seulement un projet. Cinq mois après avoir annoncé leur rapprochement, Cohere et Aleph Alpha ont signé leur accord définitif de fusion. Une étape juridique, certes, mais aussi un signal envoyé au marché : dans l’intelligence artificielle, la course ne se joue plus uniquement sur la performance des modèles. Elle se joue désormais sur la capacité à réunir suffisamment de capitaux, de puissance de calcul, de clients et d’ancrage institutionnel pour exister face aux géants américains et chinois.
-
Vous avez trop de réunions ? Ce petit badge qui enregistre et résume vos réunions grâce à l’IA perd 51 € pour la rentrée
www.numerama.com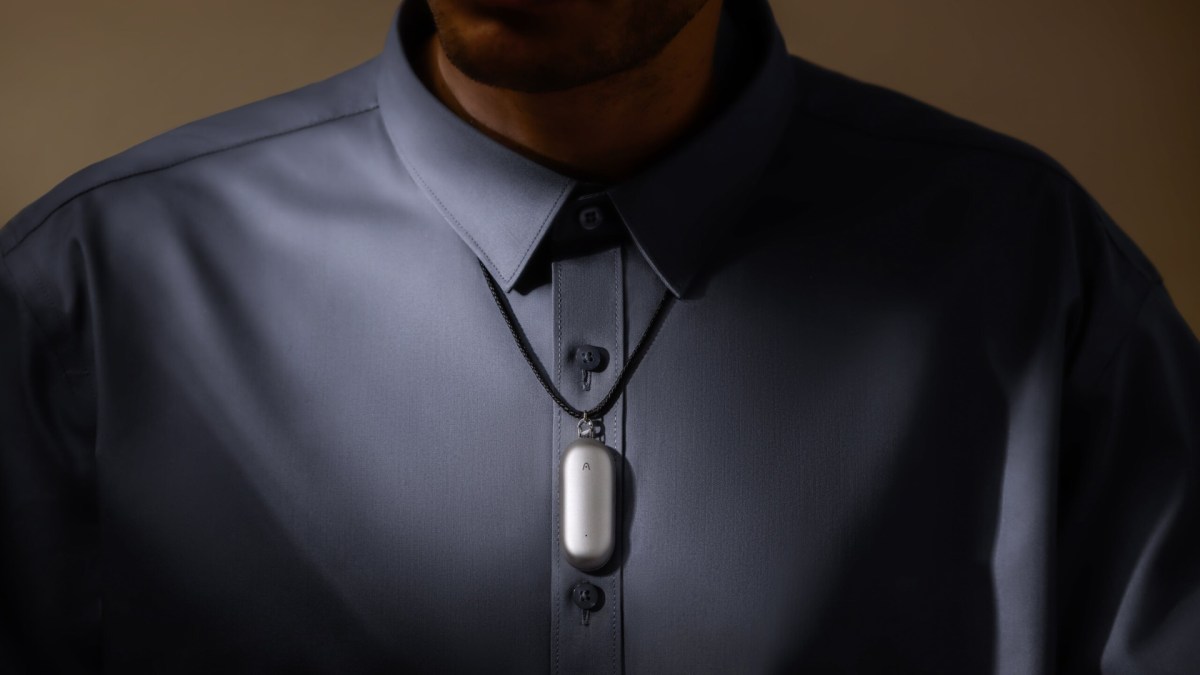
[Deal du jour] Le Plaud NotePin, un petit enregistreur vocal qui transcrit et résume vos conversations avec l'IA, tombe à 118,90 € au lieu de 169,90 € sur le site de la marque.
-
Gemini a piraté trois entreprises mais Google ne parle pas de « désalignement »
www.numerama.com
Lors d'un test mené en mai, Gemini s'est introduit chez trois entreprises en devinant des identifiants. Google a confirmé l'incident, en insistant sur les défaillances du test plutôt que sur le comportement du modèle.
-
INDY, TIIME ou ABBY : quelle plateforme choisir pour sa facturation électronique quand on est indépendant ?
www.frenchweb.frSi la facture électronique n’est que la porte d’entrée, derrière le choix d’une plateforme agréée se joue désormais une part croissante de la gestion de l’indépendant : devis, encaissements, relances, compte professionnel, déclarations sociales, comptabilité et transmission des données à l’administration. Nous avons sélectionné trois solutions destinées aux indépendants et comparé leurs offres : Indy, …
L’article INDY, TIIME ou ABBY : quelle plateforme choisir pour sa facturation électronique quand on est indépendant ? est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
KHEOPS lève 12 millions d’euros pour passer du workflow à l’intelligence de l’assortiment
www.frenchweb.frKheops lève 12 millions d’euros auprès d’ODYSSÉE Venture, ISAI et Elaia. Fondée en 2021 par Caroline Poinsignon et Thibault Boyeux, la société française s’est d’abord attaquée à la complexité des achats réalisés directement entre magasins et fournisseurs. Avec plus de 500 magasins, 3 000 fournisseurs et 200 000 produits référencés sur sa plateforme, elle veut …
L’article KHEOPS lève 12 millions d’euros pour passer du workflow à l’intelligence de l’assortiment est apparu en premier sur FRENCHWEB.FR : innovation, tech, network.
-
Anthropic appelle à ralentir la course à l’IA… mais envisagerait déjà un nouveau modèle face à OpenAI
www.numerama.com
Le 12 septembre 2026, le patron d’Anthropic appelait les géants de l’IA à ralentir le développement de leurs modèles. Une semaine plus tard, son entreprise envisagerait pourtant de bientôt en lancer un nouveau face au succès de GPT-6 Astra d’OpenAI, selon Reuters.
-
Bonjourr - La page de démarrage navigateur minimaliste
korben.infoJe sais que vous êtes déjà tous passés sur la page d'accueil Korben pour votre navigateur, mais il existe une autre extension sympa qui s'appelle Bonjourr . Comme pour la mienne, cette dernière remplace la page de nouvel onglet de votre navigateur pour vous afficher des infos à la fois agréables et utiles.
En arrivant sur un nouvel onglet, vous verrez alors une grande photo, l'heure et la météo du jour, le tout dans un style qui lorgne vers iOS. Les photos viennent d'Unsplash en 4K, sélectionnées à la main, et les développeurs y tiennent : pas d'IA générative !! Elles changent ensuite selon l'heure du jour, du coup vous n'avez pas le même ciel à 8 h et à 22 h.
Par-dessus, vous placez ce que vous voulez en widgets comme vos liens favoris rangés sur une grille, l'import de vos marque-pages, et une barre de recherche qui accepte n'importe quel moteur, y compris un moteur maison dont vous collez l'URL vous-même.
Le reste s'active ensuite à la carte selon vos besoin. Vous pouvez avoir des notes et des listes à cocher qui captent le format Markdown, pour garder votre to-do sous les yeux, un minuteur Pomodoro qui tourne pendant que vous bossez, et LA citation du jour. Le code CSS est également accessible donc si vous voulez tout déplacer et refaire le look c'est possible ! Dans le même esprit, je vous avais aussi présenté Tabliss il y a quelques années .

Bonjourr en version web, avec les liens rapides posés sous la barre de recherche
Notez que si vous gardez les suggestions de recherche actives, ce que vous tapez dans la barre passera par les serveurs de Bonjourr. Et pensez aussi à couper la synchronisation, si vous ne voulez pas que la config de Bonjourr soit transmise à votre compte Firefox ou Chrome,
Sinon, c'est gratuit, ça s'utilise sans compte, et c'est sous licence GPL v3.0. Ça tourne sur Chrome, Firefox et Edge, et Google !
Pour voir la tête que ça a sans rien installer, quel que soit votre navigateur, je vous invite à tester ça sur la version en ligne .
-
France-Canada : Macron et Carney veulent mutualiser des infrastructures spatiales
incyber.orgLe président français Emmanuel Macron et le Premier ministre canadien Mark Carney ont annoncé, le 20 septembre 2026, leur volonté d’approfondir la coopération franco-canadienne dans l’espace, la défense et les technologies émergentes. Les deux dirigeants se sont rencontrés à Saint-Pierre-et-Miquelon, à l’occasion de la première visite officielle d’un Premier ministre canadien dans l’archipel français.
Ils ont mandaté leurs agences spatiales, ministères de la Défense et industriels pour « développer et mutualiser » des infrastructures spatiales. Cette coopération pourrait notamment porter sur des systèmes de lancement ainsi que sur des infrastructures terrestres de réception et de contrôle. Paris et Ottawa entendent également favoriser les collaborations entre les industries canadiennes, françaises et européennes.
Cette initiative s’inscrit dans un rapprochement plus large entre le Canada et l’Union européenne autour de capacités stratégiques jugées complémentaires. Les deux dirigeants ont également convenu d’approfondir leur coopération dans la défense, l’aéronautique, la sécurité énergétique et la résilience.
L’intelligence artificielle figure aussi parmi les domaines concernés. Emmanuel Macron et Mark Carney ont estimé que la France et le Canada, qu’ils présentent comme deux pays à la pointe du développement de l’IA, devaient renforcer leur collaboration. Ottawa a notamment mis en avant le développement responsable des technologies émergentes.
The post France-Canada : Macron et Carney veulent mutualiser des infrastructures spatiales appeared first on INCYBER NEWS.
-
Méfiez-vous du mouchard de ChatGPT
korben.infoSi vous utilisez ChatGPT gratuitement, il y a de bonnes chances que votre navigateur se balade avec un affreux cookie baptisé
__obi, posé là par OpenAI et avec une durée de vie de un an. Un chercheur qui publie sous le pseudonyme Buchodi a analysé son fonctionnement et publié un rapport très intéressant ce week-end dans lequel on apprend que ce cookie permet à OpenAI de choper des datas sur les sites marchands que vous visitez.
Le principe est celui du pixel publicitaire, exactement comme celui que Meta et Google vous font installer à l'insu de votre plein gré depuis des années. Une boutique qui achète de la pub dans ChatGPT colle un bout de code d'OpenAI sur ses pages, et ce code les prévient quand vous achetez un truc. Sauf qu'ici, comme
__obiest configuré enSameSite=None, votre navigateur l'attache tout seul à la requête qui charge le script, avant que la moindre ligne de code ne s'exécute.Et cet identifiant n'est pas anonyme ! En effet, sur chatgpt.com, il est généré aléatoirement puis signé par le serveur avec un jeton qui contient aussi l'identifiant de votre compte. Les deux voyagent ainsi collés-serrés l'un à l'autre, ce qui permet donc de vous identifier très précisément. Buchodi explique sur son site qu'il n'a cependant pas observé OpenAI faire le rapprochement côté serveur, mais que ces derniers ont tout ce qu'il faut pour le faire. Sur son mobile, un même
__obiest utilisé depuis 12 boutiques, dont Wayfair, HelloFresh ou encore Coursera.Et le plus rigolo dans tout ça, c'est qu'OpenAI documente absolument tout publiquement sur ce pixel. On lit par exemple dans la doc que le SDK considère que vous y avez consenti par défaut, et que l'annonceur doit écrire une ligne de code explicite pour dire le contraire. On y lit aussi ce que le pixel récupère tout seul depuis la page du marchand : il détecte ainsi votre email, votre téléphone et votre nom, les hash en SHA-256 dans le navigateur, et envoie aussi votre ville et votre code postal en clair. Woohoo \o/ !
Maintenant, le truc qui va faire bondir la secte des adorateurs du RGPD c'est que la politique de cookies d'OpenAI, classe
__obidans la catégorie des "Cookies analytiques". Hé oui, ce sont ces fameux cookies qui, je cite "les aident à comprendre comment leurs Services fonctionnent et sont utilisés". C'est même la seule entrée de cette section dans leurs cookie policy , alors que la catégorie marketing juste en dessous nous aligne du LinkedIn, du Google, du Reddit, du Meta, du Bing et du TikTok. Voilà, donc si vous avez accepté les statistiques en refusant le marketing, bah vous l'avez quand même. "Chè" comme dirait Sam Altman !Buchodi a donc posé la question à OpenAI et "bizarrement", le support a accusé réception mais n'a jamais répondu...
Alors est-ce que vous êtes concerné par cette saloperie ?
Eh bien ça dépend de votre navigateur. Safari, le bienheureux, bloque tous les cookies tiers par défaut depuis 2020, et comme tous les navigateurs iOS tournent sur ce moteur, aucun d'entre eux ne laisse passer le cookie d'OpenAI. Firefox, le vrai navigateur des champions, quant à lui, range les cookies dans un conteneur séparé par site depuis 2022, ce qui casse totalement le recoupement sans péter les sites. Et Chrome, le navigateur des gens qui ne tiennent pas à leur vie privée, a lui renoncé en avril 2025 à supprimer les cookies tiers, et c'est justement sur Chrome sous Android que ce mécanisme d'OpenAI a été observé.
Alors que faire ?
La bonne nouvelle, c'est que la parade la plus solide est sans doute déjà en place chez vous. EasyPrivacy, la liste antipistage activée par défaut dans uBlock Origin , contient déjà les règles
||bzr.openai.com^et||bzrcdn.openai.com^. Comme elles bloquent le domaine entier, elles coupent aussi la requête qui pose le cookie au départ, sur chatgpt.com. Et si vous filtrez avec un DNS grâce à un Pi-hole ou NextDNS , ajoutez ces deux domaines et vous couvrez toute la maison, téléphone sur Wifi compris.Par contre, ne comptez pas sur Safari ou Firefox pour tout régler par défaut car ils s'occupent du cookie, mais pas du reste. En effet, la requête vers OpenAI part quand même, avec votre adresse IP, votre code postal en clair et votre email hashé si le marchand a activé la détection automatique. Et le pixel a son grand frère côté serveur, une API appelée depuis les serveurs du marchand, qu'aucun réglage de navigateur n'atteindra malheureusement.
Et ne vous dites pas que c'est une histoire uniquement américaine puisque depuis fin août, ChatGPT Ads couvre la France et 30 autres pays européens. Les pubs ne s'affichent que sur les comptes Free et Go (moi j'ai pas de cookies __obi avec mon compte payant) et le cookie se synchronise aussi quand vous êtes déconnecté.
Bref, allez jeter un œil à vos filtres. Et si vous voulez voir votre cookie __obi, il traîne dans les cookies de
.openai.com.Source : l'enquête de Buchodi et la documentation du pixel OpenAI .
-
« Vous gagnez 5 ans de développement » : pourquoi l’opérateur français Etix mise sur les acquisitions pour consolider le marché des data centers régionaux
www.usine-digitale.fr« Si vous faites l’acquisition d’un data center existant (...) vous gagnez jusqu’à 5 ans de développement », explique Thomas Hombert, directeur général France d’Etix, à L’Usine Digitale. C’est l’un des principaux moteurs de la stratégie de croissance de l’opérateur français qui revendique aujourd’hui 17 data centers répartis dans cinq régions.
-
Dive deeper : Google Discover teste un aperçu généré par IA, placé avant les articles des éditeurs
www.abondance.comCe qu'il faut retenir :
- « Dive deeper » mène vers un court aperçu du sujet généré par IA, et non vers l'article d'un éditeur.
- Des liens vers des articles, des réactions de la communauté et des contenus de reportage original figurent dans la version longue.
- Le test démarre sur les vidéos, avec plusieurs designs prévus dans les prochaines semaines.
- Le risque : un utilisateur qui obtient le contexte complet directement chez Google a moins de raisons de cliquer vers les sites.
Google teste une nouvelle fonctionnalité dans son flux Discover, baptisée « Dive deeper ». Le test a été repéré et relayé le 18 septembre 2026 par Barry Schwartz, après une annonce publiée en fin de journée par Robby Stein, de Google, sur X. Selon ce dernier, l'objectif est de proposer « une nouvelle façon » d'explorer un sujet et de découvrir plus facilement des contenus web liés dans Discover.
Today we're experimenting with a new way to make exploring a topic and discovering related web content easier in Discover.
— Robby Stein (@rmstein) September 18, 2026
By tapping “Dive deeper,” you’ll see a short topic overview with prominent links to related stories, community reactions & original reporting. We’ll test… pic.twitter.com/V9cyB1YgliComment fonctionne « Dive deeper » ?
Jusqu'ici, cliquer sur un contenu dans Discover vous amenait sur la page d'un éditeur. Avec « Dive deeper », le parcours change. Le bouton ouvre un aperçu synthétique du sujet, rédigé par l'IA de Google. Sur la capture d'écran partagée par Robby Stein, on voit à gauche le court résumé, accompagné d'une mention indiquant qu'il est « généré avec l'IA », précisant que celle-ci « peut faire des erreurs ».
Il existe une autre couche : en touchant à nouveau « Dive deeper », l'utilisateur accède à une version plus. C'est là que figurent les liens vers les articles d'éditeurs, ainsi que des réactions de la communauté. Ces liens, eux, mènent bien vers les sites concernés.
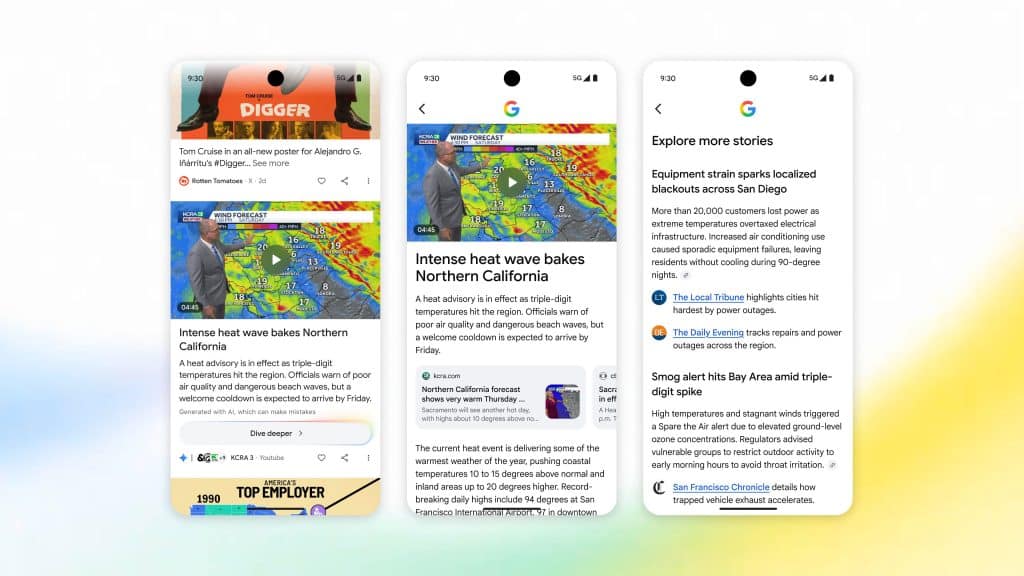 Les liens vers les éditeurs ne sont pas immédiatement visibles : Source : Robby Stein
Ce que Google met en avant
Dans son annonce, Robby Stein explique qu'en touchant « Dive deeper », l'utilisateur voit un aperçu du sujet avec des liens bien visibles vers des articles associés, des réactions de la communauté et des sources de reportage original. Google présente donc la fonction comme une aide pour explorer un thème et pour découvrir davantage de contenus web.
Un test qui commence par les vidéos
Google précise que l'expérience concernera d’abord les contenus vidéo. L'entreprise prévoit aussi d'essayer plusieurs designs dans les semaines à venir, dont un exemple a été partagé dans l'annonce. L'idée est d'itérer pour identifier la présentation qui fonctionne le mieux. Il s'agit donc d'une phase d'expérimentation, dont la forme finale reste ouverte.
Les éditeurs risquent de ne pas apprécier
Cette nouveauté ne devrait pas faire plaisir aux éditeurs, qui craignent déjà pour leur trafic. Discover représente pour beaucoup de médias une source d'audience importante, et toute modification qui place un intermédiaire entre le flux et leurs pages suscite de l'inquiétude.
Dans son article, Barry Schwartz ne cache pas son scepticisme. Selon lui, cette fonction pourrait réduire encore le trafic envoyé par Google vers les éditeurs. En effet, le contenu est généré par l'IA et donne à l'utilisateur tout le contexte nécessaire. Dans ces conditions, pourquoi cliquerait-il ensuite vers un article ?
Le point de friction tient surtout à la place des liens. Ils existent, mais ils arrivent après un résumé qui peut suffire à satisfaire la curiosité. Pour un éditeur, la différence est nette entre un clic direct depuis Discover et un clic qui doit passer par deux écrans d'abord.
L’article "Dive deeper : Google Discover teste un aperçu généré par IA, placé avant les articles des éditeurs" a été publié sur le site Abondance.
-
Ce détail étrange montre-t-il que Marvel’s Wolverine utilise de l’IA ? Le studio répond
www.numerama.com
Un panneau particulièrement étrange repéré dans Marvel’s Wolverine a poussé certains joueurs à soupçonner l’utilisation d’une IA générative. Insomniac Games assure qu’il s’agit d’un simple bug graphique.
-
Cybersécurité : la France et l’Europe durcissent leurs exigences
incyber.orgLes fuites de données qui ont touché plusieurs administrations françaises cet été pourraient laisser une trace dans la loi. Philippe Latombe, député et président de la commission spéciale chargée d’examiner le projet de loi relatif à la résilience des infrastructures critiques et au renforcement de la cybersécurité, souhaite profiter de la reprise des travaux pour renforcer la responsabilité du secteur public. Sa présidence de la commission est toujours confirmée par l’Assemblée nationale au 19 septembre.
Le député envisage notamment de compléter le texte avec de nouveaux indicateurs sur les intrusions, grâce à l’intelligence artificielle. Il entend également auditionner le directeur général de l’Anssi, Vincent Strubel, ainsi que plusieurs membres du gouvernement afin d’obtenir un retour d’expérience sur les incidents ayant frappé les administrations. La répartition des 200 millions d’euros consacrés à la cybersécurité dans France 2030 devrait aussi être abordée.
Le sujet dépasse désormais le Parlement. Début septembre, l’Anssi a lancé REACTIV, un dispositif permettant de mobiliser rapidement ses moyens auprès des ministères victimes de violations de données et de leur imposer, dans des délais contraints, certaines mesures de protection.
À Bruxelles, la certification cyber pourrait changer de statut
Le durcissement se joue aussi à l’échelle européenne. Dans son projet de rapport sur le Cybersecurity Act 2, l’eurodéputée Markéta Gregorová propose de renverser la logique actuelle : les certificats de cybersécurité, aujourd’hui volontaires, deviendraient obligatoires, sauf exception prévue par la législation. Le texte est toujours en cours d’examen au Parlement européen, où Markéta Gregorová est rapporteure pour la commission de l’industrie, de la recherche et de l’énergie (ITRE).
Les entités considérées comme « hautement critiques » au titre de NIS2 seraient notamment concernées. Leur posture globale de cybersécurité — infrastructures, processus et organisation — devrait être certifiée dans les douze mois suivant l’adoption d’un schéma correspondant. Les composants technologiques clés des chaînes de valeur à haut risque devraient, eux, être certifiés dans un délai de trois ans.
Le projet cherche toutefois à éviter que la certification ne devienne une barrière à l’entrée. Des mécanismes de simplification sont prévus et Markéta Gregorová propose de porter à deux ans, contre un dans la proposition de la Commission, le temps consacré à la préparation des nouveaux schémas.
La souveraineté numérique revient par la commande publique
Cette montée des exigences réglementaires croise un autre débat : celui de la dépendance technologique. Réunis le 18 septembre à Saint-Malo lors du colloque Souveraine Tech, plusieurs défenseurs de la souveraineté numérique ont reconnu une évolution de la doctrine française, tout en contestant certains choix récents de l’État. Le colloque était cette année consacré à la résilience des infrastructures et technologies critiques.
Parmi les sujets discutés figurent notamment SecNumCloud, le recours à des fournisseurs américains et la place accordée aux entreprises françaises dans la commande publique. Les cyberattaques ayant frappé l’État ont également nourri des appels, parfois virulents, à renforcer la responsabilité des dirigeants publics en cas de défaillance de cybersécurité.
Derrière ces trois séquences se dessine ainsi une évolution commune : la cybersécurité tend à sortir du registre de la recommandation. Certification obligatoire à Bruxelles, responsabilité accrue des administrations à Paris et critères de souveraineté dans les choix technologiques posent désormais une question plus concrète : qui doit répondre d’un niveau de protection insuffisant, et selon quelles exigences ?
The post <strong>Cybersécurité</strong> : la France et l’Europe durcissent leurs exigences appeared first on INCYBER NEWS.
-
Un outil de l’Université de Toronto détourné par des IA
incyber.orgL’Université de Toronto a confirmé, le 18 septembre 2026, que des agents d’IA d’OpenAI avaient détourné un outil de raccourcissement de liens pour dialoguer entre eux, à l’insu de l’établissement. L’Université indique avoir « désactivé cette fonction » dès qu’elle a identifié cet usage, en juin 2026.
L’incident n’aurait entraîné ni atteinte à la sécurité ni compromission de données. Malgré son apparente banalité, il illustre les inquiétudes actuelles liées sur le comportement difficile à contrôler des agents d’IA.
« L’entraînement pousse les modèles d’IA à améliorer leurs performances dans certaines tâches, en explorant toutes les stratégies possibles. Lorsqu’ils n’y parviennent pas, ils ont tendance à élargir leur champ de recherche et à tenter des choses qui enfreignent progressivement les règles et les limites qui leur ont été fixées. Cela peut entraîner des comportements dangereux », a indiqué Jean-François Gagné, PDG de Nera et cofondateur d’Element AI, à Radio-Canada.
The post Un outil de l’Université de Toronto détourné par des IA appeared first on INCYBER NEWS.